
HAMi GPU Descheduler:自动整理 Kubernetes 集群的 GPU 碎片
 技术博客
HAMi GPU Descheduler 通过 HamiPodPlacement CRD 与准入 Webhook 执行 GPU 工作负载的驱逐、重建和定向放置,让团队按声明式计划归整分散的 vGPU 资源。
本文目录
GPU 是 Kubernetes 集群中成本较高、也越来越需要被精细化利用的资源。在实际生产环境中,很多团队会选择对 GPU 进行共享使用,从而提升整体资源利用率。
但当集群长期运行后,一个新的问题也会逐渐出现:GPU 明明还有不少空闲容量,为什么新的 Pod 还是调度不上去?
一个常见原因,就是 GPU 碎片化(GPU Fragmentation)。Pod 不断创建、销毁、扩缩容和重建,原本集中在一起的 GPU 资源逐渐变得分散。最终可能出现这样的情况:集群整体还有大量 GPU 空闲资源,但没有任何一张 GPU 能够提供某个 Pod 所需要的连续资源。
针对这一实际问题,HAMi 社区与易鑫集团工程师共同设计并实现了 HAMi GPU Descheduler,将 GPU 碎片整理能力引入 Kubernetes,让已经分散的 GPU 工作负载可以按照预期重新归整。
问题:有容量,却没有位置
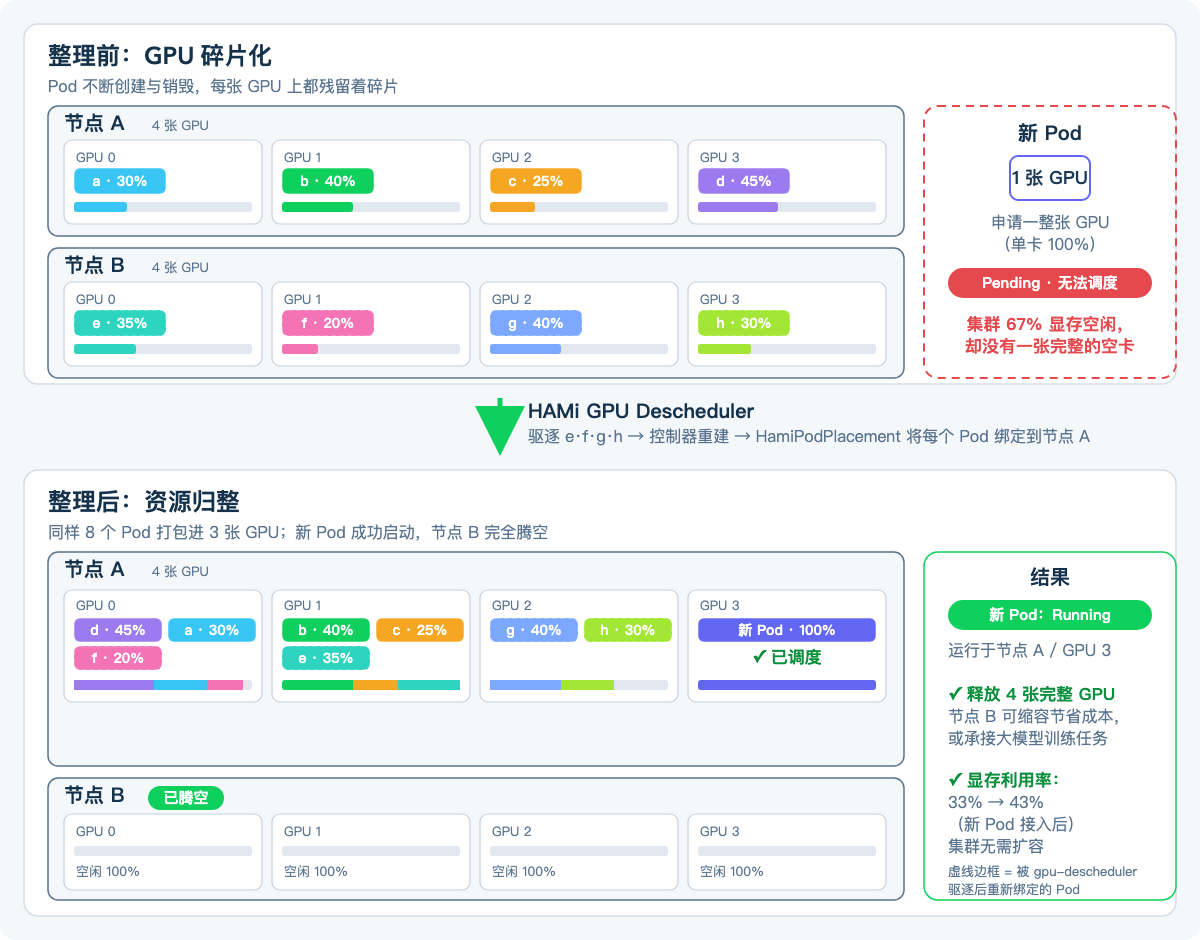
假设一个 Kubernetes 集群有两个节点,每个节点通过 HAMi 共享 4 张 GPU。
随着业务运行,8 个 Pod 分别占用了不同的 GPU 资源:
- 节点 A:
a30%、b40%、c25%、d45% - 节点 B:
e35%、f20%、g40%、h30%
从整个集群来看,全集群只用了 33% 的显存,GPU 还有大量空闲容量。
但此时如果一个新 Pod 申请一整张 GPU,它依然可能无法被调度。
因为空闲资源虽然存在,但没有集中在一张完整的 GPU 上。调度器无法放置,Pod 只能留在 Pending 状态,大部分的 GPU 资源只能闲置。
这和内存碎片有些类似:总容量并不等于当前可用的连续容量。
区别在于:内存碎片可以靠分配器合并解决,GPU 碎片不能。一个需要整卡的 Pod(例如不做模型并行的推理服务)只能落在一张完全空闲的设备上,分散在不同 GPU 上的碎片无法拼凑成一张整卡。
而且 GPU 碎片并非只影响整卡申请,任何 vGPU 申请,只要超过了所有设备上最大的单块空闲容量,都会无法落位。
例如,一个 Pod 需要一张 GPU 的 70% 资源,但当前每张 GPU 上最大的连续可用份额只有 40%,即使整个集群还有大量空闲资源,这个 Pod 同样可能一直处于 Pending 状态。
所以,GPU 利用率高并不意味着 GPU 资源一定处于良好的可用状态。
GPU 碎片为什么会越来越严重
GPU 碎片化并不是 Bug,而是共享 GPU 集群长期动态运行后很容易出现的问题。
- **弹性伸缩:**缩容时删除的 Pod 分散在多个节点上,留下大量半空的 GPU。
- 滚动升级: 新版本的 Pod 落在有空余的节点上,旧版本离开后留下空洞。
- 失败重试: 训练任务每次重启可能调度到不同节点。
- **混合负载:**申请 20% 到 40% 显存的推理 Pod 与需要整卡的任务交错分布。
这些不同粒度的资源需求长期混合运行,会进一步加剧 GPU 碎片化。集群可能出现一种很典型的状态**:总利用率看起来健康,但真正可供大任务使用的连续资源越来越少。**
更麻烦的是,被碎片化困扰的往往正是最重要的任务:小 Pod 总能不断“见缝插针”,但真正需要较大 GPU 资源的任务反而越来越难调度。
手动治理 GPU 碎片化的痛苦
发现碎片之后,最直接的方法其实是人工处理:找到碎片、kubectl delete pod 删掉可以迁移的 Pod、等控制器重建,期望它们落在合适的位置,必要时用节点选择器固定。反复操作,直到某张卡的空闲容量足以放下等待中的 Pod。
偶尔做一次没问题,但对于长期运行的生产集群来说,这种方式的问题也很明显:
- **人工操作成本高:**每次驱逐都是一次人工决策,你必须清楚这个工作负载是否允许中断,以及应该把它重新放在哪里。
- **整理结果并不稳定:**Pod 被删除后会重新进入 Kubernetes 调度流程。如果没有明确的放置约束,它仍然可能被调度到其他位置,刚刚整理好的布局很快又被打散。
- **缺少声明式的放置意图:**没有任何意图记录,布局很快再次劣化,同样的操作周而复始。
团队进行GPU 碎片整理真正需要表达的是一种声明式、一次性的操作:“把这些负载归整到那个节点的 GPU 上”。这也是 HAMi GPU Descheduler 要解决的问题。
HAMi GPU Descheduler
HAMi GPU Descheduler 是面向 HAMi 虚拟化 Kubernetes 集群的 GPU 碎片整理工具。
它通过两个机制归整分散在各节点的 vGPU 工作负载:
- Mutating Admission Webhook
HamiPodPlacement** CRD**
HAMi GPU Descheduler 扮演的角色与操作系统中的磁盘碎片整理工具一样:把散落的负载归拢到一起,恢复每张设备上连续可用的空闲容量。
它与 HAMi Scheduler 互补:调度器负责 GPU 资源的虚拟化、调度与隔离,Descheduler 负责对已经运行的 GPU 工作负载进行重新归整,让 GPU 资源布局更加紧凑。
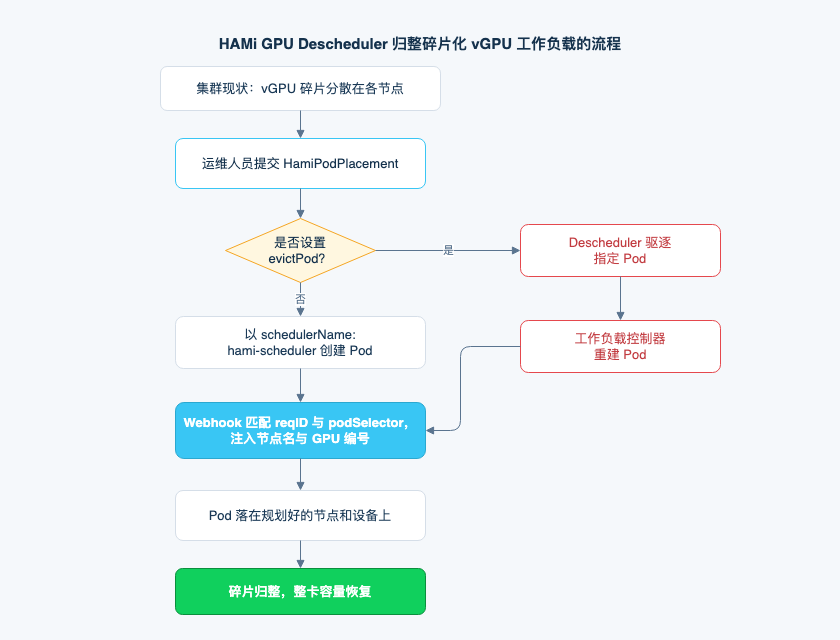
整个流程是这样的:
- 创建一个
HamiPodPlacement,描述期望的放置:目标节点、GPU 设备、适用的 Pod,可选地指定一个需要驱逐腾位的 Pod。 - 若设置了
evictPod,descheduler 会驱逐该 Pod 并等待;负载所属的控制器(Deployment、StatefulSet 等)将其重建。 - 当目标 Pod(新建的或重建的)进入准入阶段,webhook 将它与
HamiPodPlacement匹配(reqID加podSelector),并注入规划好的放置。 - Pod 被调度到你指定的节点和 GPU 设备上。每个
HamiPodPlacement恰好被一个 Pod 消费,保证了操作的幂等与可审计。
放置以 CRD 表达,碎片整理于是成为又一个普通的 Kubernetes 操作:声明式、可进 Git 审查、可自动化。
整理这个集群
回到开篇那个两节点集群。
通过多次 HamiPodPlacement 操作,要腾空节点 B 并在节点 A 上腾出连续容量,六次一次性放置就够了:Pod e、f、g、h 从节点 B 搬到节点 A,c 和 d 在节点 A 内部重新固定,让 8 个 Pod 归拢到 GPU 0 到 2 上。
以 Pod e 为例:
apiVersion: scheduling.hami.placement.com/v1
kind: HamiPodPlacement
metadata:
  name: consolidate-e
  namespace: default
spec:
  reqID: "defrag-e-0001" # 最短 5 个字符,仅消费一次
  podSelector:
    matchLabels:
      app: inference
  nodeName: gpu-node-a
  gpuDevices:
    - gpu-1 # 或 gpu-1/70 表示 GPU 1 的 70%
  evictPod: inference-e-6cd5964877-zdb5z # 需要驱逐并重新放置的 Pod
关于 podSelector 有一点要注意:它决定哪个 Pod 消费这次放置,而“先通过准入的那个匹配 Pod”会消费它。
如果命名空间里所有 Pod 都带着 app: inference 标签,消费放置的可能就不是 e,而是它的某个同门。
ReplicaSet 的 pod-template-hash 之类的标签解决不了这个问题:同一个 ReplicaSet 的所有副本都带相同的值,先被准入的同门仍可能消费这次放置。请使用只有被搬迁工作负载才携带的标签,让选择器匹配不到别的 Pod;多副本工作负载则一次只搬一个副本,并避免在有兄弟 Pod 正在创建时进行搬迁。
evictPod 是什么、怎么用
evictPod 是将一次“放置”操作变成“搬迁”操作的关键字段。它指定同一命名空间中一个已经运行的 Pod,告诉 descheduler**:为了执行这次放置,需要先让哪个 Pod 释放当前占用的 GPU 资源。**
随后的流程是这样的。descheduler 会先驱逐指定 Pod,并等待其所属的 Deployment、StatefulSet 等控制器重新创建。新 Pod 进入准入阶段后,Webhook 根据 reqID 和 podSelector 匹配对应的 HamiPodPlacement,再将它固定到预先规划好的 nodeName 和 gpuDevices。
不设置这个字段时,放置只影响之后创建的 Pod,是一种规划工具;设置之后,你就能主动搬移已经在运行的工作负载,而这正是碎片整理所需要的。
这个字段是可选的,原因也很实际。
驱逐发生在目的地校验之前,所以添加之前务必确认 nodeName 和 gpuDevices 指向一个有足够空位的有效目的地,否则 Pod 被驱逐后无处可去。
另外,descheduler 只等待替代 Pod、从不自行创建 Pod,因此被驱逐的负载必须由控制器管理。请有意识地使用 evictPod,一次搬一个 Pod。
每个 Pod 被驱逐、重建、并固定到节点 A 的特定 GPU 上,布局逐渐收敛为示意图中“整理后”的状态:8 个 Pod 打包进 3 张 GPU,新 Pod 占用第 4 张,节点 B 完全腾空,不增加任何容量,找回 4 张整卡。集群显存利用率从 33% 提升到 43%,提升完全来自那个原本无法启动的新 Pod。
腾空的节点可以缩容降本,也可以转而承接需要整卡的大模型训练任务。
驱逐之前
主动驱逐会终止正在运行的 Pod,可能短暂降低可用性。负载必须由控制器(Deployment、StatefulSet 等)管理,确保被驱逐的 Pod 会被重建;开始整理前,请检查负载的就绪状态与中断保护。
快速上手
使用 Helm 部署(要求 HAMi Scheduler v2.10.0+,Kubernetes v1.24+,推荐 v1.28+):
git clone https://github.com/Project-HAMi/gpu-descheduler.git
cd gpu-descheduler
helm install gpu-descheduler ./chart --namespace kube-system --create-namespace
确认 webhook 正常运行:
kubectl get pods -n kube-system -l app=gpu-descheduler-webhook -w
webhook 还在 8083 端口提供 REST API,用于查看集群 GPU 状态和放置记录,这是决定整理什么的依据。这个端口没有通过 Service 暴露,需要先把它转发到本机(命令会一直阻塞,请在单独的终端里运行):
kubectl port-forward -n kube-system deploy/gpu-descheduler-webhook 8083:8083
然后查询 API:
# 查看节点、GPU 设备与健康状态
curl -s http://localhost:8083/api/v1/cluster-info

# 查看当前 Placement CRD 缓存与分配记录
curl -s http://localhost:8083/api/v1/placements
目标 Pod 必须使用 schedulerName: hami-scheduler,且其标签要匹配 HamiPodPlacement 中的 podSelector。完整流程见用户指南。
结语
GPU 碎片化是一个随集群动态性增长的可用性与成本问题:容量存在却无法使用,而人工治理脆弱且无据可查。
HAMi GPU Descheduler 为这一问题提供了一种新的解决思路:通过 HamiPodPlacement CRD 声明放置计划,结合准入 Webhook,实现 Pod 的驱逐、重建与定向放置,让 GPU 碎片整理从依赖人工操作,转变为更加灵活、可控的 Kubernetes 资源管理操作。
HAMi Issue #2072 提出了节点内 GPU 碎片整理的需求。
随后,易鑫训推一体平台团队完成了基于 Webhook + CRD 的方案设计与主要实现,并将代码开源贡献给 HAMi 社区。
仓库公开后,社区维护者和用户持续参与评审与完善。
感谢每一位为项目贡献想法、代码和反馈的社区成员。
需要说明的是,目前 GPU 碎片整理计划仍由人来制定:哪些 Pod 需要归整、目标节点和 GPU 如何选择,仍需要人工判断,Descheduler 负责将放置计划准确执行。目前,工作负载的搬迁已经可以跨节点进行。
在此基础上,社区也在探索下一步的自动化能力:自动发现集群中的 GPU 碎片,生成多个候选治理方案,由用户选择并执行,同时将整理范围从单个节点进一步扩展到整个集群。
如果你在动态集群中用 HAMi 共享 GPU,不妨留意集群中那些因为 GPU 资源碎片而长期处于 Pending 状态的 Pod。尤其是在整卡资源申请场景下,这类问题往往更加直观。
尝试使用 HAMi GPU Descheduler: