如何用好每一张 GPU?密瓜智能在 ContainerDays Singapore 分享实践
10 月 27 日,ContainerDays & AI Context Singapore 2026 在新加坡新达城会展中心(Suntec Singapore)开幕。大会聚焦云原生、AI 基础设施与平台工程等技术方向,吸引来来自全球的开发者和行业实践者参与交流。
本次大会,密瓜智能开源生态 VP 宋净超(Jimmy Song)与全球市场与解决方案工程负责人 Reza Jelveh 参与技术分享,带来两场围绕 HAMi 的专题演讲,分别聚焦 Kubernetes 中的 GPU 共享与调度实践,以及 Neocloud 场景下的 GPU 利用率优化。
一场从动手实验出发,一场结合实际生产案例,两位讲者从不同角度介绍了 HAMi 的技术能力及其在 AI 基础设施中的应用。
从零开始,动手实践 GPU 共享与调度
分享主题: From Zero to Shared GPUs: Hands-on GPU Scheduling in Kubernetes with HAMi
分享嘉宾: Reza Jelveh、宋净超(Jimmy Song)
分享时间: 10 月 27 日 12:30—13:15
分享地点: Workshop Room
在 Kubernetes 环境中,GPU 通常以整卡为单位分配给任务。但不同业务对 GPU 的需求并不相同:有的任务只需要少量显存,有的则需要占用整张 GPU。如果一律采用整卡分配,就可能出现 GPU 已被占用、实际资源却未得到充分利用的情况。
如何让多个任务共享 GPU,同时根据各自需求分配显存与算力?
在这场 45 分钟的 Workshop 中,两位讲者带领参与者从零部署 HAMi,通过实际操作了解 Kubernetes 中的 GPU 共享与调度机制。
为了降低实践门槛,Workshop 使用 kind 本地集群和模拟 GPU 搭建实验环境。即使没有配备 GPU 的笔记本电脑,也能运行真实的 HAMi 调度器,观察 GPU 资源的申请与分配过程。
实验从安装 HAMi 开始,逐步演示多个 Pod 如何共享 GPU,以及当任务申请的资源超过单张 GPU 容量时,调度器会如何处理。
随后,两位讲者通过 Binpack 和 Spread 两种策略,对比了不同调度方式下的资源分配结果。
- Binpack 倾向于将任务集中分配到较少的 GPU 上,为后续大任务保留更多完整资源;
- Spread 则倾向于将任务分散到不同 GPU 上。两种策略适用于不同的工作负载,需要根据实际业务需求选择。
通过这些实验,参与者可以直观地看到 GPU 资源如何被分配,以及调度策略如何影响任务的运行位置。
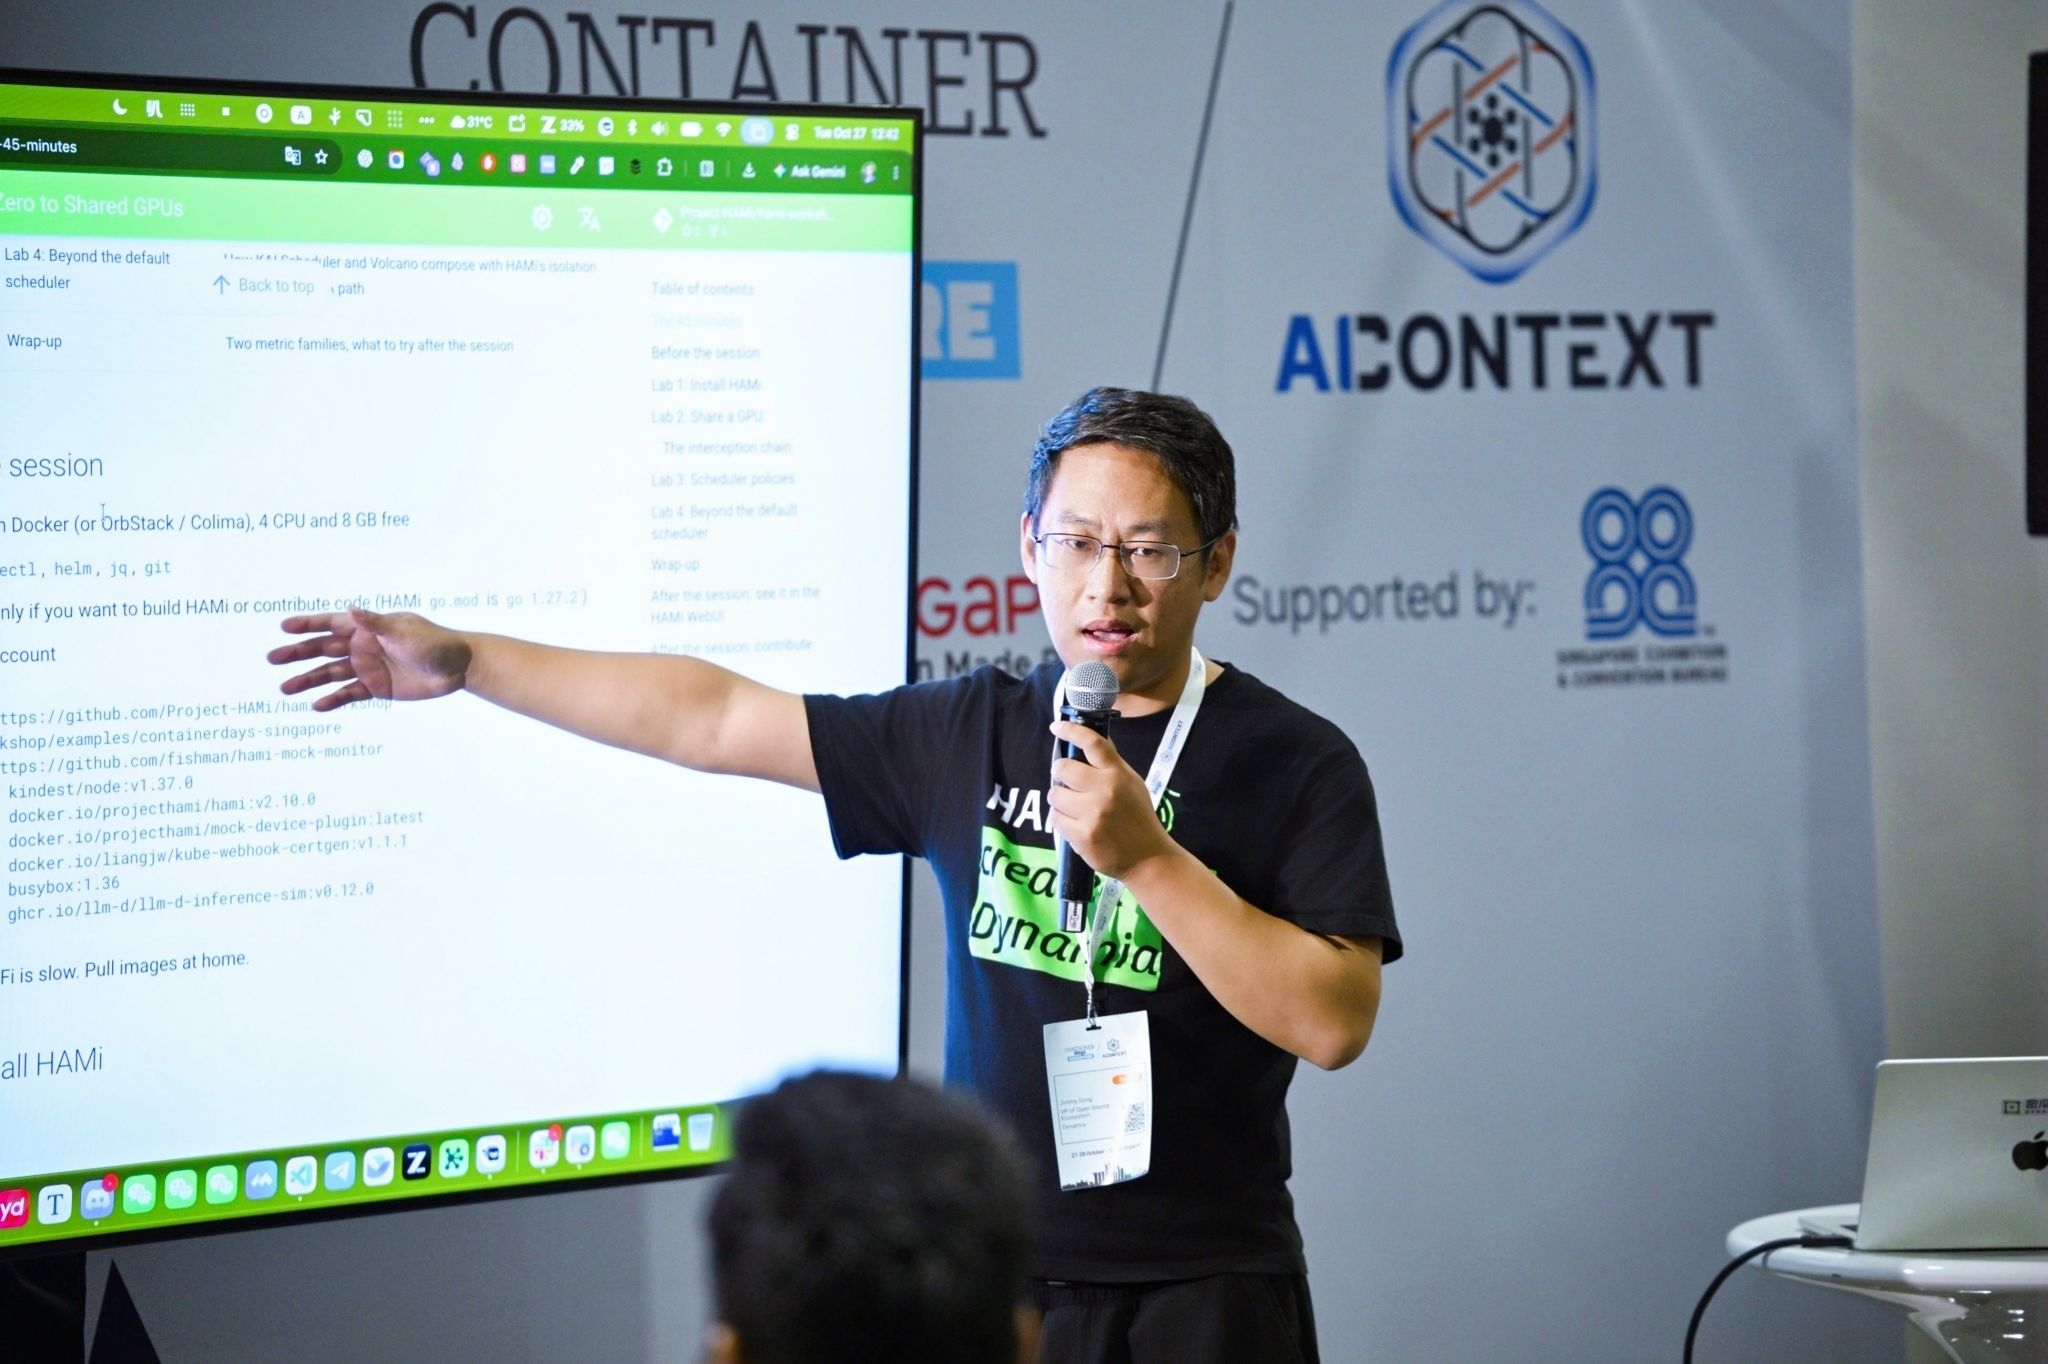
除了基础的共享与调度实验,Workshop 还介绍了 HAMi 与 KAI Scheduler、Volcano 等项目的协同方式,以及 HAMi-DRA 与 Kubernetes 动态资源分配机制的集成方向。在这些架构中,调度器负责工作负载的放置与队列管理,HAMi-core 则在容器运行时执行相应的 GPU 资源限制。
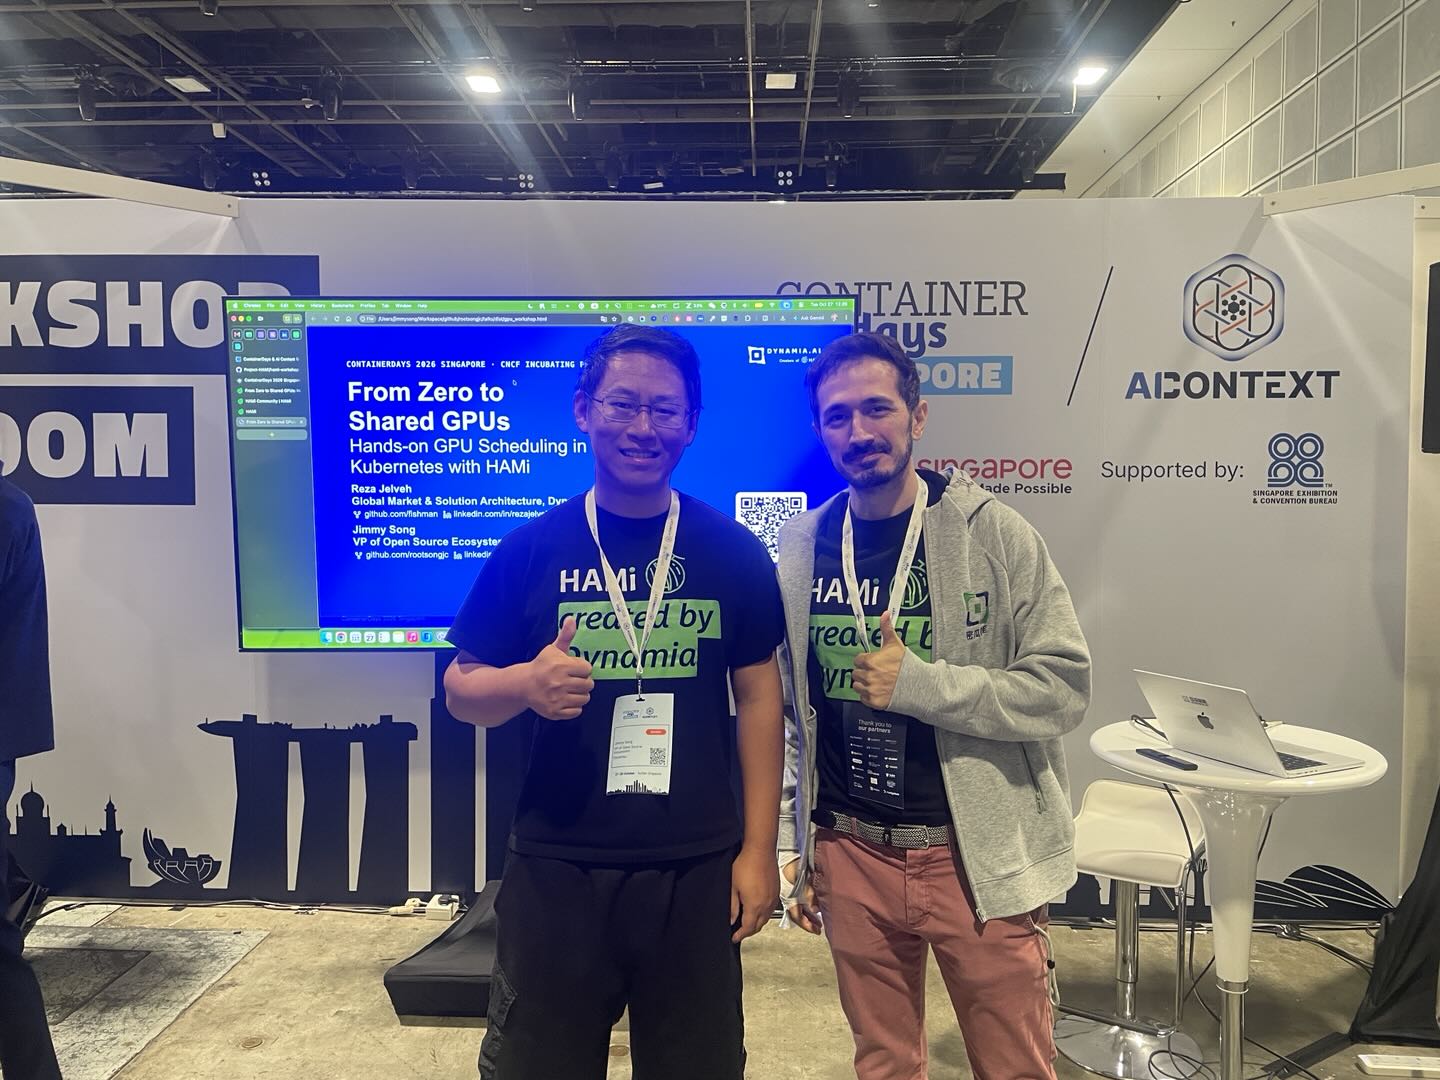
从资源申请、任务调度到运行时隔离,这场 Workshop 让参与者对 HAMi 的 GPU 资源管理机制有了更具体的认识。
Neocloud 算力利用率优化
分享主题: 10X Your Neocloud's GPU Utilization with HAMi
分享嘉宾: Reza Jelveh
分享时间: 10 月 27 日 15:05—15:40
分享地点: CDS Theatre
第一场 Workshop 介绍了 GPU 共享与调度的实现方式。第二场分享则将视角转向 Neocloud,讨论在实际 AI 基础设施中,GPU 共享如何转化为更高的资源利用效率。
在 Neocloud 场景下,GPU 不仅需要满足模型训练与推理需求,还要支撑开发环境、Notebook、多租户资源分配及用量计量等不同业务。这些业务对 GPU 的使用方式存在明显差异。大型训练任务可能需要独占整张 GPU,而小模型推理、开发测试等负载往往只使用部分显存与计算资源。
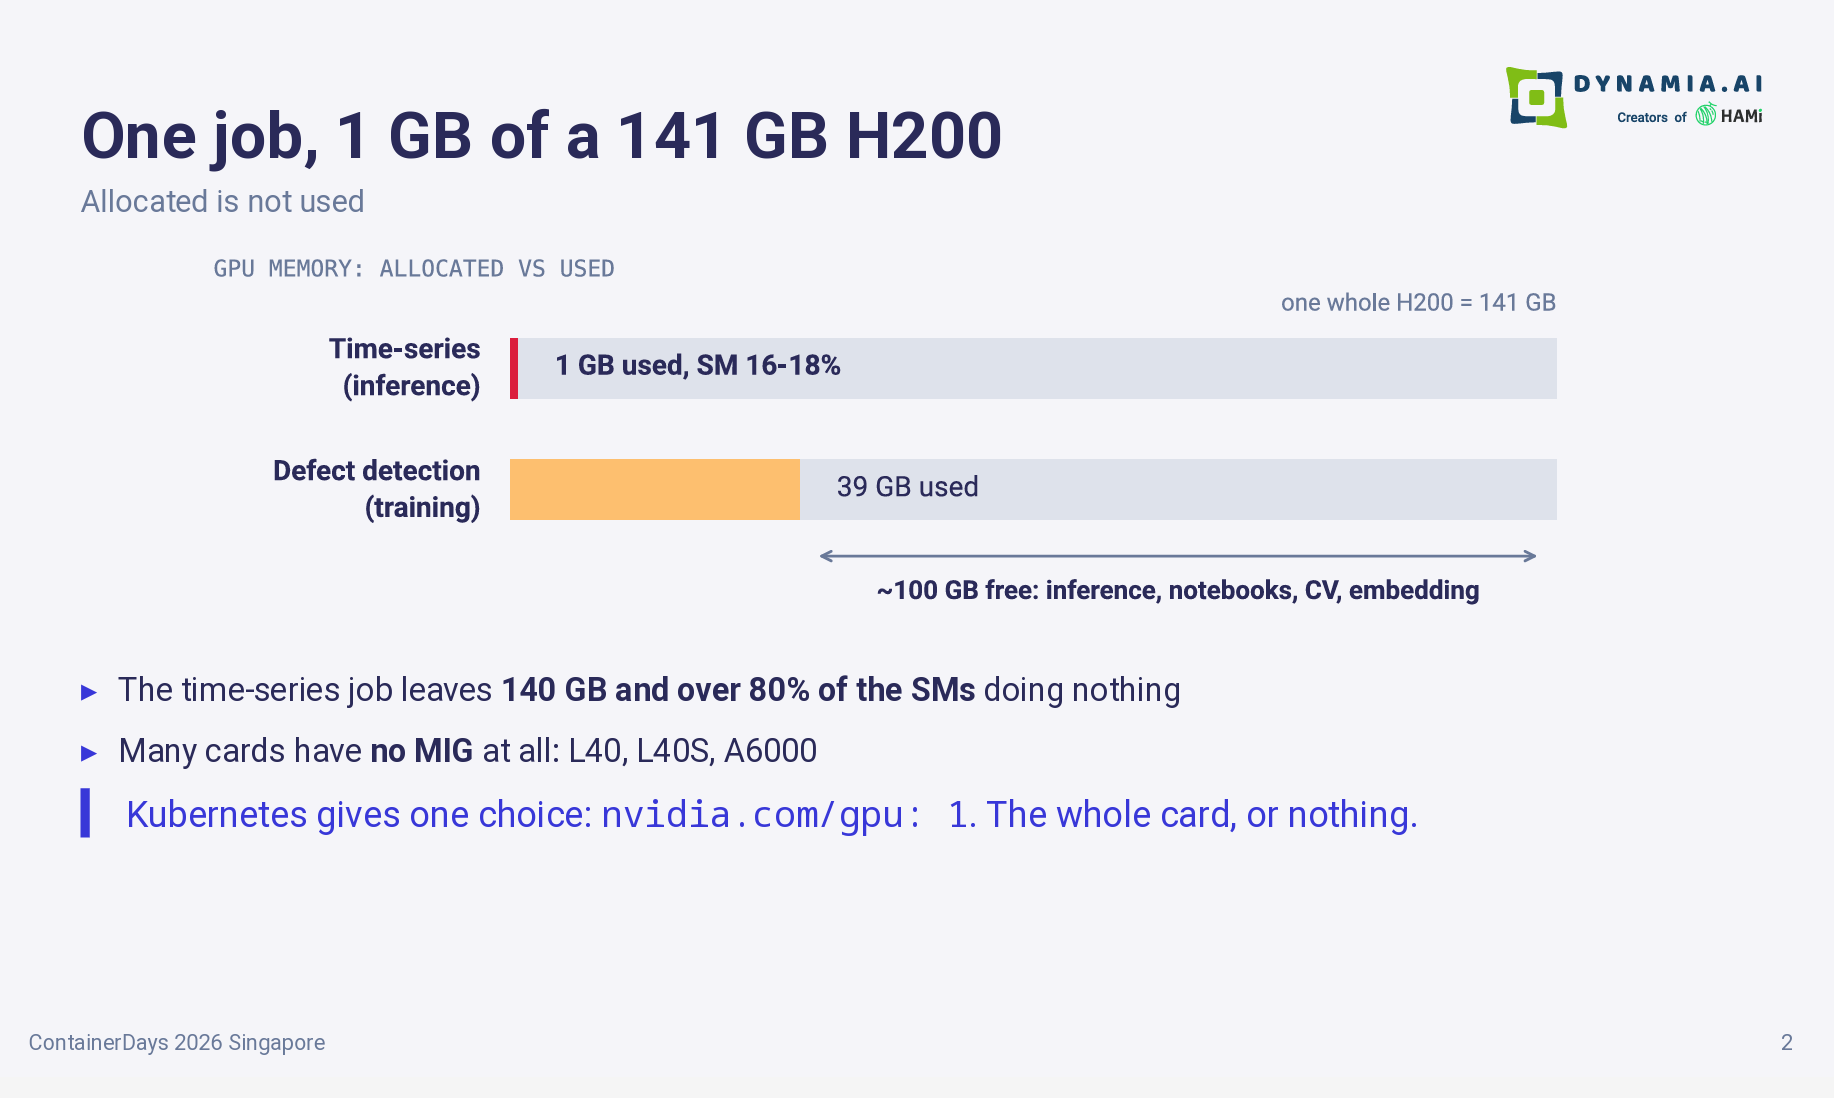
以一张拥有 141 GB 显存的 NVIDIA H200 为例:当某个任务仅使用约 1 GB 显存时,如果仍按整卡分配,大量资源就可能处于闲置状态。
针对这一问题,分享介绍了 HAMi 如何通过细粒度 GPU 资源分配、运行时限制与调度策略,让不同工作负载在满足资源约束的前提下共享设备。
GPU 利用率的提升,并不意味着单个任务运行得更快,而是让原本闲置的算力能够承载更多合适的任务。
一张 GPU ,承载更多推理任务
在推理服务场景中,单个模型实例未必能够充分使用整张 GPU。相比一味扩大单个实例的资源配置,通过显存感知的任务放置与多副本部署,有时能够更有效地利用剩余算力。
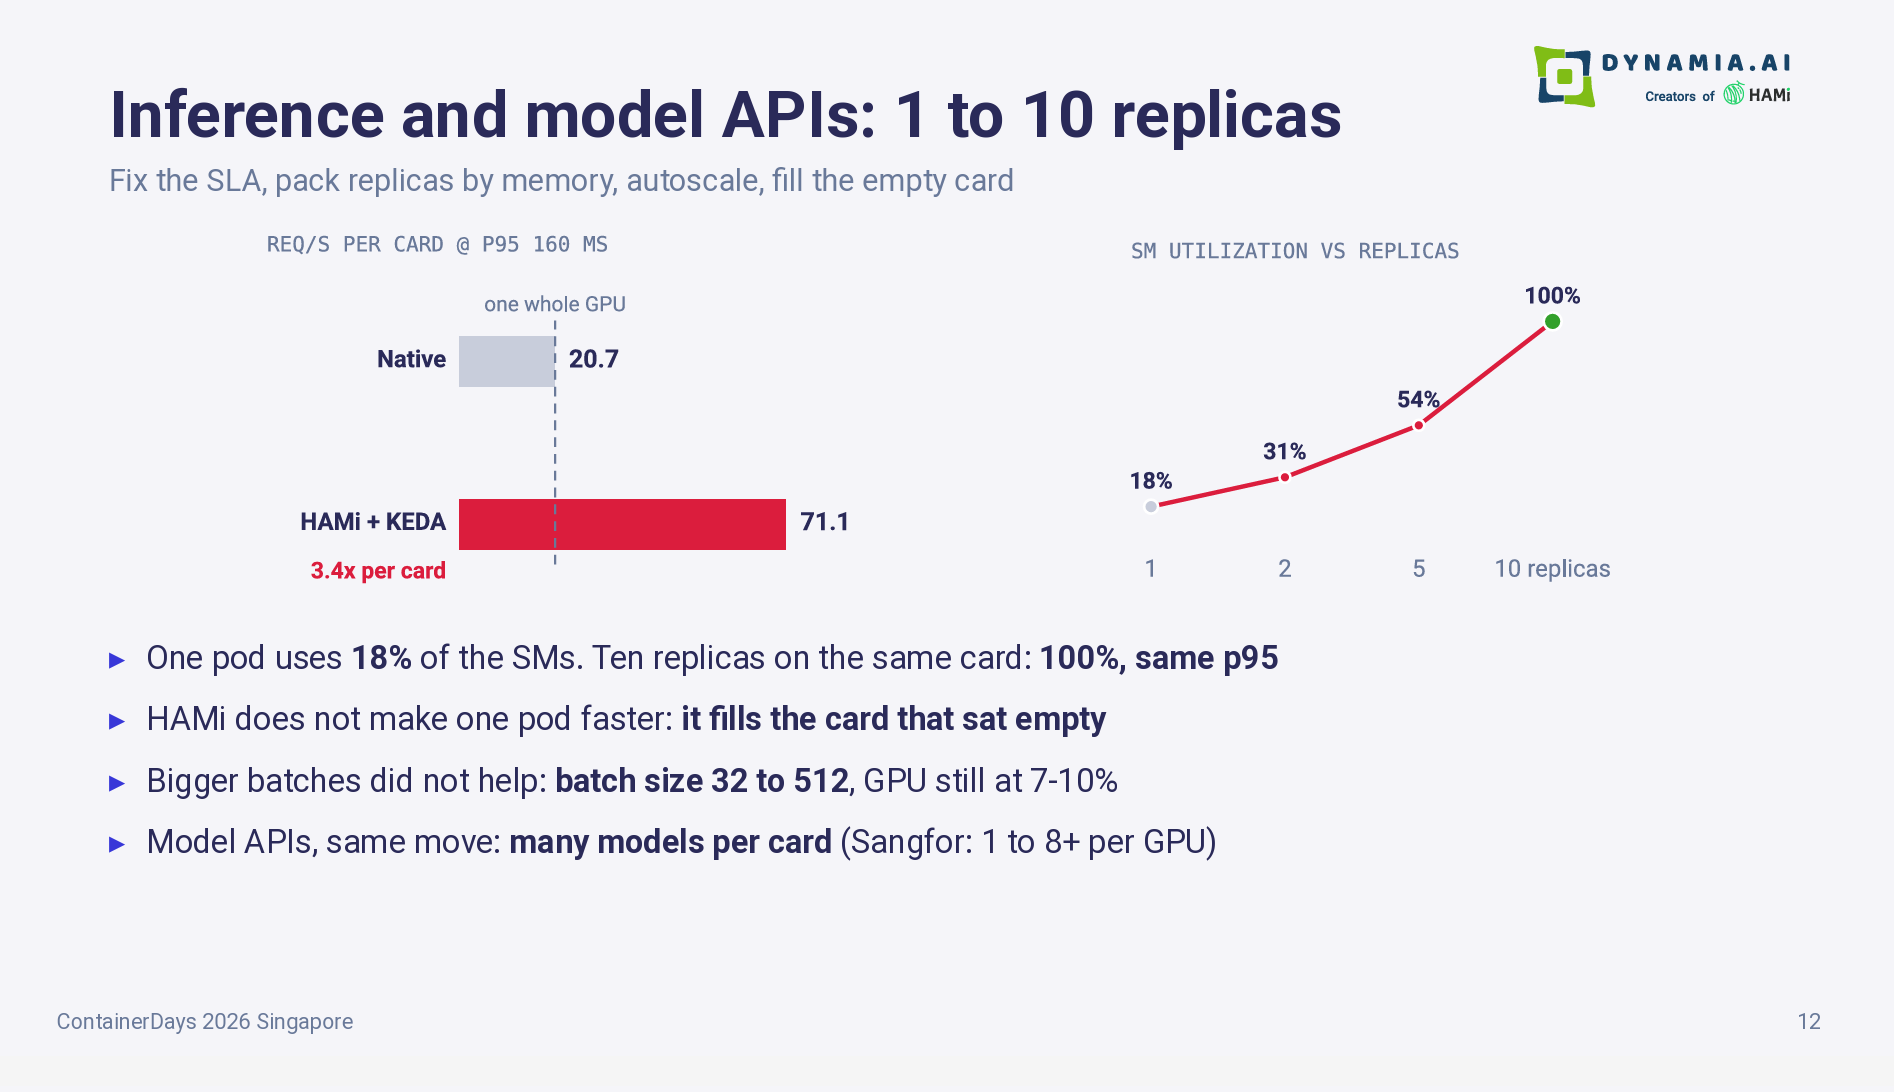
Reza 分享了相关测试与案例数据,展示不同数量的推理副本共享 GPU 时,设备利用率和服务表现的变化。
其中一组测试显示,在保持相同 p95 延迟水平的条件下,随着同一张 GPU 上的推理副本数量增加,GPU 计算资源利用率逐步提高。这一结果说明,对于资源需求较小、适合并发运行的工作负载,合理的 GPU 共享与调度能够提高设备的整体承载能力。
不过,GPU 共享并不适用于所有场景。
分享指出,大规模模型训练和大型 LLM 服务仍可能更适合使用整张 GPU;对于隔离要求较高的多租户环境,则需要结合 MIG 或独占设备等方式,提供更严格的资源隔离。
实际部署时需要先了解工作负载的资源需求,再决定采用共享还是独占方式,而不是一味追求更细的 GPU 切分粒度。
从单一 GPU 到异构算力管理
随着 AI 基础设施中 GPU、NPU 等设备类型不断丰富,如何在同一平台中管理异构资源,成为算力运营的重要课题。
分享介绍了 HAMi 对 NVIDIA、AMD、昇腾及其他异构算力设备的支持,以及如何通过统一的资源申请方式,结合不同硬件对应的资源限制机制,实现更灵活的设备管理。
在此基础上,HAMi 还可以与 Volcano、Kueue、KAI Scheduler 等项目协同,满足批处理、队列调度和多租户资源管理等不同需求。
对于企业而言,这意味着可以在保留现有 Kubernetes 技术体系的基础上,根据业务场景组合 GPU 共享、调度与资源管理能力,而不必将所有需求绑定在单一组件上。
从资源分配走向精细化运营
GPU 资源管理的另一项关键工作,是区分已分配资源与实际使用资源的用量。
例如,某个租户申请了较高的 GPU 资源配额,但实际运行时可能只使用其中一部分。如果只统计已分配资源,就很难准确判断设备的真实负载。
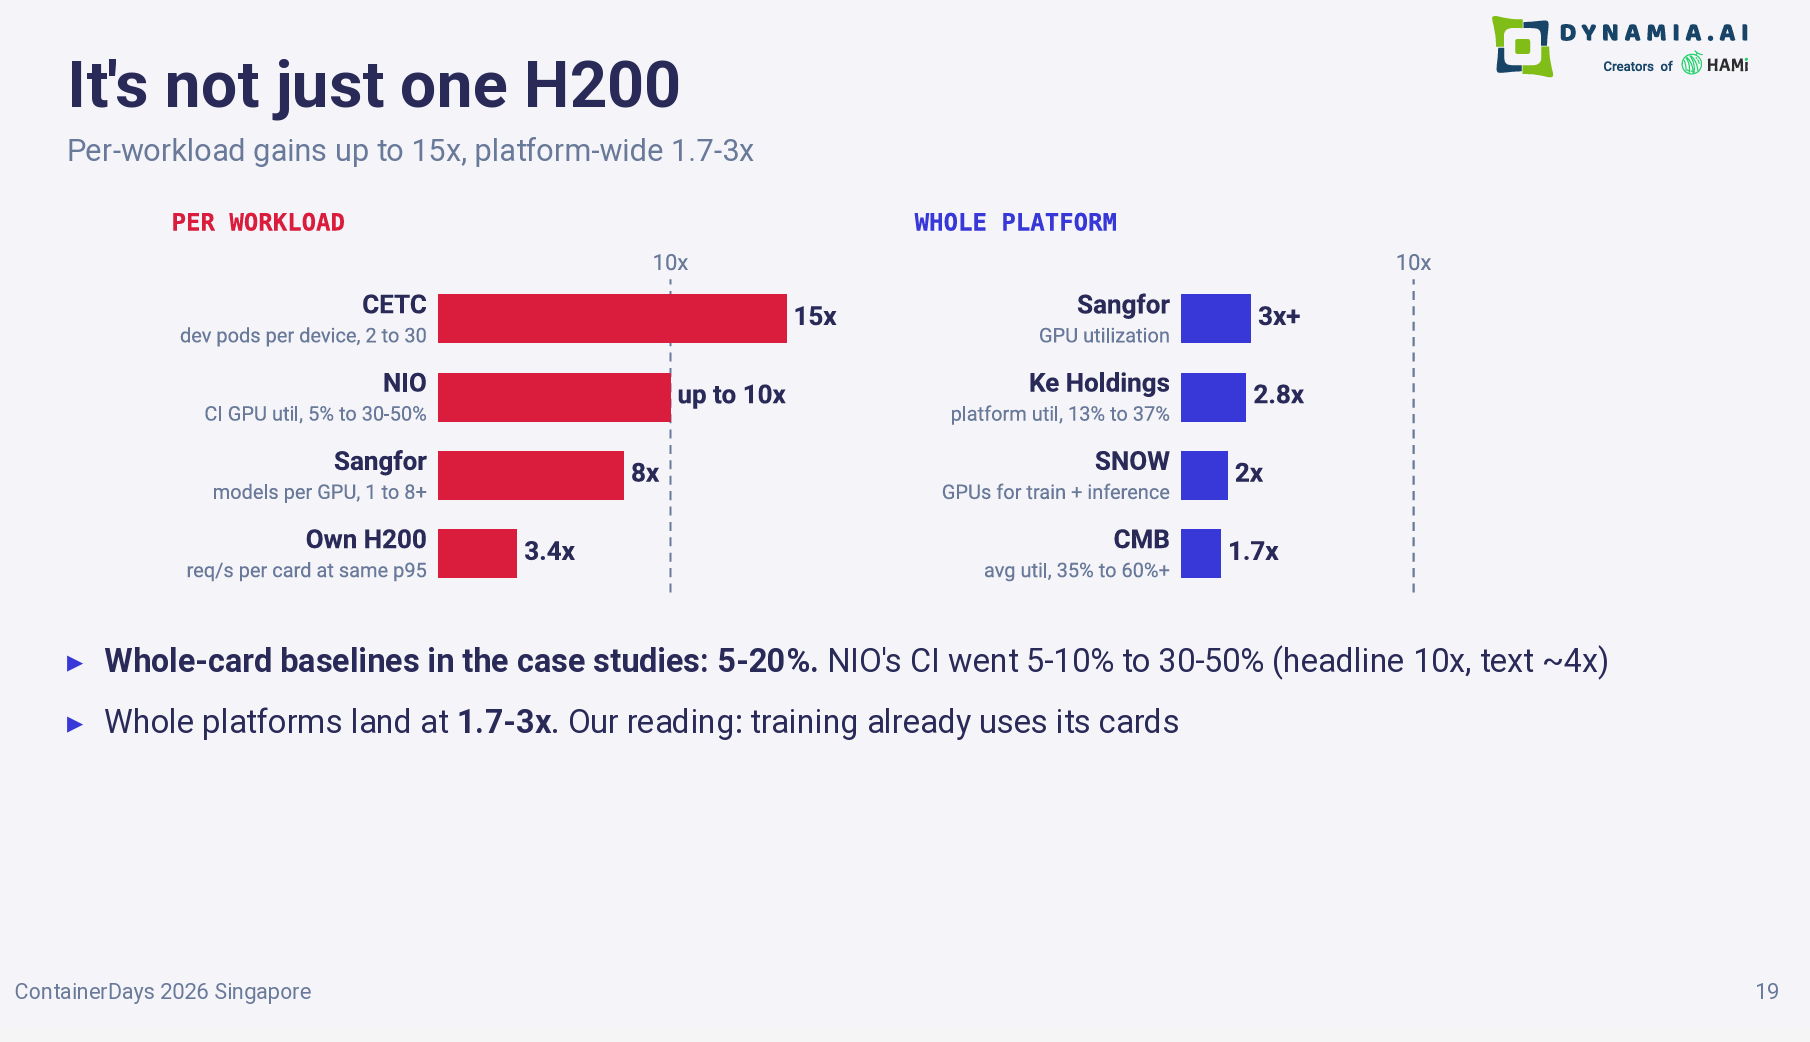
本场分享介绍了如何分别监控 GPU 的资源分配量与实际使用量,并将这些数据用于租户配额、资源计量和容量规划,结合多个生产案例,介绍了 GPU 共享、调度优化与弹性伸缩带来的实际效果。
这也说明,GPU 资源优化不能只看某个任务的测试结果,还需要结合平台整体的工作负载构成、调度方式和运行管理进行评估。
从试点到规模化:企业 AI 的实际价值
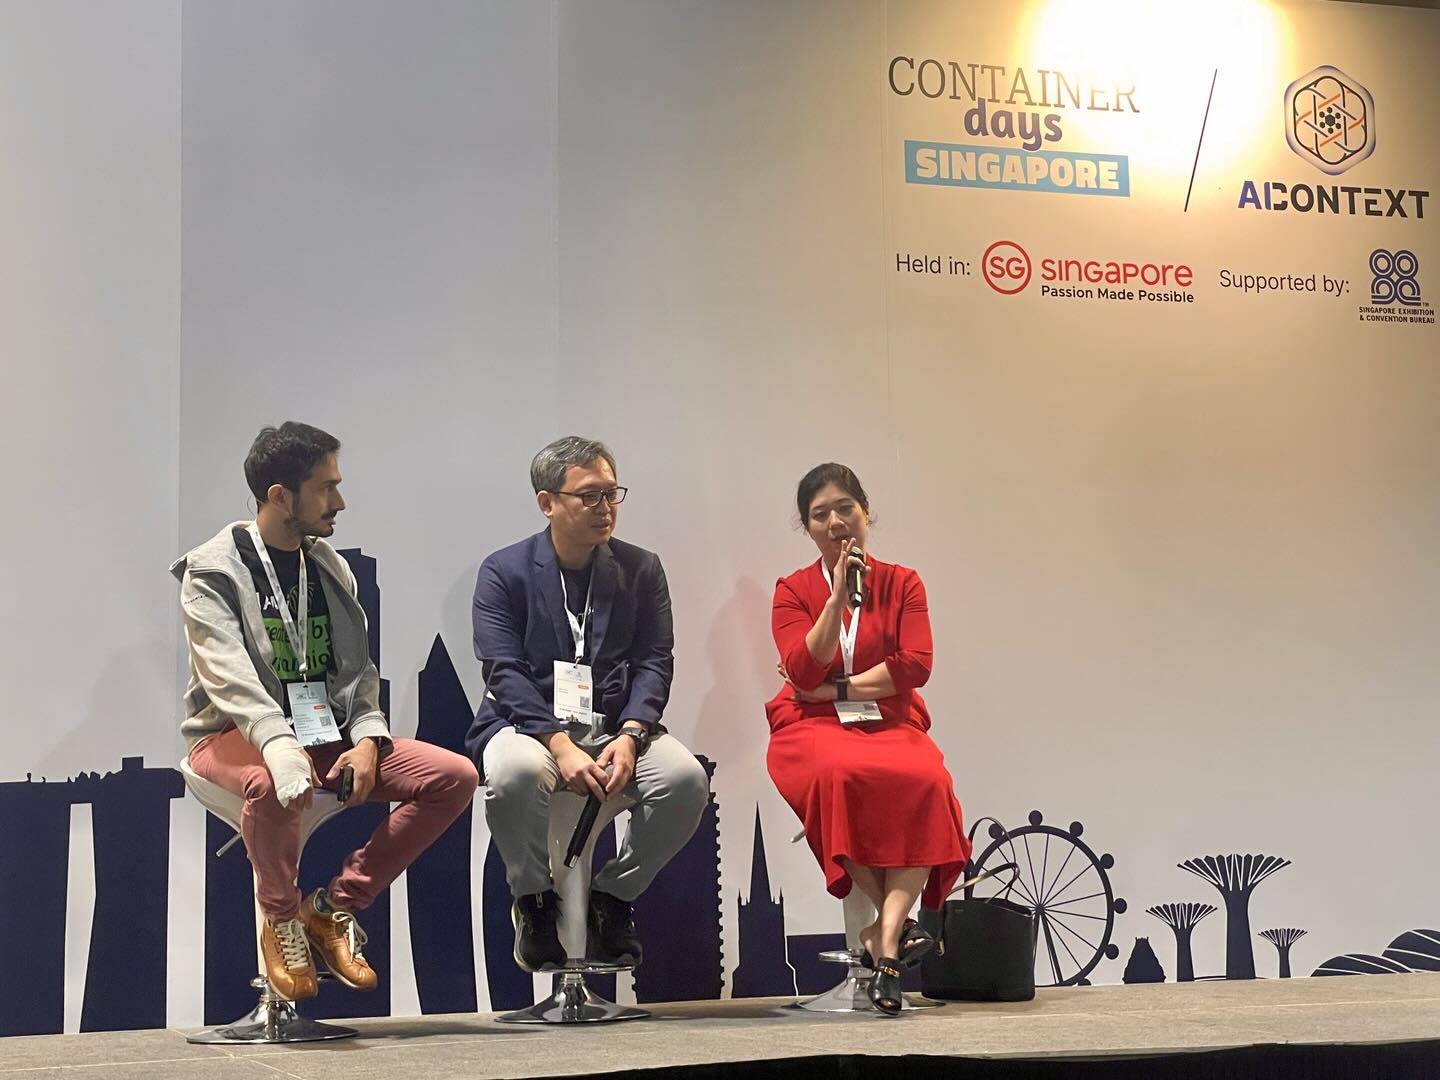
28日, Reza Jelveh 还主持了主题为 “Building Enterprise AI at Scale: From Pilots to Measurable Value” 的圆桌讨论。
讨论聚焦企业 AI 从试点验证走向规模化应用的关键挑战,包括如何将早期技术探索转化为可持续的生产部署,以及如何衡量 AI 应用带来的实际业务价值。
相比前两场围绕 GPU 共享、调度与资源利用率的技术分享,这场圆桌将视角进一步延伸至企业 AI 落地过程中的业务需求与价值评估。
两场分享分别从动手实践与生产应用出发,介绍了 HAMi 如何在 Kubernetes 中实现 GPU 共享与调度,以及这些能力在推理服务、异构硬件管理和多租户资源运营中的应用。
活动期间,密瓜智能团队与现场开发者及行业同行交流了 GPU 资源管理中的实际需求和技术实践。
作为 HAMi 开源项目的发起与持续推动者,密瓜智能将继续参与云原生与 AI 基础设施生态建设,推进 GPU 资源共享、异构算力调度与运行管理等方向的技术研发和开源协作,让更多企业能够灵活、高效地使用现有算力资源。