
模型越来越大,企业为什么仍然需要精细化算力调度?
 技术博客
企业在同一资源池中既要支持大模型的整卡和多卡部署,也要兼顾轻量推理、研发与批处理的按需共享。本文结合模型使用数据和生产集群研究,讨论如何按任务需求分配 GPU,并管理多团队共用的异构算力。
本文目录
从模型发展趋势、超大规模生产集群到企业AI应用,看算力基础设施的下一阶段
过去两年,模型能力一直是 AI 行业关注的焦点之一。从参数规模增长、推理能力增强,到 Agent 开始执行复杂任务,AI 的应用也从内容生成延伸到企业的生产流程。
当模型越来越大,单卡显存难以满足部分模型的运行需求,企业为什么还需要 GPU 虚拟化?随着整卡和多卡部署增多,GPU 共享和资源切分的价值会不会减弱?
对单个大模型来说,整卡甚至多卡往往更合适。但企业在生产环境里还会运行检索、排序、轻量推理和研发验证等任务。这些任务对显存、算力和响应时间的要求各不相同,其中一些只需要一张卡的部分资源。
整卡、多卡和按需共享的需求同时存在,正是企业需要精细化调度算力的原因。要看清这些需求怎样影响资源分配,可以先从企业实际会运行哪些模型和任务说起。
模型越来越大,但企业并没有只使用一种模型
关于未来AI模型的发展方向,行业中一直存在两种观点。
一种认为模型能力将持续向更大规模集中,前沿大模型会逐渐覆盖更多任务;另一种认为小模型凭借成本、部署和响应速度优势,会在企业场景中获得越来越广泛的应用。
OpenRouter 的调用数据提供了一个观察角度。
2025年12月,OpenRouter与a16z联合发布了《State of AI: An Empirical 100 Trillion Token Study》,基于OpenRouter平台超过100万亿Token的真实交互数据,分析了模型使用、开发者行为和AI应用趋势。
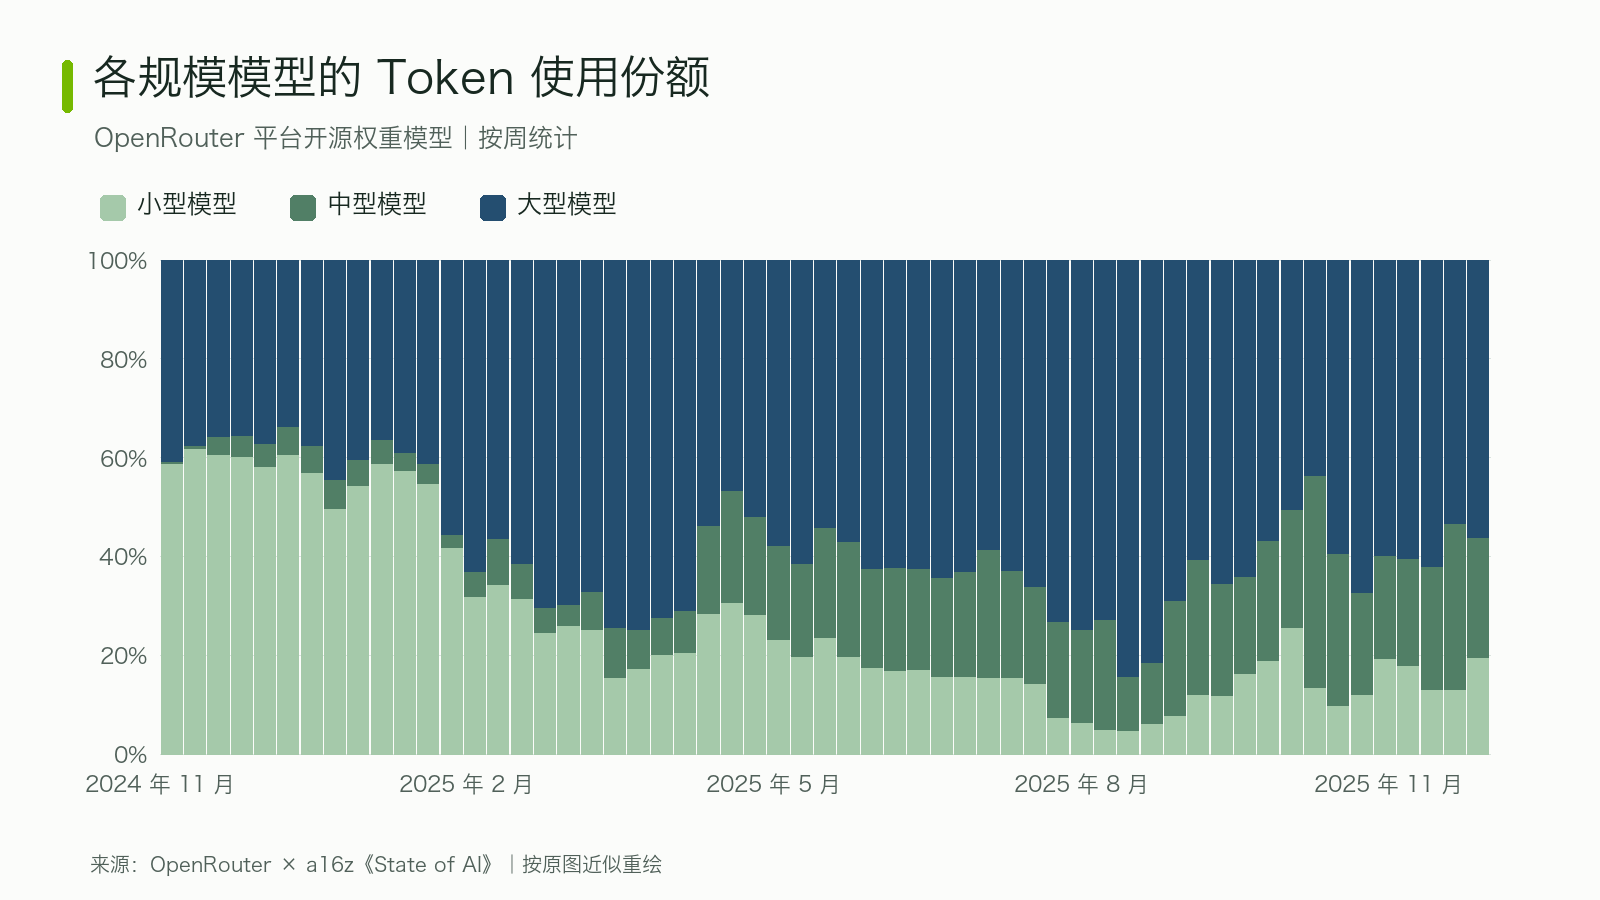
研究将开源权重模型分为小模型、中型模型和大型模型三个规模区间。
研究发现,过去一年开源模型的使用结构发生了明显变化:小模型的Token使用份额有所下降,而中型和大型模型的使用份额呈现增长趋势。
报告提出了一个值得关注的判断:
Medium is the New Small——中型模型正在成为新的小模型。
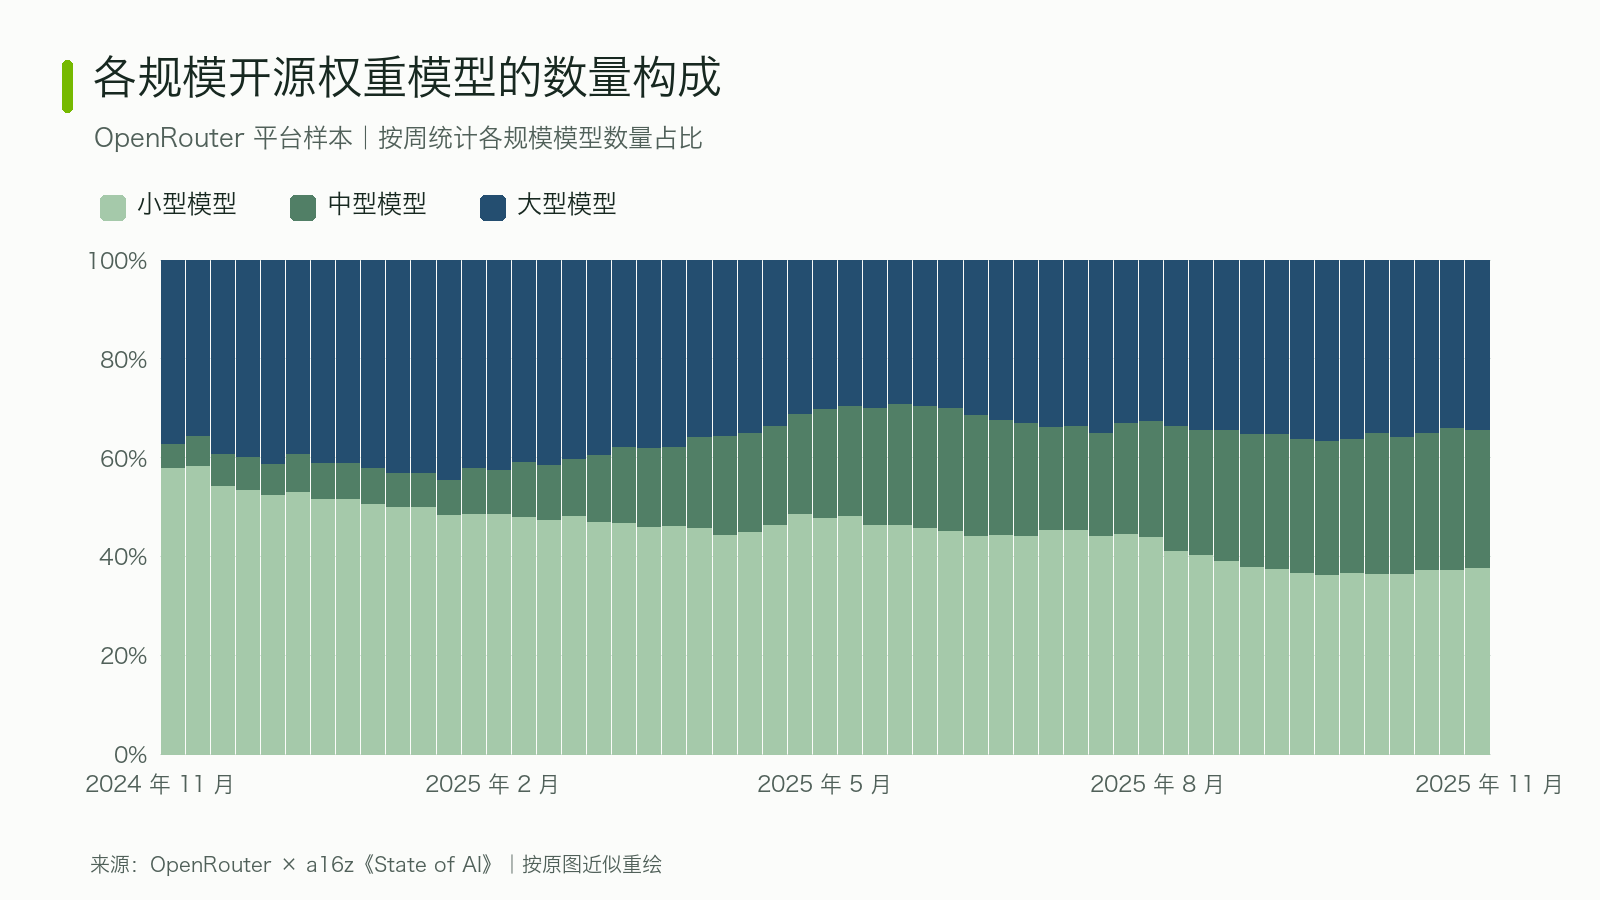
中型模型为开发者提供了一个在能力和部署成本之间做取舍的选项。
OpenRouter 的调用数据呈现了不同规模模型的使用变化,Menlo Ventures 的报告则显示,企业仍愿意为高价值任务选用能力更强的模型。落到具体业务,企业会结合任务难度、准确性、响应速度和部署成本来选模型。
例如,一个企业 AI 系统可能同时承担以下任务,模型的选择随任务而变:
- 大模型:处理复杂推理、规划和决策;
- 中型模型:承担专业领域任务和部分生产推理;
- 小模型:完成分类、信息抽取、意图识别等相对固定的任务;
- Embedding与Rerank模型:负责检索和相关性排序;
- 多模态模型:处理图像、语音和视频等不同类型的数据。
其中一些服务可以通过云端 API 调用。对于自建 AI 基础设施、私有化部署或运营 GPU 资源池的企业,更直接的问题是:当这些显存、算力和时延要求不同的任务进入同一个资源池,现有 GPU 能不能分到需要它的任务上?
AI 进入生产阶段,算力效率要放到集群里看
前一节讨论的是企业会用到哪些模型和任务。到了生产集群,这些需求能否得到满足,还取决于 GPU 与 CPU、网络等资源在各节点上的分布。阿里巴巴的一项生产集群研究,把这个问题放到了实际运行环境里观察。
2026年7月,在USENIX OSDI 2026上发表的论文《Heterogeneity at Hyperscale: Characterization and Scheduling of Large Production AI Clusters at Alibaba》,对阿里巴巴Serverless Infrastructure(ASI)生产集群进行了系统研究。
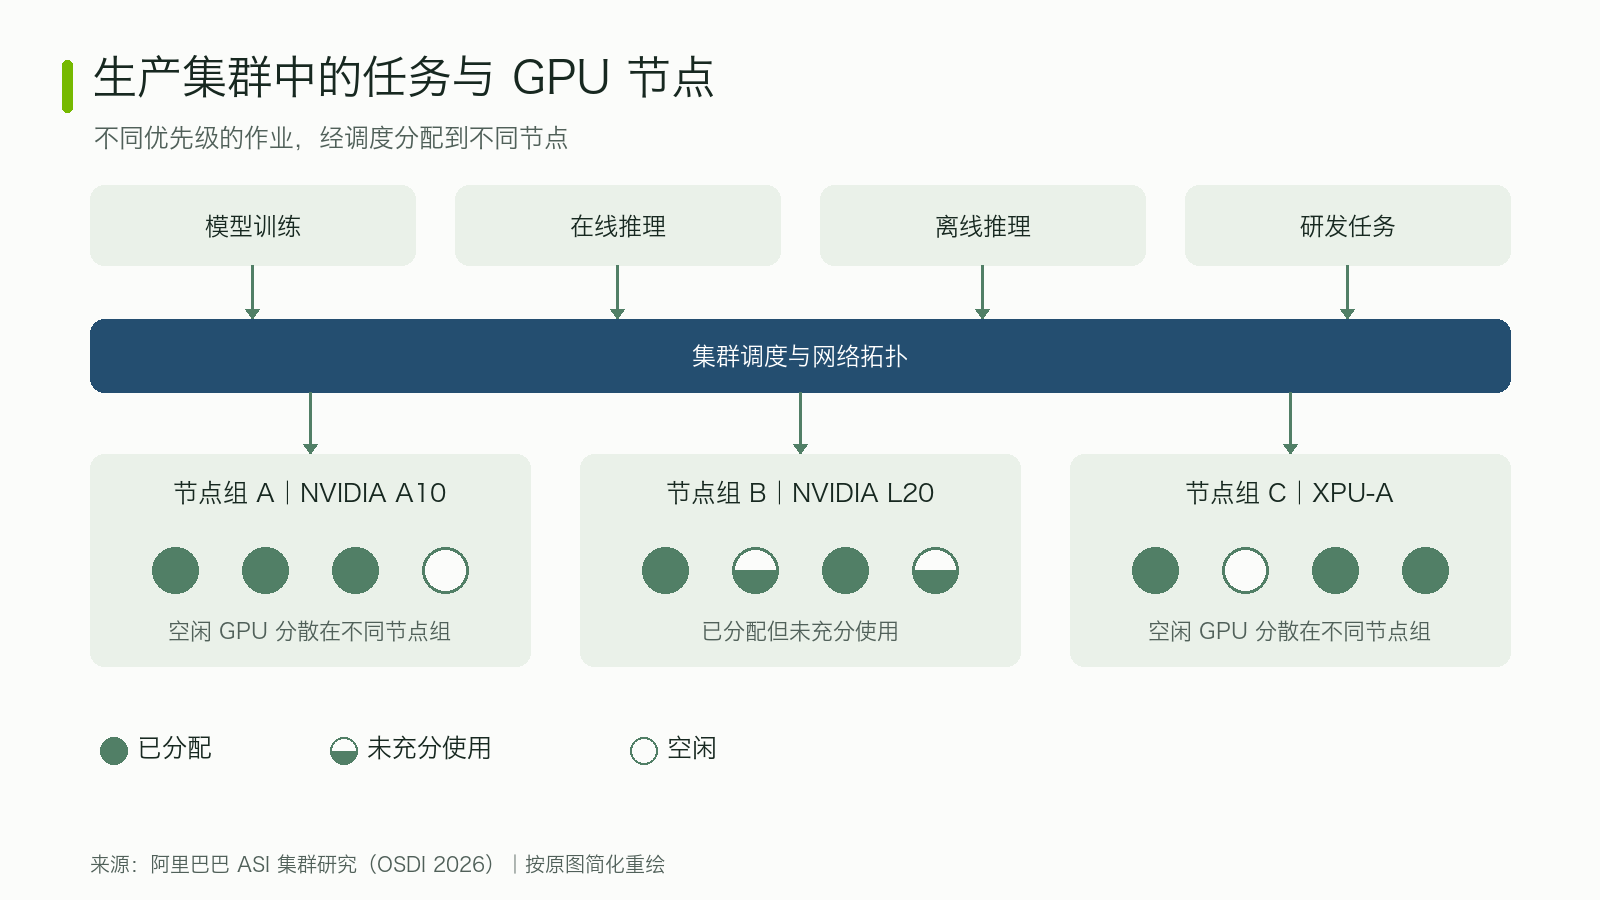
研究基于长达六个月的生产数据,覆盖155,410张来自不同厂商和不同代际的GPU、81个业务部门,以及临时研发、模型训练、在线推理和离线推理等多种工作负载。
研究发现,即使 GPU 需求旺盛,集群里仍有一部分闲置资源难以分配。这与资源在节点上的分布、任务对 CPU 和网络的要求,以及生产业务的预留策略有关,具体可以分成四类。
1. 节点资源碎片化
空闲GPU分散在不同节点,虽然集群整体存在剩余资源,但无法满足某些任务对GPU数量及节点资源组合的要求。
2. CPU与GPU资源不匹配
部分节点虽然有空闲GPU,但没有足够或匹配的CPU资源,导致GPU无法被任务有效使用。
3. 网络拓扑限制
对于需要多GPU协同运行的任务,设备之间的网络连接和拓扑位置会影响任务能否被有效部署。即使集群中存在空闲GPU,也不一定能满足任务对通信条件的要求。
4. 生产环境资源预留
企业为了应对业务峰值和保障服务稳定性,通常会预留一定的算力容量。这些资源在部分时段可能处于空闲状态,但不能直接被其他任务无条件使用。
针对这些问题,研究团队在生产环境中部署了两项优化方案,分别从集群资源组织和任务调度两个层面改善资源使用效率。
第一,GPU Defragmentation:集群级资源碎片整理。
该方案通过调整GPU资源在不同节点上的分布,减少零散剩余资源带来的分配困难。
研究结果显示,经过资源整理,存在剩余资源的节点数量减少了20.2%。
第二,让可抢占任务使用暂时闲置的 GPU。
Spot GPU 指以较低价格提供、可被回收的 GPU 算力。它适合能接受中断的任务。阿里巴巴在 OSDI 2026 论文中将这套调度方案命名为 SpotGPU:高优先级任务暂时释放 GPU 时,可抢占任务可以使用这部分资源;高优先级任务需要恢复时,调度系统收回资源,并尽量选择中断后计算损失较小的任务。
在论文观察的集群中,引入该方案后,GPU 分配率从 68% 提升至 93%。这里需要明确,93%指GPU资源分配率,而不是GPU计算利用率。两者衡量的是不同指标。
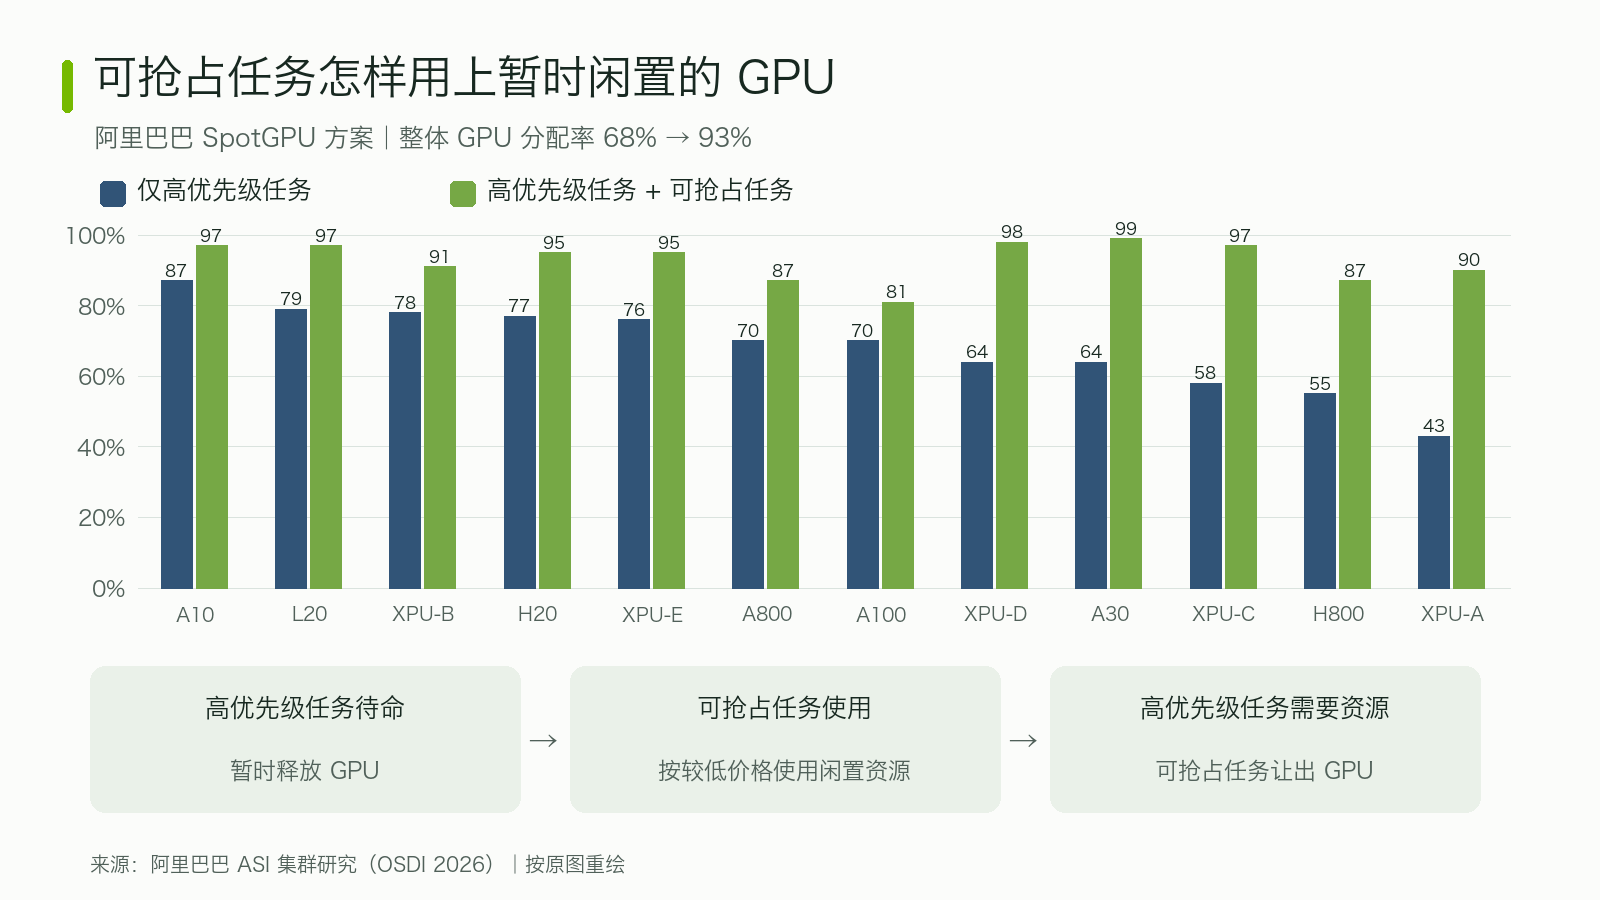
这两项实践说明,面对超大规模异构GPU集群,资源整理和任务调度能够在不单纯依赖增加硬件投入的情况下,释放原本难以有效分配的算力资源。
但这项研究还有一个更值得关注的发现:在该生产集群中,由于GPU共享使用较少,单张GPU内部的细粒度资源碎片已经不是主要的效率瓶颈。
这个发现需要放回研究所观察的环境里看。卡内碎片是指一张 GPU 内剩余的资源难以继续分配;集群碎片则是空闲卡散在不同节点,凑不成任务需要的资源组合。在这个样本集群中,节点分布、CPU 配套、网络拓扑和生产预留,对资源能否分出去的影响更直接。
集群的分配效率,取决于设备、节点和配套资源能否组成任务需要的组合。单看 GPU 有没有被占用,很难判断现有资源还能承接哪些任务。
整卡、多卡还是共享,企业该怎么选?
一项大模型任务可能需要多张 GPU 协同运行,几个轻量推理实例也可能共用一张 GPU。前一种情况,要看集群能否配齐显存、算力和通信条件都合适的一组卡;后一种情况,要看同卡运行时,各实例能否拿到足够的资源,响应时间是否仍能达标。企业选择整卡、多卡还是共享,可以从这两类需求出发,再结合具体任务判断。
对于大规模模型训练和高负载推理,整卡甚至多卡协同可能是更合理的选择。
这类任务通常需要持续、稳定的计算资源,对GPU之间的通信、显存容量和整体吞吐有较高要求。强行共享可能带来额外的资源竞争,影响任务效率。
对于多个轻负载模型的推理服务,共享则可能带来更好的资源利用效率。
例如,一个企业同时运行多个分类、Embedding、Rerank和专业领域模型。这些模型的流量、显存需求和计算负载并不完全相同。
如果每个模型都独占一张GPU,就可能出现部分资源长期闲置,而其他任务又需要等待GPU的情况。
对于研发测试和离线批处理任务,灵活分配同样具有价值。
Notebook、模型调试、参数实验、批量评测等任务,往往不需要持续独占整张GPU。通过合理的资源共享、配额管理和调度,可以减少不必要的资源占用。
选定用卡方式后,还要看它在高峰期是否有效:多卡任务能否拿到成组资源,共享任务的吞吐和时延是否达标。等到多个团队在同一批资源上长期运行,这些分配选择还需要通过配额、优先级和使用记录落实到日常管理中。
从GPU虚拟化到异构算力资源治理
单个任务怎么用卡,只解决了一次分配。多个团队长期共用算力时,平台还要持续回答:资源分布在哪些集群,谁能用多少,紧张时优先保障谁,以及分出去的资源到底用了多少。
未来企业可能同时面对:
- 不同规模和架构的AI模型;
- 训练、推理、研发和批处理等不同任务;
- NVIDIA GPU、国产 GPU 等不同类型的算力;
- 多部门、多租户和不同优先级的资源需求;
- 对吞吐、延迟、稳定性和成本有不同要求的生产业务。
在这样的环境下,单纯依靠硬件数量增加,并不能解决所有资源管理问题。
企业需要的是一套能够连接上层AI工作负载与底层异构硬件的资源管理能力。
它至少应该包含几个层面:
1. 异构资源统一管理
面对来自不同厂商、不同型号的算力资源,提供尽可能一致的资源管理和使用方式。
2. 灵活的资源分配
根据任务实际需求,在整卡使用、GPU共享和不同资源份额之间进行选择。
3. 资源隔离与性能保障
避免不同任务之间产生不可控的资源争用,并根据业务要求提供相应的性能保障。
4. 多租户与资源治理
让不同部门、团队和业务拥有明确的资源配额、优先级和使用边界。
5. 可观测与成本管理
不仅知道GPU被分配给了谁,还要了解资源实际使用情况、任务效率和成本表现。
这些能力并不需要由单一组件全部完成。GPU虚拟化、Kubernetes原生设备资源管理和各类任务调度系统需要协同工作,共同构成企业AI基础设施的资源管理体系。
五、从算力管理到基础设施效率:密瓜智能的长期实践
当多个团队开始共用不同类型的 GPU,前面讨论的配额、隔离和使用记录,都需要落实到企业已有的集群和工作流程里。
密瓜智能(Dynamia)由 CNCF 项目 HAMi 的发起与核心维护团队创立,致力于构建 AI 基础设施的开源内核。我们帮助 AI 团队让异构 GPU 与 AI 芯片资源更易用、更高效、更可治理,将复杂算力转化为可共享、可隔离、可按需使用的云原生基础设施能力。
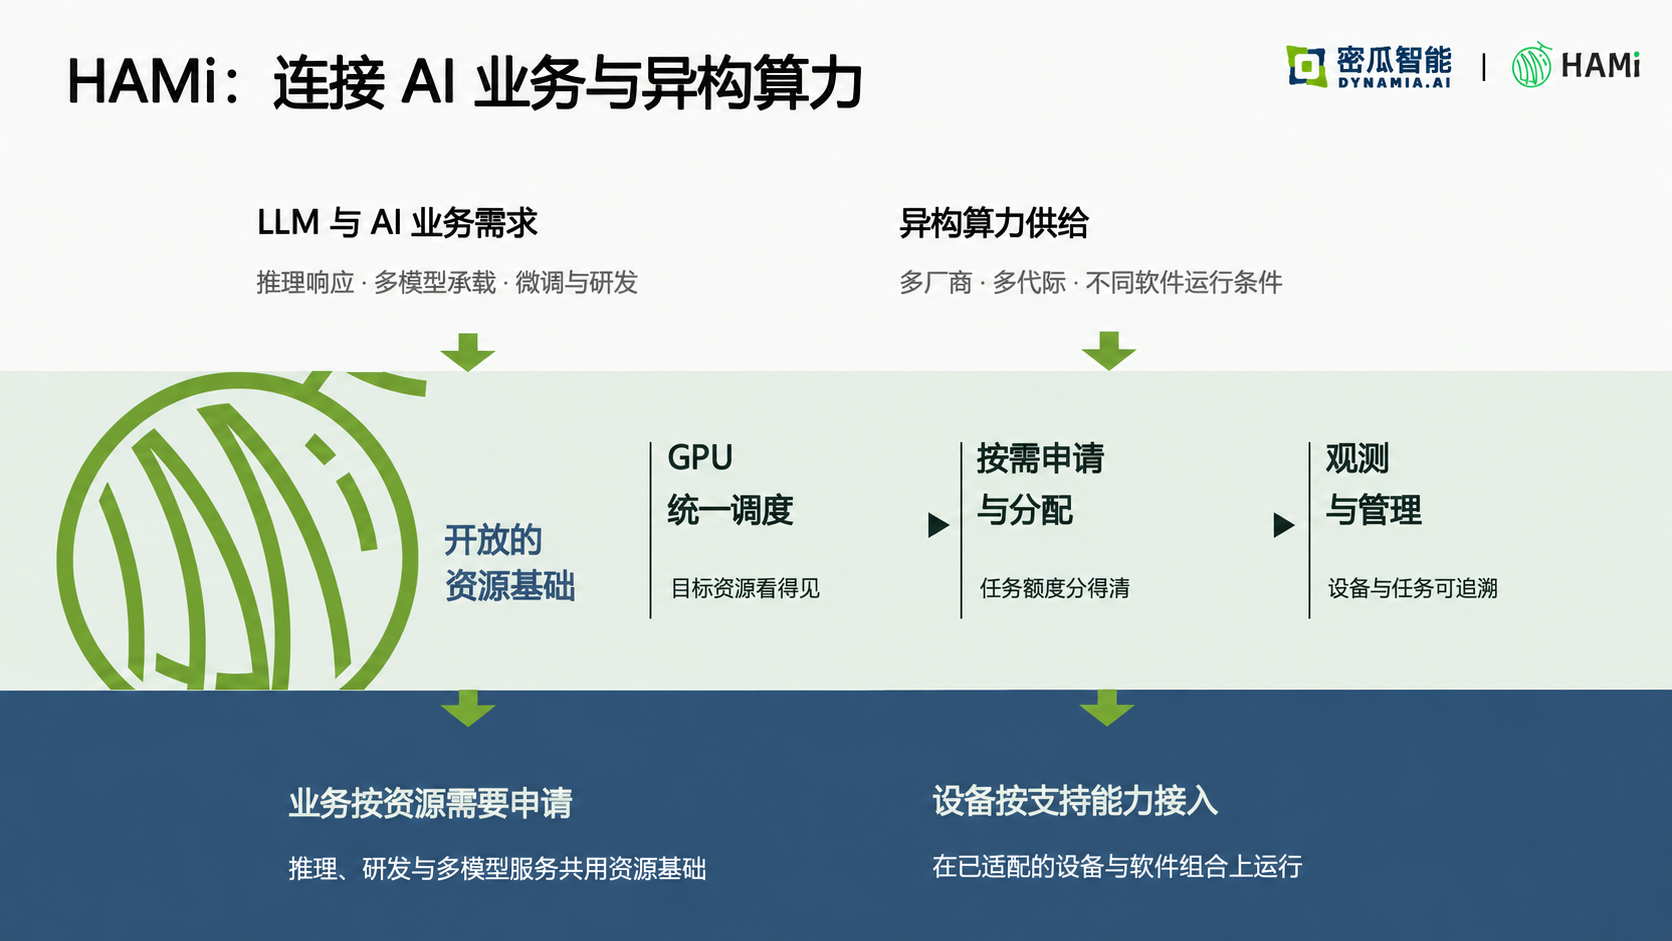
基于开源 HAMi,密瓜智能面向企业生产环境提供算力调度产品与技术服务,覆盖从单个作业的 GPU 分配到多团队、多集群的资源管理。在设备层,HAMi Enterprise 让适合共享的任务按显存和算力需求用卡,为大模型 Token 工厂持续提供模型推理所需的算力;在平台层,HAMi AI Platform 帮助团队看清已接入集群的资源分布和用量,设置团队配额与访问权限,并在企业版能力基础上,把模型部署、推理服务、运行观测和资源运营接到同一个平台。多卡任务的拓扑匹配、集群资源整理和作业调度,还需要与相应的集群调度组件配合。
随着AI模型和应用持续演进,密瓜智能将继续深耕AI基础设施底层技术,与开源社区、硬件厂商、平台伙伴及企业用户共同推动异构算力生态的发展。
参考研究
- OpenRouter & Andreessen Horowitz,《State of AI: An Empirical 100 Trillion Token Study》,2025年12月。
https://openrouter.ai/state-of-ai/ - Suyi Li et al.,《Heterogeneity at Hyperscale: Characterization and Scheduling of Large Production AI Clusters at Alibaba》,USENIX OSDI 2026。
https://www.usenix.org/conference/osdi26/presentation/li-suyi - Menlo Ventures,《2026: The State of Enterprise AI》,2026年11月。
https://menlovc.com/perspective/2026-the-state-of-enterprise-ai/
注:本文引用的行业支出数据属于研究机构估算,模型使用数据来自特定平台样本,GPU集群研究来自特定生产环境。不同研究的样本和统计口径不同,不宜直接进行横向比较。