密瓜智能分享 vLLM 集群优化实践,让算力更好支撑企业 AI
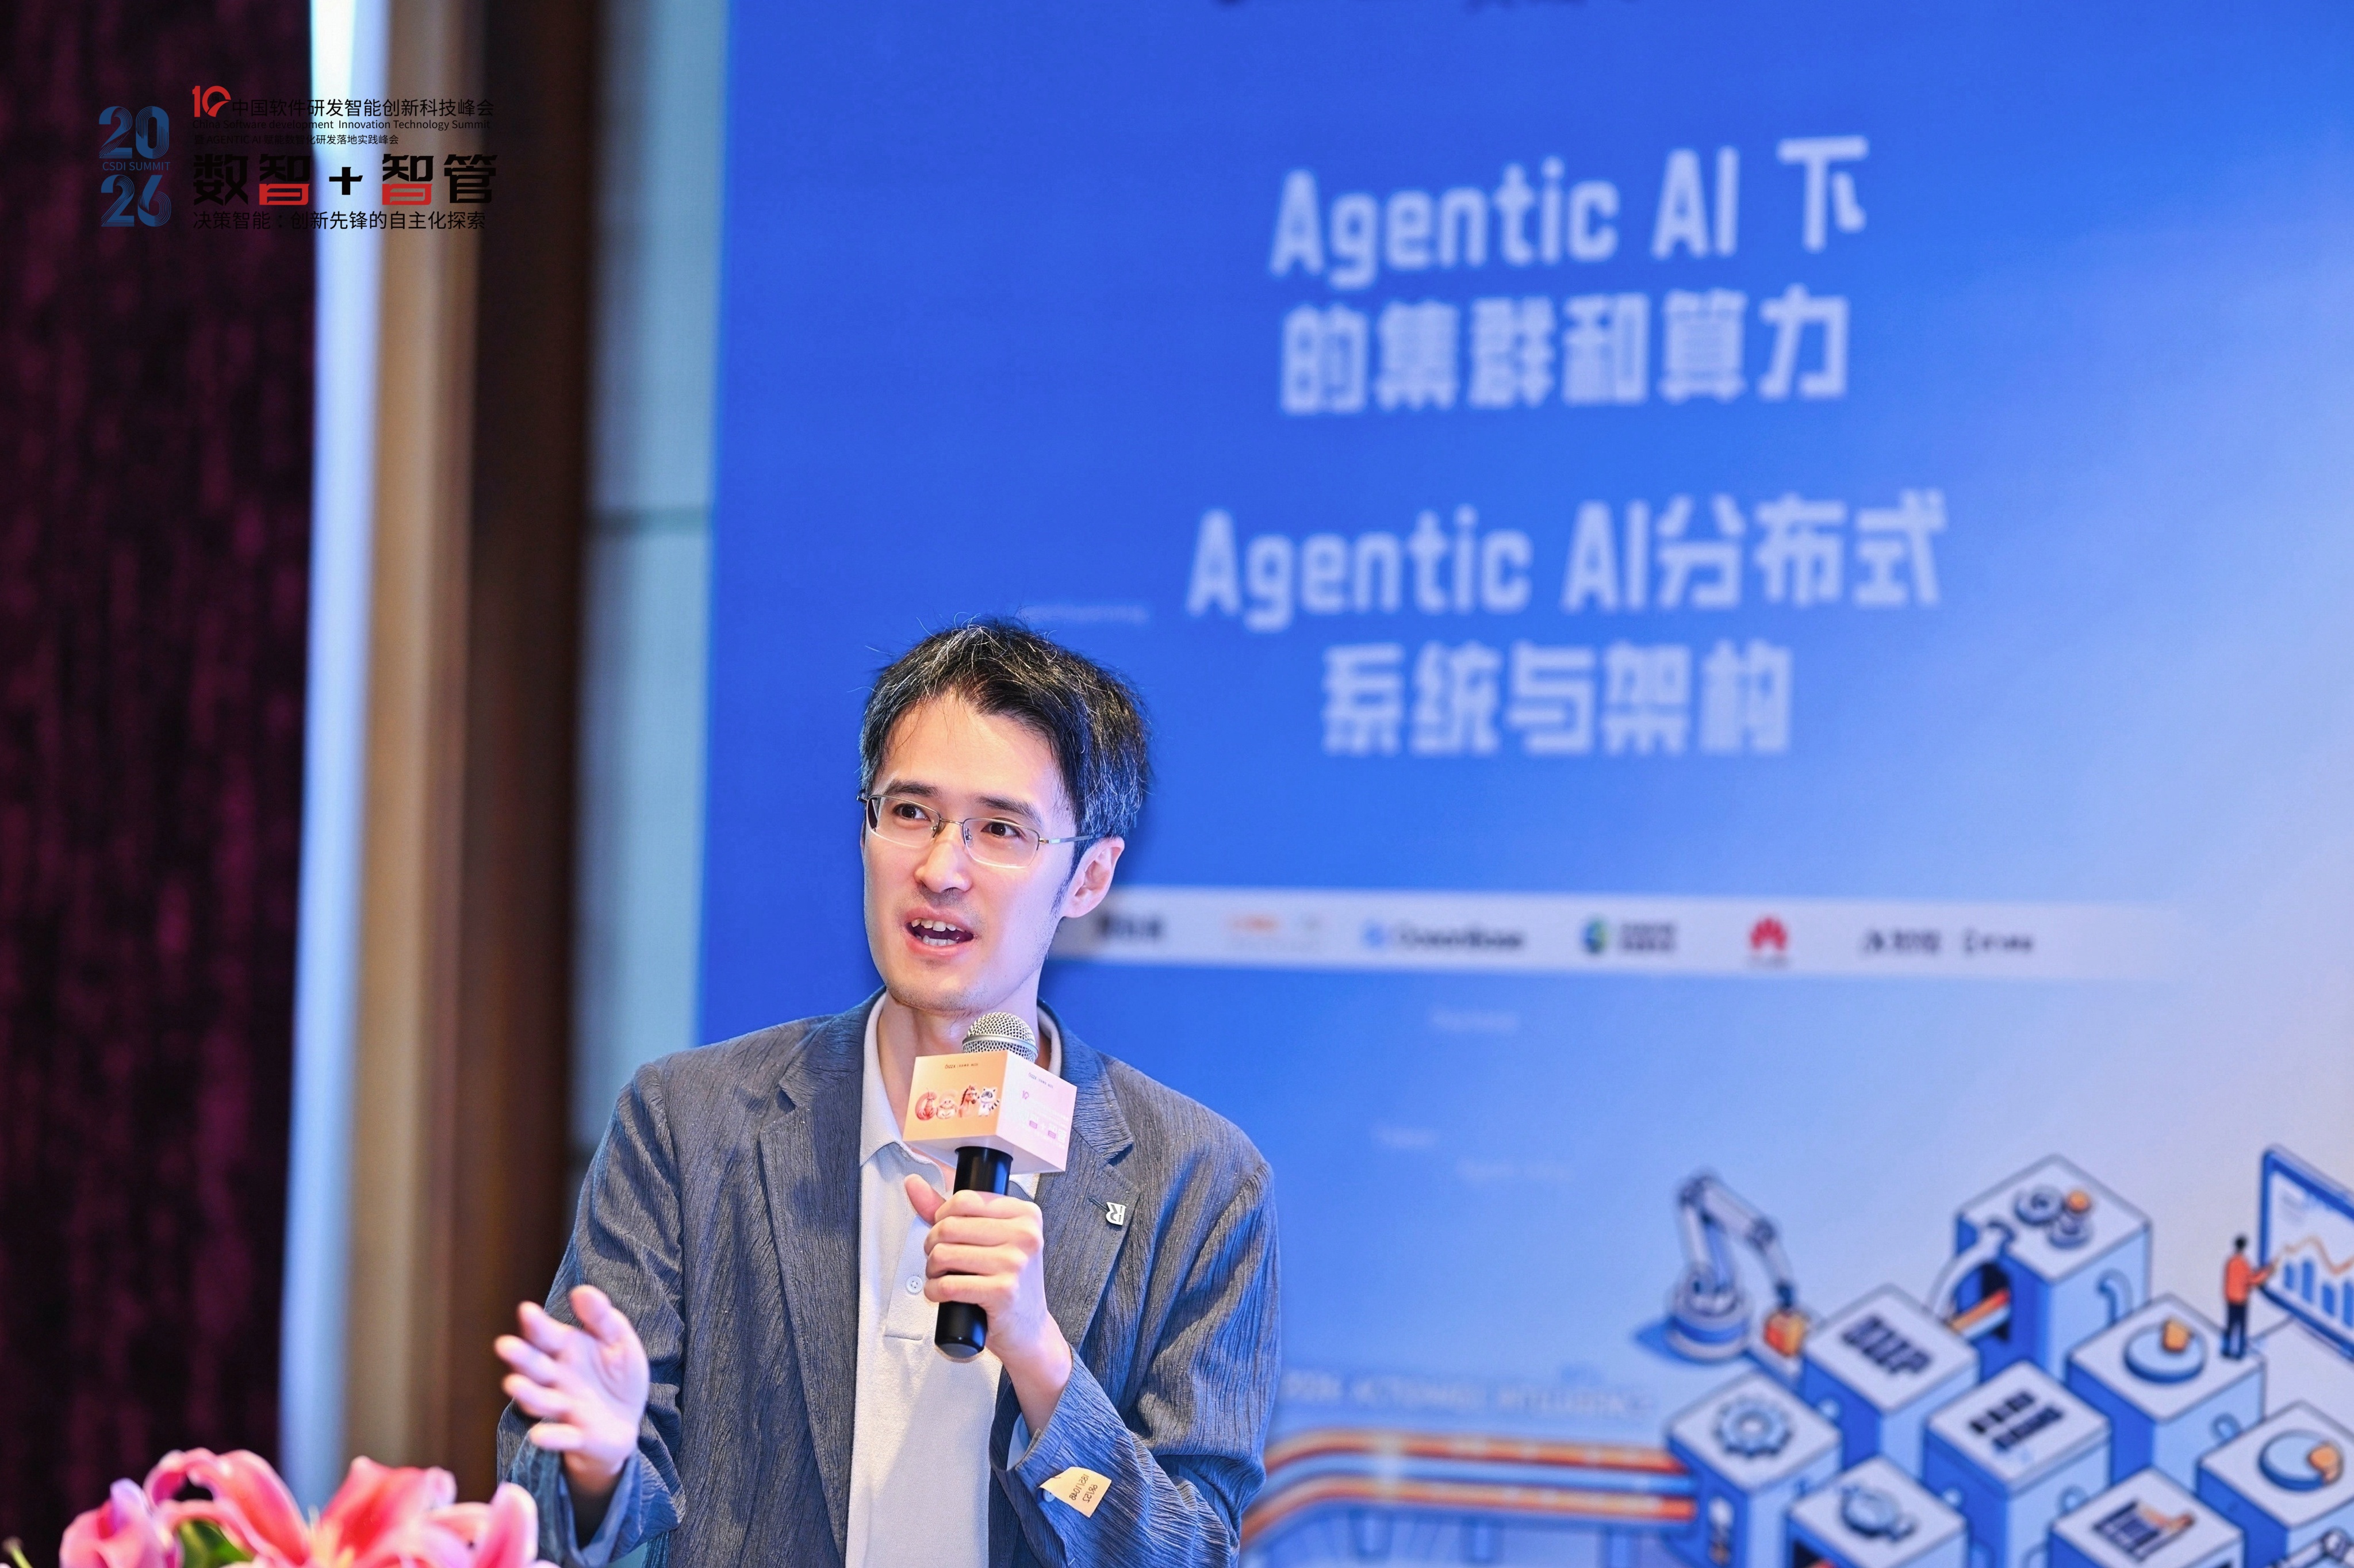
2026 年 10 月 16—18 日,由百林哲主办的第十届 CSDI 中国软件研发智能创新科技峰会暨 Agentic AI 赋能数智化研发落地实践峰会在深圳大中华喜来登酒店顺利举办。本届峰会以**“数智 + 智管”**为主题,围绕 Agentic AI 与企业研发实践展开交流。密瓜智能(Dynamia)联合创始人兼 CTO 李孟轩担任“Agentic AI 下的集群和算力”专场出品人,并带来《提升企业算力利用率,用好 GPU——vLLM 推理集群优化》主题分享。
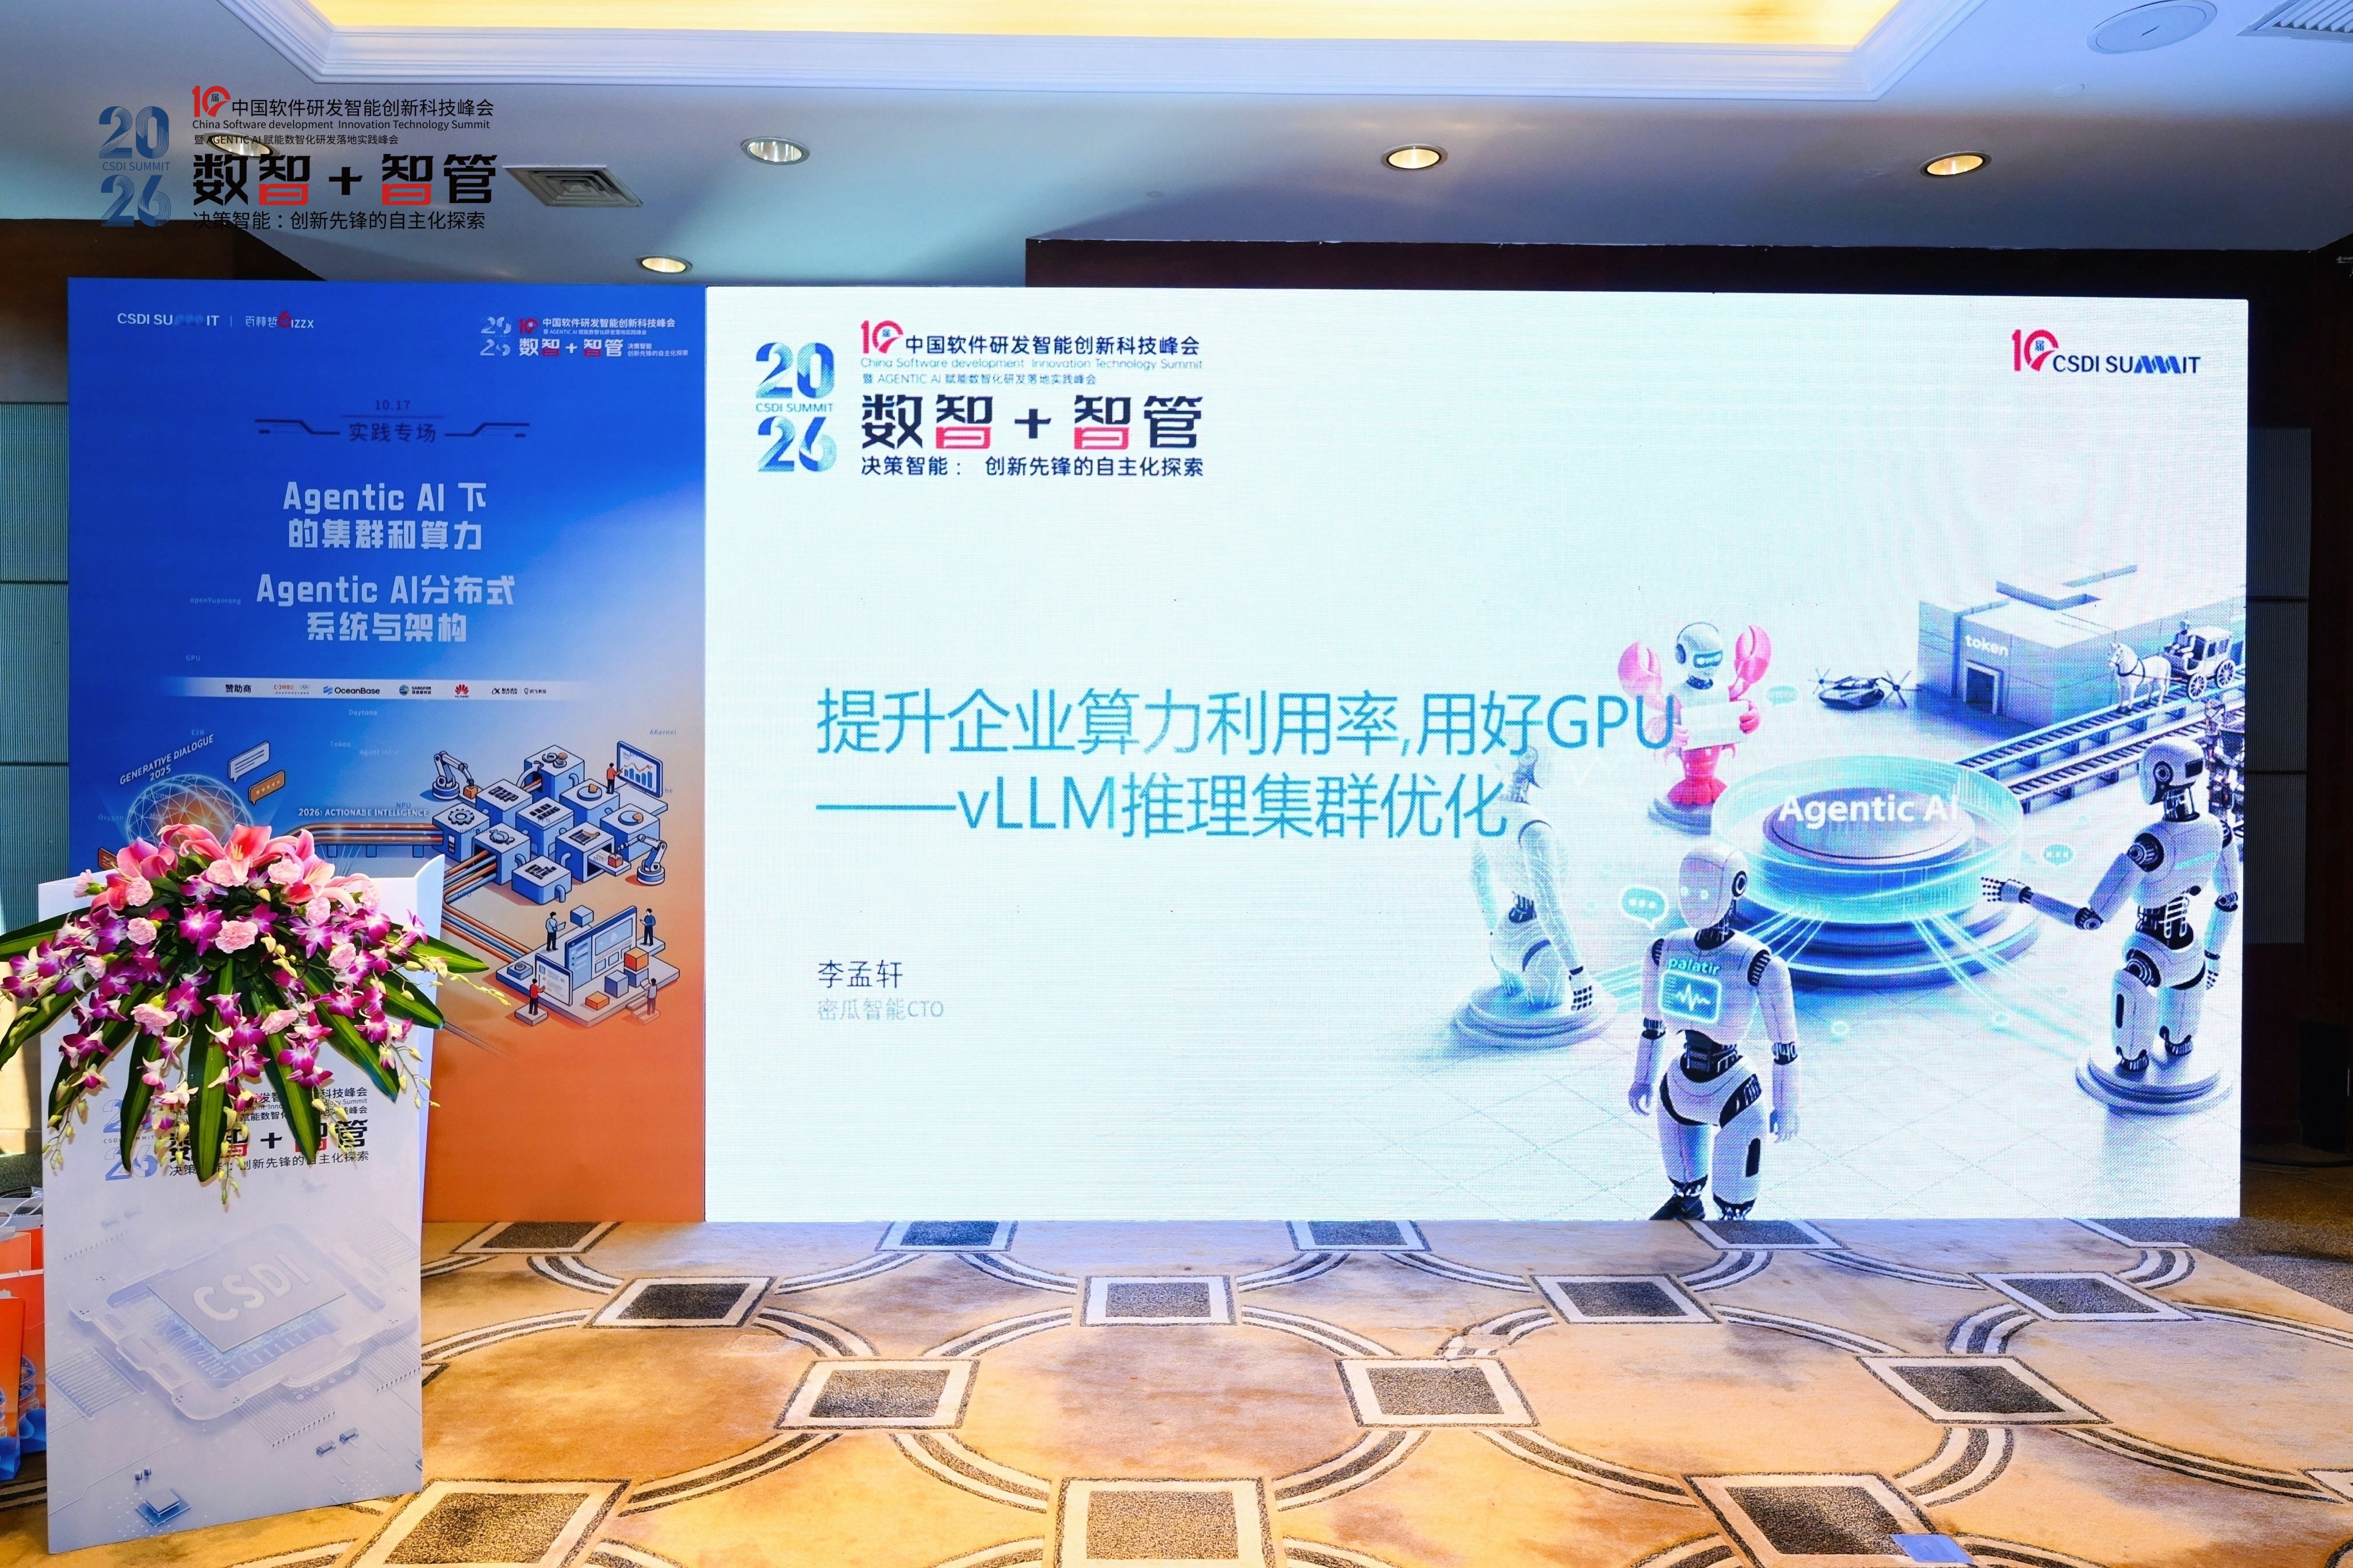
本届峰会议题覆盖企业 AI 平台、智能体产品、研发工程与分布式基础设施等方向。其中,“Agentic AI 下的集群和算力”专场将 vLLM 推理集群优化、面向 AI 工作负载的异构算力调度、以异构算力构建 AI 基础设施等议题放在一起讨论,连接推理服务与底层资源管理,为企业理解算力如何支撑 Agentic AI 应用提供了多层次视角。
围绕体验与成本,优化推理集群
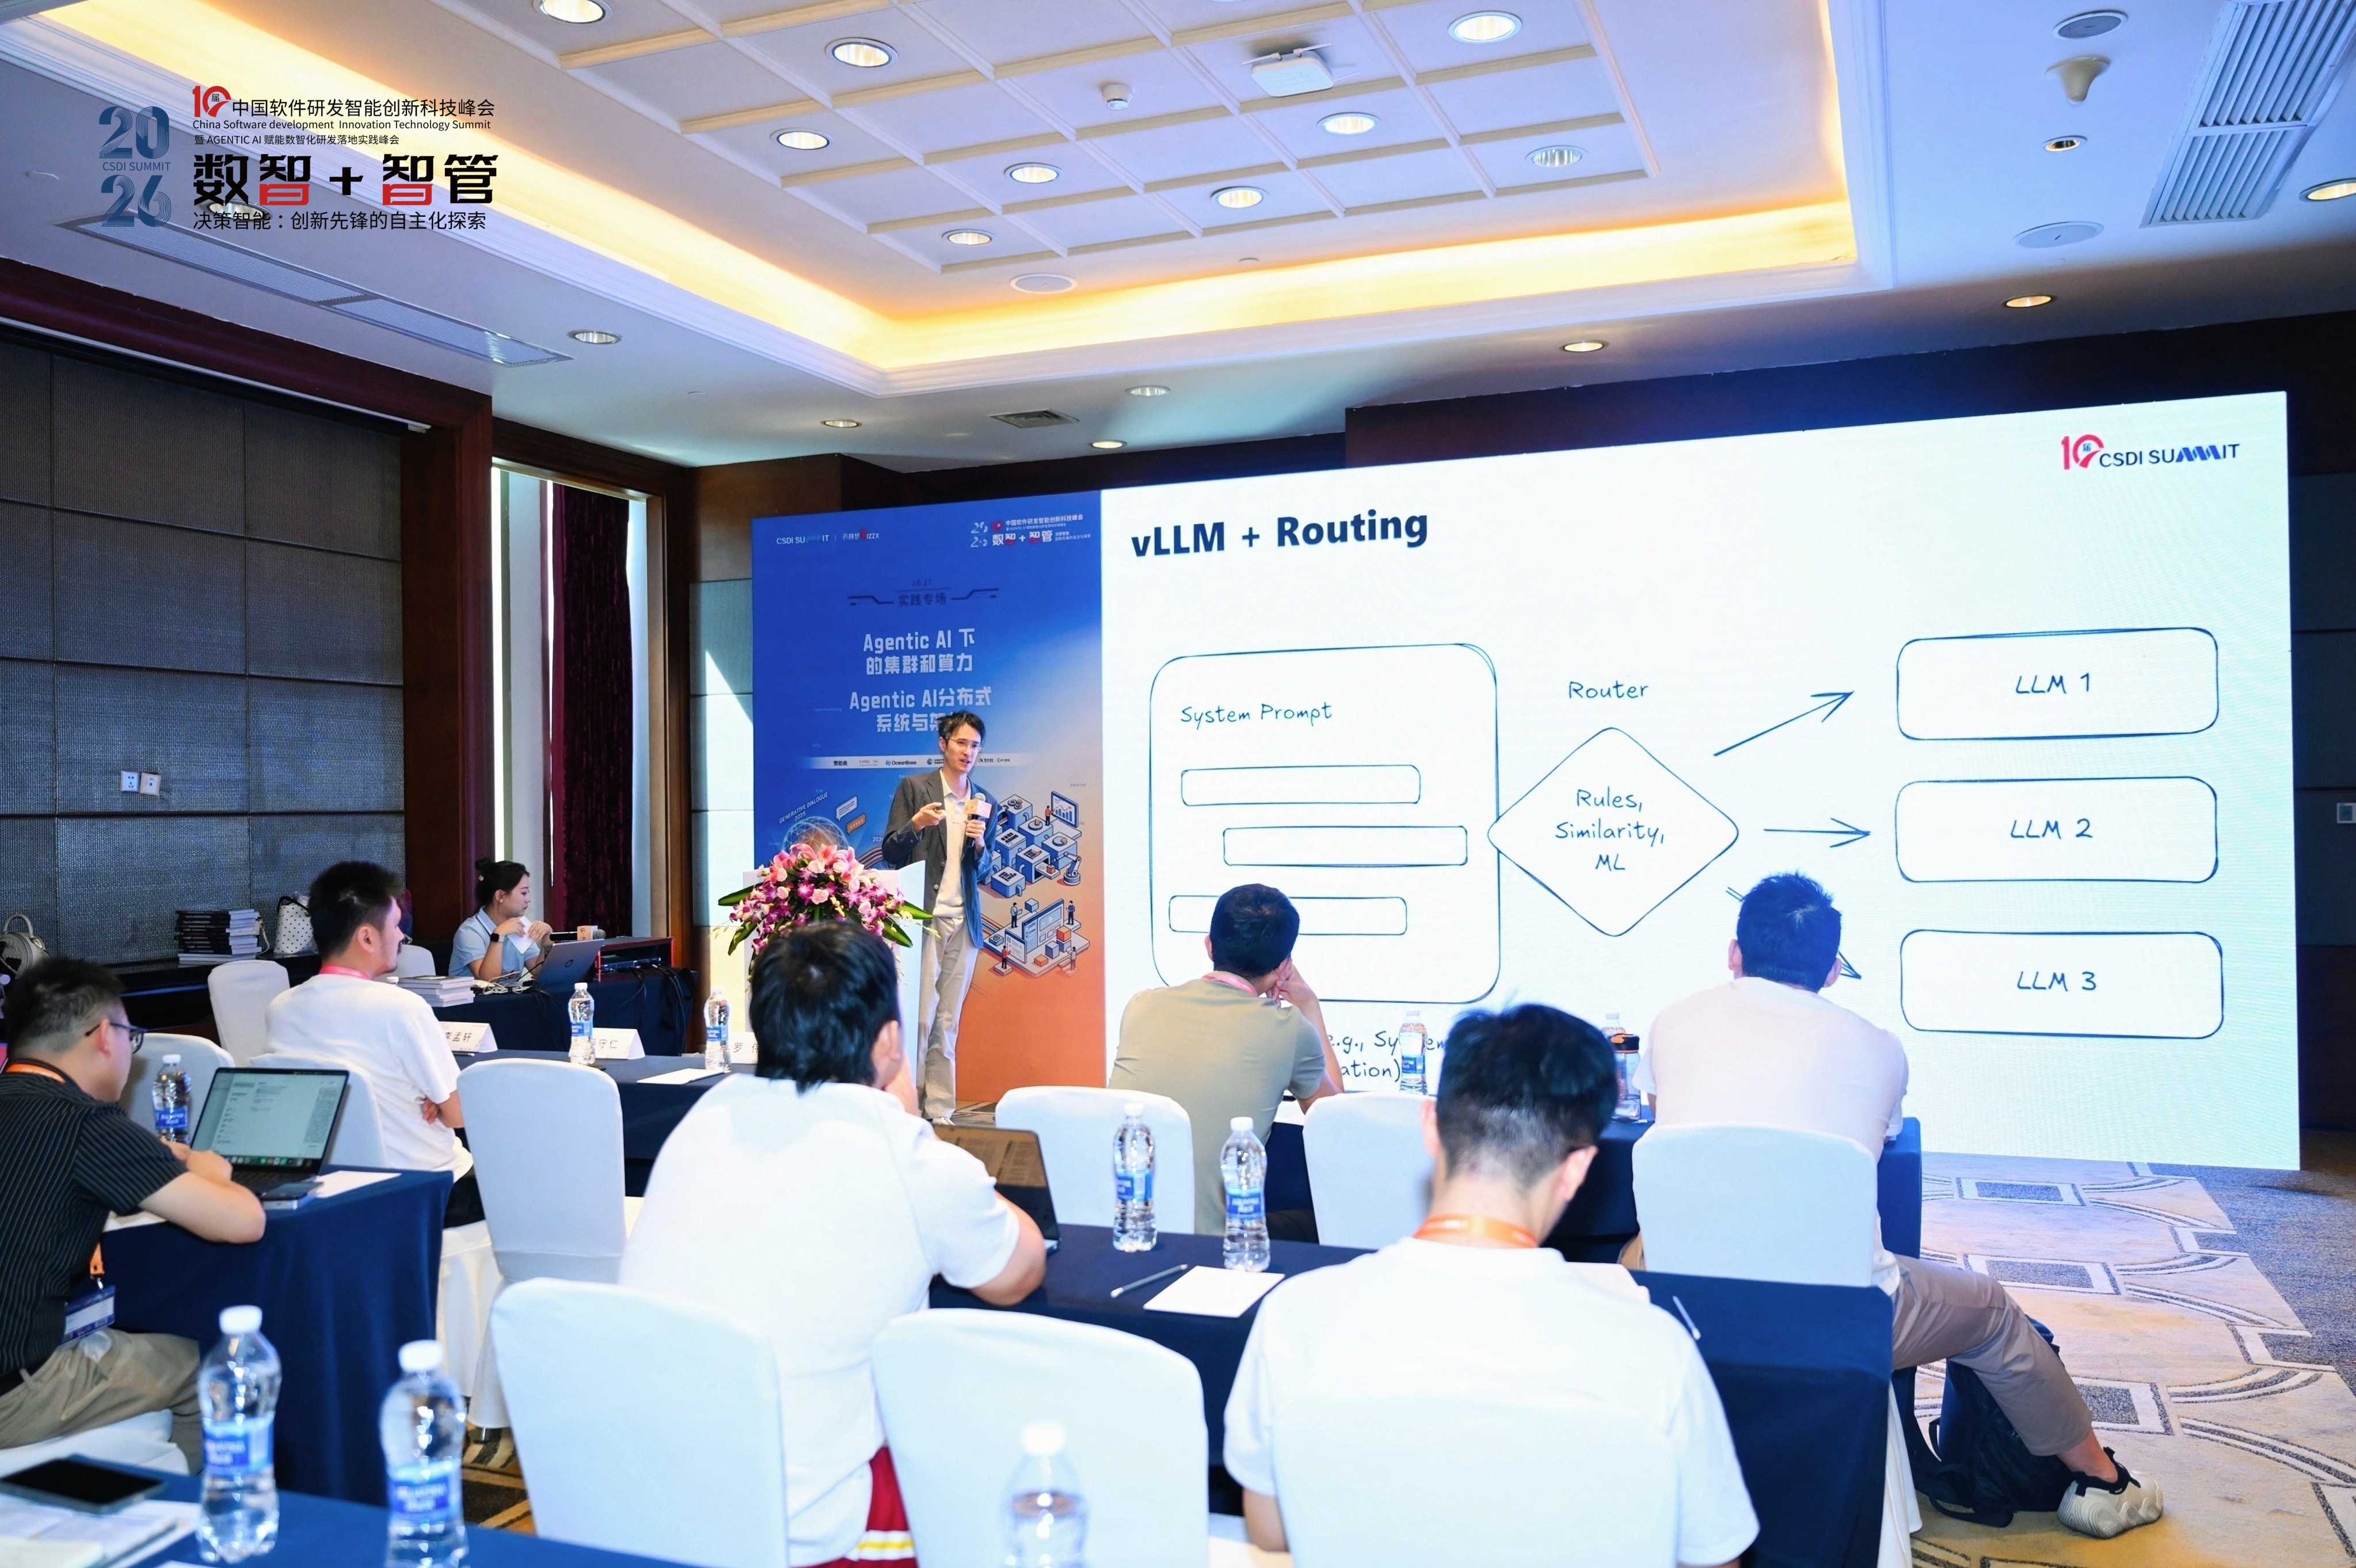
在会上,李孟轩围绕一个核心问题展开分享:企业如何将已有 GPU 资源组织成体验稳定、利用充分的推理服务?分享以首 Token 延迟(TTFT)和后续每 Token 生成耗时(TPOT)等体验指标为切入点,将推理优化与 Token 成本联系起来,说明推理框架、缓存、路由与调度之间的关系。
沿着 vLLM 从进程、集群工作负载到服务的演进,分享梳理了不同阶段需要解决的问题。单机运行可以帮助团队快速验证模型推理;进入集群后,推理任务的有状态特征和缓存局部性,则要求部署与请求分配更加精细。结合 llm-d,引入缓存感知的请求路由、KV Cache 管理与 Prefill/Decode(PD)分离,可以围绕不同计算阶段的需求组织资源,优化请求处理与推理执行的配合。
在此基础上,分享进一步讨论了 GPU 虚拟化的作用。即使推理架构经过优化,单实例独占整张 GPU 的资源分配方式,仍可能在部分模型和负载下留下利用空间。PPT 展示了结合 HAMi 进行 GPU 切分与共享的架构思路,让资源配置能够进一步贴近推理实例的实际需求。
这一路径对应着企业生产部署中的持续权衡:**既要关注响应速度和生成流畅度,也要判断资源是否得到有效使用。**架构选择需要结合模型规模、请求特征与服务目标逐步推进,并通过实际负载验证延迟、吞吐和资源利用率之间的平衡。将这些指标放在一起考量,才能让推理优化更好地服务于成本控制和稳定运行。
协同请求路由与算力管理
在本次分享的组合架构中,llm-d 负责上层请求路由及推理实例间的协作,HAMi 则在底层提供 GPU 资源切分、共享与调度能力。两者分别从请求和资源两个层面参与优化,连接起推理服务的需求与底层算力的供给。
这体现了密瓜智能参与开源基础设施建设的具体方向:通过 HAMi 的工程实践,推动算力资源更灵活地支撑上层工作负载,让企业在使用推理引擎的同时,能够进一步管理和利用已有 GPU 资源。推理引擎、服务编排与资源调度各有职责,它们之间的配合,是企业建设 AI 基础设施时需要共同考虑的问题。
从本次 CSDI 的讨论出发,Agentic AI 的持续运行需要推理框架、缓存与传输、请求路由、资源调度以及异构硬件共同支撑。未来,密瓜智能将继续围绕“AI 基础设施的开源内核”这一定位,与开源社区和生态伙伴推进相关技术的工程协作,让异构算力因开源而好用,为企业 AI 的生产运行提供更扎实的基础。