
技术演进+动手实践:HAMi 在 KubeCon NA 2026 的回顾
 Community & Events
HAMi 社区在 KubeCon + CloudNativeCon North America 2026 与 Red Hat 联合分享 GPU 共享与推理架构,介绍调度策略和 Kubernetes DRA 的进展,并通过 ContribFest 带领开发者动手体验 GPU 虚拟化。
本文目录
2026 年 11 月 9 日至 12 日,KubeCon + CloudNativeCon North America 2026 在美国盐湖城举行。
本届大会期间,HAMi 社区参与了多场技术交流与开发者实践活动,并与 Red Hat 工程师开展联合分享,围绕 Kubernetes DRA、GPU 共享和 AI 推理架构展开讨论。
此外,社区 Manager Jimmy Song 还在本届大会上荣获了 2026 年度 CNCF Lorem Ipsum Award。
从 GPU 调度策略的演进、异构硬件支持,到 Kubernetes DRA 的集成探索,再到开发者亲自搭建环境、理解 GPU 虚拟化机制, HAMi 社区在这次 KubeCon 上既展示了技术进展,也与全球开发者展开了面对面交流。
联合 Red Hat:探索生产环境中的 GPU 共享与推理架构
分享主题:
DRA + Kueue + HAMi + vLLM: A Production Architecture for Scheduler-Agnostic GPU Sharing
分享嘉宾:
- 李孟轩(HAMi 核心作者,密瓜智能联合创始人兼 CTO)
- Yuchen Fama(Red Hat Senior Principal Product Manager)
分享时间: 11 月 9 日 15:20-15:45
分享地点: Salt Palace · Level 2 · 251 D-F
在与 Red Hat 的联合分享中,李孟轩与 Yuchen Fama 将讨论重点放在了一个实际问题上:当 AI 推理服务越来越复杂,企业如何在 Kubernetes 环境中更灵活地分配 GPU,同时兼顾资源利用率和推理性能?
分享围绕 DRA、Kueue、HAMi 与 vLLM/llm-d 展开,介绍了从 GPU 资源分配、工作负载调度到推理请求路由的协作方式。
从 GPU 切分到资源调度
在实际推理集群中,并不是所有任务都需要独占一张 GPU。
除了大型模型推理,Embedding、Reranker、分类器、语音模型等工作负载也会持续消耗 GPU 资源。对于这些任务,按需分配显存和算力,往往比直接分配整卡更灵活。
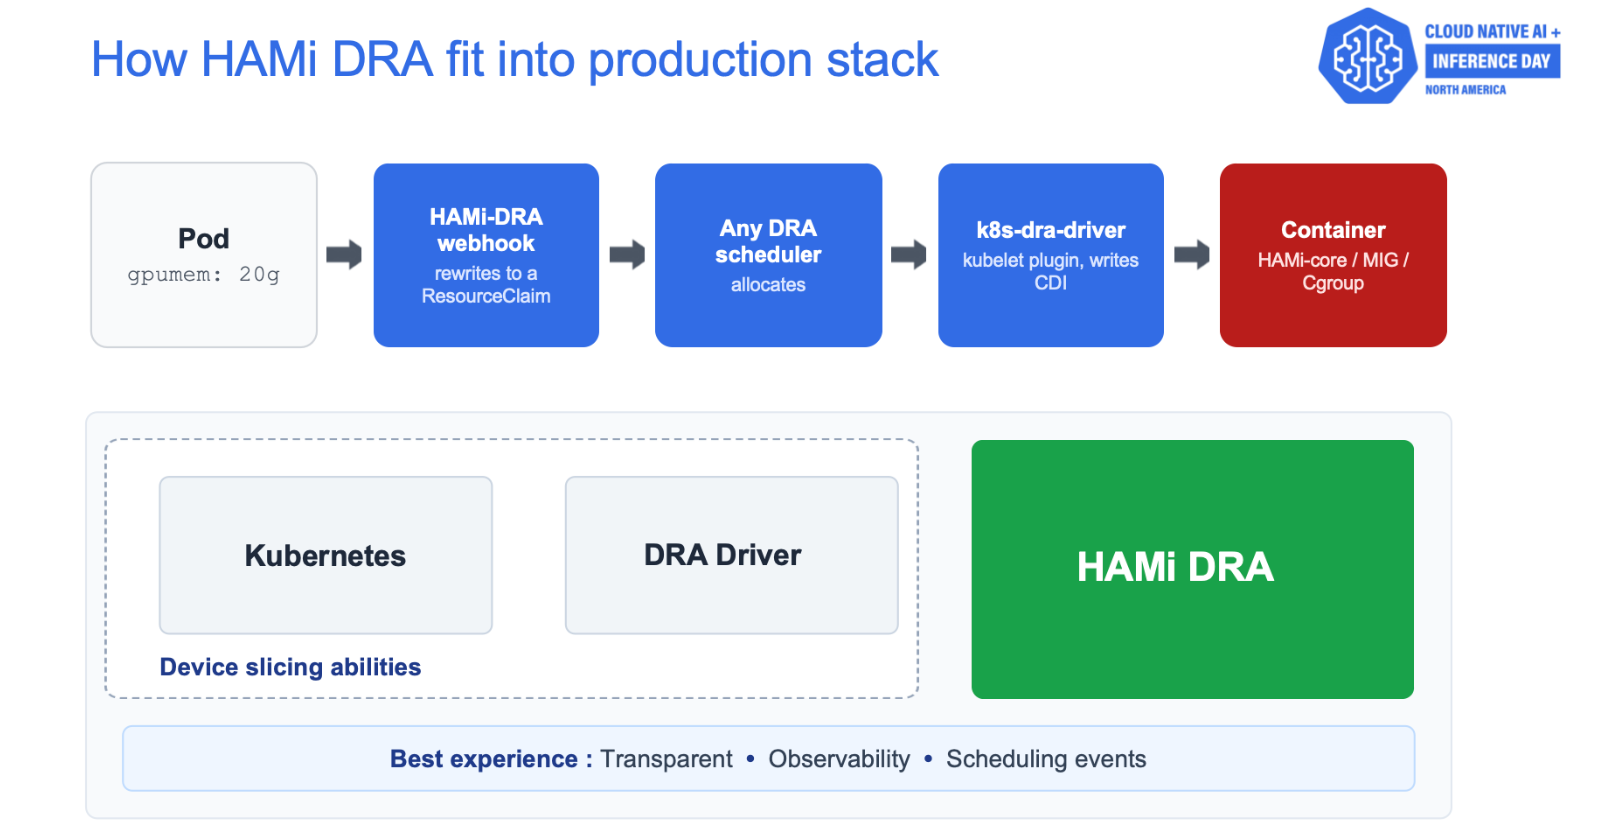
分享介绍了 HAMi 与 Kubernetes DRA 的结合方式:通过 DRA 描述和分配设备资源,再由 HAMi 相关组件负责 GPU 切分和容器内资源隔离。
同时,Kueue 可以承担工作负载的配额管理和准入控制,帮助团队管理不同任务对算力资源的使用。
推理请求需要更聪明的路由
分享中还有一个值得关注的话题:GPU 切分并不意味着推理性能问题就此解决。
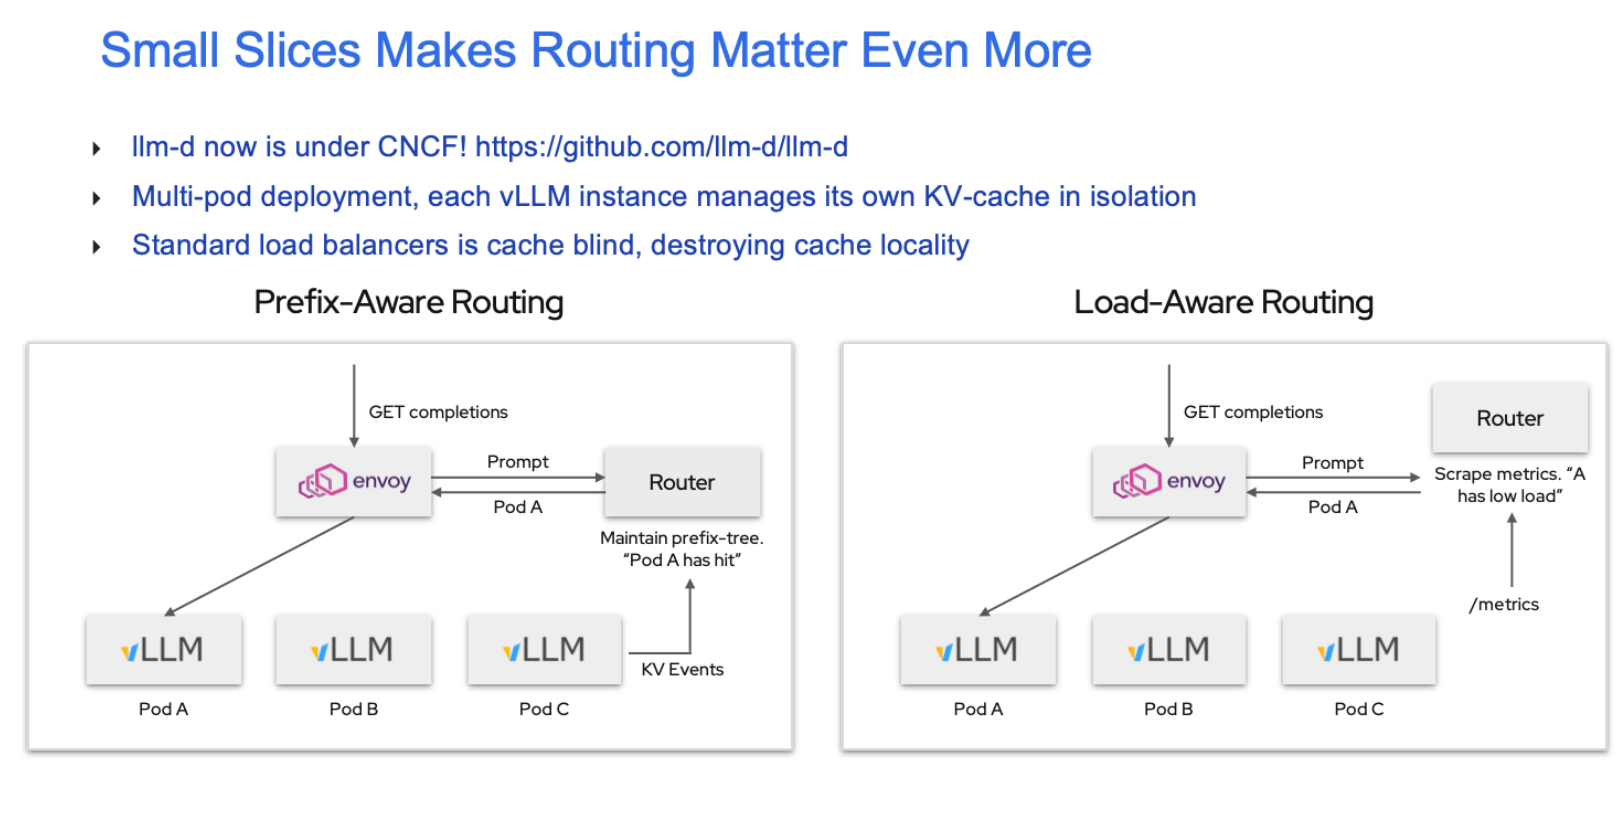
在多实例推理服务中,每个 vLLM 实例通常管理自己的 KV Cache。如果负载均衡策略没有考虑各实例的缓存状态,相同前缀的请求可能被分配到不同实例,导致已有 KV Cache 难以复用,增加缓存占用和显存压力。
当 GPU 被切分成更小的资源单元时,KV Cache 可用空间也会受到限制,这个问题会更加明显。
针对这一情况,分享进一步介绍了 llm-d 的 EPP(Endpoint Picker)机制,通过感知缓存状态,将请求优先路由到已经持有相关前缀缓存的推理实例。
在分享展示的一组 MI355X 实验中,三个 vLLM 实例分别使用 30% 的 HBM 资源。在 QPS 为 8 的测试条件下,开启 EPP 后,Prefix Cache 命中率从 45.2% 提升至 92.4%,TTFT P90 从 251ms 降至 157ms。
这组实验展示了 GPU 共享与推理请求路由之间的联系:资源切分提高了 GPU 的使用灵活性,而缓存感知路由则有助于减少缓存重复,改善推理请求的响应表现。
这次联合分享将 GPU 资源管理与推理服务的实际运行联系起来,展示了 HAMi 与 Kubernetes、Kueue、vLLM 和 llm-d 等生态项目协作的一个具体方向。
Maintainer Track:HAMi 的能力升级与技术演进
分享主题:
HAMi Levels up: Smarter Scheduling, Wider Hardware Reach and a DRA-Native Lightweight Future
分享嘉宾:
李孟轩(HAMi 核心作者,密瓜智能联合创始人兼 CTO)
分享时间: 11 月 10 日 14:50—15:20
分享地点: Salt Palace · Level 2 · 251 D-F
作为 HAMi 晋升为 CNCF Incubating 项目后的首次 Maintainer Track 分享,本次演讲重点介绍了项目在调度策略、异构硬件支持以及 Kubernetes DRA 方向上的最新进展。
企业 AI 工作负载日益多样化,GPU 资源管理已经不再只是简单地分配设备。不同任务对显存、计算资源、设备拓扑和调度策略有着不同需求,如何在资源利用率、任务性能与集群管理效率之间取得平衡,成为 AI 基础设施面临的重要问题。
围绕这些需求,本次分享主要介绍了 HAMi 的几个技术方向。
更灵活的调度策略
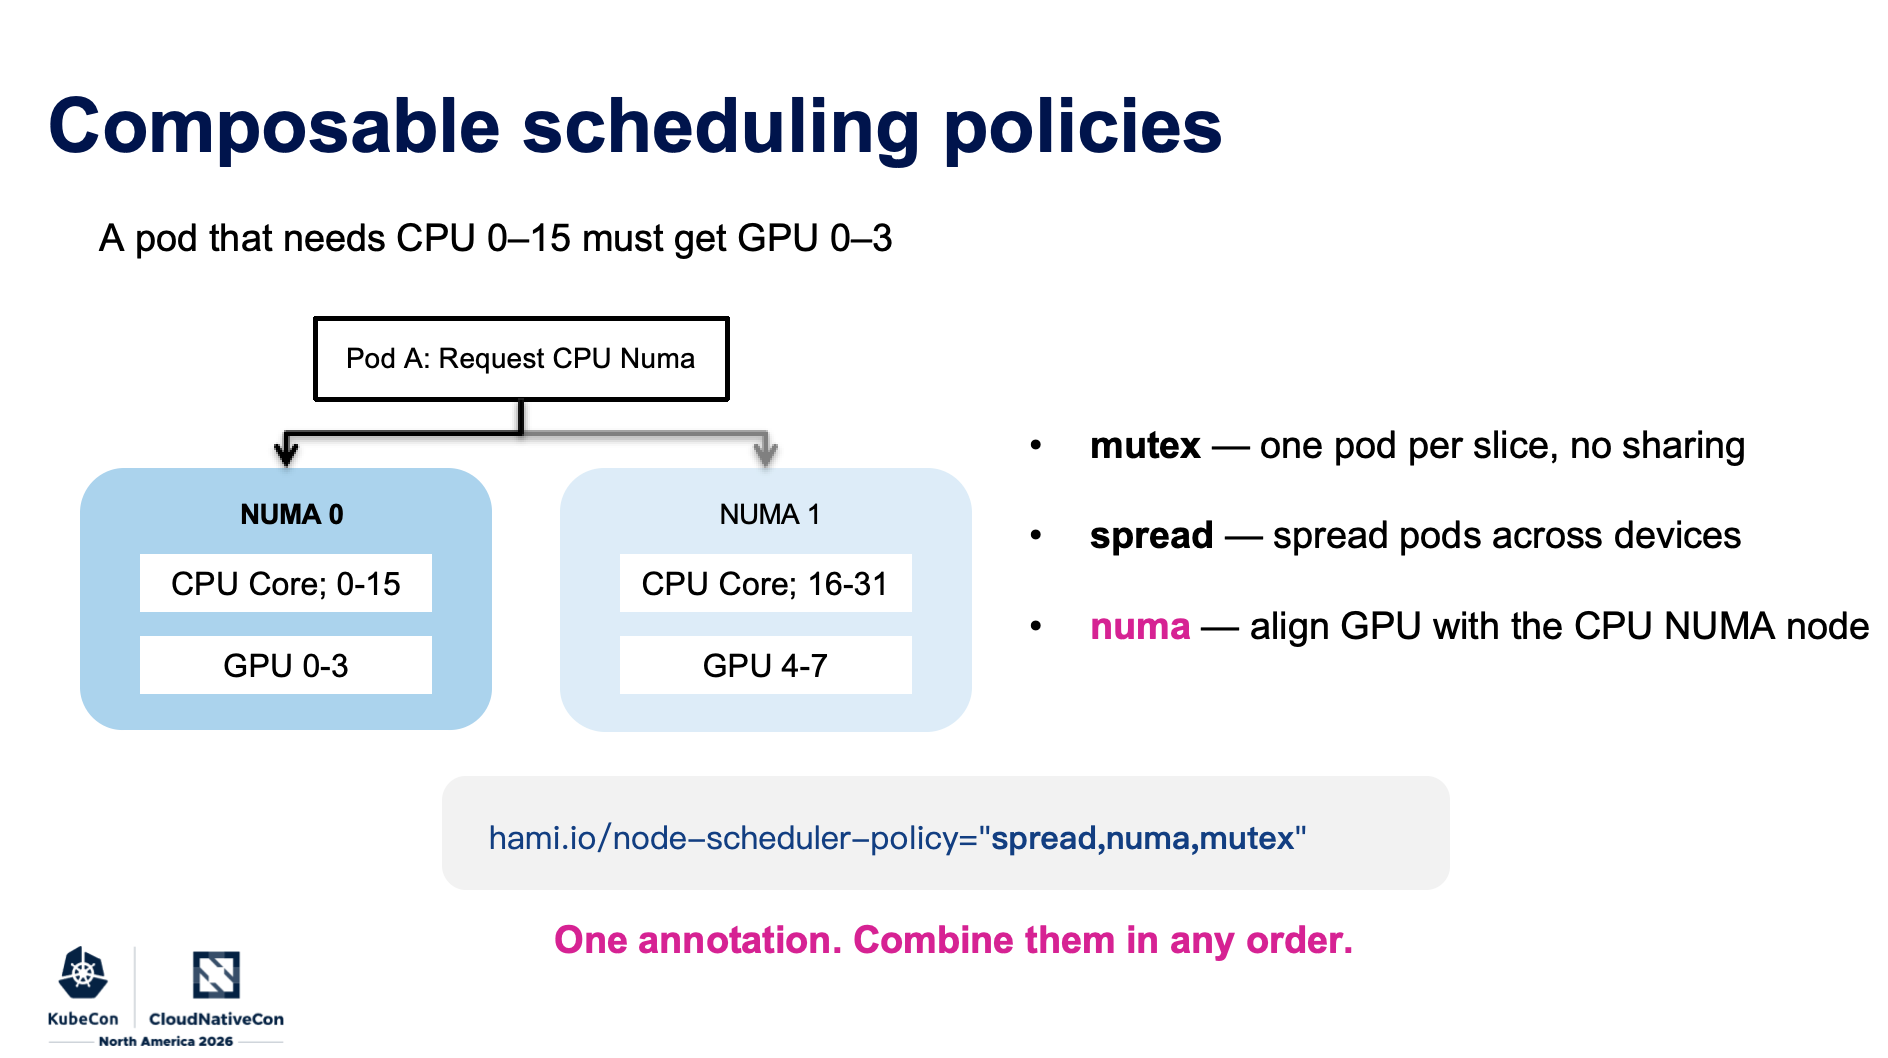
在调度方面,HAMi 持续完善组合调度策略,支持将 Mutex、Spread、NUMA 等策略组合使用。
- Mutex:限制共享行为,支持一个 Pod 独占一个切分资源。
- Spread:将任务分散到不同设备,减少资源竞争。
- NUMA:结合 CPU NUMA 节点与 GPU 拓扑进行资源放置,减少跨 NUMA 访问带来的性能损耗。
Flexible-MIG
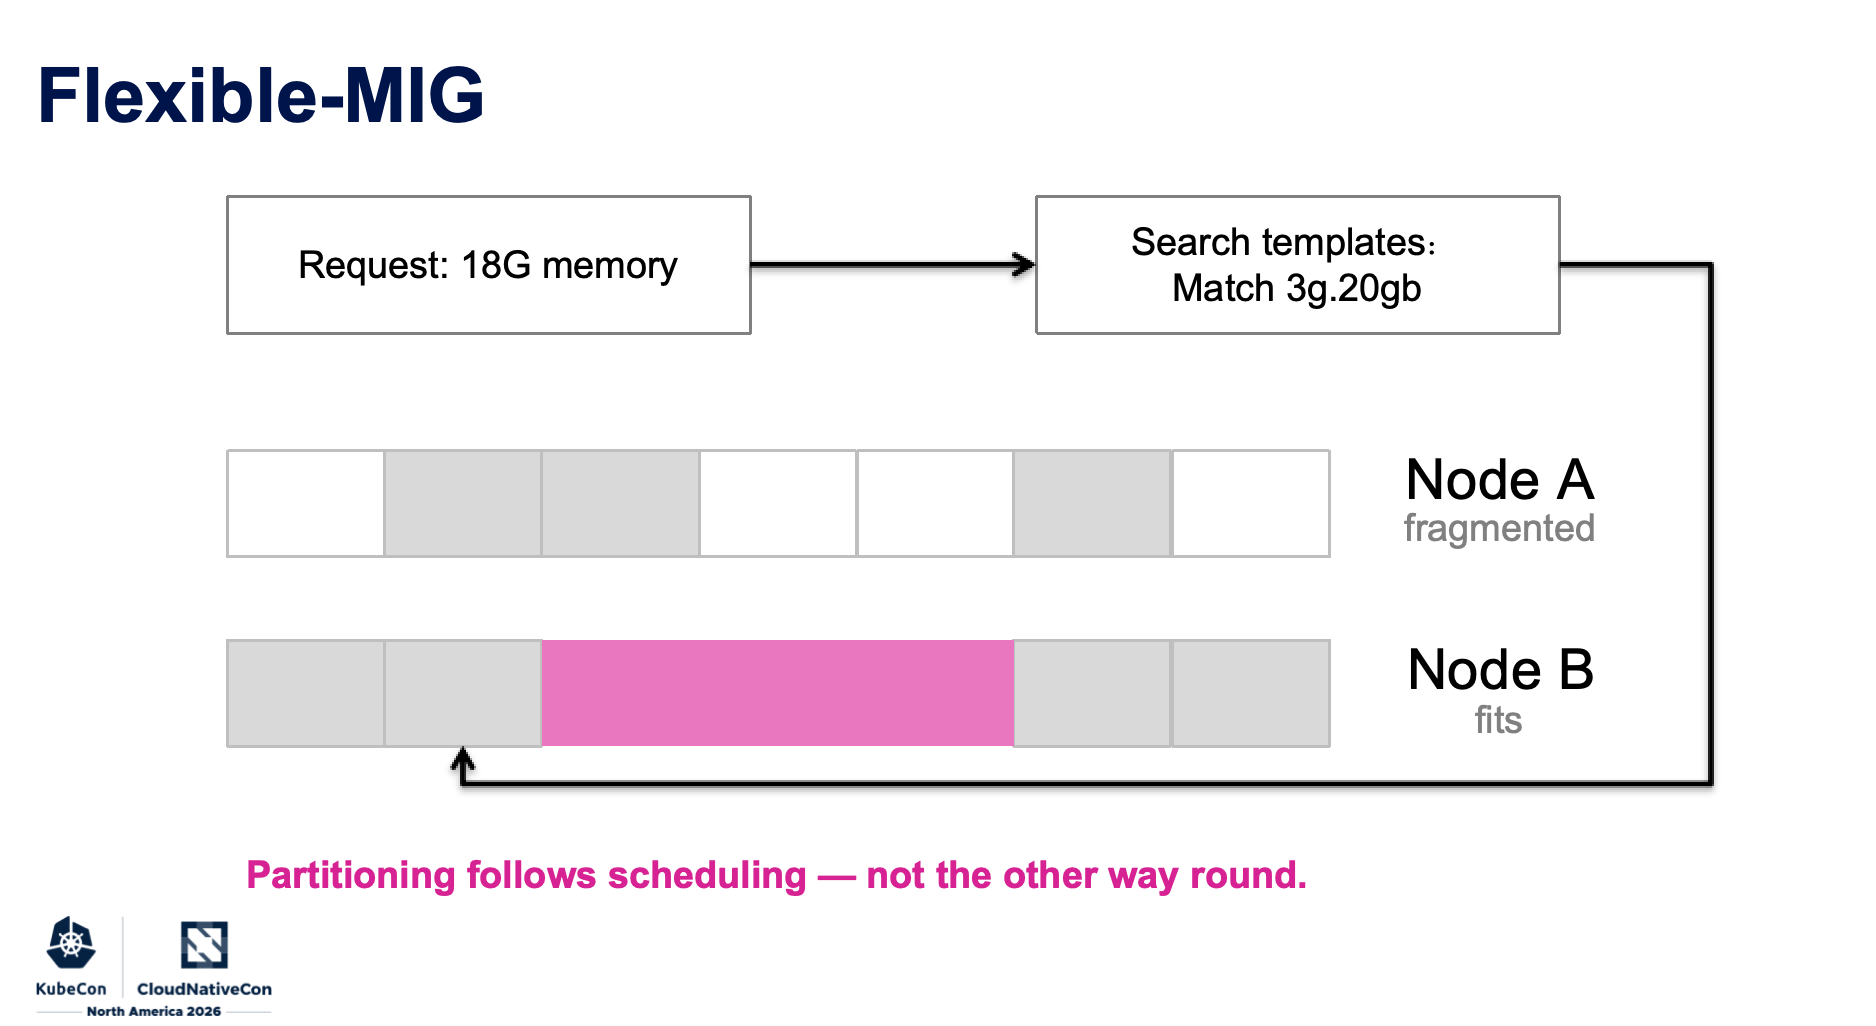
传统 MIG 通常需要提前配置固定的 GPU 分区规格,实际部署时可能遇到资源规格不匹配的问题。
Flexible-MIG 则尝试改变这一过程:先根据 Pod 的资源请求寻找合适的分区模板,再结合调度结果完成设备分配。
例如,一个任务需要 18GB 显存,系统可以根据可用模板寻找满足条件的分区,而不是要求用户提前将 GPU 固定切成某一种规格。
Remote-GPU
Remote-GPU 是本次分享介绍的另一个能力。
通过远程 GPU 访问机制,运行在没有本地 GPU 的 CPU 节点上的应用,也可以通过网络访问部署在其他节点上的 GPU。
对于希望将计算资源与应用部署位置解耦的场景,这提供了另一种资源使用方式。
AMD
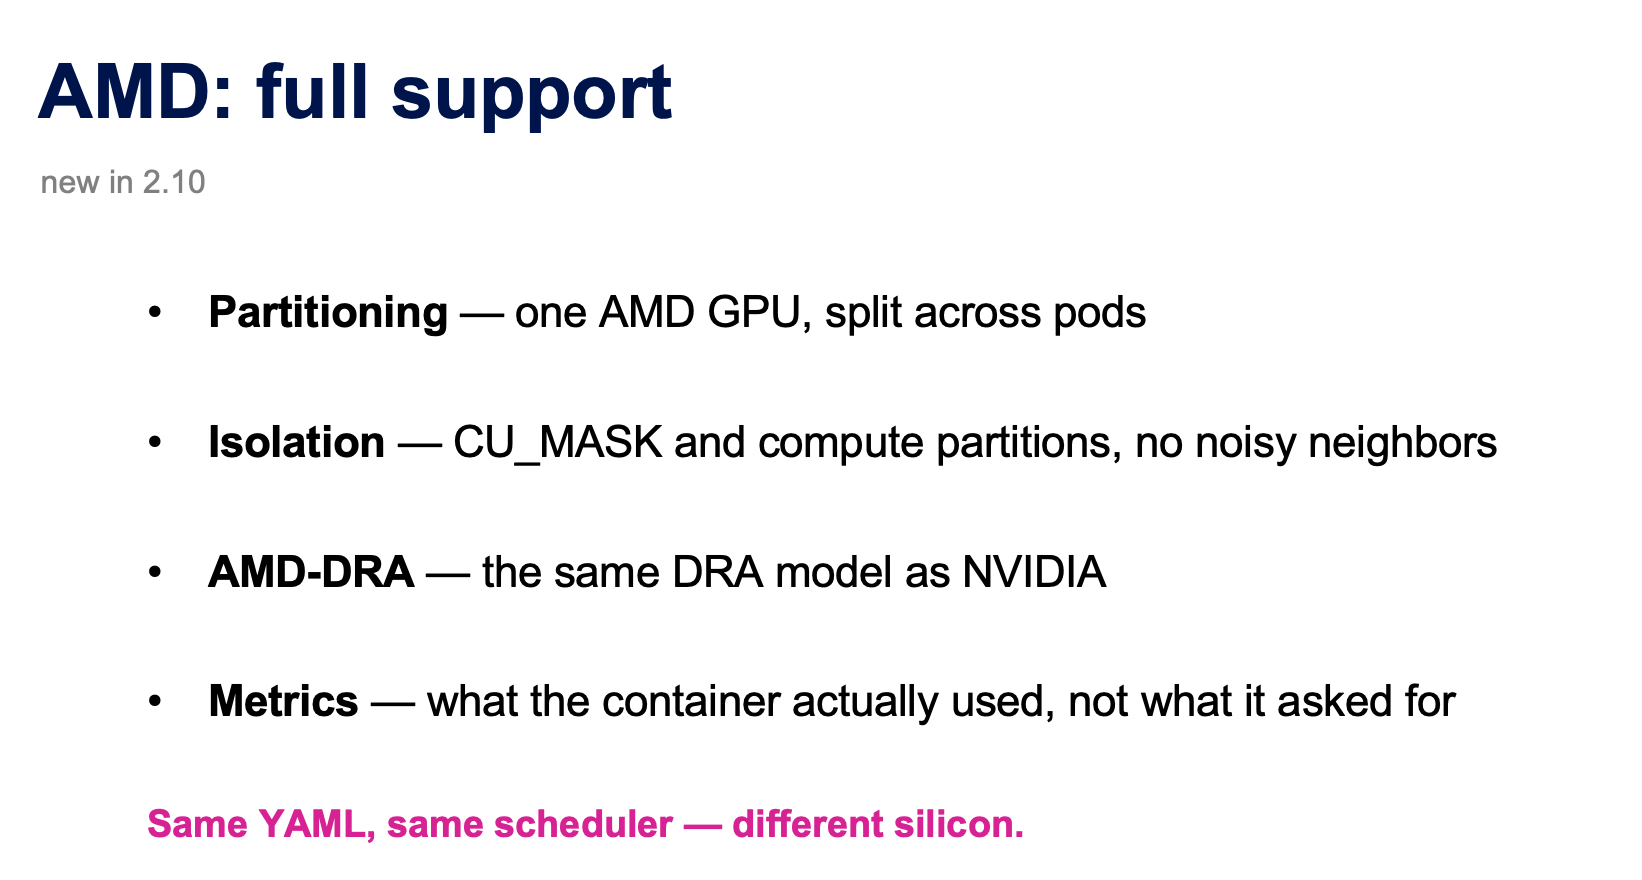
在 AMD 设备支持方面,HAMi v2.10 已实现完整支持,涵盖 GPU 分区、计算资源隔离、AMD-DRA 和实际使用量监控等能力。
这意味着用户可以通过相对统一的资源请求和调度方式管理不同类型的加速设备,减少异构硬件接入带来的使用复杂度。
HAMi-DRA
Kubernetes DRA(Dynamic Resource Allocation)为设备资源管理提供了原生机制。
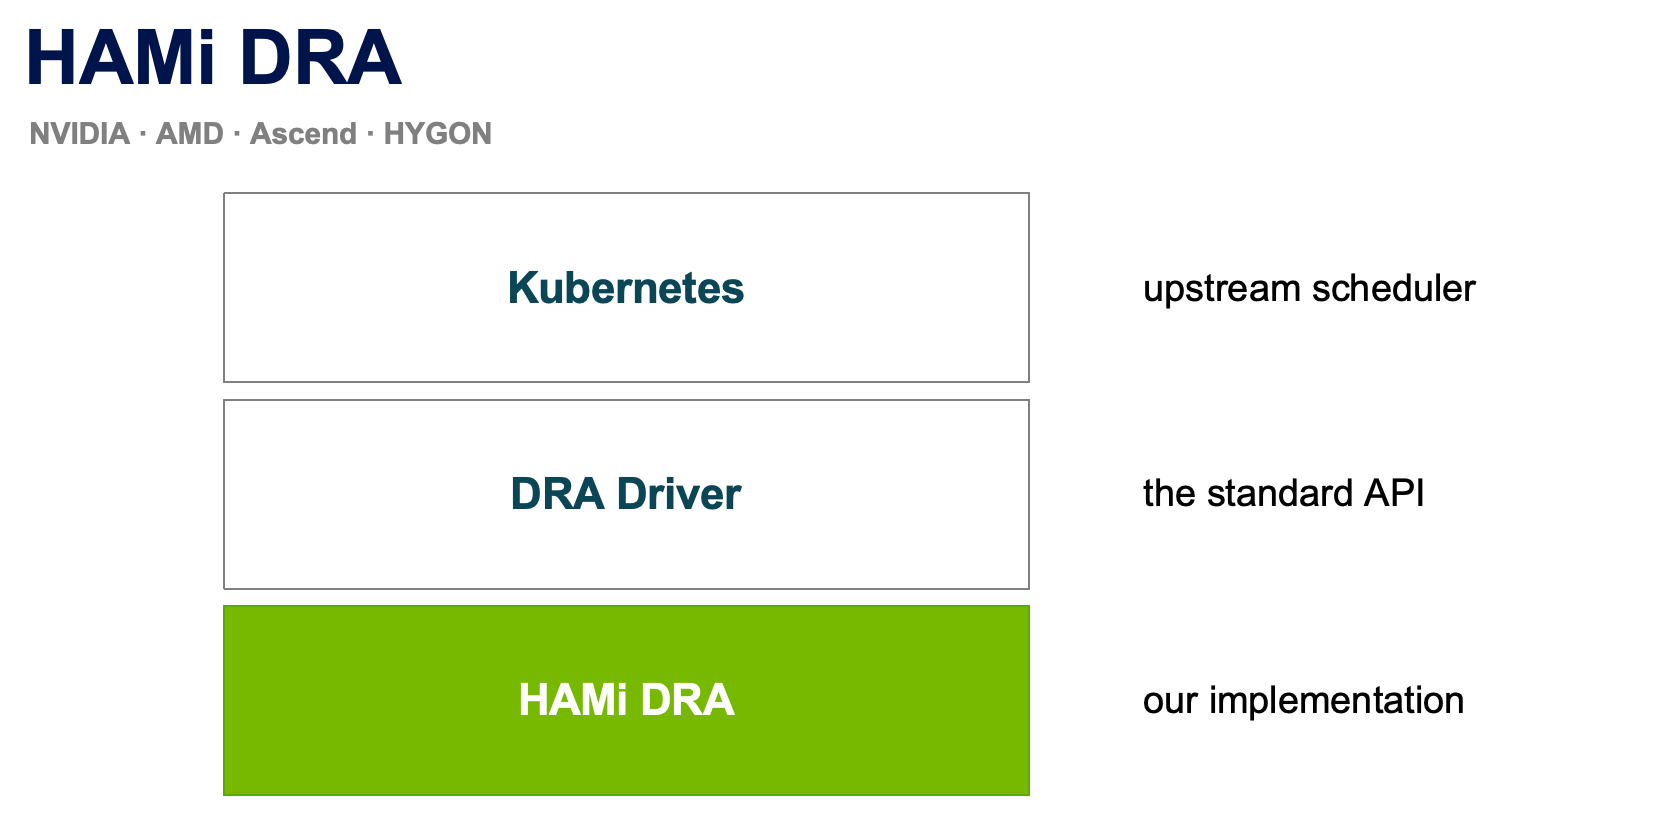
本次分享介绍了 HAMi-DRA 的实现思路:通过 DRA Driver 接入 Kubernetes 原生资源分配流程,让 Kubernetes 调度器参与设备分配,同时保留 HAMi 在 GPU 切分和容器内资源隔离方面的能力。
HAMi-DRA 并不是另起一套设备管理标准,而是基于 Kubernetes DRA 标准实现设备资源管理。
从调度策略、远程 GPU 到 DRA,HAMi 正在逐步扩展 GPU 资源管理的适用范围,让用户能够根据实际工作负载选择合适的资源分配方式。
ContribFest:从零开始理解 GPU 虚拟化
分享主题:
GPU Virtualization: First Setup and Understanding the Device Plugin / DRA
分享嘉宾:
Reza Jelveh(HAMi Community Contributor)、李孟轩(HAMi 核心作者)、申涵(HAMi-WebUI Reviewer),三位均来自密瓜智能
分享时间: 11 月 10 日 16:40—18:00
分享地点: Salt Palace · Level 2 · 255 D
在这场为期 80 分钟的动手实践中,社区团队将视角转向了开发者,带领参与者从搭建实验环境开始,一步步了解 HAMi 的核心组件,以及它们与 Kubernetes 设备管理机制之间的协作过程。
整个实验环境运行在参与者自己的笔记本电脑上,通过模拟 GPU 完成实验,不需要实际连接 GPU 设备。
搭建实验环境
活动首先带领参与者部署一个基于 kind 的 Kubernetes 集群,并安装 HAMi。
实验通过 mock-device-plugin 模拟 GPU 设备资源,通过 hami-mock-monitor 提供 GPU 使用情况指标,让参与者即使没有真实 GPU,也能观察资源调度和使用情况。
这样的设计降低了实践门槛,也让开发者能够把注意力集中在 HAMi 的资源管理机制上。
理解 GPU 共享与资源分配
完成基础部署后,参与者通过创建不同资源请求的 Pod,观察 HAMi 如何为任务分配 GPU 资源。
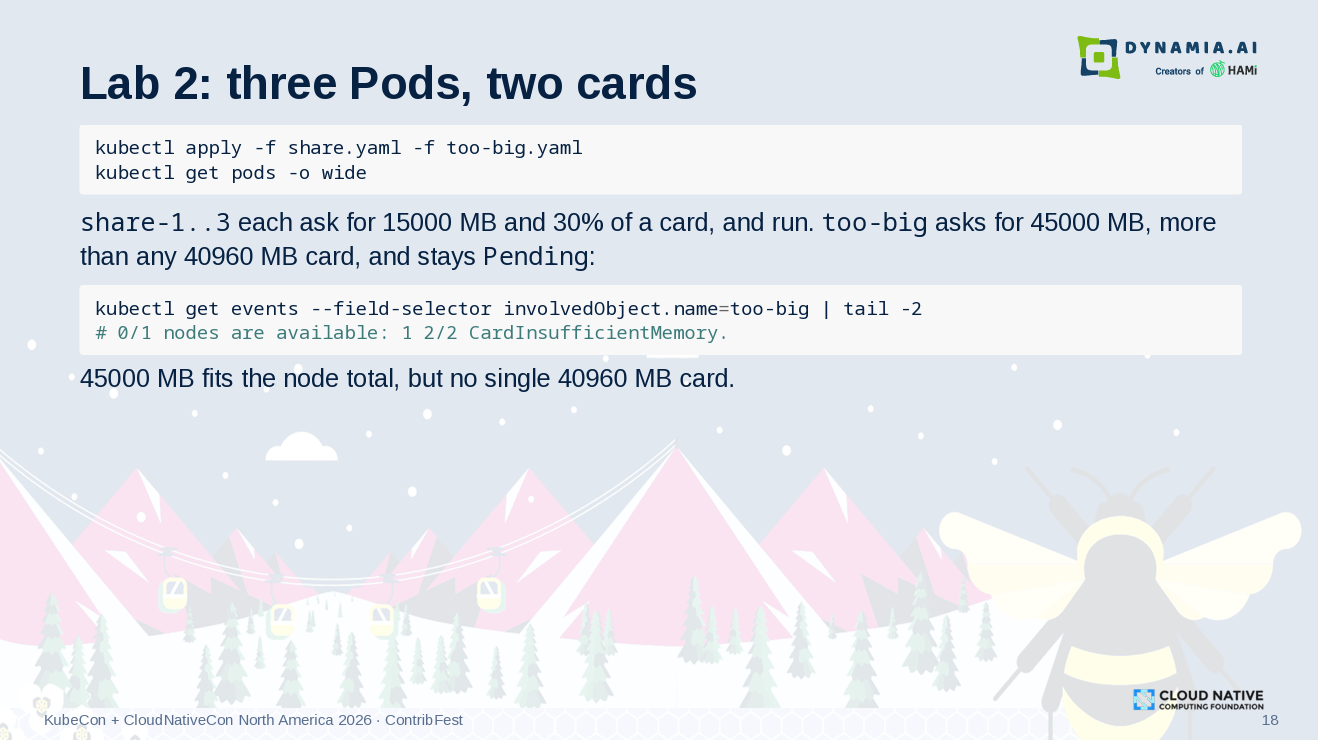
例如,在实验中,三个 Pod 分别请求 15 GB 显存和 30% 的 GPU 算力,共享两张模拟的 A100 GPU。与此同时,另一个 Pod 请求 45 GB 显存。
尽管节点上两张 GPU 的总显存超过了这一数值,但由于单张 GPU 无法满足该请求,Pod 仍然无法被调度。
这个实验展示了 GPU 共享场景下一个容易被忽略的问题:资源总量充足,并不意味着单个设备一定能够满足任务需求。 实际调度还需要考虑单张设备的资源容量和分配情况。
随后,参与者进一步对比 Binpack 和 Spread 两种 GPU 调度策略,观察相同资源请求在不同策略下的分配结果,理解资源集中与分散部署各自适用的场景。
深入理解 HAMi 的组件协作机制
在实践过程中,活动还拆解了一个 Pod 从提交资源请求到最终使用 GPU 的完整流程:
- Admission Webhook: 修改 Pod 的调度配置,将任务交由 HAMi Scheduler 处理。
- HAMi Scheduler: 根据节点设备信息,检查 GPU 的显存和算力余量,并选择合适的物理设备。
- 资源分配: 调度器将 GPU 资源分配信息写入 Pod 相关配置。
- Device Plugin 与 HAMi-Core: HAMi Device Plugin 在 Allocate 阶段完成设备及相关文件的注入,HAMi-Core 随后在容器运行过程中执行资源限制。
通过这一流程,参与者可以更清楚地理解 HAMi Scheduler、Device Plugin 和 HAMi-Core 各自承担的职责,以及它们如何配合完成 GPU 虚拟化。
从 Device Plugin 到 DRA
在理解传统 GPU 资源管理机制之后,活动进一步介绍了 Kubernetes DRA 的资源管理模型。
通过 ResourceSlice、DeviceClass、ResourceClaim 和 ResourceClaimTemplate 等核心对象,参与者了解了 DRA 如何描述设备、声明资源需求并完成设备分配。
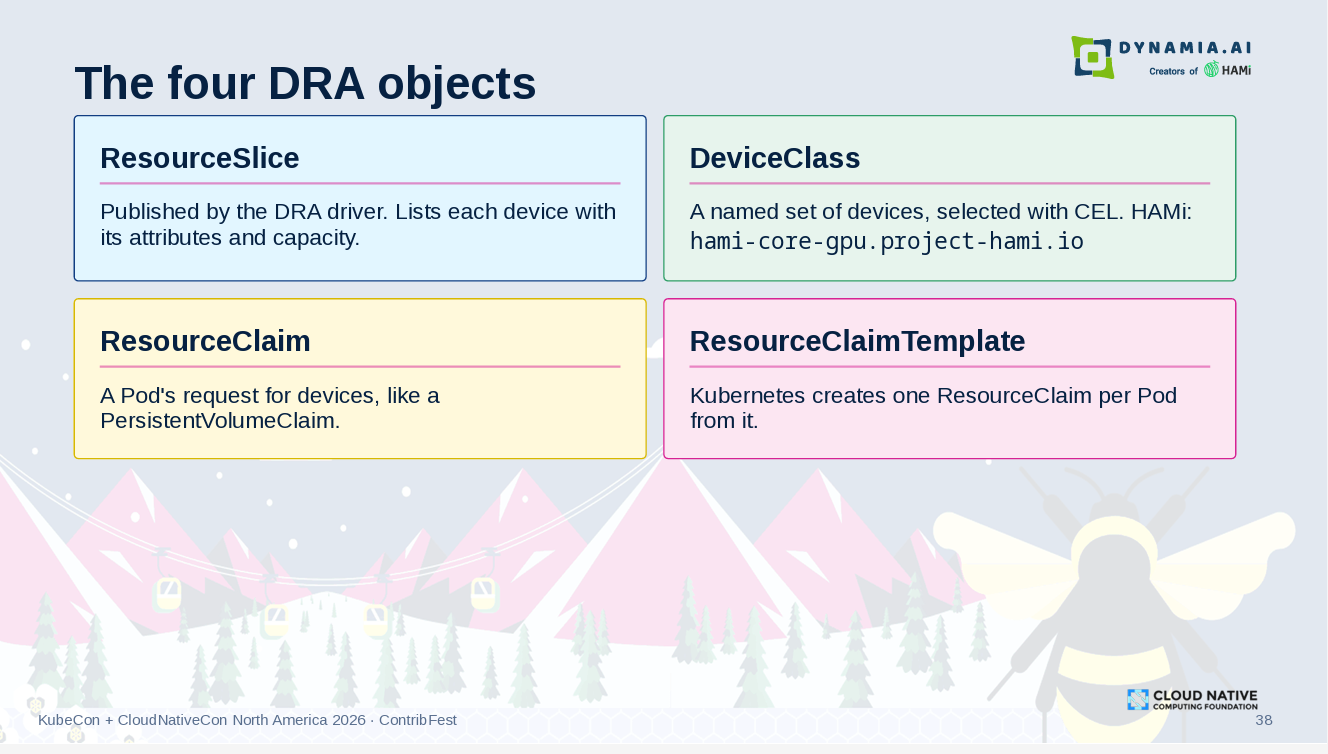
分享进一步介绍了 HAMi-DRA 的实现路径:通过 HAMi-DRA Webhook 将原有 HAMi GPU 资源请求转换为 DRA ResourceClaim,再由 Kubernetes 原生调度流程完成资源分配,同时保留 HAMi-Core 在容器内的资源隔离能力。
从学习到参与
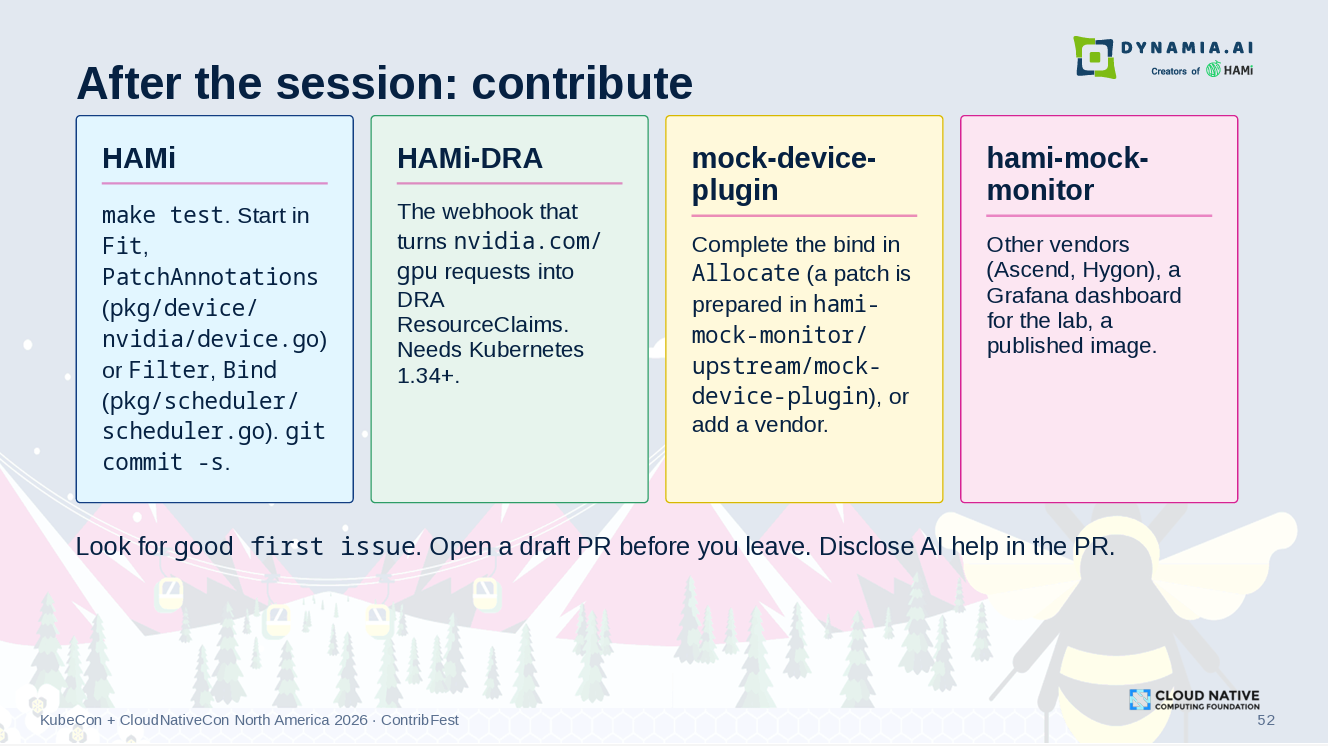
除了技术原理和动手实践,ContribFest 也为参与者介绍了后续可以继续探索的方向:
- HAMi:从调度逻辑、设备管理和测试入手。
- HAMi-DRA:了解 Webhook 如何将 GPU 请求转换为 ResourceClaim。
- Mock Device Plugin:完善模拟设备的资源分配流程。
- HAMi-WebUI:参与监控与可视化相关功能的开发
开发者可以从测试、调度逻辑、设备适配和监控能力等具体任务入手,寻找适合自己的 Good First Issue,并尝试提交 Draft PR。
从安装项目、观察调度结果,到理解底层机制,再到寻找第一个贡献入口,这场 ContribFest 希望让开发者不仅能够使用 HAMi,也能进一步理解项目,并找到参与社区共建的切入点。
HAMi Booth:与全球开发者面对面交流
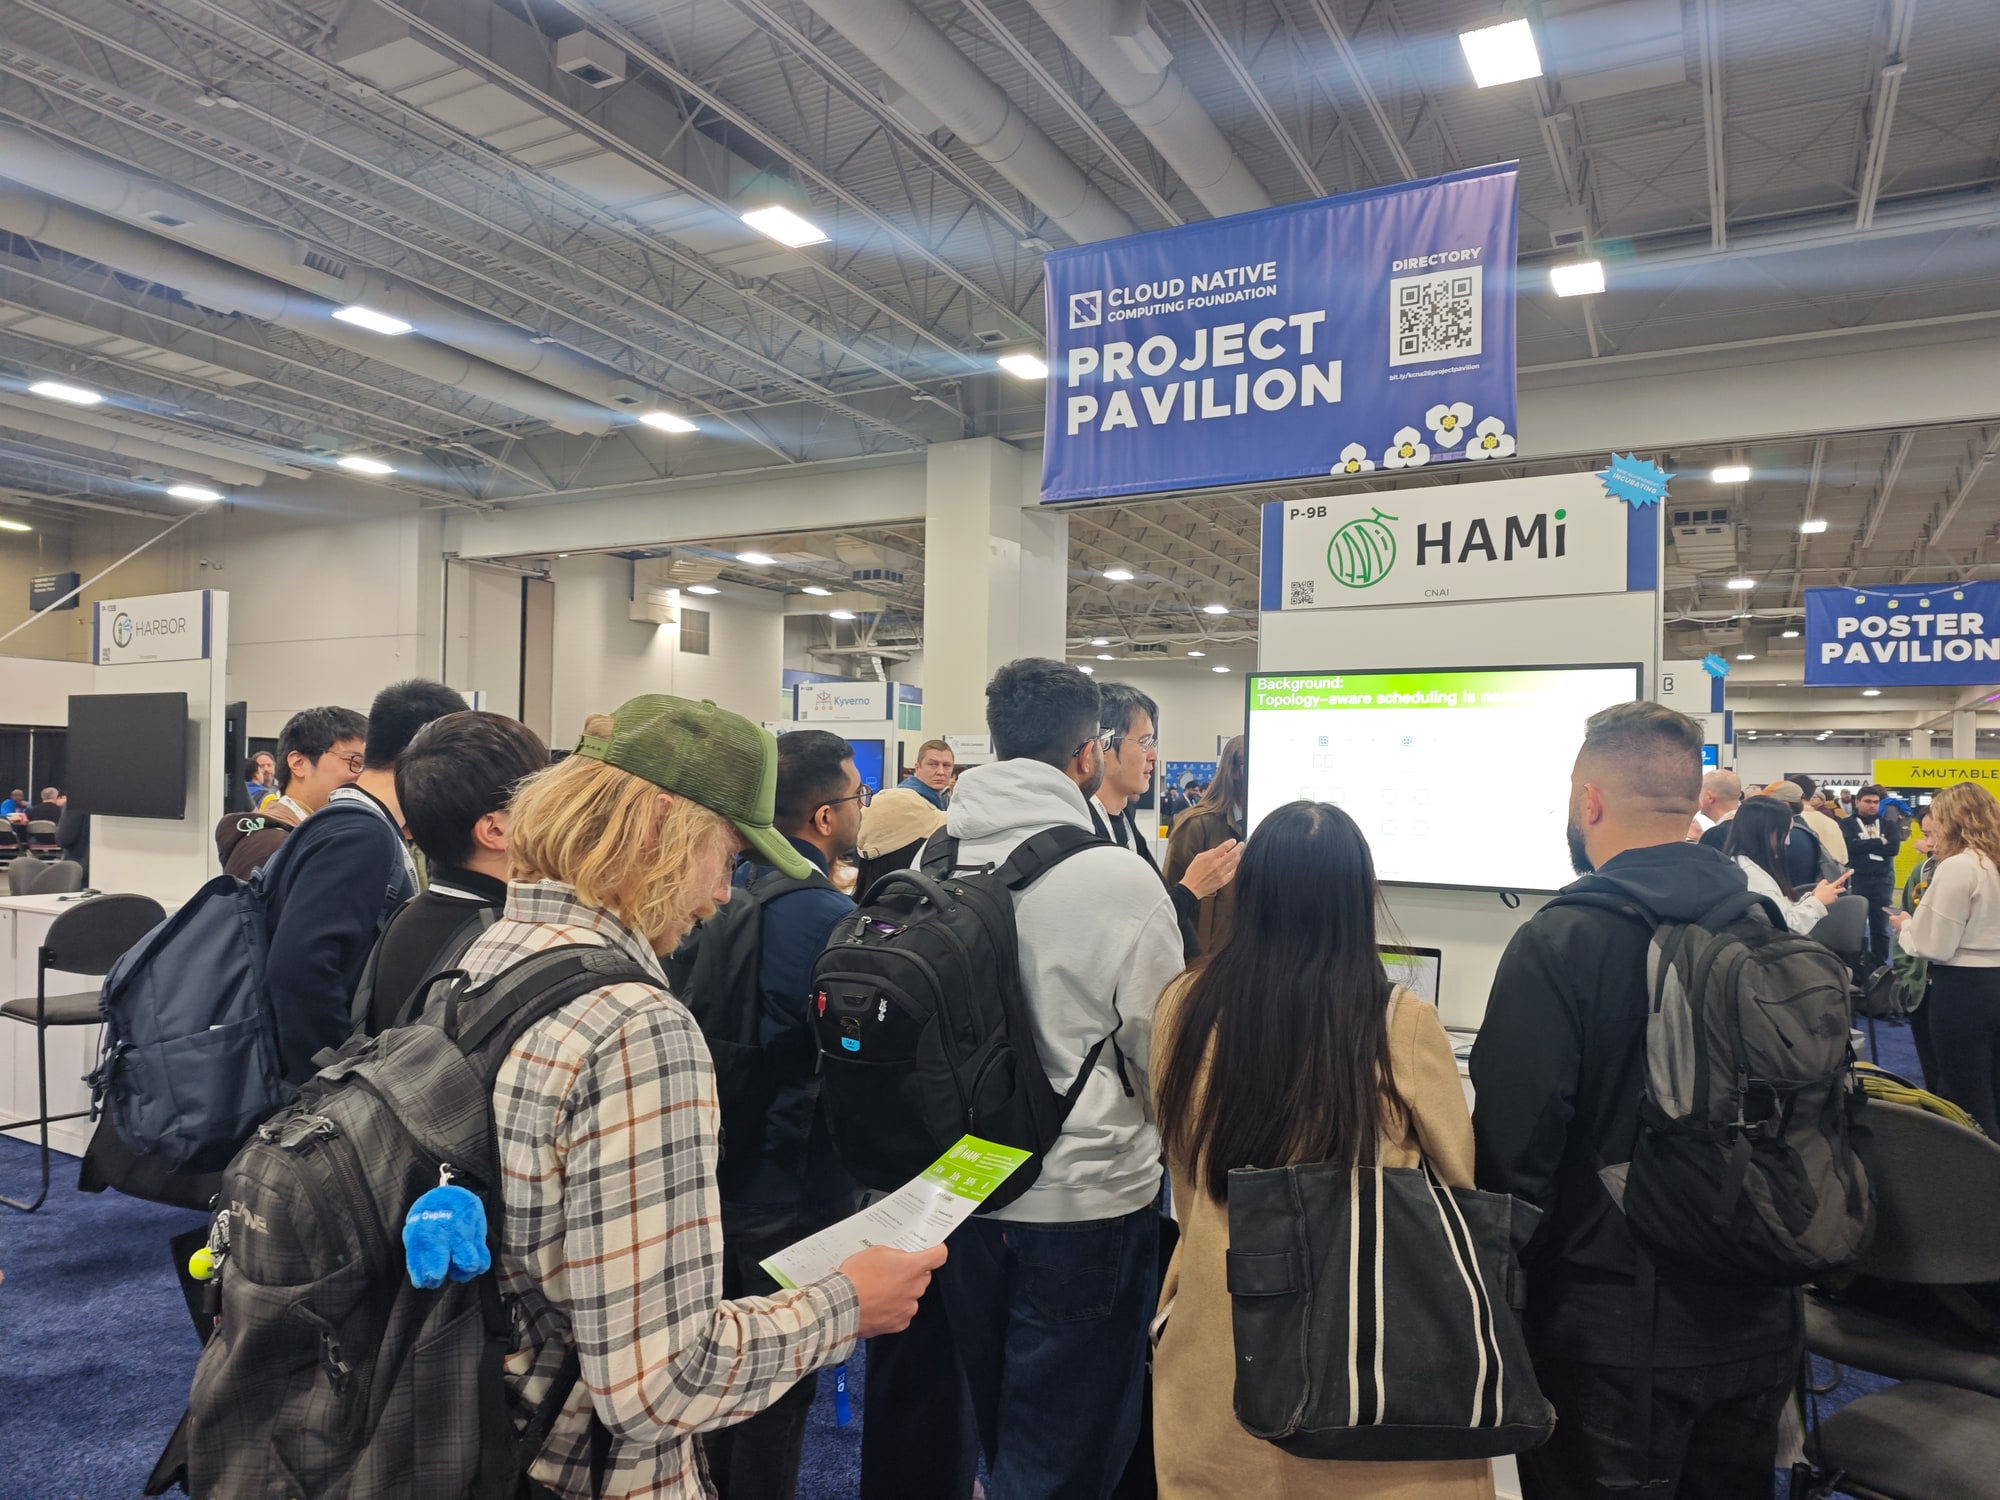
除了技术分享和动手实践,HAMi 还在 CNCF Project Pavilion 设置了社区展台。
大会期间,HAMi 社区成员与来自不同地区的开发者、用户及生态伙伴进行了面对面交流,围绕 GPU 共享、异构算力调度、Kubernetes 资源管理等话题展开讨论。
现场也有不少开发者来到展台,了解 HAMi 的技术能力和应用场景,与社区成员交流实际使用中的问题和需求。
这些面对面的交流,让社区能够更直接地了解不同用户在 GPU 资源管理中遇到的挑战,也为后续的技术交流和生态合作创造了机会。
社区荣誉
本届 KubeCon 期间,HAMi 社区 Manager Jimmy Song 荣获 2026 CNCF Lorem Ipsum Award。
从云原生技术知识分享,到 AI 基础设施领域的技术交流,再到 HAMi 社区建设与生态合作,Jimmy 长期投入技术传播、开发者交流和开源生态建设,推动更多开发者与行业伙伴了解并参与相关技术实践。
这份荣誉不仅是对 Jimmy 个人工作的认可,也让我们看到了长期投入的价值。无论是技术分享、社区维护,还是与开发者和生态伙伴的协作,开源社区的发展都离不开每一位参与者的付出。
恭喜 Jimmy,也感谢所有维护者、贡献者和生态伙伴一直以来的支持与共同努力。
持续探索,让异构算力管理更加灵活
回顾这次 KubeCon,HAMi 展示的不仅是现有 GPU 共享与虚拟化能力,也包括项目在资源调度、异构硬件支持和 Kubernetes 原生设备管理方向上的持续探索。
一方面,Binpack、Spread 和拓扑感知调度等能力,让 GPU 资源能够更好地匹配不同工作负载的需求;另一方面,HAMi-DRA 也在探索与 Kubernetes 原生资源管理体系及不同调度器的协同路径。
这些技术方向的持续推进,离不开社区维护者、贡献者、用户与生态伙伴的共同参与。
HAMi 将继续围绕 GPU 虚拟化与异构算力统一调度开展技术探索,推动项目能力完善、硬件支持拓展与生态协作。
期待与更多开发者在下一场社区活动中相见,也欢迎加入 HAMi 社区,一起交流技术、反馈需求、参与贡献!