HAMi Meetup 上海站深度解读(一):CNCF × PyTorch 的云原生 AI 基座里,HAMi 解决哪一层问题?
模型已经能跑起来,业务却迟迟难以上线;一边在等待 GPU,另一边的设备又没有被充分使用。对企业 AI 平台团队而言,难点往往出现在模型、工具链与基础设施的连接处。模型数量继续增加时,这些断点会进一步变成成本、协作和运维压力。
这是 HAMi Meetup 上海站 系列深度解读的第一篇。CNCF 中国区总监、Linux 基金会亚太区副总裁 Keith Chan 在本场活动中带来开场演讲《CNCF x PyTorch:构筑面向产业落地的云原生 AI 研发基座》,给出了一套分层协作的思路。其中,HAMi 被放在调度与资源管理层,承担异构算力共享与管理的角色。从企业平台建设的角度看,理解这一位置,才能判断引入 HAMi 可以解决什么,以及还需要哪些组件配合。
核心亮点
- HAMi 位于调度与资源管理层,与模型框架、工作流组件分工协作。
- HAMi-core 与 KAI Scheduler 的协作,展示共享控制能力接入不同调度体系的路径。
- 企业可从一项训练任务和一个推理服务开始,验证资源申请、执行与观测能否衔接。
演讲嘉宾: Keith Chan|CNCF 中国区总监、Linux 基金会亚太区副总裁
研发基座要解决的,是成本、效率与规模的连锁问题
Keith 将企业 AI 落地的挑战归纳为成本失控、效率瓶颈和规模受限。
成本压力不只来自 GPU 的采购价格。当资源缺少统一调度,小任务长期独占设备,空闲算力便难以被其他团队使用。环境搭建和工具链集成反复进行,也会持续消耗人力。
效率问题则贯穿研发到上线的过程。开发、训练和部署使用不同环境,团队就要反复处理依赖、配置与交接。模型在研发环境中验证成功,并不代表已经具备稳定上线的条件。
当更多业务接入,原本可以靠人工处理的问题会变得难以维护。模型如何统一部署,资源如何分配,出现异常后由谁定位,都需要明确的平台能力与协作规则。
因此,云原生 AI 研发基座的建设目标,是把数据、训练、部署和运行管理接起来,通过标准化流程、自动化执行和资源调度,减少每个项目重新搭建基础设施的负担。
CNCF 与 PyTorch 的连接点,在完整的工作流里
这场分享没有把研发基座归结为某一个项目,而是展示了一套分层协作的思路。
底层由 Kubernetes 承担容器编排、节点、网络和存储等基础工作。向上一层,Volcano 处理批量任务调度,Kueue 管理作业队列与配额,HAMi 提供异构设备共享与管理能力。它们共同面对资源问题,但关注的粒度不同:队列决定任务获得资源的规则,设备管理还要处理一张卡如何供多个任务使用。
再向上,是训练编排、模型服务和流水线。Kubeflow Trainer、KServe、Argo Workflows 等组件把具体任务组织成可管理的生命周期。PyTorch 及其周边训练、微调和推理工具,则承接模型计算与执行。
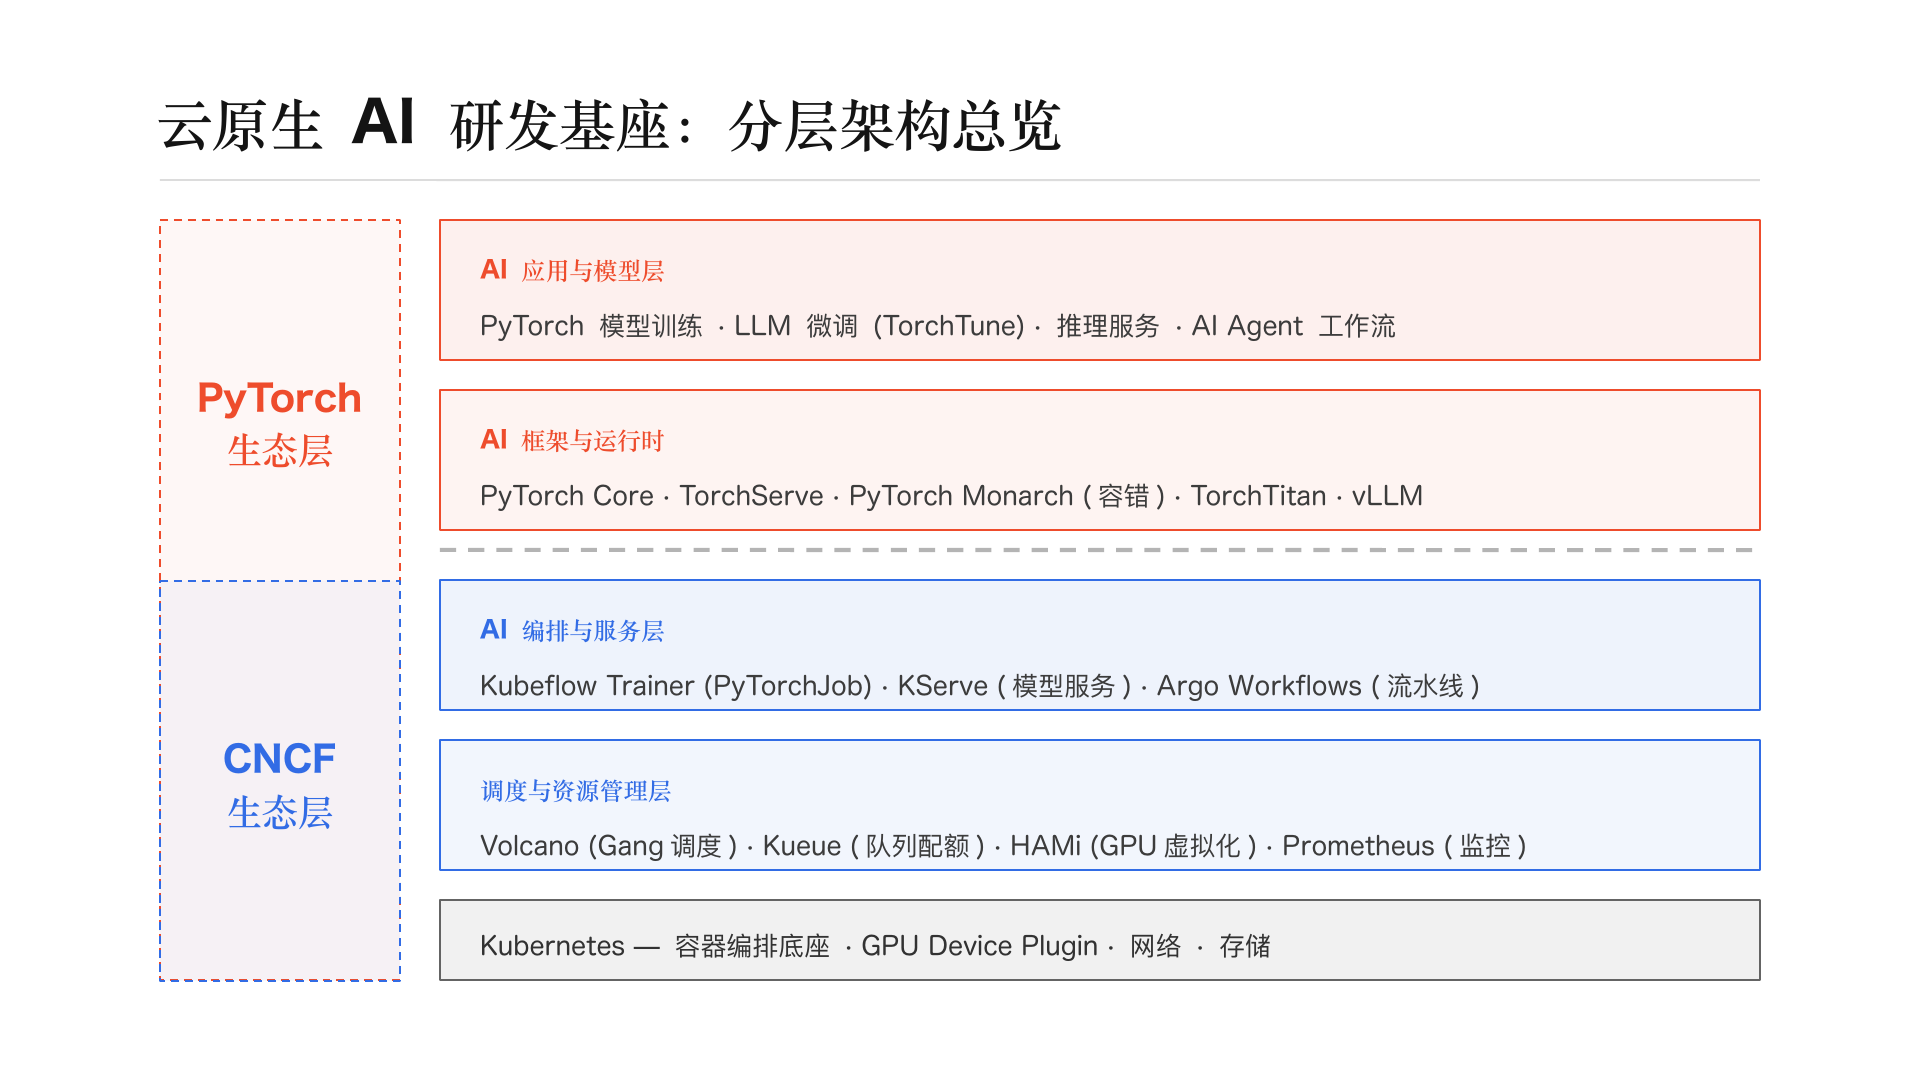
这套分工帮助平台团队回答一个很实际的问题:出现瓶颈时,应当改哪一层?任务排队与模型执行缓慢不是同一个问题,队列配置、设备分配和模型运行时也不能互相替代。
组件之间可以组合,并不代表企业需要一次性部署全部组件。先明确业务所需的训练、推理与资源治理能力,再选择对应的实现,才能避免平台越建越复杂,业务仍然难以使用。
从 Uber 的架构案例,看清模型、执行与资源的边界
Keith 以 Uber Michelangelo 平台为例,介绍了模型训练与基础设施分层的设计。
在分享展示的架构中,PyTorch 与 DeepSpeed 承担模型训练工作,Ray 作为统一的分布式执行层,Kubernetes 负责 GPU 集群资源编排。模型定义、分布式执行和资源管理分别落在不同层级,协作关系更加清晰。
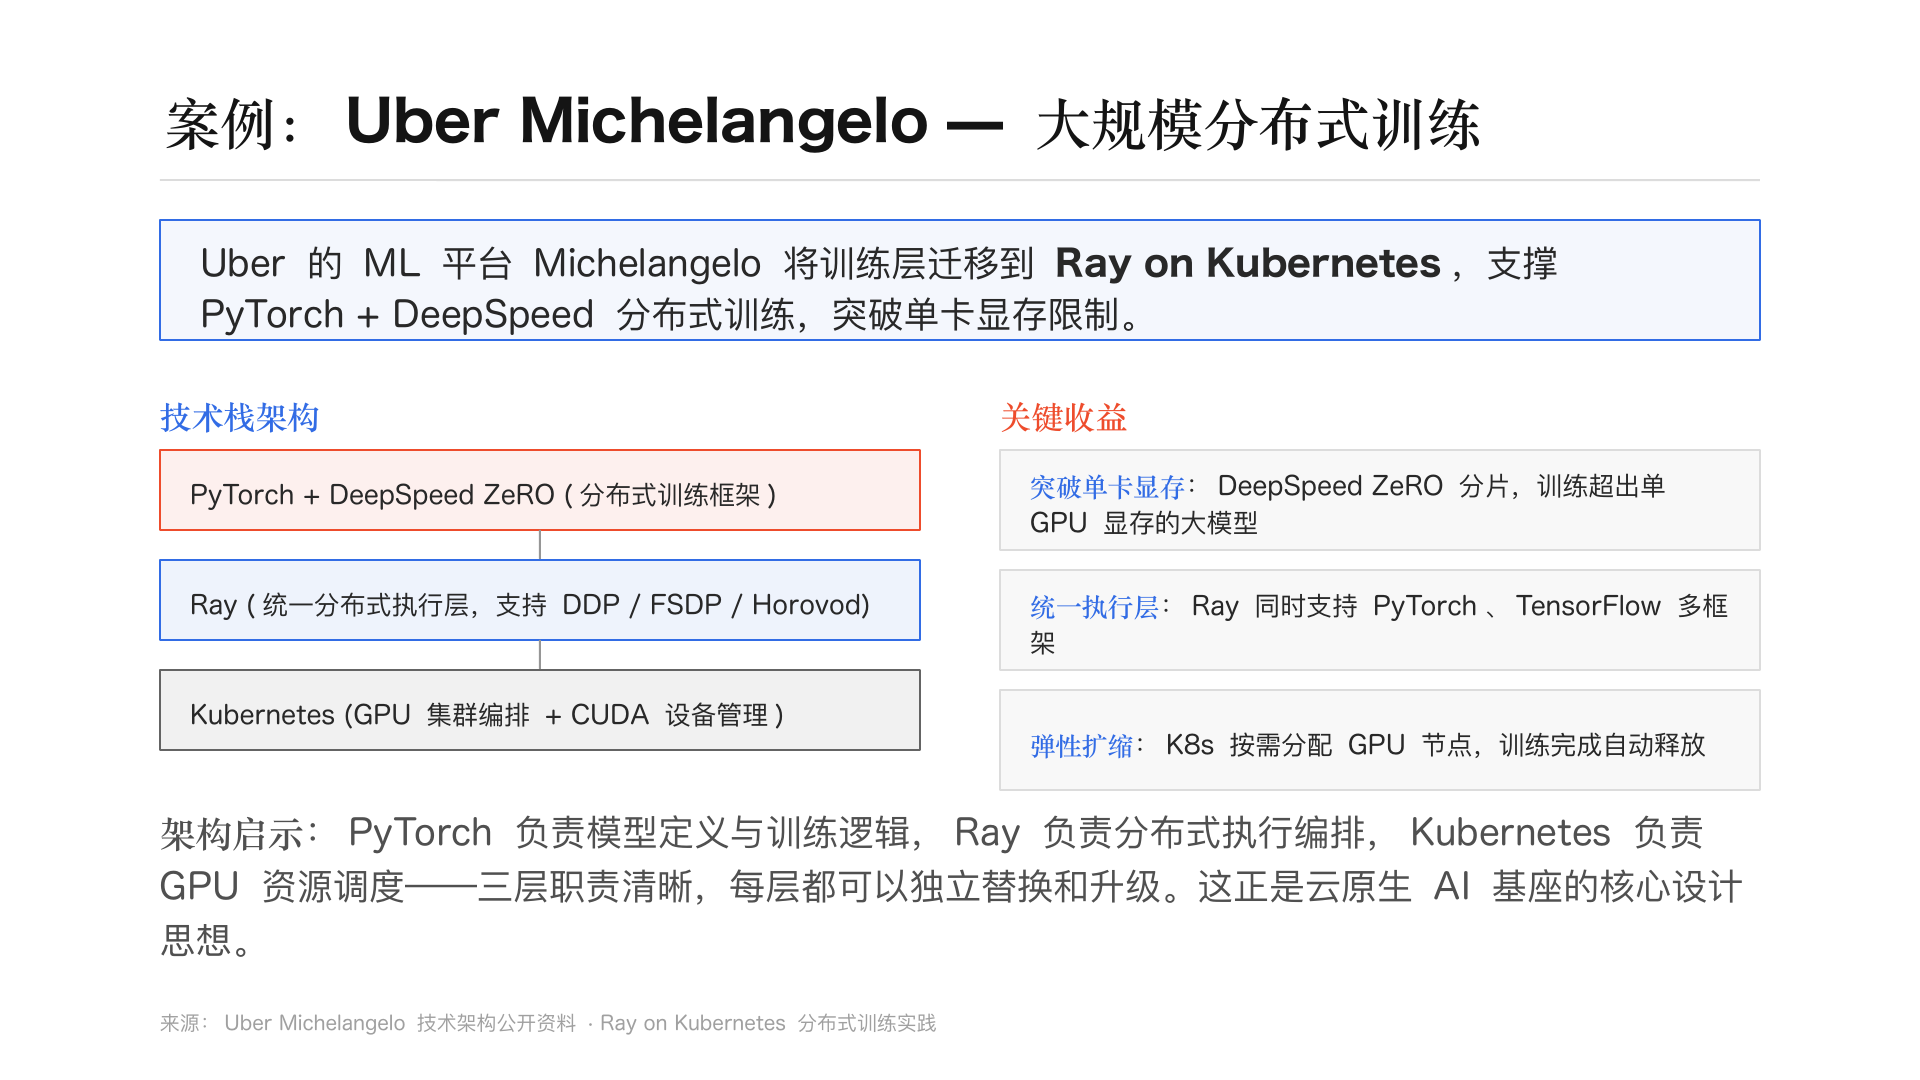
这一案例可以借鉴的重点,是职责边界,而不是照搬整套技术栈。
对已有 AI 平台的企业,框架更新不应要求资源管理体系全部重做;扩展 GPU 资源,也不应让算法团队重新理解底层每一项调度细节。清晰的接口与分层,可以为后续升级、替换和扩展留下空间。
HAMi 的价值,落在异构设备共享与资源控制上
回到 Keith 展示的整体研发基座,HAMi 面向的是资源管理层的问题:让适合共享的任务按需使用 GPU,并把不同类型的加速设备纳入统一管理。模型训练和执行仍由上层框架承担,HAMi 为这些负载提供设备共享、资源限制与调度能力。Uber 案例说明的是分层方法,演讲没有将其描述为 HAMi 的采用案例。
Keith 还提到 HAMi-core 被 KAI Scheduler 采用。这体现了共享控制能力可以与不同调度体系协作的价值。对企业来说,引入 HAMi 可以围绕已有平台的资源短板展开,无需把模型框架、工作流与调度系统视为必须整体替换的一套组件。
这种组合仍有清楚的边界。不同硬件、驱动和适配方式能够提供的共享与隔离能力并不相同,用户态资源限制也不能等同于硬件级故障隔离。平台需要用自身负载验证配额是否生效、任务之间是否存在干扰,再决定哪些业务适合共享。
跑通一条完整路径,比堆齐组件更有价值
演讲后半段,Keith 特别谈到了兼容性问题。同一项 AI 工作负载,在不同 GPU 驱动、网络配置或扩缩容行为下,可能得到不同的运行结果。底层环境可用,上层模型也可用,两者组合起来仍然需要验证。
他介绍了 Kubernetes AI Conformance 相关工作,强调通过标准化测试降低基础设施与 AI 工作负载之间的不确定性。对企业而言,兼容性验证需要进入选型和交付过程,同时保留真实业务负载下的测试,不能仅凭组件名称判断整套系统已经可用。
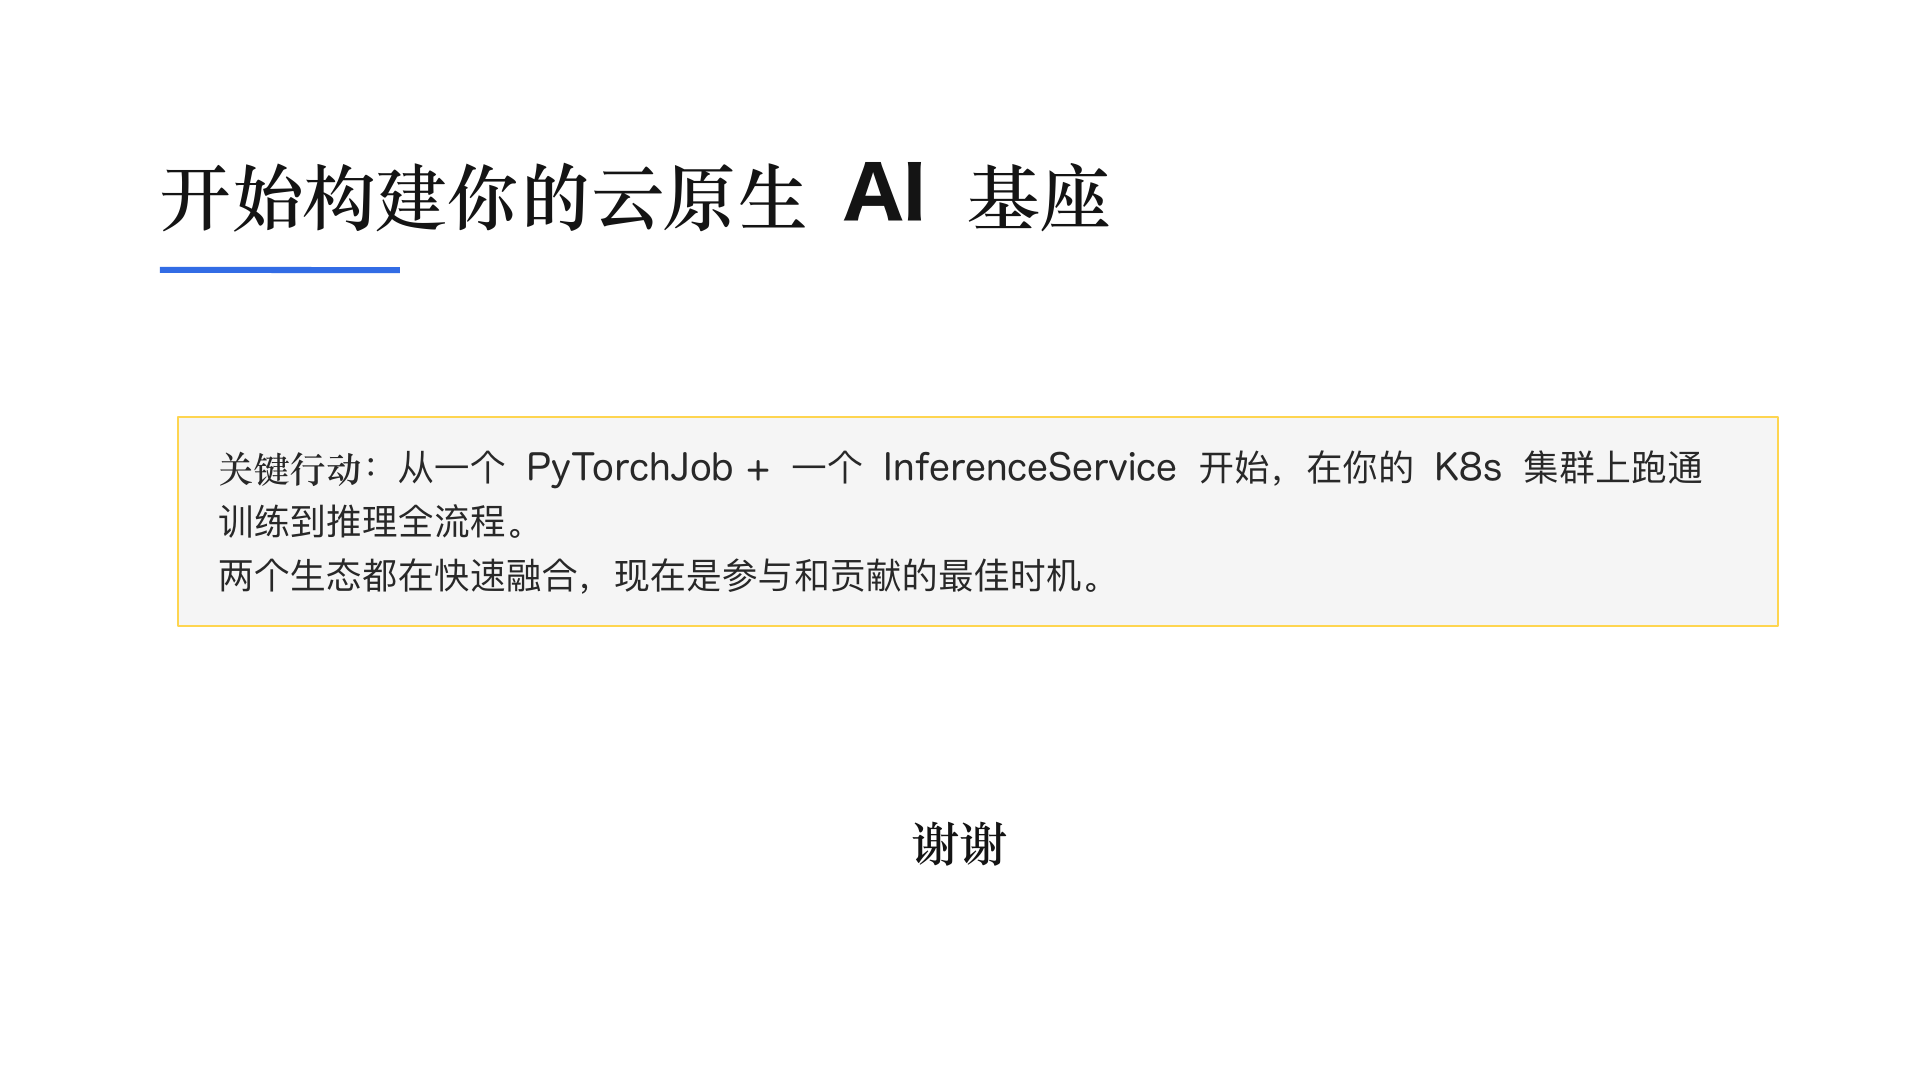
演讲给出的起点很具体:从一项训练任务和一个推理服务开始,在现有 Kubernetes 集群上跑通训练到推理的完整流程,再逐步补齐资源管理、监控和自动化。
密瓜智能关注的企业 AI 基座建设,应从一条真实业务链路验收:训练和推理能否接续运行,资源申请是否得到落实,共享后的运行状态是否可观测。HAMi 提供开源的异构算力管理基础;企业采用时,还需要完成平台集成、设备适配验证和持续运维。明确这些分工,才能把开源组件的能力转化为业务真正用得上的基础设施。