HAMi Meetup 上海站深度解读(二):GPU 共享之后,HAMi 如何进一步做好隔离、调度与观测?
把一张 GPU 分给多个任务,只是资源共享的开始。对企业平台团队来说,还要确认每个任务是否遵守配额、分配结果能否被观测,以及不同设备和任务应该如何调度。否则,账面上完成了共享,运行时的资源使用仍然难以掌握。
本文是 HAMi Meetup 上海站 系列深度解读的第二篇。密瓜智能联合创始人兼 CTO、HAMi Maintainer 李孟轩在本场活动的分享《从本地设备到远程算力池:远程 GPU 方案与 HAMi 2.10 新能力》中,介绍了 v2.10 的能力进展、DRA 生态适配,以及演讲时公布的 v2.11 规划。串起这些变化的主线,是让共享后的算力既能按需分配,也能在运行过程中被约束、观测和诊断。
核心亮点
- HAMi-core 配合 KAI Scheduler,将调度分配与运行时资源限制接起来。
- 组合调度策略、mutex 与动态 MIG 分别处理任务放置、互斥和分配灵活性问题。
- HAMi-DRA 补充资源申请转换、集群监控与调度事件;Remote GPU 和 CPU NUMA 对齐属于演讲时的后续规划。
演讲嘉宾: 李孟轩|密瓜智能联合创始人兼 CTO、HAMi Maintainer
分配了多少,还要看实际用了多少
李孟轩从两个常见场景切入:小任务按整卡申请,资源容易闲置;不同厂商、不同型号的设备分散管理,可能出现部分集群排队、部分集群空闲的情况。
HAMi 作为异构算力虚拟化中间件,在 Kubernetes 环境中提供设备共享与统一管理能力。任务可以声明所需的设备型号和资源,平台也可以把任务、设备、已分配额度与实际使用情况放到同一视图里观察。
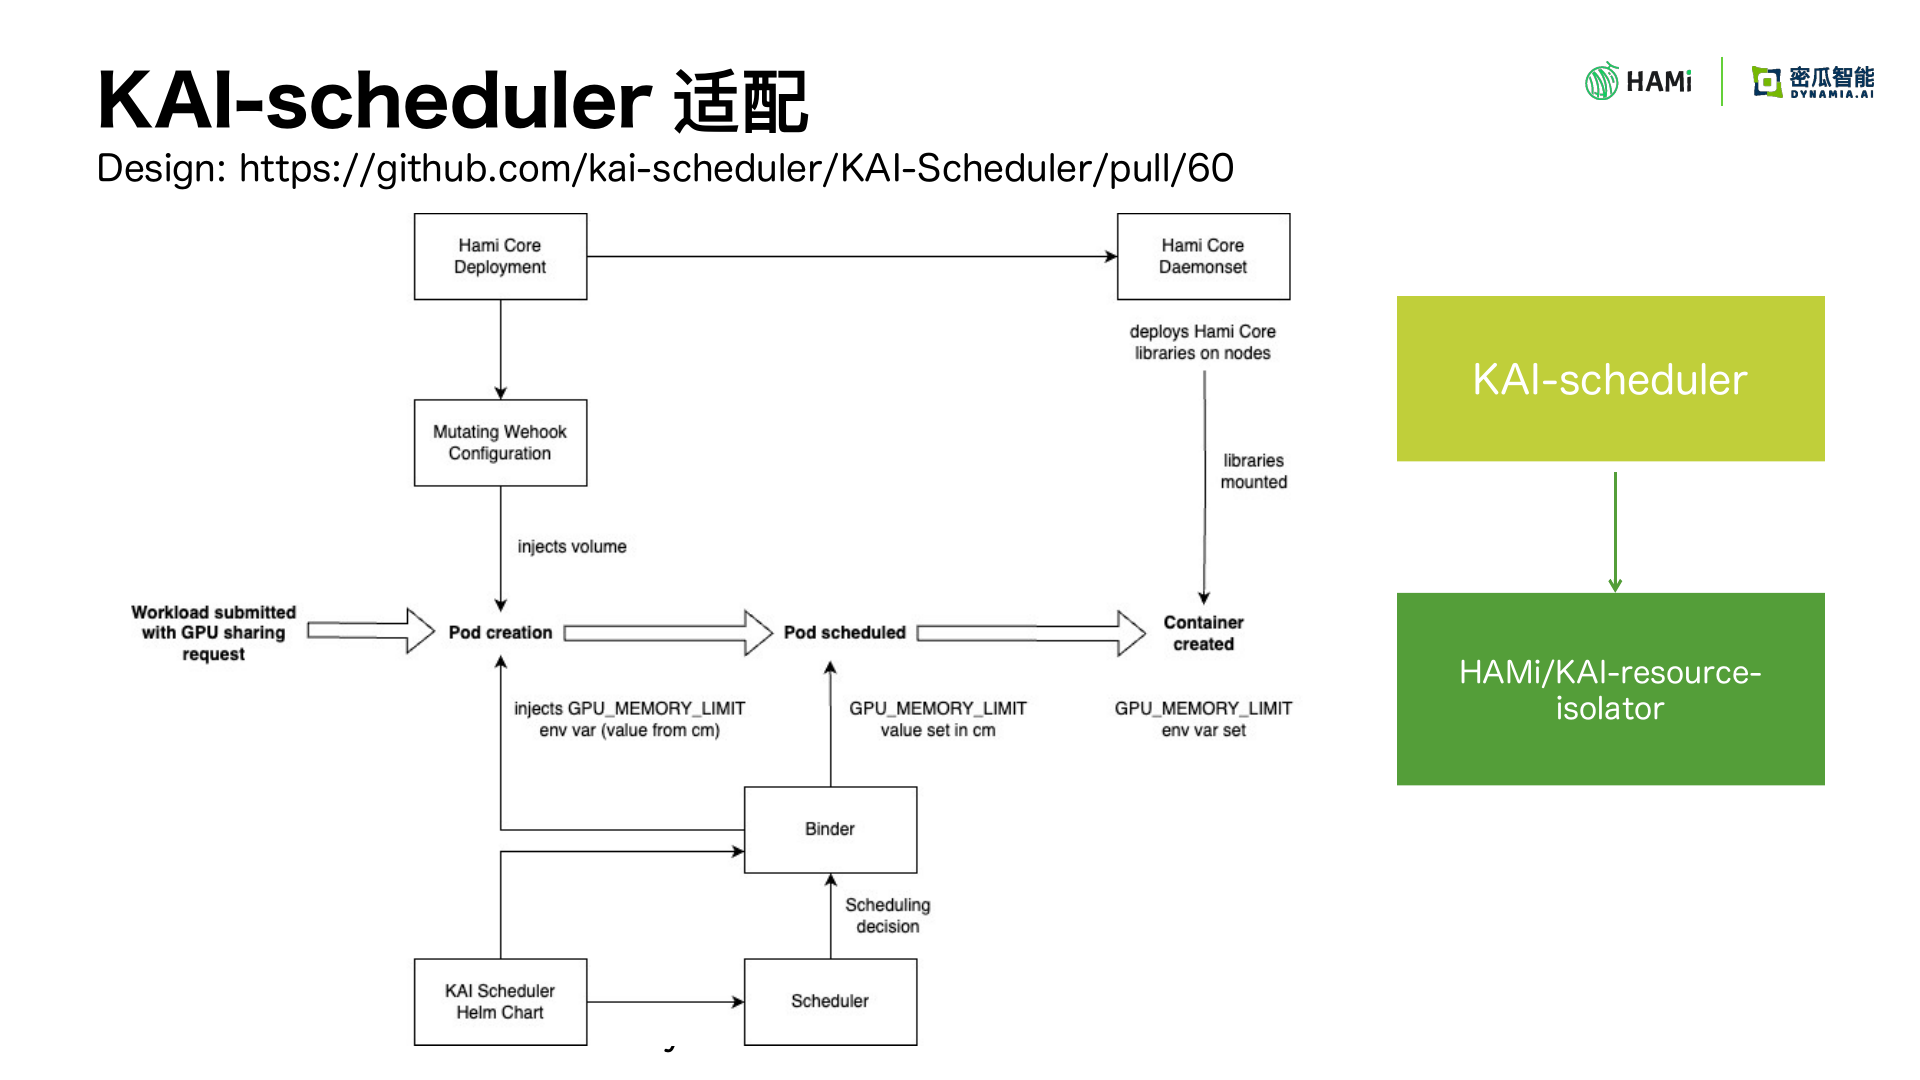
KAI Scheduler 的适配体现了 HAMi-core 与调度生态的分工。按分享介绍,调度器根据资源声明安排任务,HAMi-core 则通过相应注入组件进入容器,根据分配信息执行显存与算力限制。前者决定资源如何分配,后者约束资源实际如何使用。企业已有调度体系时,可以沿着这一接口考虑共享能力的集成;部署仍需匹配组件与版本,不能只安装调度器就默认具备运行时控制。
昇腾软切分的更新则聚焦另一个问题:限制已经生效,用户却可能仍从设备查询工具中看到整卡显存。新增监控指标提供容器级显存使用量、显存上限等信息,让平台能够区分设备总量与任务配额,判断切分是否按预期工作。
调度策略可以组合,资源共享也需要边界
同样是多任务共享 GPU,不同业务的诉求可能相反。有的团队希望任务尽量集中,释放完整设备;有的任务对资源争用更敏感,希望分散运行。涉及多卡通信时,设备之间的拓扑关系又会影响数据传输。
李孟轩介绍,v2.10 将调度策略变得更加可组合。例如,任务可以选择 spread 策略,也可以在分散调度的基础上组合 NUMA 考量,让调度行为更明确地对应业务要求。
新增的 mutex 策略,则提供了 GPU 级别的任务互斥能力。指定 mutex 的任务,不会与其他同样指定 mutex 的任务共享一张卡,适用于希望特定任务或副本避免落在同一设备上的情况。它不等同于禁止所有其他任务使用这张卡,策略边界需要准确理解。
昇腾场景中的异构任务支持,也允许任务在符合条件的模板切分节点与软切分节点之间获得调度机会,减少必须预先指定单一切分方式带来的限制。统一调度的前提,仍是任务与设备能力相匹配。
动态 MIG 与 DRA,分别改善分配灵活性和使用体验
动态 MIG 的更新针对预设切分模板可能带来的不灵活。
如果先按小任务的需求把整张卡切成小份,后续较大的任务就可能无法落入剩余分区。分享介绍的新方式,会跟踪设备槽位分布,根据任务申请匹配可用的 MIG 规格与位置,而不是一开始就按固定模板切完整张卡。
这种方式提高了分配灵活性,但仍然受支持的 MIG 规格与可用槽位约束。剩余总量看起来足够,并不代表一定存在符合条件的分配位置。
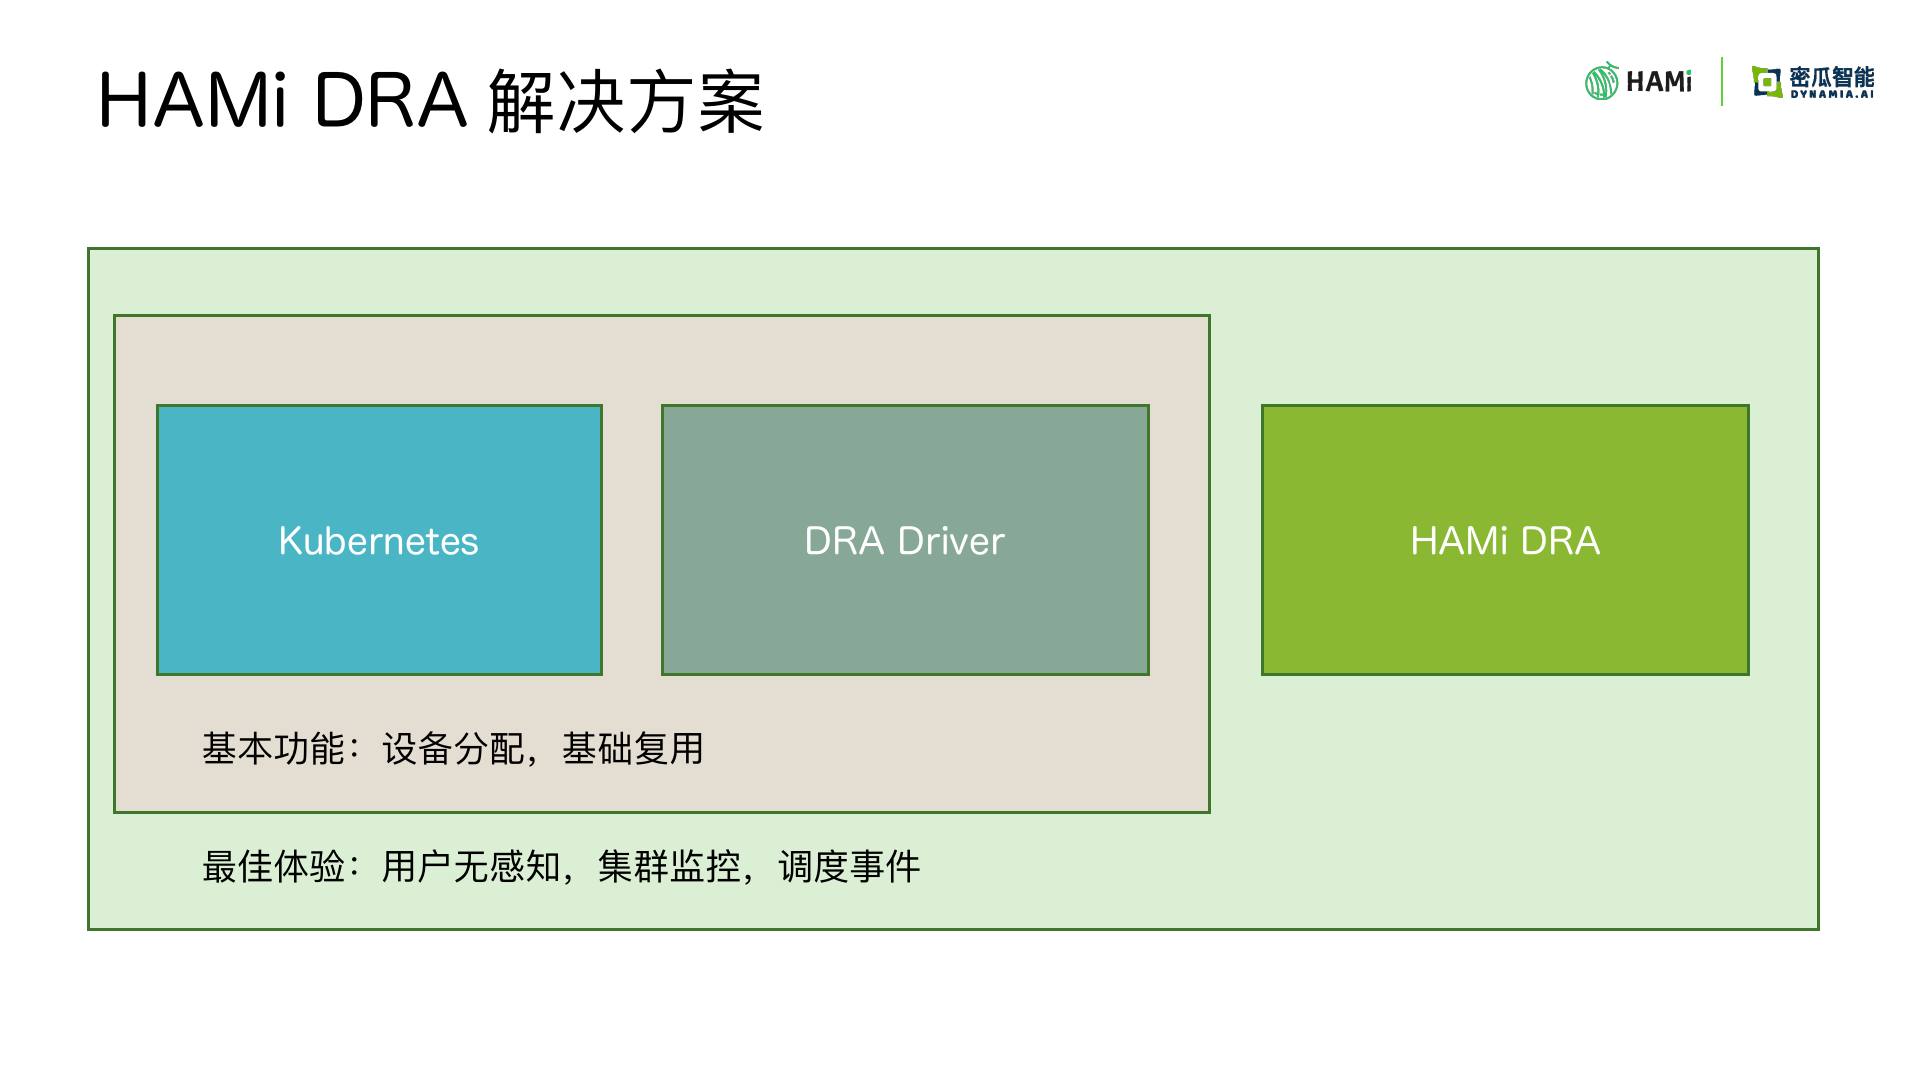
DRA 相关进展解决的是另一层问题。设备能够通过 DRA 分配后,用户还需要熟悉的申请方式、完整的资源视图,以及任务无法调度时的解释。
HAMi-DRA 围绕这些使用环节,提供资源请求到 DRA 分配逻辑的转换,并补充集群监控与调度事件。平台人员可以更直接地了解资源剩余情况,定位任务究竟受设备类型、显存还是其他条件限制。本次分享还介绍了昇腾 DRA 适配进展;实际部署需要核对 Kubernetes 版本与对应设备驱动支持。
远程 GPU 与 CPU NUMA 对齐,是下一步规划
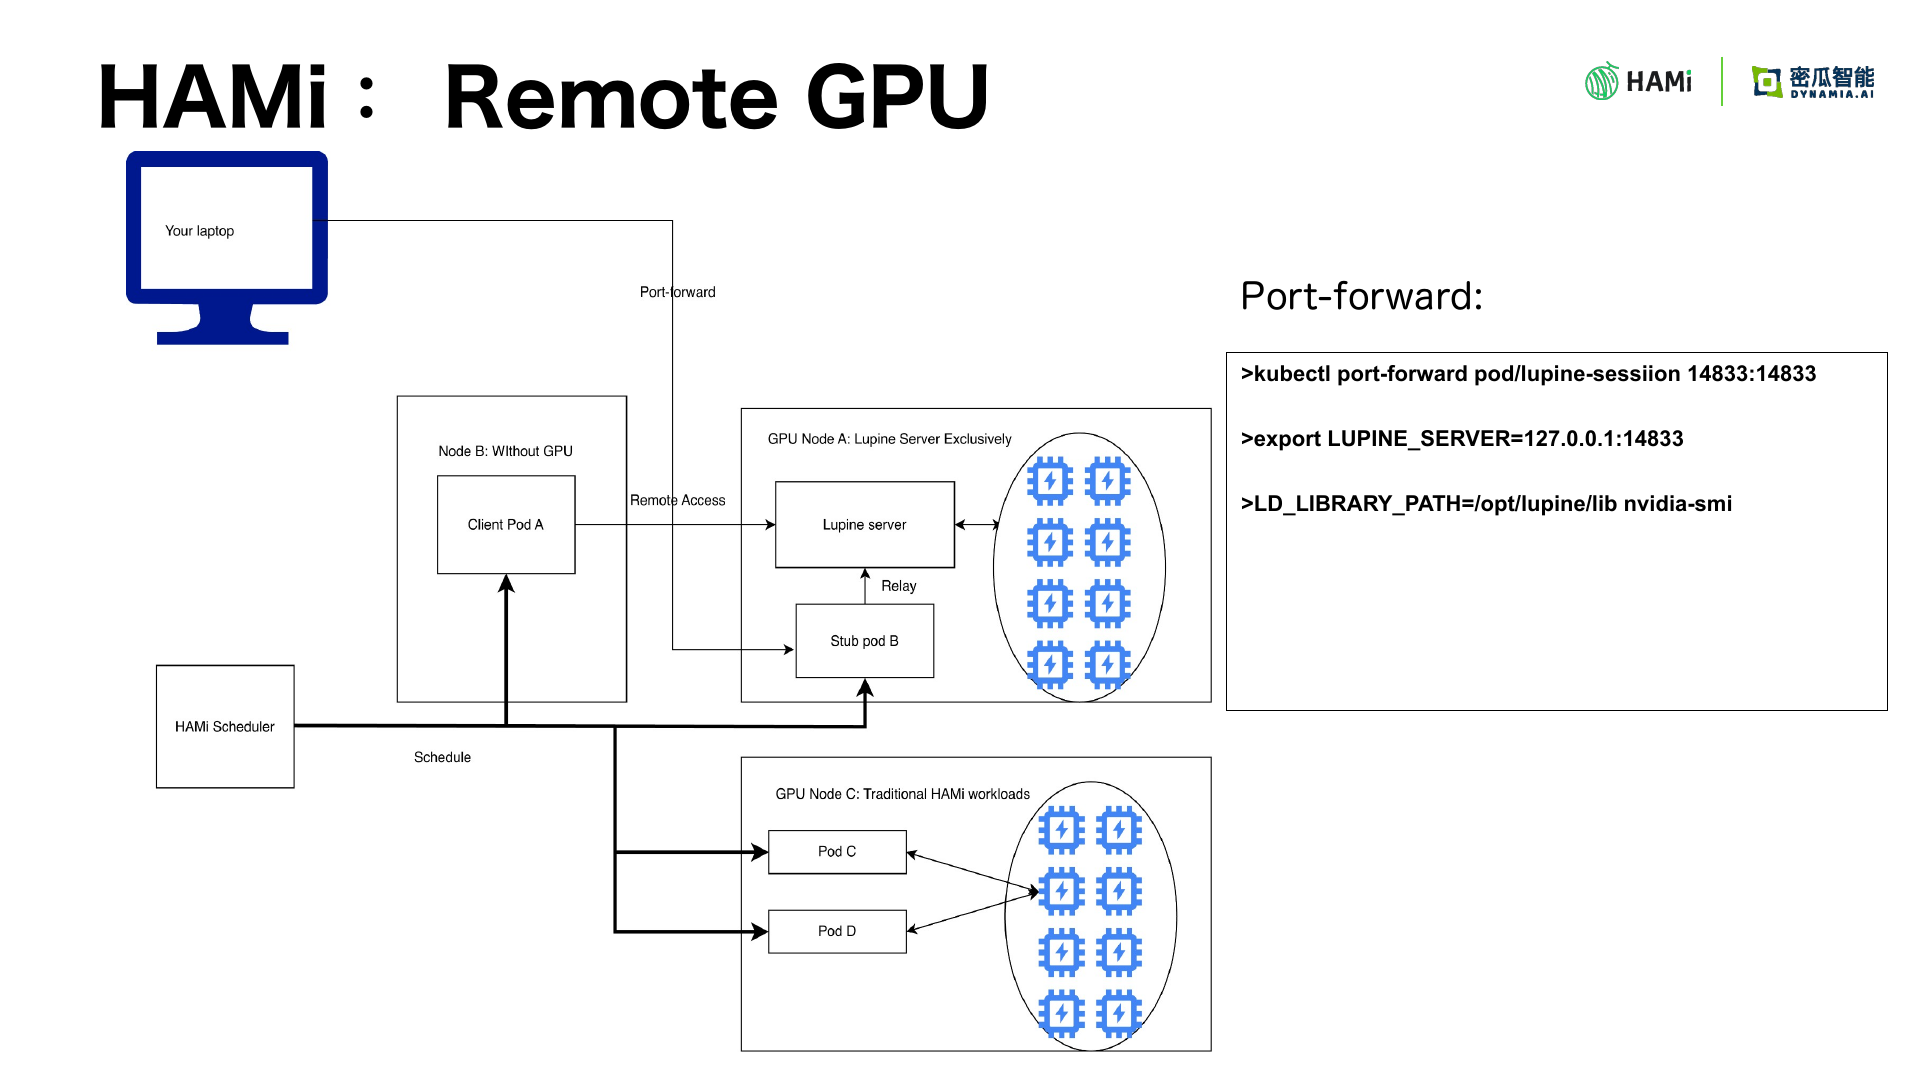
李孟轩将 Remote GPU 列入演讲时的 v2.11 路线图。它面向的是新的使用需求:任务运行的节点没有 GPU,也能通过网络申请并访问远端算力。以下内容按分享中的设计方向介绍,与前文的 v2.10 能力分开理解。
规划方案借助开源项目 Lupine,让运行在其他节点上的任务连接远端 GPU。HAMi 负责感知远端资源、参与调度,并自动处理连接所需的配置。按分享中的设计,划定为远程 GPU 模式的设备节点,将用于接收相应的远程资源请求。
这一方向扩展了算力池的使用方式,但跨节点访问仍然经过网络。网络条件、传输开销与具体工作负载,会影响它的适用范围,不能据此推导出与本地 GPU 等价的性能。
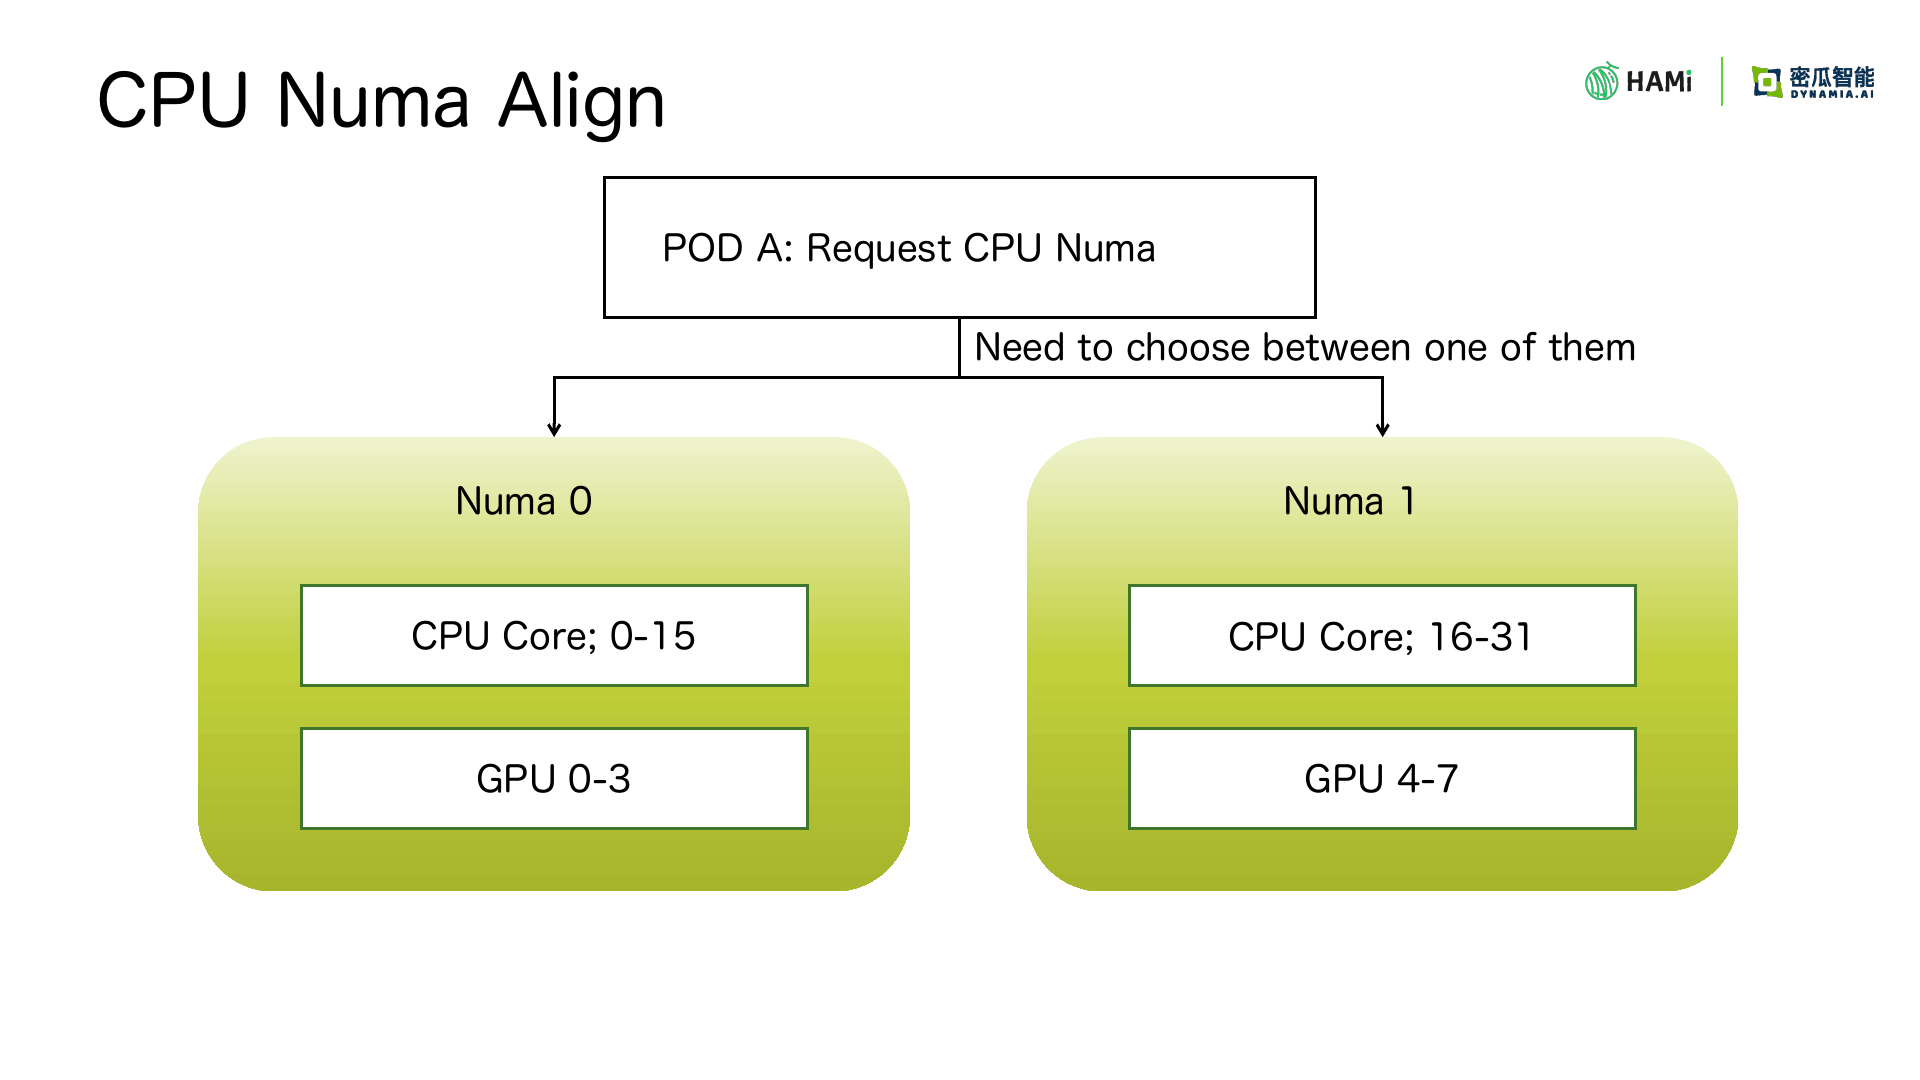
另一个规划是 CPU 与 GPU 的 NUMA 对齐。李孟轩明确指出,已有的 GPU 间 NUMA 考量,尚不等于 CPU 与 GPU 已经处于同一 NUMA 节点。后续计划把两者的分配关系一起纳入,减少跨 NUMA 数据交换带来的额外开销。
密瓜智能看待 HAMi 的企业价值,重点在共享之后的运行质量。平台应同时检查申请额度与实际占用,按业务约束选择调度策略,并在任务无法分配时获得可解释的原因。演讲还提出与 llm-d 等推理框架探索协同,通过 GPU 拓扑感知等资源层能力配合上层推理编排;这一方向同样需要具体场景验证。对企业团队,HAMi 的评估应落在这些可检查的行为上,而不止于一张卡能够划出多少份。
视频回放及 PPT 下载
- B 站回放: 主题演讲 | 从本地设备到远程算力池:远程 GPU 方案与 HAMi 2.10 新能力 —— 李孟轩
- 下载 PPT: remote-gpu-hami-2.10-limengxuan.pdf