

Von exklusiven GPUs zu feiner Ressourcenfreigabe: Wie SERES mit HAMi täglich über 10 Milliarden Inferenz-Tokens verarbeitet
 Fallstudien
SERES hat HAMi in seine Inferenzplattform SeresCloud integriert, um Grafikspeicher und Rechenleistung für kleine Modelle bedarfsgerecht zuzuweisen und mit der automatischen Skalierung zu verbinden. Die Fallstudie beschreibt Ressourcenverwaltung und GPU-Auslastung bei einem Volumen von über 10 Milliarden Tokens pro Tag.
Auf dieser Seite
Über SERES
Die SERES Group wurde 1986 gegründet und hat ihren Sitz in Chongqing. Das Technologieunternehmen konzentriert sich auf Fahrzeuge mit alternativen Antrieben. Die gemeinsam mit Huawei entwickelte Automobilreihe AITO ist auf dem Markt bekannt.
SeresCloud ist die intern entwickelte KI-Infrastrukturplattform von SERES. Sie stellt Geschäftssystemen und Agent-Anwendungen einheitliche Modelldienste bereit und ist mit Kubernetes-Clustern und GPU-Pools verbunden. Darauf laufen Inferenz-Workloads wie Embedding, Rerank, Sprachsynthese, OCR und große Sprachmodelle.
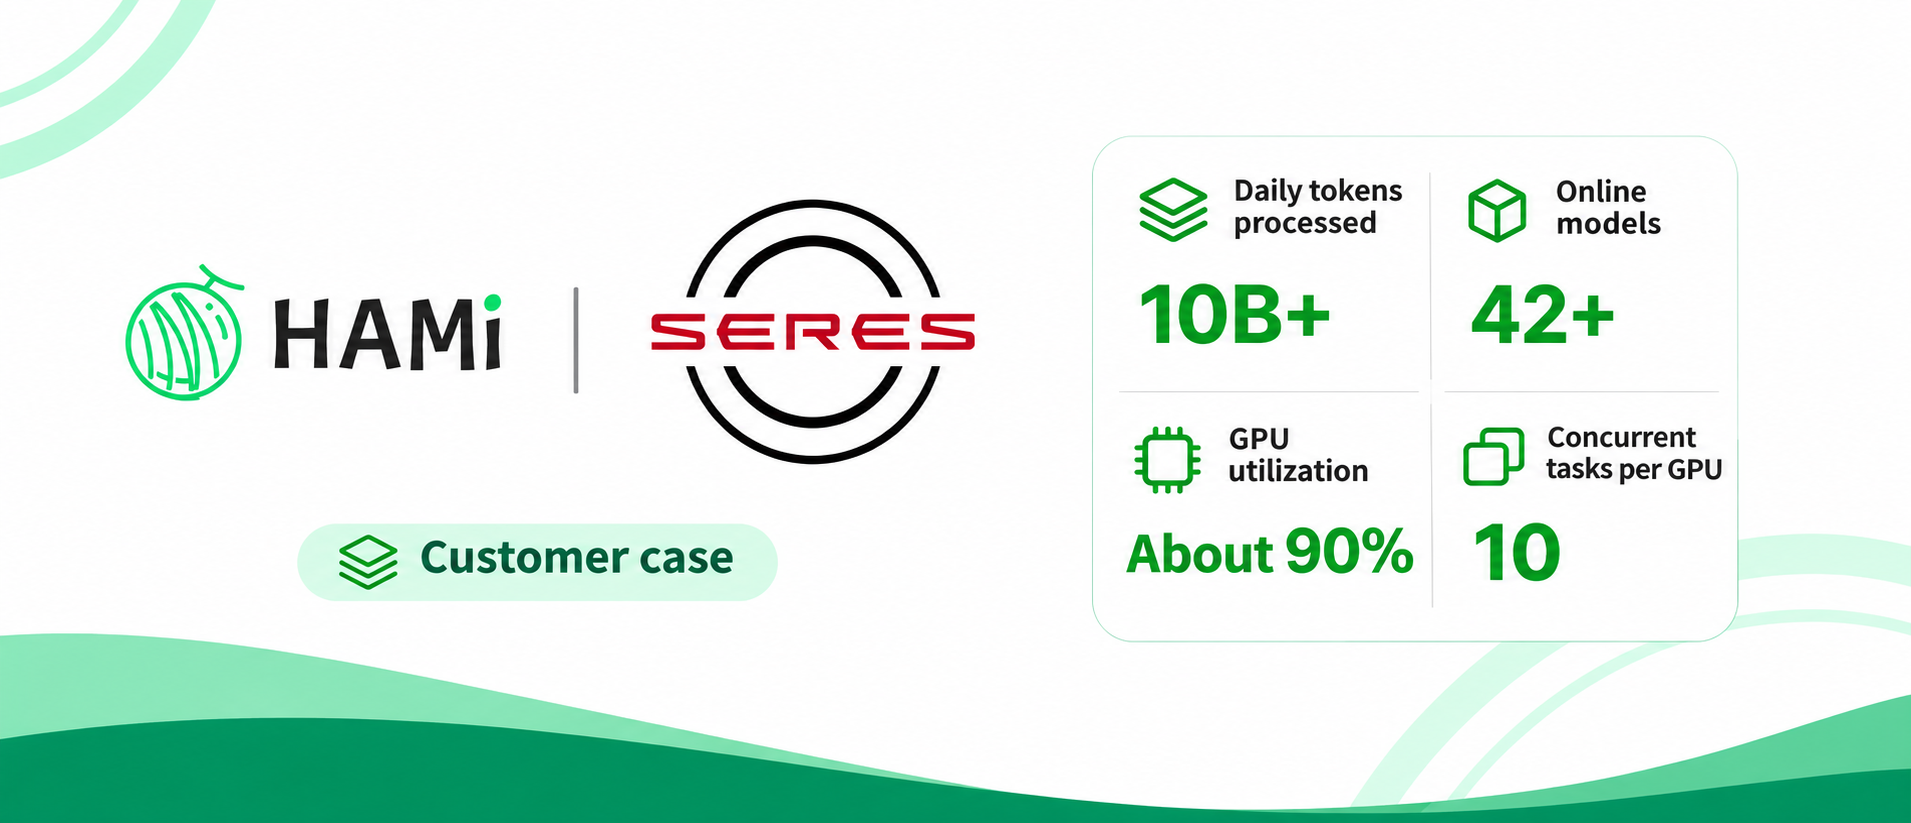
Geschäftsanforderung: Mehr als 10 Milliarden Tokens pro Tag
Mit der zunehmenden Nutzung von KI-Agenten im Unternehmen wuchs das Inferenzgeschäft von SERES rasch.
Anfang 2026 liefen auf der internen Plattform SeresCloud etwa 10 Online-Modelle, die täglich ungefähr 300 Millionen Tokens verarbeiteten. Nur wenige Monate später waren es mehr als 42 Modelle und über 10 Milliarden Tokens pro Tag – ein Anstieg von über 3.000 %.
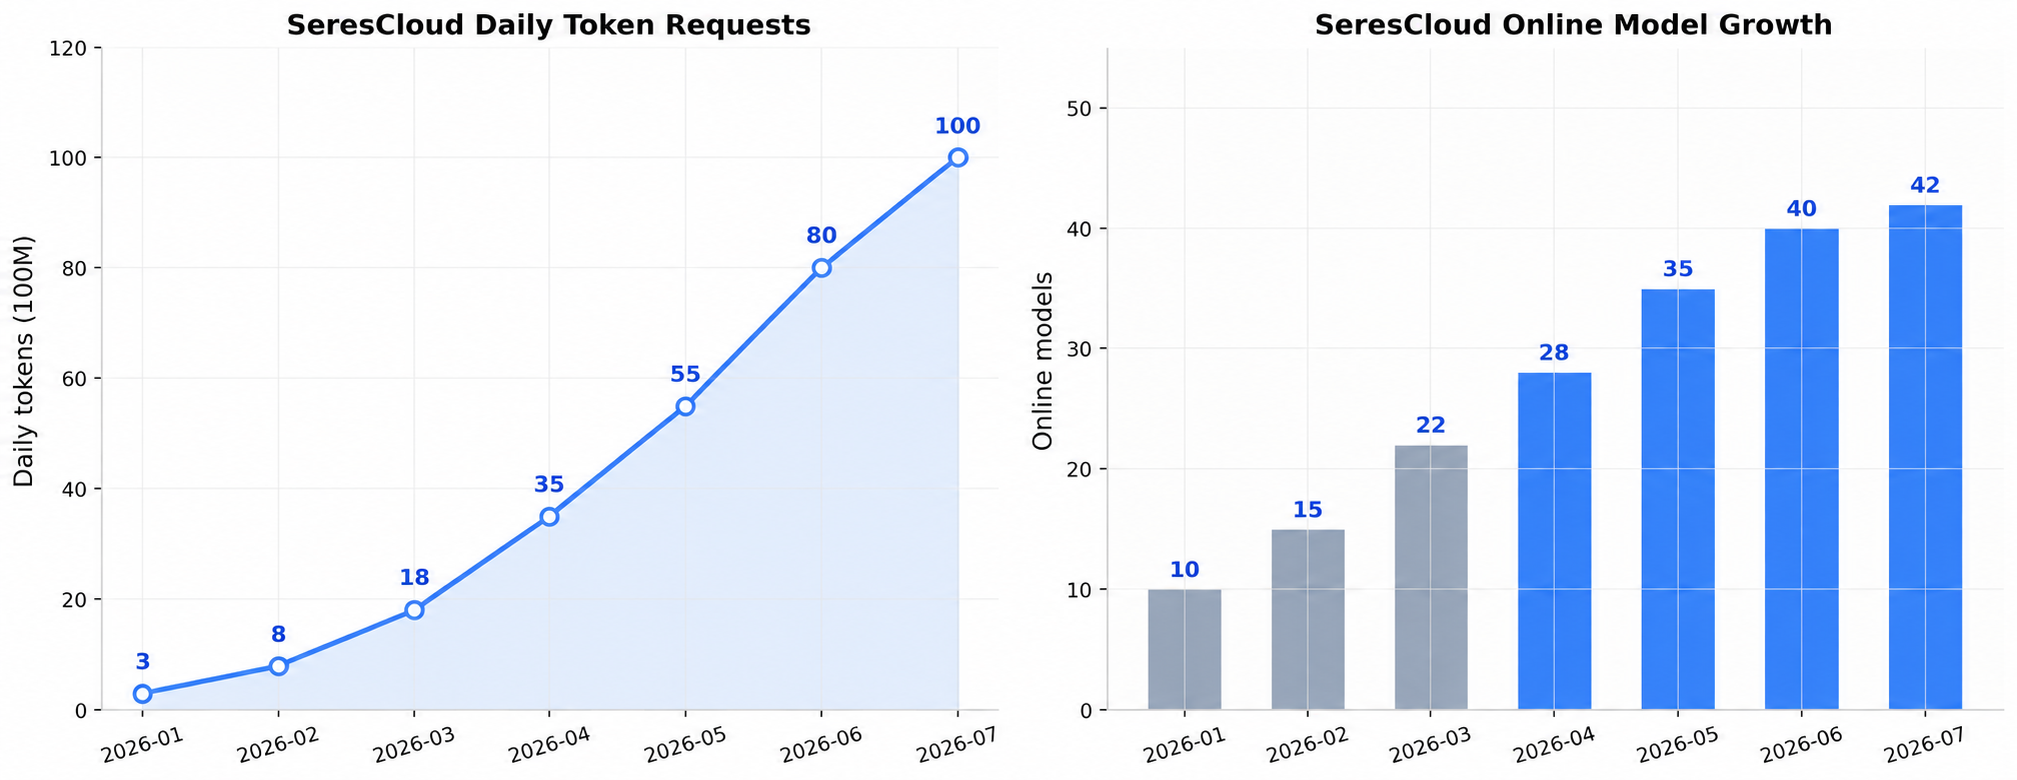
Dieses Wachstum stellte neue Anforderungen an die Verwaltung der GPU-Ressourcen.
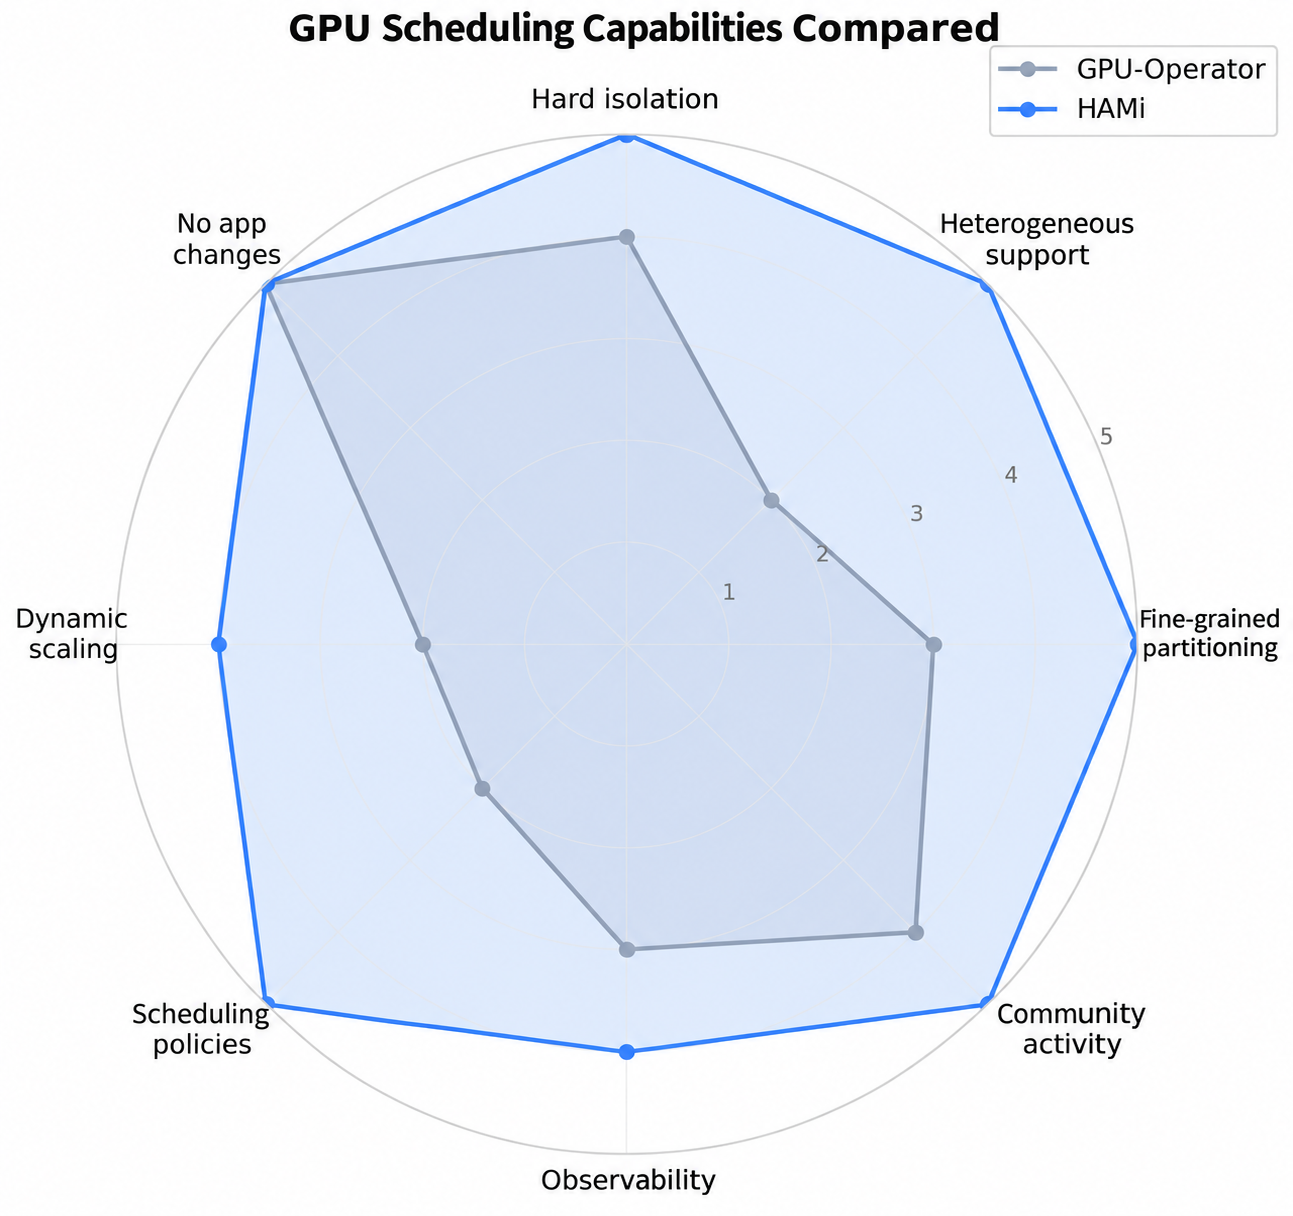
Anfangs nutzte SERES vor allem NVIDIA GPU Operator. Allgemeine GPU-Aufgaben konnten eine ganze Karte erhalten. Bei Geräten wie A100 und H100 mit MIG-Unterstützung (Multi-Instance GPU) konnte eine physische GPU in unabhängige Hardwareinstanzen aufgeteilt werden.
Für die anfänglichen Anforderungen reichte dies aus. Mit mehr Inferenzmodellen und einem größeren GPU-Cluster traten jedoch Probleme auf.
Viele leichte Inferenzaufgaben benötigten keine ganze GPU. Gleichzeitig unterschieden sich die Verwaltungsverfahren je nach GPU-Modell. Die Plattform musste die Auslastung erhöhen und zugleich Workload-Isolation und Stabilität sichern.
SERES suchte nach einer flexibleren Möglichkeit zur gemeinsamen GPU-Nutzung und entschied sich schließlich für das Open-Source-Projekt HAMi.
HAMi ermöglicht eine fein abgestufte Zuweisung von Grafikspeicher und Rechenleistung, darunter prozentuale Compute-Kontingente. Außerdem verwaltet es heterogene Beschleuniger wie NVIDIA-GPUs, Huawei Ascend, Hygon DCUs und Cambricon MLUs einheitlich. Als CNCF-Incubating-Projekt passten seine Funktionen für Sharing, Isolation und heterogene Geräte zu den Anforderungen von SERES.
Lösung
Mit HAMi musste SERES seine gesamte KI-Inferenzplattform nicht neu aufbauen.
Das Unternehmen hatte SeresCloud bereits als eigene Inferenzplattform entwickelt. Sie bietet internen Geschäftssystemen und Agent-Anwendungen einheitliche Modelldienste und ist mit Kubernetes-Clustern und GPU-Pools verbunden.
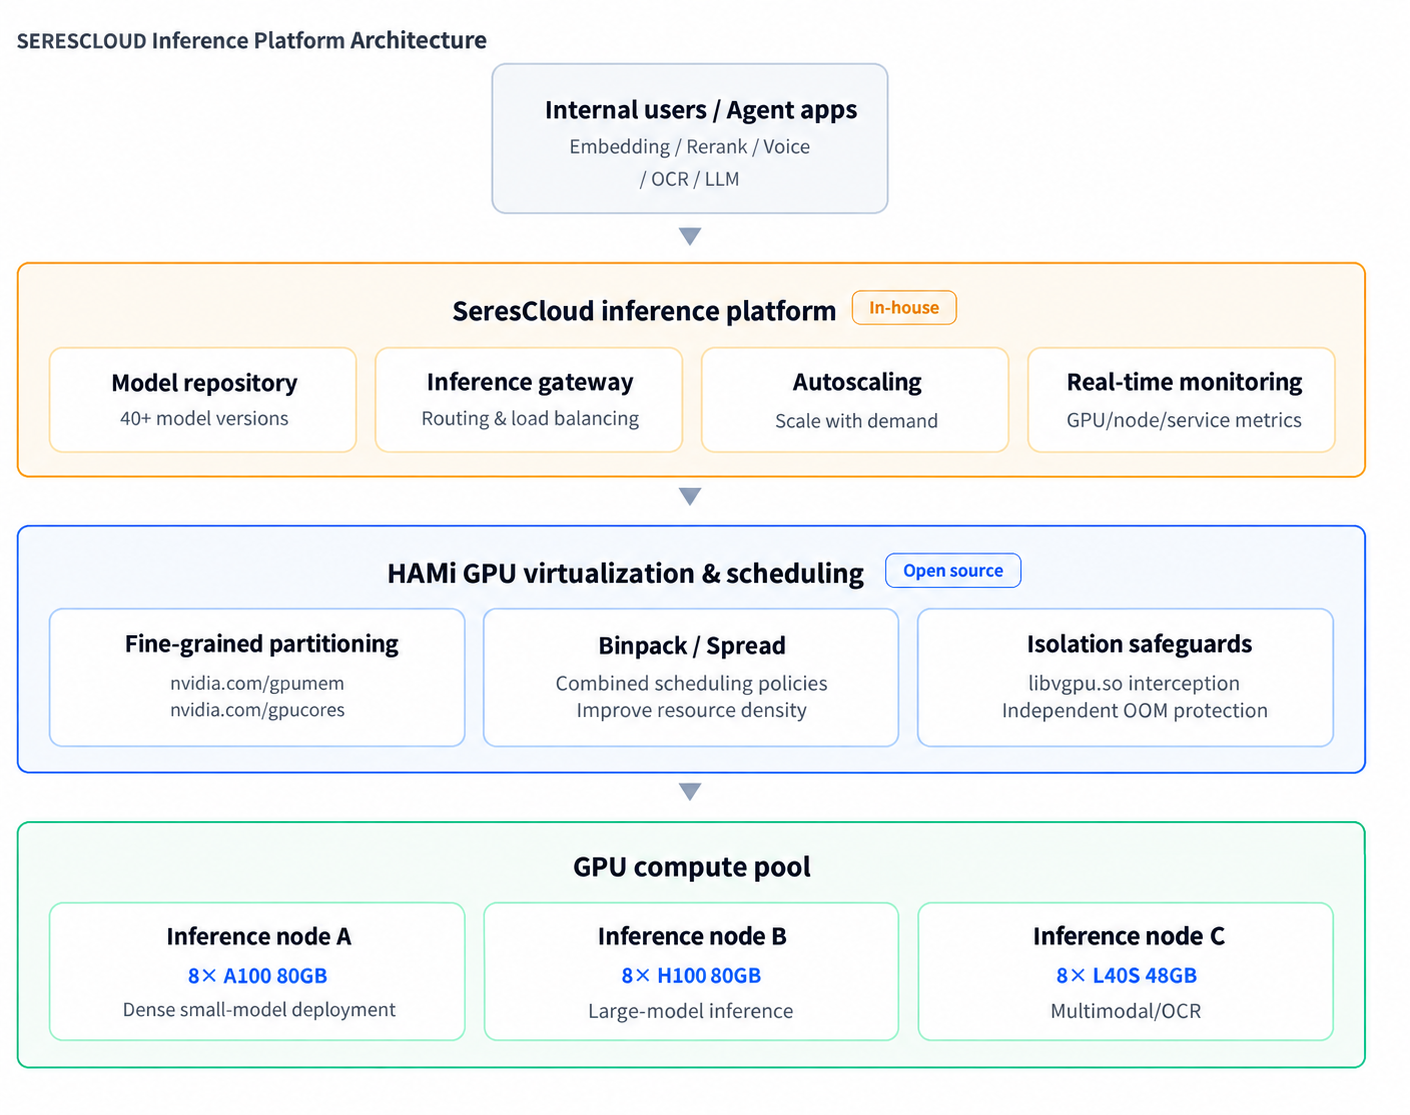
Die Plattform verfügte bereits über umfassende Funktionen für Inferenzdienste:
- Modell-Repository: Verwaltet Versionen, Images und Konfigurationen von über 40 Modelltypen und unterstützt die Bereitstellung mit einem Klick.
- Inferenz-Gateway: Stellt einen einheitlichen Diensteinstieg mit Traffic-Routing, Lastverteilung, Rate Limiting und Circuit Breaking bereit.
- Automatische Skalierung: Passt die Zahl der Inferenz-Pod-Replikas anhand von QPS, GPU-Auslastung, Tiefe der Anfragewarteschlange und weiteren Echtzeitmetriken an.
- Echtzeitüberwachung: Überwacht Modelldienste, GPU-Knoten sowie Grafikspeicher- und Rechennutzung durchgängig.
SERES brauchte keine zweite Inferenzplattform, sondern eine genauere Verwaltung der zugrunde liegenden GPUs, die zur vorhandenen Architektur passt. HAMi übernahm diese Rolle als Schicht für GPU-Virtualisierung und Scheduling.
In der neuen Architektur skaliert SeresCloud die Dienste nach Geschäftsbedarf, während HAMi GPU-Ressourcen fein abgestuft zuweist, plant und isoliert.
SeresCloud entscheidet anhand von Anfragen und Dienstlast, wann hoch- oder herunterskaliert wird. Wenn ein Pod erstellt wird, wählt HAMi anhand des verfügbaren Grafikspeichers, der Rechenleistung und weiterer Ressourcen ein geeignetes Gerät.
Dieses Zusammenspiel bewahrt die Geschäftslogik der vorhandenen Plattform und macht die GPU-Zuweisung flexibler. Für jeden leichten Inferenzdienst muss keine ganze Karte mehr reserviert werden.
Technische Umsetzung
Von ganzen exklusiven GPUs zur feinen gemeinsamen Nutzung
SERES betreibt zahlreiche leichte Inferenzdienste, darunter Embedding, Rerank, Sprachsynthese (Voice) und OCR. Diese benötigen meist nur einige Hundert MB bis wenige GB Modellspeicher; eine Inferenzinstanz braucht in der Regel etwa 1–4 GB Grafikspeicher.
Das Anfragevolumen schwankt zudem im Tagesverlauf deutlich: Während der Arbeitszeit ist es hoch, nachts meist geringer.
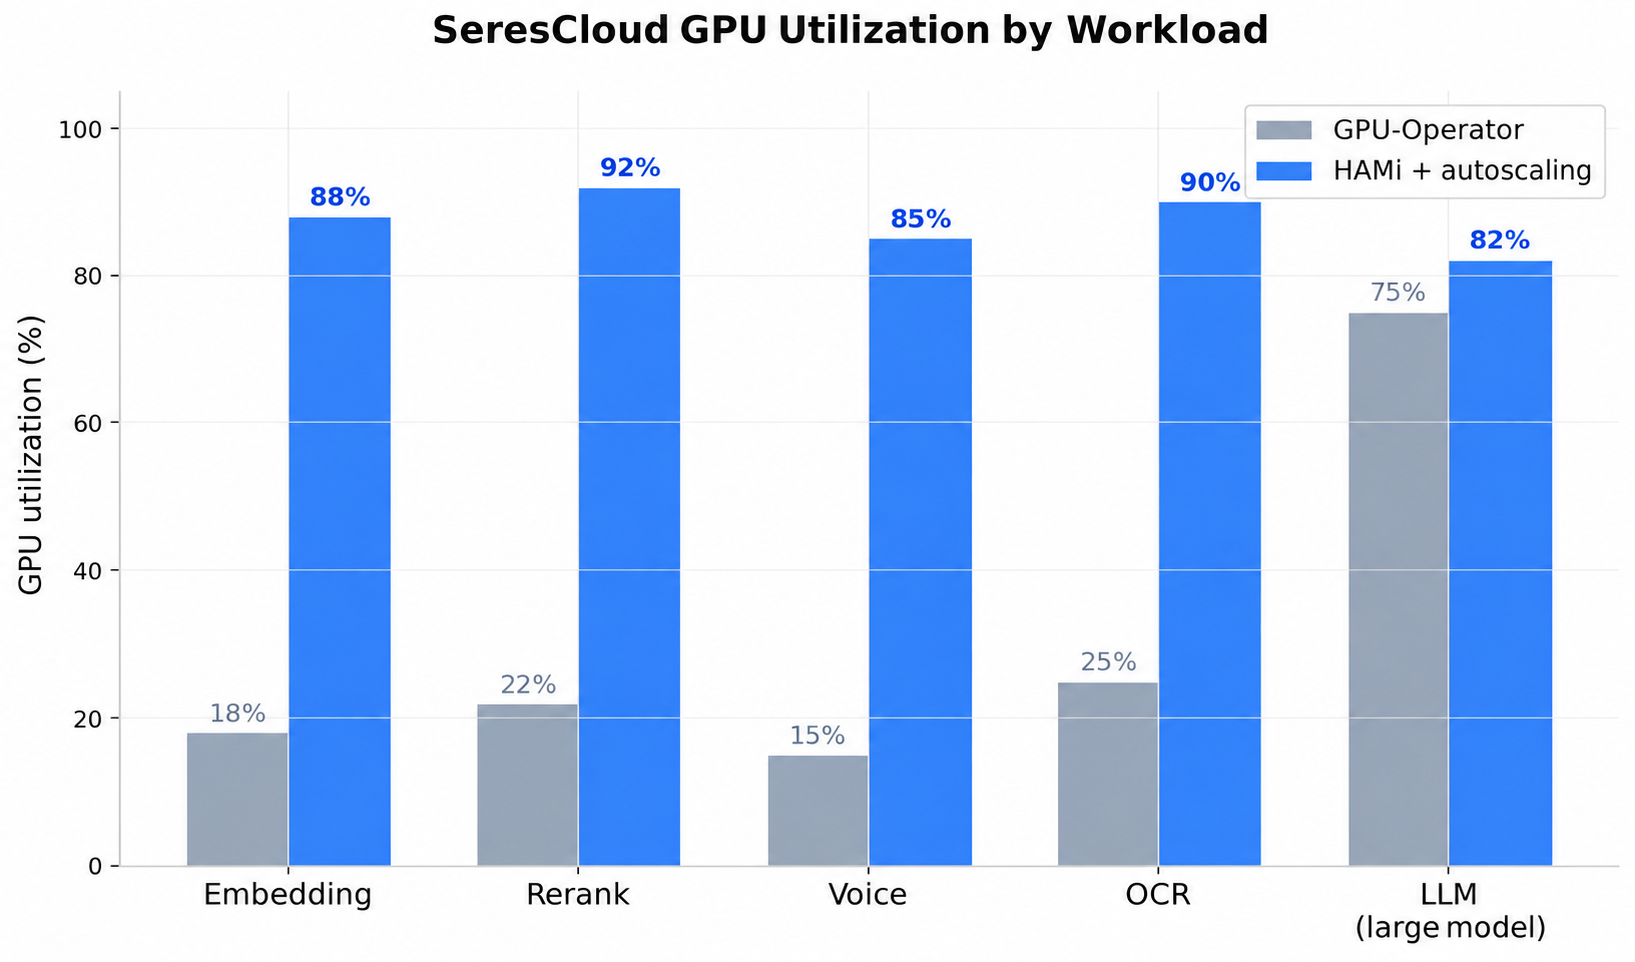
Bei exklusiver Zuweisung belegte ein Pod auch dann eine ganze GPU, wenn er nur wenig Grafikspeicher und Rechenleistung nutzte. Übrige Ressourcen standen anderen Aufgaben nicht zur Verfügung. In solchen kleinen Modell-Workloads lag die GPU-Auslastung dauerhaft bei etwa 15–25 %.
Das Team versuchte Time-Slicing, damit mehrere Pods dieselbe GPU über Zeitscheiben nutzen konnten. Das erhöhte die gemeinsame Nutzung, löste aber das Problem der Ressourcenisolation nicht.
Ein plötzlicher Anstieg der Grafikspeichernutzung eines Pods konnte andere Aufgaben auf derselben Karte beeinträchtigen oder einen OOM-Fehler auslösen. Konkurrierten mehrere anspruchsvolle Aufgaben um Rechenleistung, schwankte die Inferenzlatenz. Für produktive Dienste mit SLA-Anforderungen waren diese Risiken relevant.
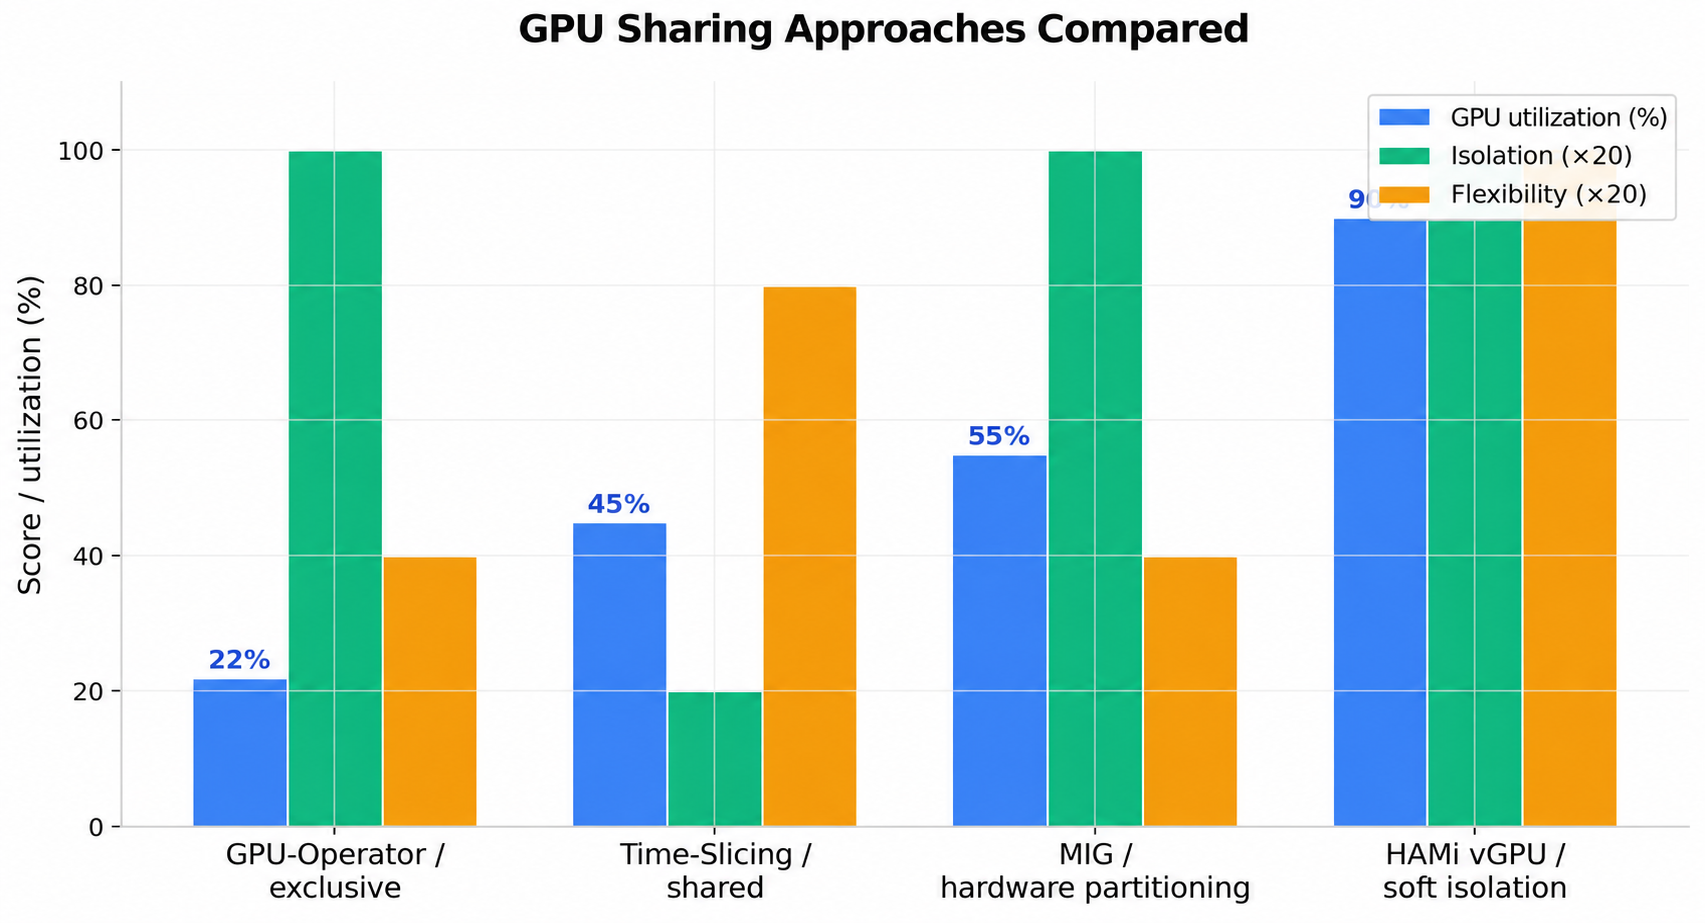
SERES setzte für die betreffenden Workloads deshalb HAMi vGPU Sharing mit Softwareisolation ein.
HAMi fängt CUDA-Aufrufe über libvgpu.so im Container ab und setzt harte Grenzen für Grafikspeicher und Rechenleistung durch. So ermöglicht es eine feinere gemeinsame Nutzung und Verwaltung.
Diese Konfiguration fordert beispielsweise einen vGPU-Anteil an und setzt Grafikspeicher- und Rechenlimits:
resources:
  limits:
    nvidia.com/gpu: 1          # Request 1 vGPU share of a physical GPU
    nvidia.com/gpumem: 3000    # Limit memory to 3000 MiB
    nvidia.com/gpucores: 30    # Limit compute to 30%
Dabei gilt:
nvidia.com/gpu: 1fordert eine gemeinsam genutzte GPU-Ressourceninstanz an, keine exklusive physische Karte.nvidia.com/gpumem: 3000begrenzt den Grafikspeicher dieser Aufgabe auf 3000 MiB.nvidia.com/gpucores: 30begrenzt die nutzbare GPU-Rechenleistung auf 30 %.
SERES kann GPUs damit nach dem tatsächlichen Ressourcenbedarf jedes Modells zuweisen, statt eine ganze Karte als kleinste Einheit zu verwenden.
Parallel dazu skaliert SeresCloud die Dienste: Bei geringer Last sinkt die Zahl der Inferenzinstanzen und Ressourcen werden frei; bei steigenden Anfragen kommen Pod-Replikas hinzu, denen HAMi GPU-Ressourcen zuweist.
In dieser Kombination stieg die GPU-Auslastung kleiner Inferenzmodelle bei SERES von 15–25 % auf etwa 90 %.
Scheduling-Strategien nach Workload wählen
Für eine Inferenzplattform im Unternehmen ist Auslastung nicht das einzige Ziel. Auch Effizienz und Stabilität müssen im Gleichgewicht stehen. HAMi bietet unterschiedliche Scheduling-Strategien für verschiedene Lasten:
- Binpack: Bevorzugt bereits verwendete GPUs, um die Dichte und Auslastung einer Karte zu erhöhen. Geeignet für dicht bereitgestellte kleine Modelle und fragmentierungssensitive Szenarien.
- Spread: Verteilt Pods bevorzugt auf unterschiedliche GPUs. Geeignet für latenzsensitive Inferenz mit hoher Parallelität.
Durch eine passende Strategie je Workload verbesserte SERES die Auslastung und berücksichtigte zugleich die SLA-Anforderungen kritischer Dienste.
Wichtige Produktionskonfiguration
Das folgende Beispiel zeigt einen Teil der zentralen Helm-Konfiguration, die SERES für HAMi in Produktion nutzt:
devicePlugin:
  deviceSplitCount: 10        # Max 10 shared tasks per physical GPU
  deviceMemoryScaling: 1      # Memory based on actual physical VRAM (no oversubscription)
  deviceCoreScaling: 1        # Compute based on actual physical compute
  migStrategy: none           # MIG disabled (handled by HAMi soft slicing)
  disablecorelimit: "false"   # Enable compute limiting

scheduler:
  defaultMem: 5000            # Default memory allocation 5000 MiB
  defaultCores: 0             # No compute reserved by default (dynamically allocated by the scheduler)
Die Einstellungen bedeuten:
deviceSplitCount: 10: Höchstens 10 parallele gemeinsame Aufgaben pro physischer GPU.deviceMemoryScaling: 1: Zuweisung anhand des tatsächlichen physischen Grafikspeichers ohne Überbelegung.deviceCoreScaling: 1: Zuweisung anhand der tatsächlich vorhandenen Rechenleistung.migStrategy: none: MIG ist deaktiviert; die Softwarepartitionierung von HAMi übernimmt das Sharing.disablecorelimit: "false": Compute-Limits sind aktiviert.defaultMem: 5000: Standardmäßig 5000 MiB Grafikspeicher zuweisen.defaultCores: 0: Standardmäßig keine feste Rechenleistung reservieren; der Scheduler weist sie dynamisch zu.
deviceSplitCount=10 ist eine wichtige Grenze für parallele Aufgaben. Der Wert begrenzt, wie viele vGPU-Aufgaben gleichzeitig auf einer GPU laufen, ändert aber weder deren physischen Grafikspeicher noch die gesamte Rechenleistung. Der Scheduler lässt Aufgaben weiterhin nur entsprechend den tatsächlich verfügbaren Ressourcen zu, um einen Laufzeit-OOM durch Überbelegung zu vermeiden.
HAMi prüft bei der Zulassung weiterhin die verbleibenden physischen Ressourcen und vermeidet Laufzeit-OOM durch zu große Zuweisungen.
Erfahrungen aus dem Produktivbetrieb
GPU-Sharing in Produktion erfordert neben der Bereitstellung auch Aufmerksamkeit für Scheduling-Kompatibilität, Fehlersuche, Ressourcenkonfiguration und Überwachung. SERES sammelte bei der Verwendung von HAMi mehrere Erfahrungen.
Webhook-Kompatibilität mit privilegierten Pods
Der Mutating Webhook von HAMi setzt schedulerName für Pods mit vGPU-Anforderung automatisch auf hami-scheduler.
Bei Debugging-Pods mit privileged: true überspringt der Webhook diese Verarbeitung jedoch. Bei der Fehlersuche im Scheduling ist dieses Verhalten zu beachten.
Scheduling-Fehler besser beobachten
Seit HAMi v2.x wurden die Meldungen zu Scheduling-Fehlern deutlich verbessert. Standardisiertere Fehlercodes sind unter anderem:
NodeInsufficientDeviceCardTypeMismatchCardInsufficientMemory
SERES empfiehlt, HAMi-Metriken mit Prometheus/Grafana zu verbinden, um Probleme beim GPU-Scheduling schneller zu lokalisieren.
deviceSplitCount angemessen einstellen
Mehr gleichzeitig laufende Aufgaben sind nicht immer besser. Zu viele Aufgaben auf einer GPU können Ressourcenkonflikte, Kontextwechsel und betrieblichen Aufwand erhöhen.
Nach Belastungstests wählte SERES für seine Inferenzlasten deviceSplitCount=10 als Ausgleich zwischen Bereitstellungsdichte und Stabilität.
Der Wert gilt für die aktuellen Workloads von SERES und ist keine allgemeine Empfehlung. Andere Inferenzaufgaben müssen entsprechend Modellgröße, Parallelität und Latenzanforderungen getestet werden.
Zusammenspiel mit eigener automatischer Skalierung
HAMi regelt, wie GPU-Ressourcen zugewiesen werden. Die Geschäftsplattform entscheidet weiterhin, wann Inferenzdienste hoch- oder herunterskalieren sollen.
SERES verbindet HAMis vgpu_monitor-Metriken mit QPS, Inferenzlatenz und weiteren SeresCloud-Metriken als Grundlage für die automatische Skalierung.
Entscheidend ist ein einheitliches Monitoring-System, das Geschäfts- und Ressourcendaten verknüpft. GPU-Verwaltung kann sich so an wechselnde Inferenzlasten anpassen, statt nur statische Kapazitäten zu verteilen.
Nächste Schritte
Mit der Weiterentwicklung seiner KI-Infrastruktur möchte SERES HAMi über die bisherige Umsetzung hinaus einsetzen.
Heterogenen Ressourcenpool ausbauen
Wenn das Ökosystem heterogener KI-Beschleuniger weiter reift, will SERES Huawei Ascend, Hygon DCU und andere Geräte in HAMis einheitliches Scheduling aufnehmen und einen heterogenen Compute-Pool aufbauen.
HAMi-DRA-Integration
SERES verfolgt die Arbeit der HAMi-Community am Kubernetes-DRA-Standard (Dynamic Resource Allocation) und möchte künftig die native DRA-Schnittstelle für flexiblere GPU-Zuweisung nutzen.
Scheduling feiner abstimmen
Das Team will fortgeschrittene Funktionen wie prioritätsbasierte Ressourcenverdrängung und topologiebewusstes GPU-Scheduling prüfen, um die Auslastung bei großen Inferenzmodellen zu verbessern.
Weiter an die Open-Source-Community zurückgeben
SERES wird Probleme und Verbesserungsvorschläge aus dem Produktivbetrieb weiterhin an die HAMi-Community weitergeben und mit ihren Entwicklern am Projekt arbeiten.
Ergebnis: Rund 90 % GPU-Auslastung
Durch das Zusammenspiel von Kubernetes, HAMi und seiner eigenen Inferenzplattform unterstützte SERES das schnelle Wachstum des KI-Geschäfts und verbesserte zugleich die GPU-Effizienz deutlich:
- Das tägliche Token-Volumen wuchs von 300 Millionen auf über 10 Milliarden, ein Plus von mehr als 3.000 %.
- Die GPU-Auslastung kleiner Inferenzmodelle stieg von 15–25 % auf etwa 90 %.
Für SERES liegt der Wert von HAMi nicht allein darin, mehr Aufgaben auf einer GPU auszuführen. Ressourcen können entsprechend dem tatsächlichen Bedarf jedes Modells zugewiesen werden. Das verringert Verschwendung durch exklusive Ganzkartenbelegung und unterstützt stabile Inferenzdienste.
Die Erfahrung kann anderen Unternehmen als Orientierung dienen, die KI-Inferenzplattformen auf Kubernetes aufbauen. Wenn Modellzahl, Anfragen und GPU-Typen zunehmen, sind fein abgestufte gemeinsame Nutzung und mehrschichtige Ressourcenverwaltung technische Ansätze, die geprüft werden sollten.