

Wie teilen sich Dutzende Cloud-Gaming-Spieler eine Grafikkarte?
 Engineering
HAMi erweitert die GPU-Ressourcenverwaltung von CUDA auf Vulkan-Rendering. So können Cloud-Gaming-, Fahrsimulations- und andere Anwendungen GPUs in Kubernetes gemeinsam nutzen und voneinander isolieren. In einem CARLA-Belastungstest blieb der Leistungsunterschied mit aktivierter Isolation unter 2 %.
Auf dieser Seite
Einleitung
Seit seiner Veröffentlichung im Jahr 2020 läuft das von miHoYo entwickelte Open-World-Abenteuerspiel Genshin Impact nun seit sechs Jahren. Im Juli dieses Jahres wurden die Geräteanforderungen für Version 7.0 bekannt gegeben. Die neue Version verbessert die Darstellung der Figuren und die Materialien der Spielwelt weiter. Für ein Open-World-Spiel mit vielen Spielern weltweit bleibt es eine wichtige technische Herausforderung, die Bildqualität zu erhöhen und zugleich die Leistung auf verschiedenen Geräten zu gewährleisten.
Beim Grafik-Rendering ist Vulkan dank der feineren Kontrolle über GPU-Ressourcen zu einer technischen Option für die Leistungsoptimierung von Genshin Impact geworden. Während der Gamescom 2025 stellte miHoYo auf einem von Samsung veranstalteten Forum für Spieltechnologie Ergebnisse zum Einsatz von Vulkan vor: In dem gezeigten Testszenario mit hoher Frame-Last stieg die Bildrate (FPS) mit Vulkan um 17,1 %.
Wenn Rendering-Aufgaben vom lokalen Gerät in die Cloud wandern, geht es jedoch um mehr als die Leistung einer einzelnen Anwendung. Hinzu kommen die Zuweisung und gemeinsame Nutzung von GPU-Ressourcen durch mehrere Aufgaben: Wie viele Sitzungen kann eine GPU gleichzeitig tragen? Wie lassen sich Grafikspeicher zuweisen und die Ressourcennutzung begrenzen, ohne dass sich Aufgaben gegenseitig stören?
Das hängt sowohl von der Rechenleistung der GPU als auch von einem wirksamen Mechanismus zur gemeinsamen Nutzung und Isolation der Ressourcen ab.
HAMi ist ein Open-Source-Projekt, das vom Gründerteam von Dynamia initiiert wurde und dauerhaft betreut wird. Es verwaltet heterogene KI-Rechengeräte in Kubernetes-Clustern und unterstützt bereits die Ressourcenzuweisung, Nutzungsbegrenzung und Überwachung für CUDA-Rechenaufgaben. Die neue Vulkan-Rendering-Isolation erweitert diese Verwaltung auf Grafik-Rendering. Damit können CUDA-Rechenaufgaben und Vulkan-Rendering denselben Mechanismen für Zuweisung, Begrenzung und Beobachtung folgen.
Warum GPU-Ressourcenverwaltung nicht nur CUDA berücksichtigen darf
Sowohl CUDA als auch Vulkan ermöglichen Anwendungen den Zugriff auf GPUs, haben aber unterschiedliche Aufgaben und Einsatzgebiete.
CUDA ist eine Plattform und ein Programmiermodell für parallele Berechnungen, vor allem für allgemeine Rechenaufgaben. Sie wird häufig für rechenintensive Aufgaben wie KI-Training und Inferenz eingesetzt. Vulkan ist eine plattformübergreifende Grafik- und Compute-API, mit der Anwendungen auf einer niedrigeren Ebene auf GPUs zugreifen können. Sie kommt häufiger in grafikintensiven Bereichen wie Spiele-Rendering, Simulation des autonomen Fahrens und digitalen Zwillingen zum Einsatz.
Beide nutzen GPU-Ressourcen, aber über unterschiedliche Laufzeitschnittstellen und Aufrufpfade. Eine Verwaltung, die sich auf CUDA beschränkt, deckt daher nicht alle GPU-Workloads ab.
Für eine GPU-Verwaltungsplattform in einem Kubernetes-Cluster ergibt sich daraus ein praktisches Problem: Wenn Ressourcenlimits und Nutzungsüberwachung nur für den CUDA-Aufrufpfad gelten, können Aufgaben, die über Vulkan auf die GPU zugreifen, nicht unmittelbar mit demselben Mechanismus verwaltet werden.
Angenommen, eine GPU führt zugleich KI-Inferenz und das Rendering einer dreidimensionalen Szene aus. Begrenzt die Plattform nur die CUDA-Rechenlast, kann sie mit diesem Mechanismus den Ressourcenverbrauch der Vulkan-Rendering-Aufgabe kaum genau verwalten. Auch die Konkurrenz zwischen den Aufgaben lässt sich schwerer einheitlich beurteilen.
Damit weitere Arten von GPU-Workloads dieselbe Infrastruktur gemeinsam nutzen können, muss die Ressourcenverwaltung deshalb von CUDA auf andere Laufzeitschnittstellen wie Vulkan ausgeweitet werden.
Die neue Vulkan-Rendering-Isolation von HAMi ist eine solche Erweiterung der bestehenden GPU-Ressourcenverwaltung.
Vulkan in die einheitliche Ressourcenverwaltung einbinden
In Kubernetes umfasst die GPU-Ressourcenverwaltung von HAMi im Wesentlichen drei Schritte:
- Scheduling und Zuweisung: Eine geeignete GPU für die Aufgabe auswählen und die verfügbaren Ressourcen festlegen.
- Isolation und Begrenzung: Die GPU-Nutzung anhand der Zuweisung beschränken und das Risiko von Ressourcenkonflikten bei gemeinsamer Nutzung verringern.
- Überwachung und Beobachtung: Die Ressourcennutzung während der Ausführung fortlaufend erfassen, um Verwaltung und Betriebsanalyse zu unterstützen.
Für CUDA-Rechenaufgaben verfügt HAMi bereits über entsprechende Laufzeitmechanismen zur Ressourcenkontrolle. Um Vulkan-Workloads ähnlich zu verwalten, muss es zunächst an deren GPU-Aufrufpfad anknüpfen.
Anwendungen über eine implizite Vulkan-Layer anbinden
Die Vulkan-Rendering-Isolation von HAMi nutzt den von Vulkan offiziell unterstützten Mechanismus der impliziten Layer (Implicit Layer).
Eine Vulkan-Layer ist ein Erweiterungsmechanismus, der zwischen Anwendung und zugrunde liegendem Vulkan-Treiber in den Ablauf von API-Aufrufen eingreifen kann. Anders als eine Layer, die eine Anwendung ausdrücklich aktivieren muss, kann der Vulkan Loader eine implizite Layer anhand der Laufzeitkonfiguration automatisch laden.
So kann HAMi während der Vulkan-Nutzung die Ressourcenverwaltung einbinden, ohne dass Entwickler ihre Anwendung eigens für HAMi ändern müssen. Bei bestehenden Vulkan-Anwendungen, die die Anforderungen an Laufzeitumgebung und Komponentenkonfiguration erfüllen, reichen Bereitstellung und Konfiguration der entsprechenden Komponenten aus, um Ressourcenisolation mit weniger Änderungen an der Anwendung einzuführen.
Einen gemeinsamen Mechanismus zur Ressourcenverwaltung nutzen
CUDA und Vulkan werden über unterschiedliche Pfade angebunden. Das Ziel der Ressourcenverwaltung bleibt jedoch gleich: HAMi verwendet für CUDA die bestehenden Kontrollen und bindet Rendering-Aufgaben auf dem Vulkan-Pfad über eine implizite Layer ein.
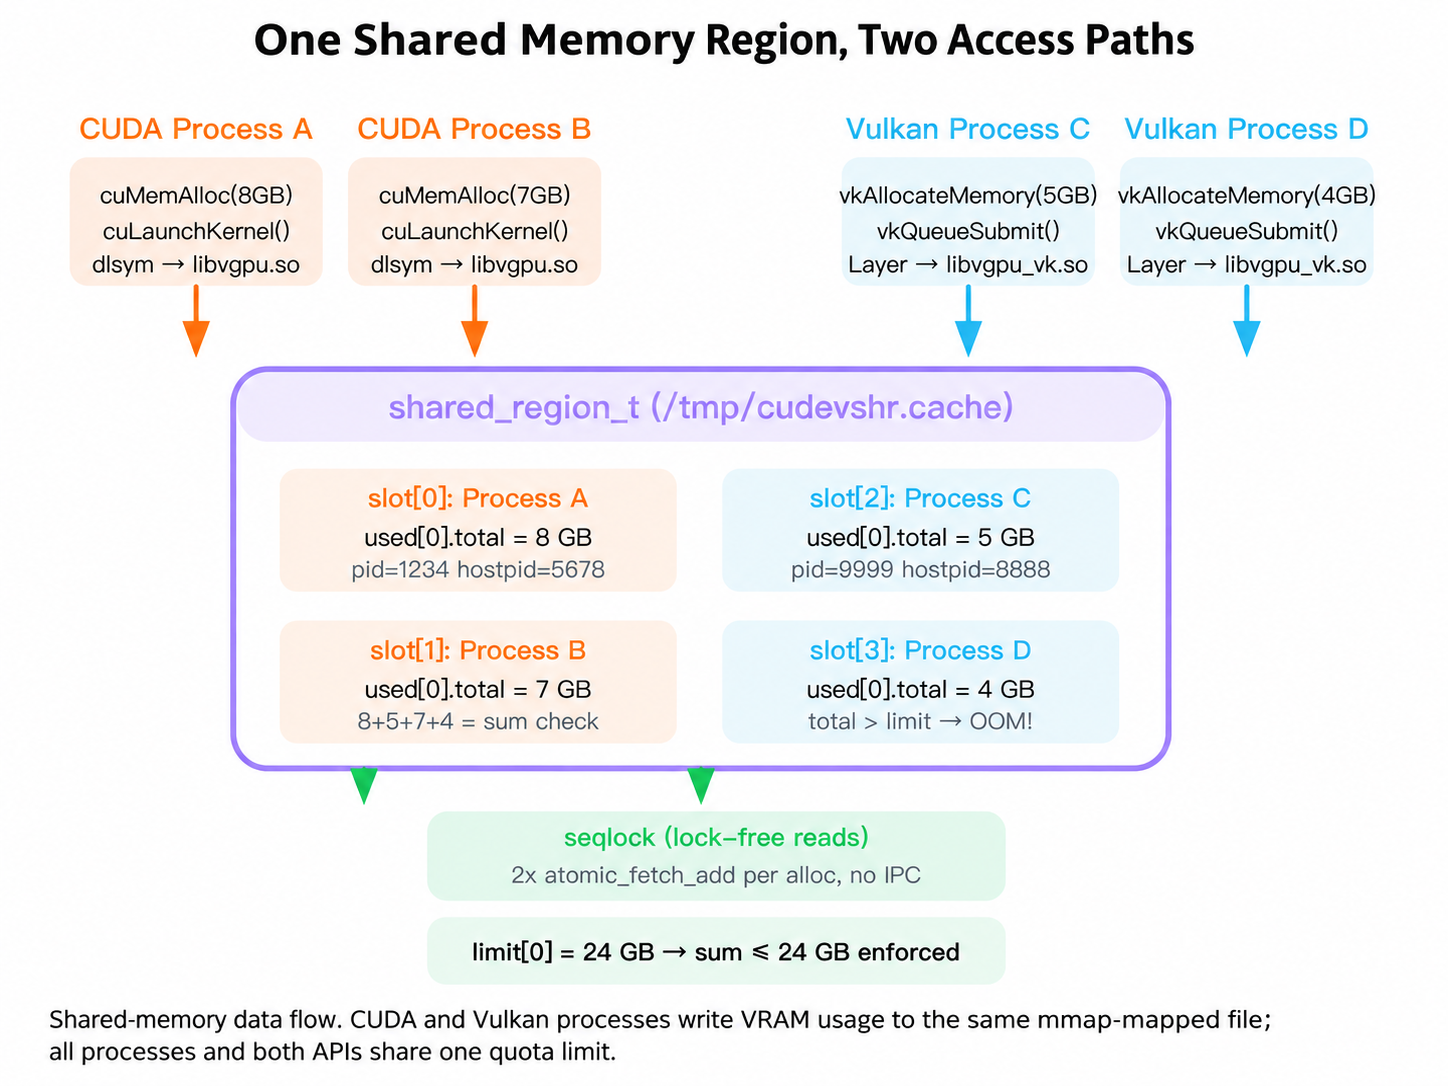
Die beiden Pfade verarbeiten unterschiedliche Arten von GPU-Aufrufen. Beide müssen jedoch einer konsistenten Ressourcenzuweisung folgen und in dasselbe System für Limits und Nutzungsbeobachtung eingebunden sein. So kann die Plattform Rechen- und Rendering-Lasten einheitlich verwalten, ohne für jede Schnittstelle eine vollständig getrennte Ressourcenverwaltung aufzubauen.
In Umgebungen mit CUDA- und Vulkan-Workloads synchronisiert HAMi außerdem den nötigen Ressourcenstatus, damit die Aufgaben ihre gemeinsame GPU koordiniert nutzen.
Im Einzelnen bietet Vulkan-Rendering-Isolation folgende Möglichkeiten:
- Klare Ressourcengrenzen: Rendering-Aufgaben Ressourcen zuweisen und ihre Nutzung begrenzen.
- Gemeinsame Nutzung durch mehrere Aufgaben: Das Risiko verringern, dass eine Aufgabe zu viele GPU-Ressourcen belegt und andere beeinträchtigt.
- Einheitliche Beobachtung: Rechen- und Rendering-Aufgaben in derselben Verwaltungssicht erfassen und die tatsächliche GPU-Nutzung nachvollziehen.
- Spielraum für bessere Auslastung: Eine Grundlage schaffen, damit mehr Workloads dieselbe GPU nutzen können.
Ressourcenisolation bedeutet allerdings nicht, dass Aufgaben einander in ihrer Leistung überhaupt nicht beeinflussen können. GPU-Hardware, Parallelitätsgrad und Lastprofil bestimmen weiterhin, wie gut die gemeinsame Nutzung funktioniert. Neben der Funktionalität müssen daher auch Stabilität und Leistungsaufwand des Isolationsmechanismus im Betrieb geprüft werden.
Einsatzszenarien für Vulkan-Rendering-Isolation
In der Praxis ist Vulkan-Rendering-Isolation besonders dort hilfreich, wo mehrere GPU-Workloads dieselbe Hardware nutzen sollen.
Cloud Gaming
Beim Cloud Gaming muss jede Spielersitzung fortlaufend Szenen rendern und verbraucht dafür GPU-Ressourcen. Wenn jede Sitzung eine GPU exklusiv belegt, können die Hardwareeffizienz und die Betriebskosten zu begrenzenden Faktoren werden.
Mit Vulkan-Rendering-Isolation kann die Plattform Ressourcenbereiche für einzelne Sitzungen festlegen, sodass mehrere Rendering-Aufgaben unter kontrollierten Bedingungen dieselbe GPU nutzen. Das schafft eine Grundlage für mehr parallele Sitzungen pro Karte und eine bessere Auslastung. Wie viele Sitzungen eine GPU tatsächlich tragen kann, muss anhand der Spiellast, der Anforderungen an die Bildrate und der realen Leistung bei gleichzeitiger Ausführung ermittelt werden.
Simulation des autonomen Fahrens
Die Entwicklung autonomer Fahrzeuge erfordert viele Simulationstests, um das Verhalten bei unterschiedlichen Straßen, Verkehrssituationen, Licht- und Wetterverhältnissen zu prüfen. Laufen mehrere Simulationen gleichzeitig, belegt das Rendering der dreidimensionalen Umgebungen dauerhaft GPU-Ressourcen; zwischen den Aufgaben kann Ressourcenkonkurrenz entstehen.
Eine feinere Zuweisung und Begrenzung für einzelne Simulationen kann den Einfluss einer Aufgabe auf die Ressourcen anderer verringern und die vorhandenen GPUs sinnvoller auf mehrere Tests verteilen. Sofern die Leistungsanforderungen der Simulation erfüllt werden, können mehr Aufgaben die vorhandenen GPUs gemeinsam nutzen und die Kapazität für parallele Tests sowie der Gesamtdurchsatz steigen.
Digitale Zwillinge und Cloud-Workstations
GPU-Workloads für digitale Zwillinge und Cloud-Workstations sind häufig vielfältiger. Dieselbe Infrastruktur muss möglicherweise Daten verarbeiten und Modelle ausführen, gleichzeitig aber auch Anwendungen für dreidimensionales Rendering in Echtzeit betreiben.
Wenn Berechnung und Rendering über CUDA beziehungsweise Vulkan auf die GPU zugreifen, bleibt die Ressourcenverwaltung einer Plattform unvollständig, die nur eine der beiden Schnittstellen abdeckt. Mit der Vulkan-Rendering-Isolation von HAMi können beide Workload-Arten nach einem einheitlicheren Verfahren verwaltet werden. Das erleichtert die zentrale Zuweisung, Begrenzung und Überwachung.
Cloud Gaming, Simulation des autonomen Fahrens und digitale Zwillinge unterscheiden sich fachlich, stehen aber vor einem ähnlichen Problem: Eine GPU-Infrastruktur muss mehrere Aufgaben mit unterschiedlichen Ressourcenanforderungen tragen.
Wo KI-Berechnungen und Echtzeitgrafik zusammenkommen – etwa wenn eine Anwendung Wahrnehmungsinferenz ausführt und gleichzeitig eine dreidimensionale Simulation aktualisiert –, hilft die gemeinsame Verwaltung von CUDA und Vulkan dabei, die GPU-Nutzung vollständiger zu erfassen und Lücken in der Workload-Verwaltung zu verringern.
CARLA-Test: Leistung der Vulkan-Isolation
Im Produktivbetrieb muss Ressourcenisolation die Nutzung kontrollierbar machen und zugleich ihren Einfluss auf die Anwendungsleistung möglichst gering halten. Das ist für Echtzeit-Rendering besonders wichtig. Cloud Gaming und Fahrsimulationen laufen oft lange und ohne Unterbrechung; entsprechend hoch sind die Anforderungen an Leistung und Stabilität.
Für die Leistungsprüfung der Vulkan-Rendering-Isolation nutzte das Team die Plattform CARLA für autonome Fahrsimulation als Testlast und führte auf einer NVIDIA GeForce RTX 4090 einen zweistündigen Dauertest unter Last durch.
CARLA kann fortlaufend komplexe dreidimensionale Szenen mit Straßen, Fahrzeugen, Licht und wechselndem Wetter erzeugen. Dadurch eignet sich die Plattform, um die Rendering-Leistung über längere Zeit zu beobachten.
Im Test wurde die Leistung in zwei Betriebszuständen erfasst:
- Ohne HAMi-Vulkan-Isolation: Als Leistungsreferenz.
- Mit HAMi-Vulkan-Isolation: Zur Beobachtung nach Einführung der Ressourcenisolation.
Ergebnisse
In dieser RTX-4090-Testumgebung und bei der festgelegten Last blieb der Gesamtleistungsunterschied zwischen den Läufen mit und ohne HAMi-Vulkan-Isolation unter 2 %. Beide liefen zwei Stunden lang stabil.
Unter diesen Testbedingungen zeigt das Ergebnis, dass der Vulkan-Isolationsmechanismus dauerhaft laufen kann und die Rendering-Leistung vergleichsweise wenig beeinflusst.
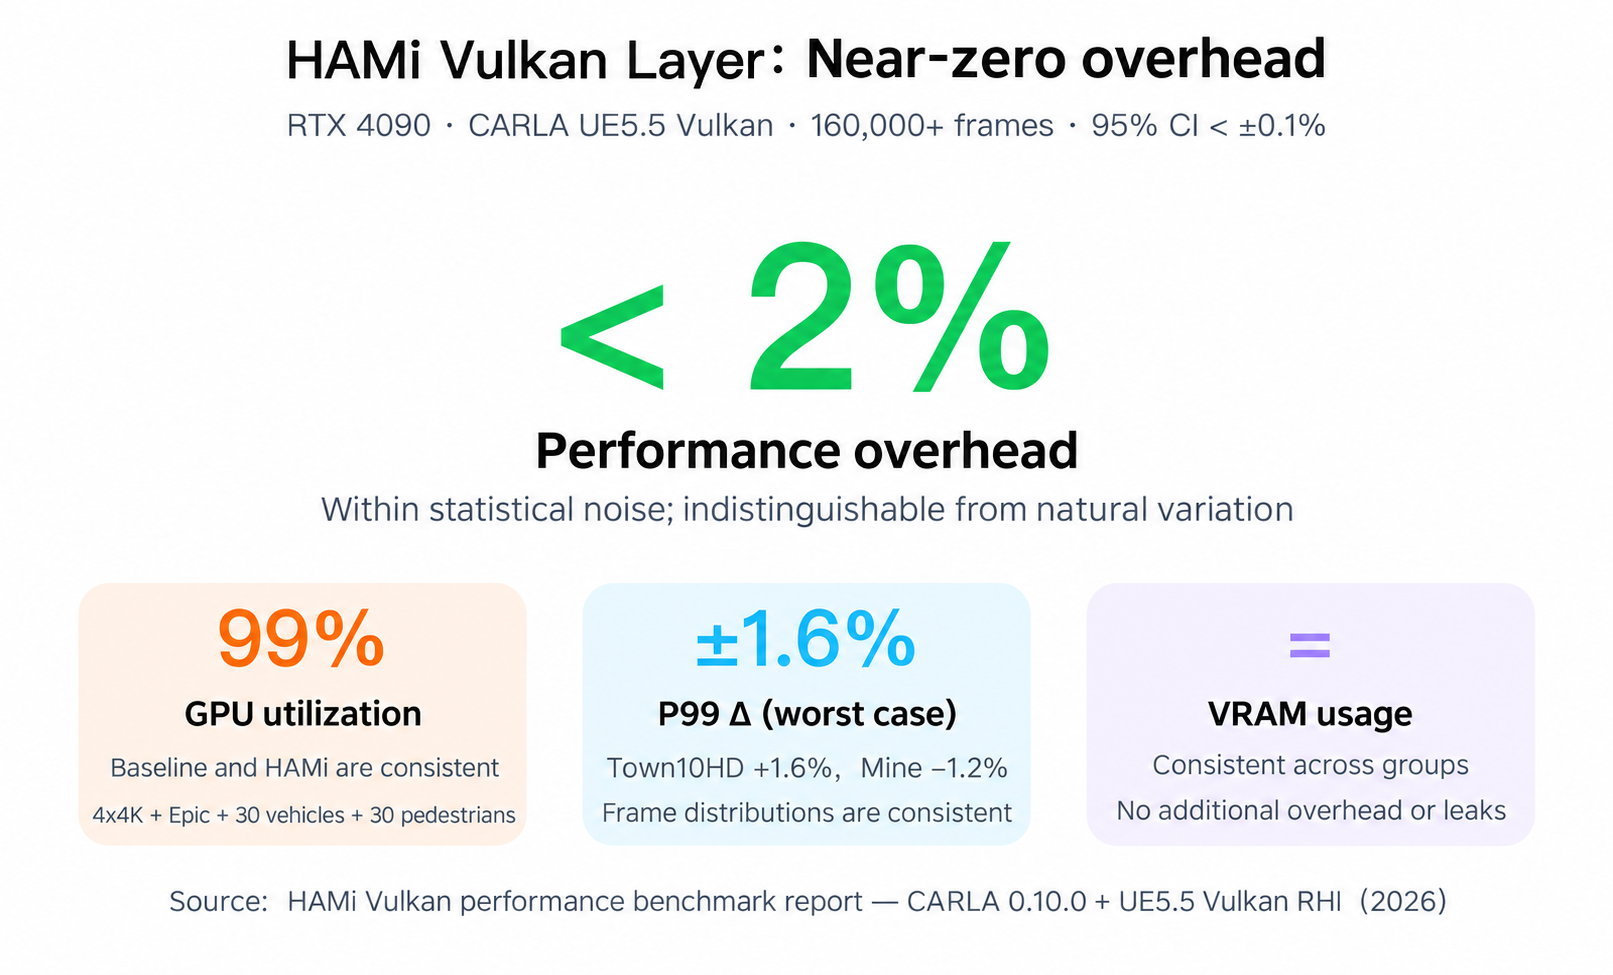
Das Ergebnis muss dennoch im jeweiligen Kontext betrachtet werden. GPU-Modell, Treiberversion, Zahl gleichzeitig laufender Aufgaben und tatsächliche Rendering-Last können die Leistung des Isolationsmechanismus beeinflussen. Unternehmen, die Vulkan-Isolation produktiv einsetzen möchten, sollten deshalb mit einem PoC eine Leistungsreferenz für ihre eigenen Workloads ermitteln und Zielparallelität, Ressourcenkonfiguration sowie langfristigen Betrieb bewerten.
So lässt sich die Funktion ausprobieren
Für bestehende Vulkan-Anwendungen, die die Anforderungen an die Laufzeitumgebung erfüllen, erfordert die HAMi-Rendering-Isolation keine besondere Änderung am Anwendungscode.
Nachdem die Umgebung gemäß der Projektdokumentation vorbereitet und die erforderlichen Komponenten installiert und konfiguriert wurden, können Vulkan-Workloads in Containern ausgeführt und ihre GPU-Ressourcen beobachtet werden.
Produktivbereitstellung
Wer die Funktion produktiv einsetzen möchte, sollte zusätzlich auf folgende Punkte achten:
- GPU- und Treiberkompatibilität: Prüfen, ob Zielhardware, Treiber und Vulkan-Laufzeit die Anforderungen der Komponenten erfüllen.
- Ressourcenplanung im Cluster: Die GPU-Zuweisung für die tatsächlichen Workloads konfigurieren und gemischte Lasten sowie parallele Aufgaben bewerten.
- Überwachung und Warnmeldungen: Die GPU-Nutzung in das bestehende Monitoring aufnehmen und nötige Zustandsprüfungen und Warnungen einrichten.
- Leistungsreferenz: Die Leistung vor und nach Aktivierung der Isolation vergleichen, um Auslastung und Aufwand für die eigene Anwendung zu beurteilen.
- Upgrades und Wartung: Komponentenversionen, Änderungen der Laufzeitumgebung und bestehende Betriebsanforderungen des Clusters berücksichtigen.
Diese Punkte entscheiden darüber, ob der Isolationsmechanismus zur vorhandenen Infrastruktur eines Unternehmens passt und auch im Dauerbetrieb den Geschäftsanforderungen genügt. Als federführendes Team des HAMi-Projekts arbeitet Dynamia weiterhin an dessen Kerntechnologie und unterstützt Unternehmen bei Lösungsbewertung, PoC-Validierung, Produktivbereitstellung, Leistungsoptimierung und langfristigem technischen Support, damit sie diese Funktionen in ihren Anwendungen einsetzen können.
Fazit
Von CUDA-Berechnungen bis zum Vulkan-Rendering besteht bei unterschiedlichen Laufzeitschnittstellen derselbe Bedarf, GPU-Ressourcen gemeinsam zu nutzen, zu isolieren und zu beobachten.
Die Vulkan-Rendering-Isolation von HAMi bindet Vulkan-Anwendungen über eine implizite Layer an und integriert Grafik-Rendering in die bestehenden Mechanismen für Ressourcenzuweisung, Begrenzung und Beobachtung. Damit erweitert sie den Anwendungsbereich der GPU-Ressourcenverwaltung.
HAMi Vulkan-Rendering-Isolation wurde in hami-enterprise-v2.11.0 offiziell veröffentlicht.
Wenn Ihr Unternehmen mit geringer GPU-Auslastung, Ressourcenkonkurrenz zwischen Aufgaben oder Schwierigkeiten bei der Verwaltung von Rendering-Lasten zu tun hat, sprechen Sie mit Dynamia über den Einsatz der HAMi-Vulkan-Rendering-Isolation in Ihrer Umgebung.