

Warum GPUs zur Grundlage der KI wurden: Ein GPU Einstieg für K8s Veteranen
 Engineering
Ein GPU Einstieg für Kubernetes Entwickler zu parallelen Berechnungen, Tensor Cores, HBM, Transformern und KV Cache sowie den unterschiedlichen Anforderungen von Training und Inferenz. Weitere Themen sind Systeme mit mehreren GPUs, Cluster Scheduling und Ressourcenverwaltung.
Auf dieser Seite
Dieser GPU Einstieg für Kubernetes Entwickler folgt Ameen Alams dreiteiliger Reihe über GPU Architektur und bezieht sich außerdem auf Material von TrendForce, NVIDIA (Slinky/Slurm und GPUDirect Datenpfade), Mirantis und anderen über GPU Infrastruktur und Agentic AI.
Wenn du K8s kennst, aber noch nicht mit GPUs gearbeitet oder Modelle trainiert und für Inferenz bereitgestellt hast, soll dieser Artikel eine Grundlage schaffen.
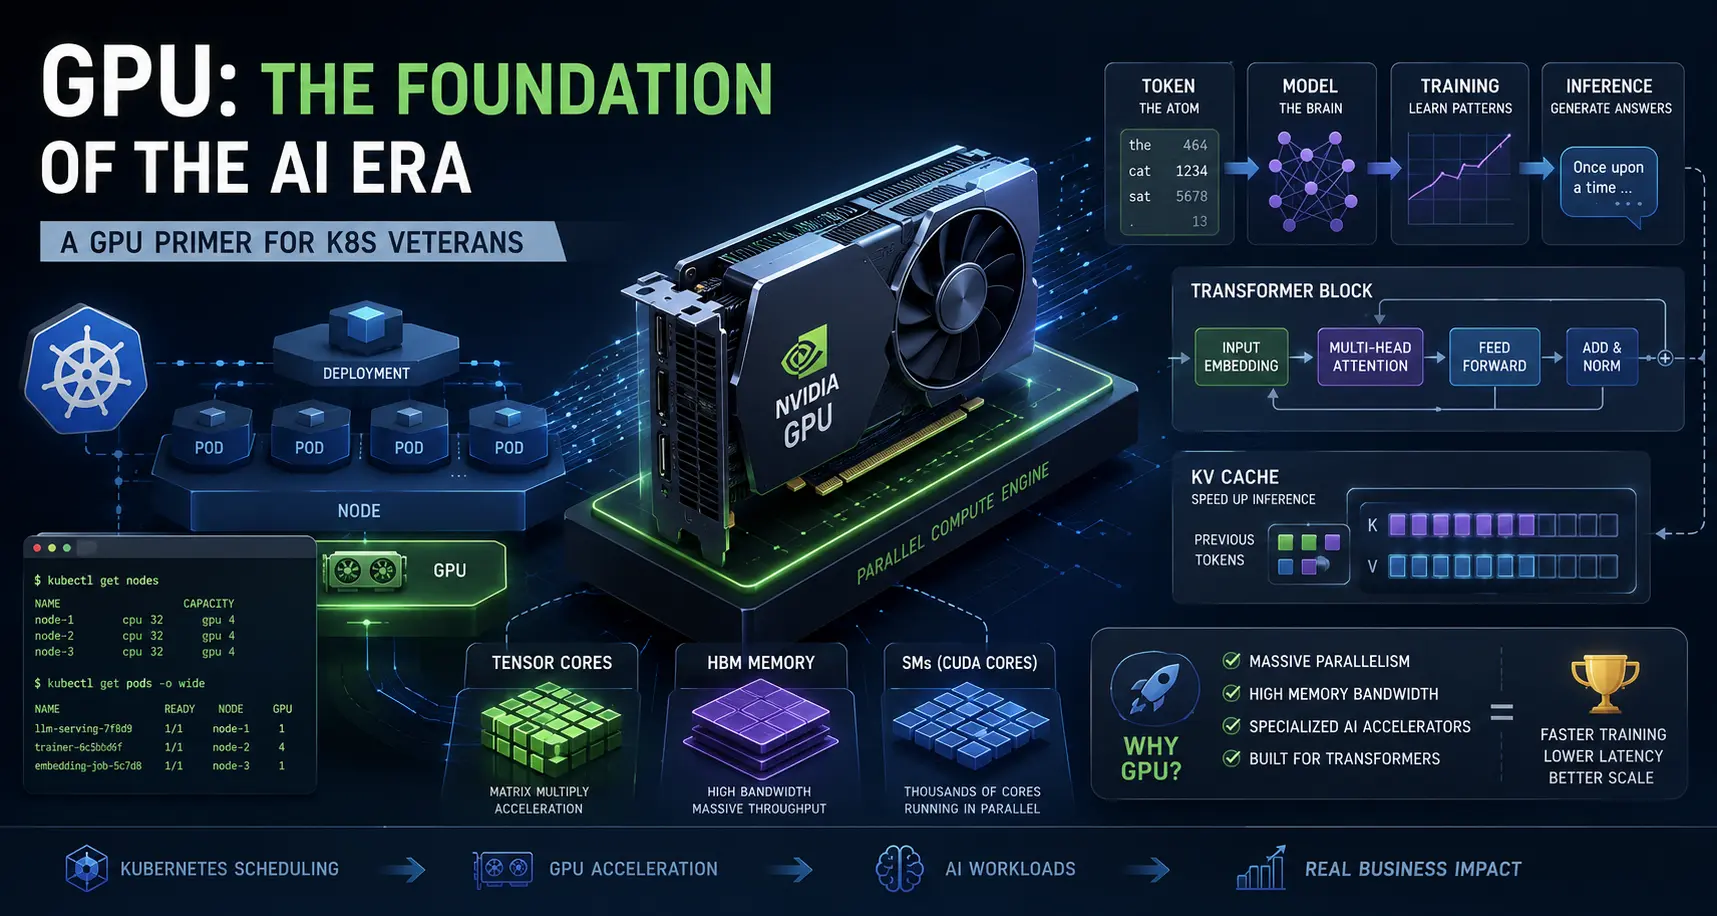
Vorbemerkung
In den vergangenen zehn Jahren habe ich vor allem mit Containern und Kubernetes gearbeitet. Vom Service Mesh bis zum gesamten Cloud Native Ökosystem beschäftigte ich mich täglich mit Scheduling, Netzwerk, Speicher und Observability, jedoch meist auf der CPU Seite. Im vergangenen Jahr wechselte ich in die KI Infrastruktur.
Erst dort wurde mir klar, wie viele neue Begriffe ich verstehen musste: Token, Transformer, Tensor Core, HBM und KV Cache. Viele technische Texte setzen diese Kenntnisse voraus. Wer noch kein Modell trainiert oder einen Inferenzdienst bereitgestellt hat, hat es entsprechend schwer.
Mir half schließlich eine Lernmethode: von vertrauten Cloud Native Konzepten ausgehen und damit verwandte Ideen in der KI Infrastruktur verstehen.
Kubernetes Entwickler kennen Scheduling, Jobs, Deployments, Controller, Caches, Auslastung und Mandantenfähigkeit. Auch Mikroservices, Service Meshes, verteilte Systeme, ereignisgesteuerte Systeme und hochverfügbare Architekturen bieten hilfreiche Analogien.
Mit diesen Verbindungen wurden viele zuvor unbekannte Technologien verständlicher. Ich möchte diesen Lernweg für Menschen mit ähnlichem Hintergrund festhalten.
Im ersten Artikel der Reihe geht es um eine grundlegende Frage: Warum wird für KI Berechnungen so häufig eine GPU eingesetzt?
Später folgen GPU Ressourcenverwaltung, Scheduling und Observability, also Themen, die K8s Entwicklern vertrauter sind.
Wenn du einen Satz eingibst und die KI Wort für Wort antwortet, liegt für K8s Nutzer eine Analogie nahe: Die KI ist ein „Workload“ auf einer GPU, und die GPU ist ein spezialisierter „Node“.
Fachbegriffe in K8s Sprache
Die KI Infrastruktur verwendet viele Fachbegriffe. Ohne Erfahrung mit Training oder Inferenz sind sie nicht immer leicht zu verstehen. Diese Tabelle stellt die Begriffe vor, die später genauer erklärt werden.
| KI Begriff | Einfach erklärt | Analogie für K8s Entwickler |
|---|---|---|
| Token | Kleinste Texteinheit, die ein Modell verarbeitet; ein Zeichen, ein Wort oder Wortteil | Ein kleiner Textabschnitt in einem Log als Grundeinheit der Information |
| Modell | Durch Training entstandene Parameter und Rechenstruktur, die Eingaben verarbeitet und Ergebnisse erzeugt | Eine Anwendung samt benötigter Daten, die nach der Bereitstellung einen Dienst anbietet |
| Training | Wiederholte Berechnungen mit großen Datenmengen, um Parameter anzupassen und eine Aufgabe zu lernen | Ein lang laufender Job, der ein einsetzbares Modell erzeugt |
| Inferenz | Ein trainiertes Modell verarbeitet Anfragen und erzeugt Vorhersagen oder Antworten | Ein mit Deployment bereitgestellter Onlinedienst |
| Transformer | Auf Attention basierende neuronale Netzarchitektur, Grundlage vieler großer Sprachmodelle | Eine Controller Schleife veranschaulicht schrittweise Generierung, obwohl die Mechanismen verschieden sind |
| Tensor Core | GPU Recheneinheit zur Beschleunigung von Matrix Multiplikation und Addition | Ein Worker, der für eine bestimmte Aufgabe optimiert ist |
| HBM | Speicher mit hoher Bandbreite für Modellgewichte, KV Cache und weitere GPU Daten | Lokaler Speicher eines Nodes, aber mit höherer Bandbreite |
| KV Cache | Gespeicherte Keys und Values früherer Token, die wiederholte Berechnungen vermeiden | Lokal gehaltener Sitzungszustand, der mit dem Kontext wächst |
Mit diesen Grundlagen können wir untersuchen, weshalb sich GPUs für KI Berechnungen eignen.
Eine oft übergangene Frage
GPUs werden häufig für KI Training und Inferenz eingesetzt. Wir diskutieren, welche GPU wir mieten, welches Framework wir nutzen und welches Modell wir bereitstellen. Eine einfachere Frage bleibt oft offen: Warum eine GPU statt einer vielseitigeren CPU? Warum wurde ein ursprünglich vor allem für Grafik entwickelter Prozessor zur zentralen KI Hardware?
Die Antwort liegt in den Architekturunterschieden zwischen CPU und GPU und in den Berechnungsmustern neuronaler Netze.
CPU vs. GPU
CPUs sind uns vertraut. Die K8s Steuerungsebene, etcd und Scheduler laufen auf ihnen. Eine CPU verarbeitet komplexe Befehle und Steuerlogik gut. Sie hat vergleichsweise wenige, dafür leistungsfähige Kerne und ist auf die Effizienz und geringe Latenz einzelner Aufgaben ausgerichtet.
Man kann sie sich als erfahrenen Handwerker vorstellen, der komplexe, präzise Arbeiten selbstständig ausführt.
Eine GPU ist anders aufgebaut: Viele Rechenkerne führen ähnliche Operationen parallel auf großen Datenmengen aus. Statt die einzelne Aufgabe möglichst schnell abzuschließen, optimiert sie den Gesamtdurchsatz.
Wenn die CPU ein Handwerker ist, gleicht die GPU einer großen Fabrik. Viele Beschäftigte erledigen ähnliche Arbeitsschritte gleichzeitig und steigern damit die Gesamtleistung. Beide Ansätze haben Vorteile.
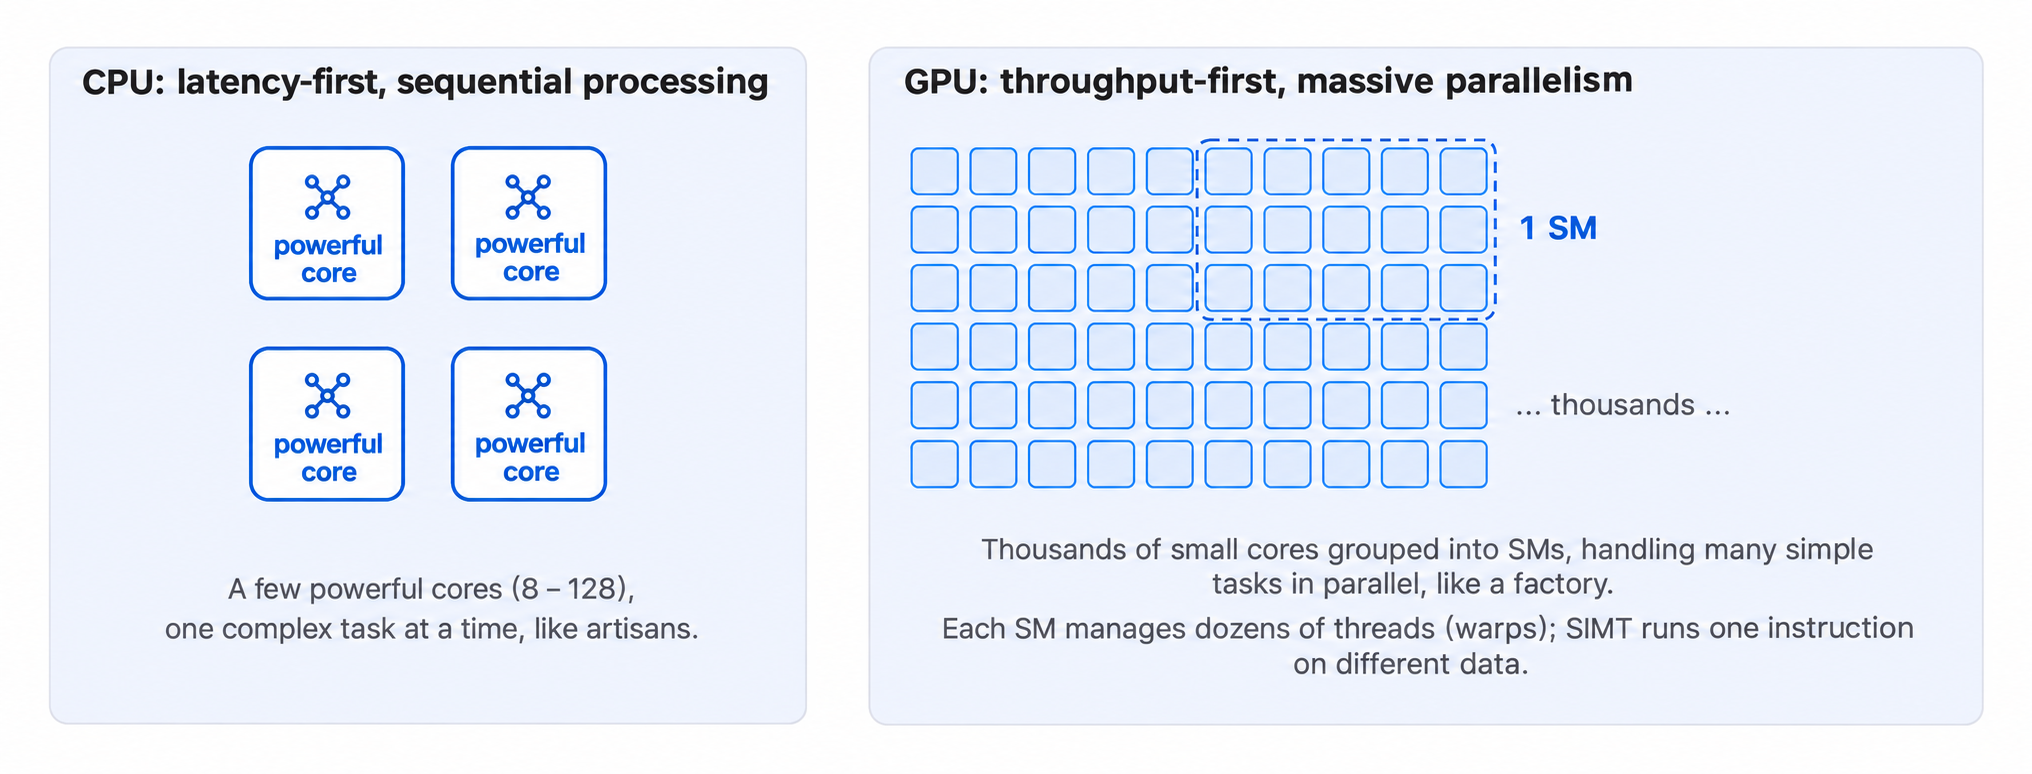
Bei komplexer Steuerlogik, häufigen Verzweigungen und sequenziellen Abhängigkeiten ist meist die CPU besser geeignet. Für viele ähnliche, parallel ausführbare Berechnungen liefert die GPU oft mehr Durchsatz.
Webdienste, Datenbanken und Betriebssysteme enthalten viel Steuerlogik und hängen daher hauptsächlich von CPUs ab. Deep Learning führt dagegen zahlreiche Matrixoperationen aus, von denen viele parallel laufen können.
Warum KI CPUs überfordert
Neuronale Netze führen viele Matrixmultiplikationen aus. Vereinfacht werden große Mengen von Zahlen nach festen Regeln multipliziert und addiert.
Beim Verarbeiten von Token fallen zahlreiche solche Operationen an. Viele können gleichzeitig ausgeführt werden. Genau darin liegt die Stärke einer GPU.
Eine CPU mit 128 Kernen muss eine große Matrixberechnung in mehreren Schritten abarbeiten. Eine GPU mit Tausenden Rechenkernen kann die Matrix aufteilen und Teile parallel auf unterschiedlichen Einheiten verarbeiten.
Der Vorteil besteht nicht darin, dass jeder GPU Kern schneller wäre als ein CPU Kern. Die GPU kann sehr viele Einheiten gleichzeitig für gleichartig strukturierte Aufgaben einsetzen.
Viele Matrixoperationen neuronaler Netze lassen sich auf diese Weise parallelisieren. Deshalb kann GPU Hardware ihre parallele Architektur ausspielen und ist eine wichtige Rechenplattform für KI Training und Inferenz.
Drei zentrale Begriffe für GPU und KI Berechnungen
Tensor Core: Ein Sidecar für Matrixoperationen
NVIDIA GPUs enthalten allgemeine CUDA Cores und auf Matrixoperationen spezialisierte Tensor Cores.
CUDA Cores bearbeiten viele Arten von Berechnungen. Tensor Cores sind für Matrix Multiplikation und Addition optimiert und verarbeiten Matrixblöcke effizient. Bei passenden Datentypen und Aufgaben erreichen sie einen höheren Durchsatz.
Da neuronale Netze viele Matrixmultiplikationen durchführen, können Tensor Cores hier ihren Vorteil ausspielen.
Als K8s Analogie sind CUDA Cores allgemeine Worker für verschiedene Aufgaben, während Tensor Cores spezialisierten Sidecars für „Matrixmultiplikation in großen Mengen“ ähneln. Beide erfüllen unterschiedliche Rollen.
HBM: Schneller lokaler Speicher für den Node
Auch eine schnelle GPU benötigt einen ausreichend schnellen Datenstrom.
Wie eine CPU nutzt eine GPU mehrere Speicherebenen: Register, gemeinsam genutzten Speicher, Caches und Gerätespeicher. Sie unterscheiden sich in Kapazität, Zugriffslatenz und Bandbreite.
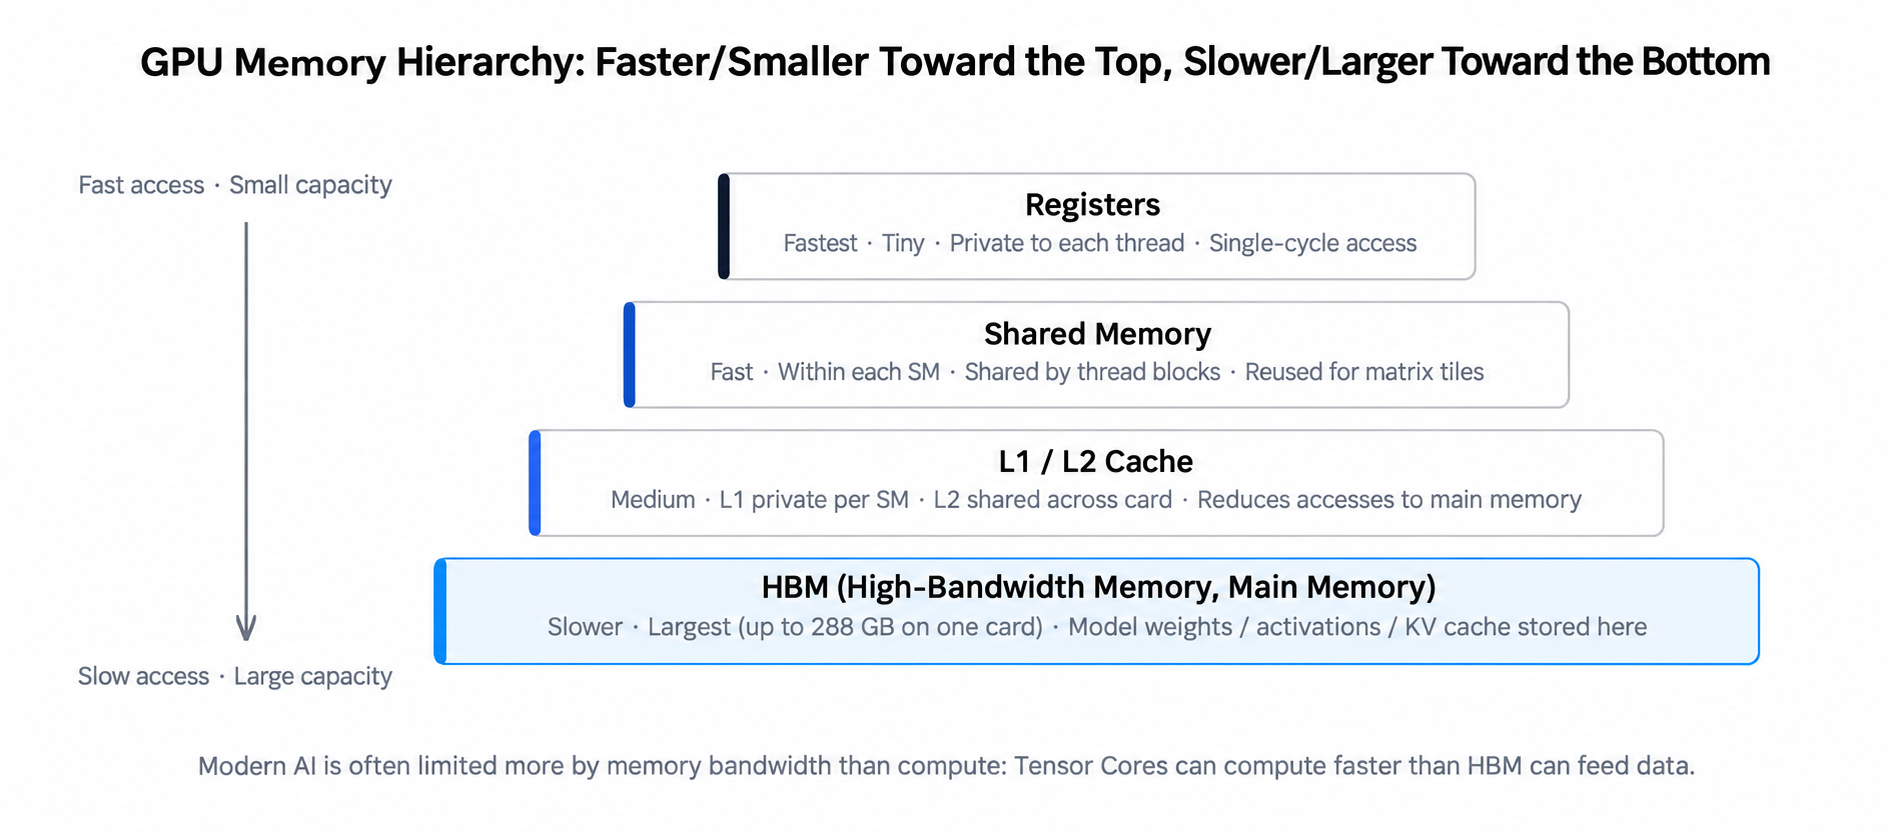
HBM (High Bandwidth Memory) ist eine verbreitete Speichertechnologie für leistungsfähige GPUs. Dort können Modellgewichte, Zwischenergebnisse und KV Cache liegen. Die hohe Bandbreite versorgt die GPU bei großen Berechnungen schneller mit Daten.
Herkömmlicher GDDR Speicher besteht meist aus getrennten Chips auf einer Platine. Mit steigendem Bandbreitenbedarf begrenzen Schnittstellenbreite, Leiterbahnen und Stromverbrauch den Ausbau.
HBM stapelt Speicherlagen vertikal, verbindet sie über Through-Silicon Vias (TSVs) und integriert die Stapel über dichte Packaging Technik nahe dem GPU Chip. So entsteht eine breitere Speicherschnittstelle auf kleinerem Raum und eine höhere Übertragungsbandbreite.
Anschaulich sind konventionelle Speicherchips mehrere Lagerhäuser rund um eine Werkstatt; HBM platziert die Lager direkt daneben und liefert Material über mehr parallele Wege.
Warum ist Bandbreite so wichtig? Eine GPU kann eine Matrix erst berechnen, wenn die Daten vorliegen. Liefert der Gerätespeicher nicht schnell genug, warten die Recheneinheiten.
Bei manchen KI Inferenzaufgaben wird deshalb eher die Speicherbandbreite als die Rechenleistung zum begrenzenden Faktor.
Die HBM Bandbreite blieb in der Entwicklung von NVIDIA GPUs ein wichtiger Leistungswert. Von H200 über Blackwell bis Vera Rubin wurde sie für wachsende KI Aufgaben weiter erhöht.
NVIDIA optimiert außerdem Datenübertragungen zwischen GPU und externen Geräten:
- GPUDirect Storage ermöglicht direktere Übertragungen vom Speichergerät zum GPU Speicher und reduziert Umwege über Host Speicher und CPU.
- GPUDirect RDMA ermöglicht direkten Datenaustausch zwischen GPU Speicher und RDMA fähigen Netzwerkgeräten und spart Kopien und CPU Beteiligung zwischen Nodes.
- NVLink ist eine schnelle Verbindung zwischen GPUs für den Datenaustausch in Systemen mit mehreren Karten.
Die Techniken wirken an unterschiedlichen Stellen des Datenpfads, helfen aber alle bei schneller Datenversorgung. K8s Entwickler können sie als Maßnahmen zur Vermeidung unnötiger Zwischenstationen verstehen.
NVIDIAs Stellung bei KI Berechnungen hängt auch eng mit diesem Ökosystem aus GPU Speicher und schnellen Verbindungen zusammen.
Transformer und Token: Wie ein Sprachmodell antwortet
Ein Transformer ist keine Hardware, sondern eine neuronale Netzarchitektur. GPT, Claude, LLaMA und andere große Sprachmodelle nutzen Transformer basierte Ansätze.
Bei üblichen autoregressiven Sprachmodellen lässt sich Textgenerierung vereinfacht als Vorhersage des nächsten Token anhand der vorhandenen Tokenfolge verstehen.
Ein Token ist eine grundlegende Texteinheit: ein Zeichen, ein Wort oder ein Wortteil.
Das Modell wandelt eine Eingabe in Token um, berechnet anhand des bisherigen Kontextes die Wahrscheinlichkeiten für das nächste Token und wählt es nach einer Generierungsstrategie aus.
Dieses Token wird zur Folge hinzugefügt. Mit dem aktualisierten Kontext folgt die nächste Vorhersage, bis die Antwort vollständig ist oder eine Abbruchbedingung erreicht wird.
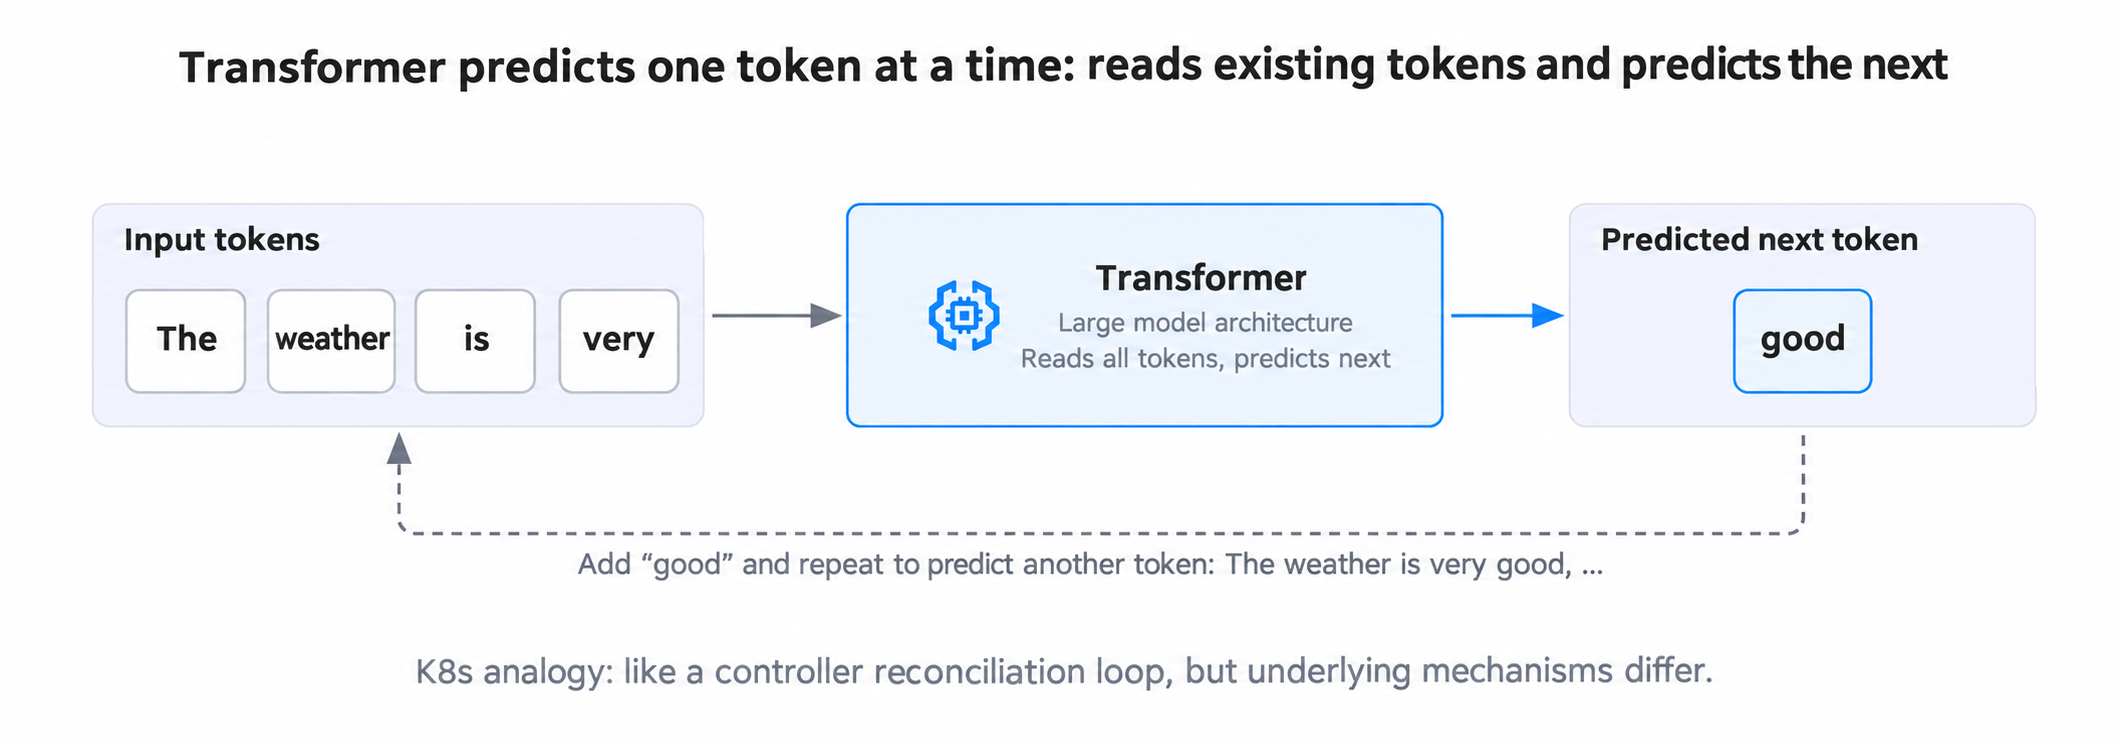
Eine K8s Analogie ist die Reconcile Schleife eines Controllers: aktuellen Zustand lesen (vorhandene Token), nächsten Schritt berechnen (neues Token), Folge aktualisieren und wiederholen.
Das ist nur eine Hilfe zum Verständnis des iterativen Ablaufs. Die interne Berechnung eines Transformers unterscheidet sich von einem Kubernetes Controller. Die schrittweise Anzeige von Antworten in KI Assistenten hängt mit dieser autoregressiven Generierung zusammen.
Training vs. Inferenz
Training und Inferenz sind zwei Phasen im Lebenszyklus eines Modells. Beide benötigen GPU Berechnungen, haben aber unterschiedliche Lastprofile und Ressourcenanforderungen.
- Training berechnet wiederholt über große Datenmengen und passt Parameter an. Große Läufe können Wochen oder Monate dauern und stellen Gesamtdurchsatz und Trainingseffizienz in den Vordergrund. In K8s Begriffen entspricht es einem langen Batch Job, der Modellgewichte erzeugt.
- Inferenz verarbeitet Eingaben mit einem trainierten Modell und liefert Ergebnisse. Ein Onlinedienst muss schnell antworten und bei vielen gleichzeitigen Nutzern stabil bleiben. Das ähnelt einem mit K8s Deployment betriebenen Dienst.
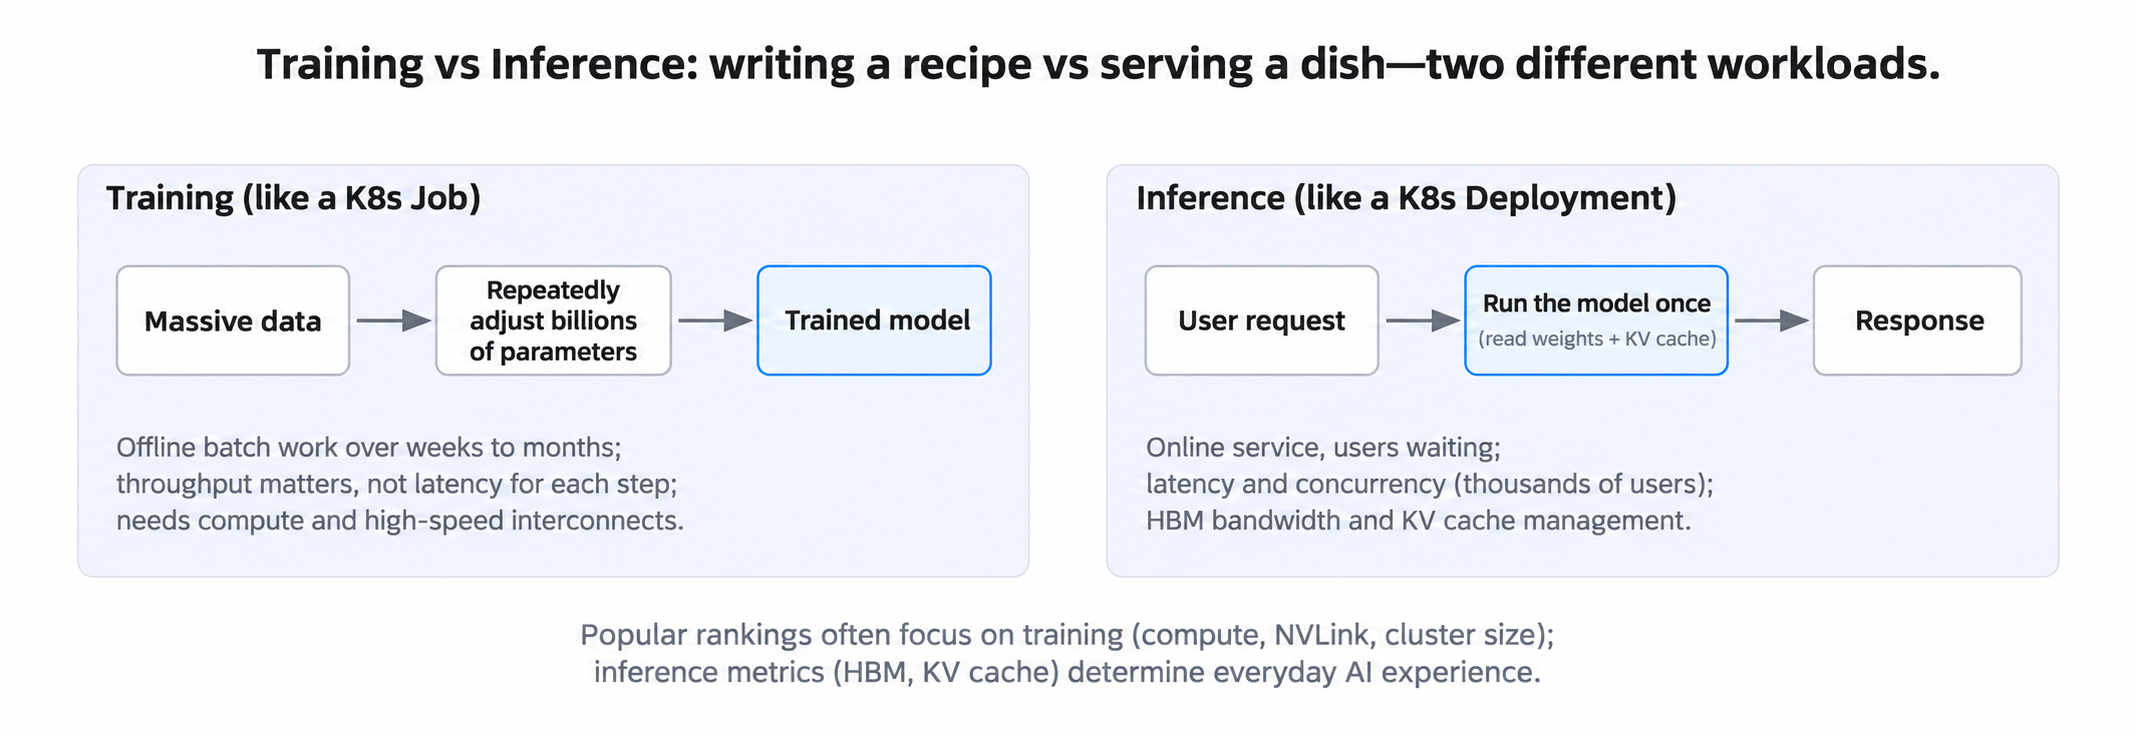
Diese Unterschiede beeinflussen GPU Auswahl und Leistungsbewertung.
Für großes Training zählen Tensor Core Rechenleistung, Kommunikationsbandbreite zwischen GPUs und effiziente Zusammenarbeit mehrerer Karten. Berechnung und Datenaustausch bestimmen gemeinsam die Laufzeit.
Bei der Inferenz großer Sprachmodelle sind zusätzlich HBM Kapazität und Bandbreite sowie KV Cache Verwaltung wichtig. Sie beeinflussen Kontextlänge, gleichzeitige Anfragen und die Geschwindigkeit der Token Generierung.
Die GPU Auswahl muss deshalb zur konkreten Trainings- oder Inferenzlast und deren Bedarf an Rechenleistung, Speicher und Kommunikation passen.
Zusammenarbeit mehrerer GPUs: Verteilte Berechnungen in KI Clustern
Eine GPU reicht nicht für jede Aufgabe. Große Modelle passen eventuell nicht in ihren Speicher; umfangreiches Training kann Hunderte oder Tausende GPUs benötigen.
Wenn mehrere GPUs zusammenarbeiten, müssen Aufgaben aufgeteilt, Daten übertragen, Ergebnisse synchronisiert und Nodes koordiniert werden. Viele dieser Fragen kennen Cloud Native Entwickler aus verteilten Systemen.
Zusammenarbeit mehrerer GPUs
Bei Modellparallelität laufen unterschiedliche Teile eines Modells auf verschiedenen GPUs. Jede berechnet ihren Teil und tauscht Zwischenergebnisse aus. Das erinnert an die Verteilung von Funktionen auf Mikroservices, erfordert jedoch meist eine engere Synchronisierung und reagiert empfindlicher auf Latenz und Bandbreite.
Kommunikation zwischen GPUs
Vor allem verteiltes Training tauscht häufig Daten aus. Innerhalb eines Nodes können GPUs NVLink und ähnliche schnelle Verbindungen nutzen; zwischen Nodes kommen oft InfiniBand oder RoCE zum Einsatz.
Eine Analogie ist der Ost West Verkehr zwischen Mikroservices. Verteilte KI stellt jedoch strengere Anforderungen an Bandbreite, Latenz und Topologie. NVIDIA integriert GPUs und schnelle Netzwerke auch auf Systemebene, etwa bei Vera Rubin NVL72. Solche Rack Architekturen verbinden mehrere GPUs und Interconnect Komponenten für parallele Berechnungen.
All-reduce
Beim datenparallelen Training verarbeitet jede GPU einen Teil der Trainingsdaten und berechnet Gradienten. Damit alle Beteiligten einheitliche Aktualisierungen verwenden, müssen diese Gradienten zusammengeführt werden. All-reduce ist eine kollektive Kommunikationsoperation, die Werte über GPUs reduziert und das Ergebnis an alle verteilt.
Erfahrung mit etcd oder Raft hilft beim Verständnis der Koordination zwischen Nodes, doch die Probleme sind verschieden: Raft behandelt verteilten Konsens; All-reduce aggregiert und verteilt numerische Daten.
Continuous Batching
Anfragen an ein Sprachmodell treffen zu verschiedenen Zeiten ein und erzeugen unterschiedlich viele Token. Statisches Batching wartet oft, bis ein ganzer Batch fertig ist. Continuous Batching nimmt während der Generierung neue Anfragen auf und entfernt abgeschlossene.
Aus Sicht ereignisgesteuerter Systeme ist es ein fortlaufend arbeitender Dienst. Hier werden neben Anfragen auch die GPU Ressourcen für jeden Generierungsschritt geplant. Die dynamische Zusammensetzung reduziert Wartezeiten und Leerlauf und erhöht den Inferenzdurchsatz.
Disaggregierte Inferenz
Die Inferenz eines Sprachmodells umfasst meist zwei Phasen:
- Prefill verarbeitet die Eingabe Token und erzeugt den KV Cache. Dabei fallen viele parallele Berechnungen an.
- Decode nutzt den vorhandenen KV Cache und generiert Ausgabe Token schrittweise. Diese Phase reagiert stärker auf Speicherbandbreite und Cache Verwaltung.
Da die Anforderungen verschieden sind, betreiben manche Systeme Prefill und Decode in getrennten GPU Pools und skalieren sie unabhängig. Das heißt disaggregierte Inferenz. Der KV Cache muss zwischen beiden übertragen werden; die Methode hängt von Hardware und Implementierung ab.
Ähnlich wie getrennt bereitgestellte Mikroservices übernehmen die Phasen verschiedene Funktionen. Der KV Cache entspricht einem Sitzungskontext zwischen den Verarbeitungsschritten.
Trotz neuer Hardware und Rechenmechanismen sind Aufgabenverteilung, Node Kommunikation, Scheduling und Datenverwaltung vertraute Probleme. Erfahrung mit Kubernetes, Istio, Envoy und anderen verteilten Systemen hilft beim Verständnis von KI Clustern.
GPU Cluster planen: Slurm und Kubernetes gemeinsam
Nach der Zusammenarbeit mehrerer GPUs stellt sich die Frage, wer ihre Aufgaben plant und verwaltet. Slurm und Kubernetes sind verbreitete Lösungen mit unterschiedlicher Herkunft und unterschiedlichen Stärken.
Slurm ist im High Performance Computing (HPC) weit verbreitet. Laut den im Quelltext zitierten NVIDIA Daten nutzen etwa 65 % der globalen TOP500 Supercomputer Slurm. Große KI Trainingsteams haben oft etablierte Job Skripte, Fair Share Regeln und Abrechnungsprozesse.
Großes Modelltraining läuft lange und hat hohe Anforderungen an GPU Topologie, Kommunikation zwischen Nodes und Gesamtdurchsatz. Slurms langjährige Erfahrung mit Batch Jobs und großen Rechenpools macht es hierfür attraktiv.
Kubernetes eignet sich besonders für containerisierte Workloads und Onlinedienste. Inferenz benötigt Autoscaling, Service Discovery, Traffic Management und Observability—alles ausgereifte K8s Fähigkeiten. Mit passenden Schedulern und Komponenten kann Kubernetes auch Training unterstützen.
Unternehmen mit Training und Onlineinferenz müssen mitunter beide Umgebungen betreiben. NVIDIAs Open Source Projekt Slinky bietet einen gemeinsamen Ansatz: Slurm wird in Kubernetes bereitgestellt und verwaltet. K8s übernimmt die Infrastruktur, Slurm behält seine Stärken bei HPC Jobs.
Zu den Komponenten gehören:
- slurm-operator verwaltet Slurm Komponenten wie slurmctld, slurmd und slurmdbd über Kubernetes Ressourcen und Workload Objekte. K8s Konfiguration und Lebenszyklusverwaltung erleichtern Bereitstellung und Betrieb.
- GPU Operator + DCGM Exporter verwalten Treiber und weitere GPU Komponenten und sammeln Metriken. Mit Slurm Jobdaten wird Monitoring auf Job Ebene möglich.
- ComputeDomains + DRA verwenden Kubernetes Dynamic Resource Allocation und verwandte Mechanismen für GPU Interconnect Ressourcen in Systemen wie GB200 NVL72 und unterstützen damit verteiltes Training.
Laut der im Original zitierten NVIDIA Praxis wurde Slinky für mehr als 8.000 GPUs eingesetzt. Bei den genannten NCCL All-reduce und All-gather Tests lag die Kommunikationsleistung nahe an einer nativen Slurm Umgebung. Unter diesen Testbedingungen verursachte die Kubernetes Verwaltungsebene keinen deutlichen Leistungsverlust.
Slinky zeigt eine Möglichkeit zur Clusterverwaltung: Kubernetes betreibt die Infrastruktur und Slurm plant die entsprechenden Rechenjobs innerhalb derselben Umgebung.
Training und Inferenz haben dennoch unterschiedliche GPU Anforderungen. Unabhängig vom Scheduler müssen Zuweisung, Topologie, elastische Planung und Auslastung zur Aufgabe passen. Neben der Platzierung auf einer geeigneten GPU bleibt die Ressourceneffizienz eine wichtige Herausforderung.
KV Cache: Speicherbedarf bei der Inferenz großer Sprachmodelle
Der KV Cache beeinflusst Speicherbedarf und Leistung wesentlich. Beim Generieren eines neuen Token benötigt ein Transformer Attention Informationen früherer Token. Ihre Keys und Values jedes Mal neu zu berechnen, würde viel Rechenarbeit wiederholen.
Deshalb speichern Inferenzsysteme bereits berechnete Keys und Values für spätere Schritte: den KV Cache (Key-Value Cache).
Er spart Berechnungen, benötigt aber zusätzlichen GPU Speicher, der mit der Kontextlänge wächst. Beispiele:
- Für eine Unterhaltung mit 10.000 Token müssen die zugehörigen Keys und Values gespeichert werden.
- Für ein neues Token liest die Attention Berechnung normalerweise den relevanten historischen KV Cache.
- Im Beispiel der Quelle kann ein 70B Modell mit 32K Kontext pro Anfrage 8–16 GB KV Cache benötigen.
- Bei langen Kontexten und vielen gleichzeitigen Anfragen können insgesamt Hunderte Gigabyte belegt sein.
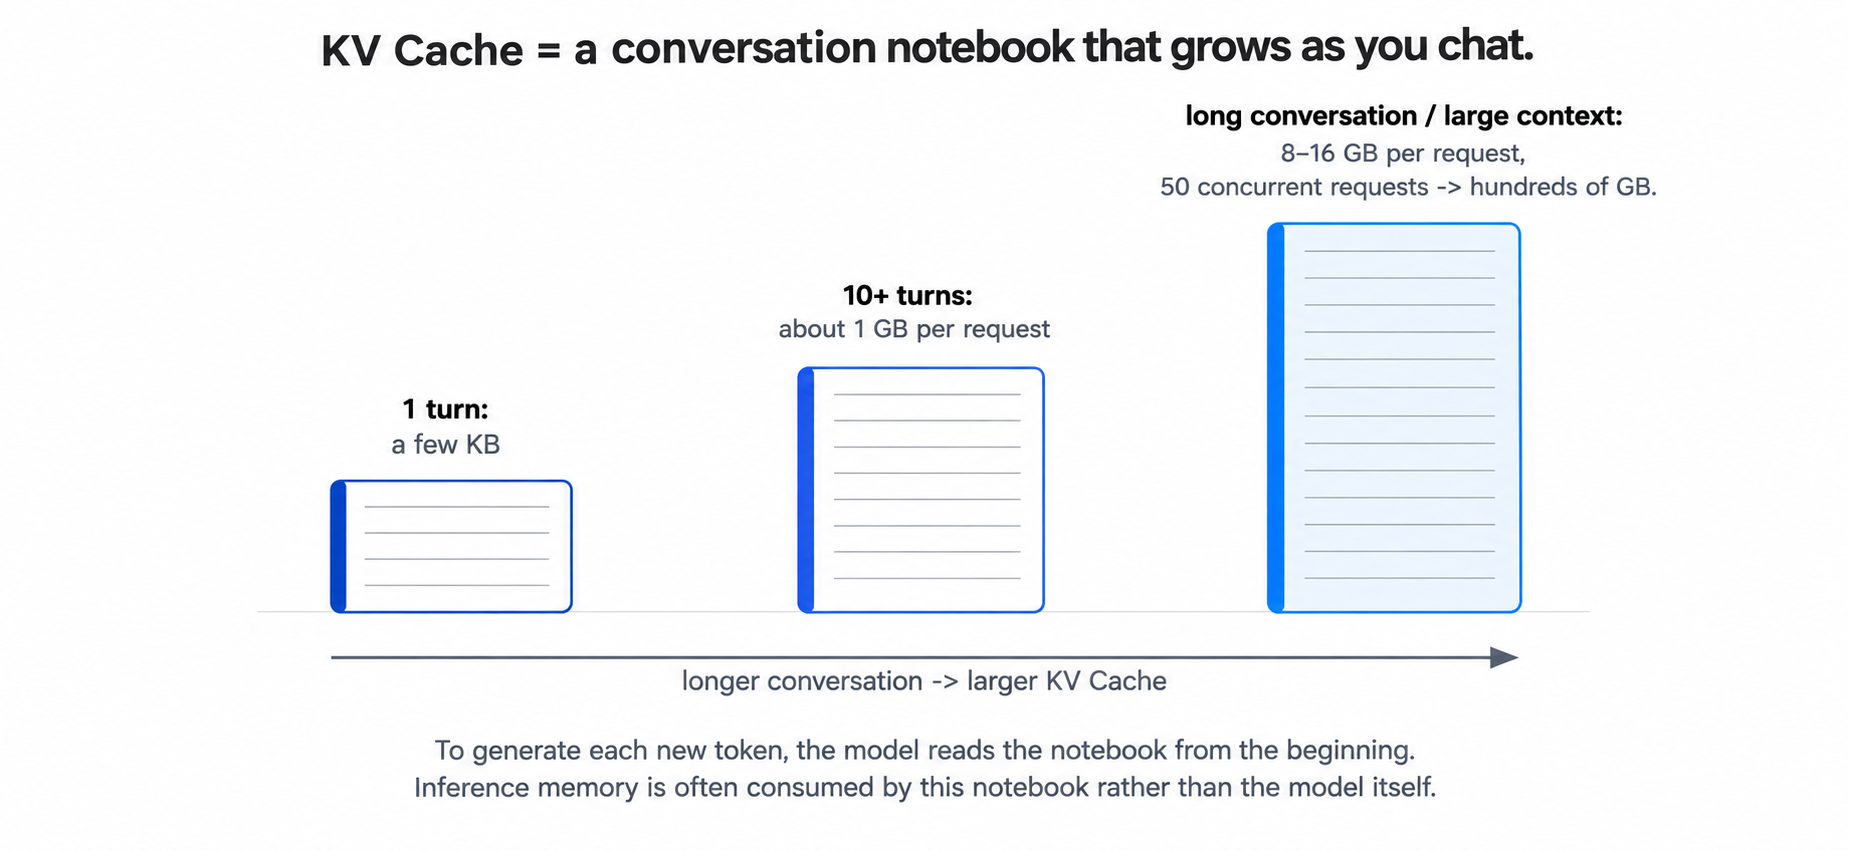
Für K8s Entwickler ähnelt der KV Cache lokal gespeichertem Sitzungszustand. Längere Gespräche behalten mehr Historie, auf die weitere Generierungsschritte zugreifen müssen.
Der GPU Speicher muss sowohl Modellgewichte als auch KV Cache aufnehmen. Lange Kontexte oder hohe Parallelität können die Zahl gleichzeitig bearbeitbarer Anfragen begrenzen. Inferenz Frameworks nutzen unterschiedliche Verwaltungsverfahren.
PagedAttention in vLLM übernimmt die Idee von Speicherseiten und verwaltet KV Cache in Blöcken. Das mindert Fragmentierung und verbessert die Speicherausnutzung.
NVIDIA Dynamo und ähnliche Inferenzsysteme bieten eine hierarchische KV Cache Verwaltung und verschieben Daten je nach Zugriff zwischen GPU Speicher, CPU Speicher und anderen Ebenen.
Zuweisung, Wiederverwendung und Verwaltung des KV Cache bestimmen Speicherverbrauch, Parallelität und Gesamtleistung eines Inferenzdienstes.
GPU Auslastung kann täuschen
K8s Betreiber wissen: Ein Pod im Zustand Running arbeitet nicht unbedingt effizient. Ähnlich ist es bei GPUs. Hohe gemeldete Auslastung beweist keine hohe Recheneffizienz.
GPU Utilization in nvidia-smi beschreibt den Anteil eines Messzeitraums, in dem mindestens ein Compute Kernel läuft. Die Kennzahl zeigt Aktivität, aber nicht, ob die Recheneinheiten vollständig genutzt werden.
90 % Auslastung bedeuten nicht 90 % der maximalen Rechenleistung. Speicherbandbreite, Kernel Startaufwand und andere Faktoren können Kapazität ungenutzt lassen.
Für eine Bewertung müssen SM Aktivität (Streaming Multiprocessor), Rechendurchsatz, Tensor Core Nutzung und Speicherbandbreite gemeinsam betrachtet werden. Selbst fast 100 % in nvidia-smi können mit geringer SM Aktivität einhergehen. Der Engpass hängt von Workload und feineren Messwerten ab.
Für Inferenzdienste zählen außerdem Anwendungsmetriken:
- Token Durchsatz: ausgegebene Token pro Zeiteinheit, ähnlich dem Durchsatz eines Onlinedienstes.
- TTFT (Time to First Token): Zeit von der Anfrage bis zum ersten ausgegebenen Token; sie prägt die wahrgenommene Reaktionszeit.
- TPOT (Time Per Output Token): durchschnittliche Zeit pro Ausgabe Token während der Generierung. ITL (Inter-Token Latency) ist der Abstand zwischen zwei Token. Die Kennzahlen hängen zusammen, ihre Berechnung kann je nach Framework variieren.
- GPU Speicherbelegung: Modellgewichte, KV Cache und temporäre Rechendaten getrennt betrachten, um Kapazitäts- oder Zugriffsengpässe zu finden.
K8s Entwickler können diese Metriken mit QPS, Antwortlatenz und Ressourcenreserve vergleichen. Entscheidend sind sowohl Hardwareaktivität als auch tatsächlich bearbeitete Anfragen, erzeugte Token und Antwortzeiten.
Warum NVIDIA schwer zu verdrängen ist
Neben der Hardwareleistung ist das CUDA Softwareökosystem ein wesentlicher Grund für NVIDIAs Position im KI Markt.
CUDA ist mehr als eine Schnittstelle für parallele Berechnungen. Es umfasst Programmiermodell, Compiler, Laufzeit und beschleunigte Bibliotheken. Über Jahre entstand eine breite Werkzeugkette, die von PyTorch, TensorFlow, JAX und anderen Frameworks unterstützt wird. Viele Trainings- und Inferenzsysteme sind speziell für CUDA optimiert.
Man kann das Ökosystem mit Linux Kernel, containerd und zugehörigen Cloud Native Werkzeugen zusammen vergleichen: Mehrere Softwareebenen greifen ineinander.
Die Verlagerung vorhandener KI Workloads auf andere GPUs erfordert daher meist mehr als neue Hardware. Rechenkerne, Bibliotheken, Frameworks, Inferenzdienste, Monitoring und Betriebswerkzeuge müssen auf Kompatibilität und Leistung geprüft werden.
Dieses Ökosystem von Entwicklung bis Betrieb und die Kosten eines Wechsels sind ein wichtiger Wettbewerbsvorteil NVIDIAs.
Die Zukunft: KI Fabriken
NVIDIA verwendet zunehmend den Begriff „AI Factory“ für auf KI Berechnungen ausgerichtete Rechenzentren. Damit wird betont, dass nicht nur GPUs, sondern Rechenleistung, Speicher, Netzwerk, Stromversorgung und Kühlung gemeinsam geplant werden müssen.
Mit wachsender GPU Dichte und Clustergröße sind besonders wichtig:
- Stromversorgung: Laut Quelle verbraucht ein Vera Rubin Rack über 100 kW; ein mittelgroßes Trainingscluster kann 10–50 MW benötigen. Kapazität, Stabilität und Redundanz müssen früh eingeplant werden.
- Kühlung: Dichte GPU Systeme erzeugen viel Wärme. Luftkühlung reicht in manchen Fällen nicht aus; Flüssigkeitskühlung wird für dichte Server und Racks wichtiger.
- Netzwerktopologie: Verteiltes Training tauscht häufig Daten aus. Bandbreite, Latenz und Verbindungen zwischen GPUs beeinflussen die Effizienz. Netzwerk und Node Anordnung müssen zur Last passen.
- Speicherbandbreite: Schnellere Recheneinheiten benötigen eine entsprechende Datenversorgung. Bei manchen KI Aufgaben bleibt die Bandbreite des GPU Speichers entscheidend.
- Verfügbarkeit und Betrieb: Stromredundanz, Kühlungsausfälle, Netzzuverlässigkeit und Wiederherstellung von Nodes beeinflussen die Stabilität.
Erfahrene Betreiber großer verteilter Systeme kennen diese Fragen. Dichte KI Cluster haben allerdings strengere Anforderungen an Strom, Kühlung und schnelle Verbindungen; Hardwareplanung und Betrieb müssen enger zusammenarbeiten.
Die CPU bleibt wichtig
GPUs übernehmen die Modellberechnung, doch CPUs sind für KI Infrastruktur unverzichtbar. Mit Agentic AI werden ihre Aufgaben vielfältiger.
In gewöhnlichen Sprachmodell Inferenzsystemen verarbeiten CPUs Anfragen und Eingabedaten und übernehmen Scheduling. Agenten fügen Aufgabenorchestrierung, Werkzeugaufrufe, Zusammenarbeit mehrerer Agenten, Zustandsverwaltung und Ergebnisverarbeitung hinzu. Vieles davon benötigt CPU Ressourcen.
Auch Reinforcement Learning und Training mit komplexer Umgebungsinteraktion können die CPU stärker belasten, etwa durch Ausführung von Umgebungen und Werkzeugen oder durch Auswertung.
Infrastrukturplanung darf sich deshalb nicht auf GPU Rechenleistung beschränken. Ausreichende CPU Kapazität und das Zusammenspiel beider Prozessorarten beeinflussen die Effizienz des Gesamtsystems. K8s Entwickler sollten Modellinferenz, Orchestrierung, Werkzeuge und Datenverarbeitung bei der Zuweisung von CPU, GPU, Speicher und Netzwerk berücksichtigen.
Was bedeutet das für K8s Veteranen?
Nach Architektur und Berechnung komme ich zu meiner eigenen Arbeit zurück: GPU Ressourcenverwaltung.
GPUs sind teuer in Anschaffung und Betrieb. Eine zugewiesene GPU wird nicht automatisch vollständig genutzt. Speicherbandbreite, KV Cache, Batching und weitere Faktoren bestimmen die tatsächliche Effizienz.
Dazu gehören Fragen wie:
- Wie teilen mehrere Mandanten eine GPU sicher, ähnlich wie K8s mehrere Pods auf einem Node platziert?
- Welche Zuweisungs- und Sharing Strategien passen zu Training und Inferenz?
- Welche feingranularen Metriken zeigen, ob die Rechenleistung wirklich genutzt wird?
GPU Virtualisierung und Sharing Technologien müssen diese Fragen lösen.
Laut der in der Quelle zitierten ClearML Umfrage zur KI Infrastruktur erreichten nur etwa 7 % der befragten Unternehmen zu Spitzenzeiten eine GPU Auslastung über 85 %. Mehr als die Hälfte lag zwischen 51 % und 70 %, rund 15 % unter 50 %.
Für viele Unternehmen bleibt die Nutzung der Ressourcen also eine Herausforderung. Niedrige Werte können an Lastprofil, Konfiguration, Scheduling oder anderen Ursachen liegen und müssen im Einzelfall untersucht werden.
Aus meiner Erfahrung unterscheide ich drei Stufen der GPU Ressourcenverwaltung:
Allocation (Zuweisung) → Utilization (Auslastung) → Efficiency (Effizienz)
- Allocation fragt, wer eine GPU erhält. Kubernetes Device Plugin kann GPUs entdecken und zuweisen. Ganze Karten exklusiv zu verwenden oder Zeitscheiben zu teilen sind unterschiedliche Ansätze.
- Utilization fragt, wie viel der zugewiesenen Ressource tatsächlich genutzt wird. Dynamisches Batching und elastische Skalierung können Leerlauf verringern.
- Efficiency fragt, wie wirksam die Berechnungen die Hardware nutzen. Hohe Auslastung allein genügt nicht. SM Aktivität, Tensor Core Nutzung, Speicherbandbreite und Token pro Energieeinheit liefern ein genaueres Bild.
Die Verwaltung kann feingranularer werden. Zukünftige Scheduler könnten Hardwarezustand und Anwendungsmetriken einbeziehen, statt nur freie Kartenquoten zu prüfen. SM Aktivität, Speicherbedarf und KV Cache Belegung könnten bei der Platzierung helfen.
Cloud Native Entwickler kennen ähnliche Probleme aus Scheduling, Mandantenverwaltung und Observability. Diese Erfahrung ist eine gute Grundlage für das Verständnis der KI Infrastruktur.
Jenseits von NVIDIA
Der bisherige Text konzentrierte sich auf NVIDIA. Dessen Hardware und Software sind für heutige KI Berechnungen repräsentativ, aber es gibt andere Wege. Cloud Anbieter, klassische Chiphersteller und chinesische Hardwareunternehmen entwickeln eigene Produkte und Softwarestacks.
- Eigene Beschleuniger der Cloud Anbieter: Google entwickelt TPU weiter; AWS arbeitet an Trainium und Inferentia; Meta, Microsoft und andere entwickeln eigene KI Chips.
- Traditionelle Chiphersteller: AMD erweitert mit Instinct GPUs und ROCm sein KI Angebot; Intel entwickelt Gaudi, oneAPI und verwandte Produkte.
- Chinas heterogenes Ökosystem: Huawei Ascend, Hygon DCU, Cambricon, Moore Threads, Enflame, Kunlunxin, MetaX, Biren und weitere Anbieter entwickeln Hardware und Software weiter.
- Offene Software: UXL, Triton und PyTorch Unterstützung für verschiedene Hardware Backends fördern die Portabilität.
Verschiedene Beschleuniger erhöhen die Komplexität der Infrastrukturverwaltung. In einem Cluster können NVIDIA, AMD und andere GPUs mit unterschiedlichen Geräteschnittstellen, Treibern, Laufzeiten und Softwarestacks vorhanden sein. Erkennung, Zuweisung, Scheduling und Monitoring müssen darauf eingehen.
Für spätere Artikel bleiben folgende Fragen:
- Wie lassen sich verschiedene Beschleuniger in einem Cluster einheitlich planen und beobachten?
- Wie unterstützen Kubernetes Device Plugin und DRA (Dynamic Resource Allocation) unterschiedliche Hardware?
- Wie könnte offene Software den Vorteil des CUDA Ökosystems verändern?
- Welche Software- und Infrastrukturverbesserungen sind nötig, damit chinesische KI Beschleuniger stärker produktiv eingesetzt werden können?
Dieser Artikel begann mit der GPU Architektur, erklärte ihre Eignung für Deep Learning und verglich die Hardwareanforderungen von Training und Inferenz. Der nächste Artikel betrachtet weitere Beschleuniger und die Verwaltung heterogener Rechenressourcen mit Kubernetes.
Quellen
- Ameen Alam, Why GPUs Became the Foundation of Modern AI (Teil 1)
- Ameen Alam, The Hidden Technology Behind Modern AI GPUs (Teil 2)
- Ameen Alam, Real AI Infrastructure and the Future of GPUs (Teil 3)
- TrendForce, The Great Rebalance: How Agentic AI Is Reshaping the CPU/GPU Ratio (CPU:GPU Verhältnis)
- Anton Polyakov (NVIDIA), Running Large-Scale GPU Workloads on Kubernetes with Slurm (Slinky/Slurm unter K8s)
- Kawonise, Why NVIDIA GPU Architecture Is Perfect for AI: GPU Data Path for a Single Node (GPUDirect Datenpfad)
- Mirantis, GPU Infrastructure Automation and Strategy (Automatisierung und Auslastung der GPU Infrastruktur)