

Die Architekturentwicklung von HAMi-DRA: Kubernetes-native Planung und Ascend-NPU in der Praxis
 Engineering
HAMi-DRA überträgt Geräteanforderungen, Planung und Kapazitätsbuchführung an Kubernetes DRA; HAMi-core sorgt weiterhin für die Isolation zur Laufzeit. Der Beitrag behandelt Architektur, Kompatibilitätsmodus, einen Ascend-NPU-Versuch und praktische Grenzen.
Auf dieser Seite
Am 15. September 2026 veröffentlichte die HAMi-Community HAMi DRA 0.2.3.
Die Version setzt HAMis Entwicklung hin zu einem Kubernetes-nativen Ressourcenmodell fort: Geräteanforderungen, Planung und Kapazitätsbuchführung übernimmt Kubernetes DRA; HAMi-core setzt innerhalb der Container weiterhin Speicher- und Rechenquoten durch.
Bereits im Webinar zu HAMi 2.9 wurde HAMi-DRA als produktionsreif angekündigt. Seit Kubernetes 1.34 die zentralen DRA-APIs als GA bereitstellt, ist HAMi-DRA eine Option für die Verwaltung heterogener Beschleuniger.
Für bestehende HAMi-Nutzer ist besonders der Kompatibilitätsmodus wichtig: Er wandelt vorhandene HAMi-Ressourcenanforderungen in native ResourceClaims um und verringert Änderungen an der YAML-Konfiguration bei einer Migration.
Warum braucht HAMi DRA? Welche Aufgaben gehen an Kubernetes über, und welche verbleiben bei HAMi? Der Beitrag erläutert ausgehend von der bisherigen Architektur die Neuerungen durch DRA, die Architektur von HAMi-DRA, seine Betriebsarten und den aktuellen Stand.
Warum HAMi-DRA benötigt wird
HAMi ermöglicht mehreren Workloads die gemeinsame Nutzung einer GPU oder eines anderen Beschleunigers und teilt ihnen Speicher und Rechenleistung nach Bedarf zu. Im herkömmlichen Kubernetes-Device-Plugin-Modell werden Extended Resources meist als ganze Geräte gezählt:
resources:
  limits:
    nvidia.com/gpu: 1
Damit wird eine GPU angefordert; ein Anteil ihres Speichers oder ihrer Rechenleistung lässt sich in diesem Eintrag nicht ausdrücken.
Für die feingranulare gemeinsame Nutzung erweitert HAMi die Ressourcenangaben. Eine Anforderung für Ascend 310P kann so aussehen:
resources:
  limits:
    huawei.com/Ascend310P: 1
    huawei.com/Ascend310P-memory: "8192"
    huawei.com/Ascend310P-core: "50"
8192 steht für 8192 MiB (8 GiB) Speicher, 50 für 50 % Rechenleistung.
In der bisherigen Architektur arbeiten mehrere Komponenten zusammen:
- Mutating Webhook ändert die Ressourcenkonfiguration des Pods.
- Scheduler Extender plant gemeinsam genutzte Beschleuniger.
- Device Plugin meldet und bindet Geräteressourcen ein.
- HAMi-core erzwingt Speicher- und Rechengrenzen im Container, unter anderem mit
libvgpuundlibvnpu.
Diese Architektur wird produktiv eingesetzt, beruht jedoch auf dem Device Plugin und dem Extended-Resource-Modell und hat damit einige Grenzen.
Herausforderungen der bisherigen Architektur
Quoten erfassen keine feinen Anteile
Die native ResourceQuota kann Anforderungen für Extended Resources wie huawei.com/* zählen, aber nur Summen pro Namespace führen. Sie sieht nicht, wie HAMi Speicher und Rechenleistung einer einzelnen Karte aufteilt. Für eine Begrenzung der tatsächlichen Teamnutzung ist deshalb ein zusätzliches Quotensystem nötig.
Verdrängung ist nicht verfügbar
Planungsfunktionen wie Preemption kennen Entscheidungen eines externen Schedulers nicht. Ein Task mit hoher Priorität kann auf diesem Weg einen Task mit niedriger Priorität nicht verdrängen.
Knotensperren bremsen die Planung
Wenn mehrere Pods gleichzeitig auf demselben Knoten geplant werden, müssen sie unter Umständen nacheinander abgearbeitet werden. Knotensperren können Teile der Zuteilung serialisieren und die Wartezeit verlängern. Bei hoher Clusterlast steigt die Dauer der Pod-Erstellung. Ein fehlgeschlagener Antrag kann einen Knoten fünf Minuten lang sperren; neue Pods auf diesem Knoten warten dann ebenfalls.
Diese Probleme hängen eng mit dem bisherigen Ressourcenmodell und dem Scheduler Extender zusammen. Für eine andere Zuteilung und Planung ist ein neuer Mechanismus erforderlich.
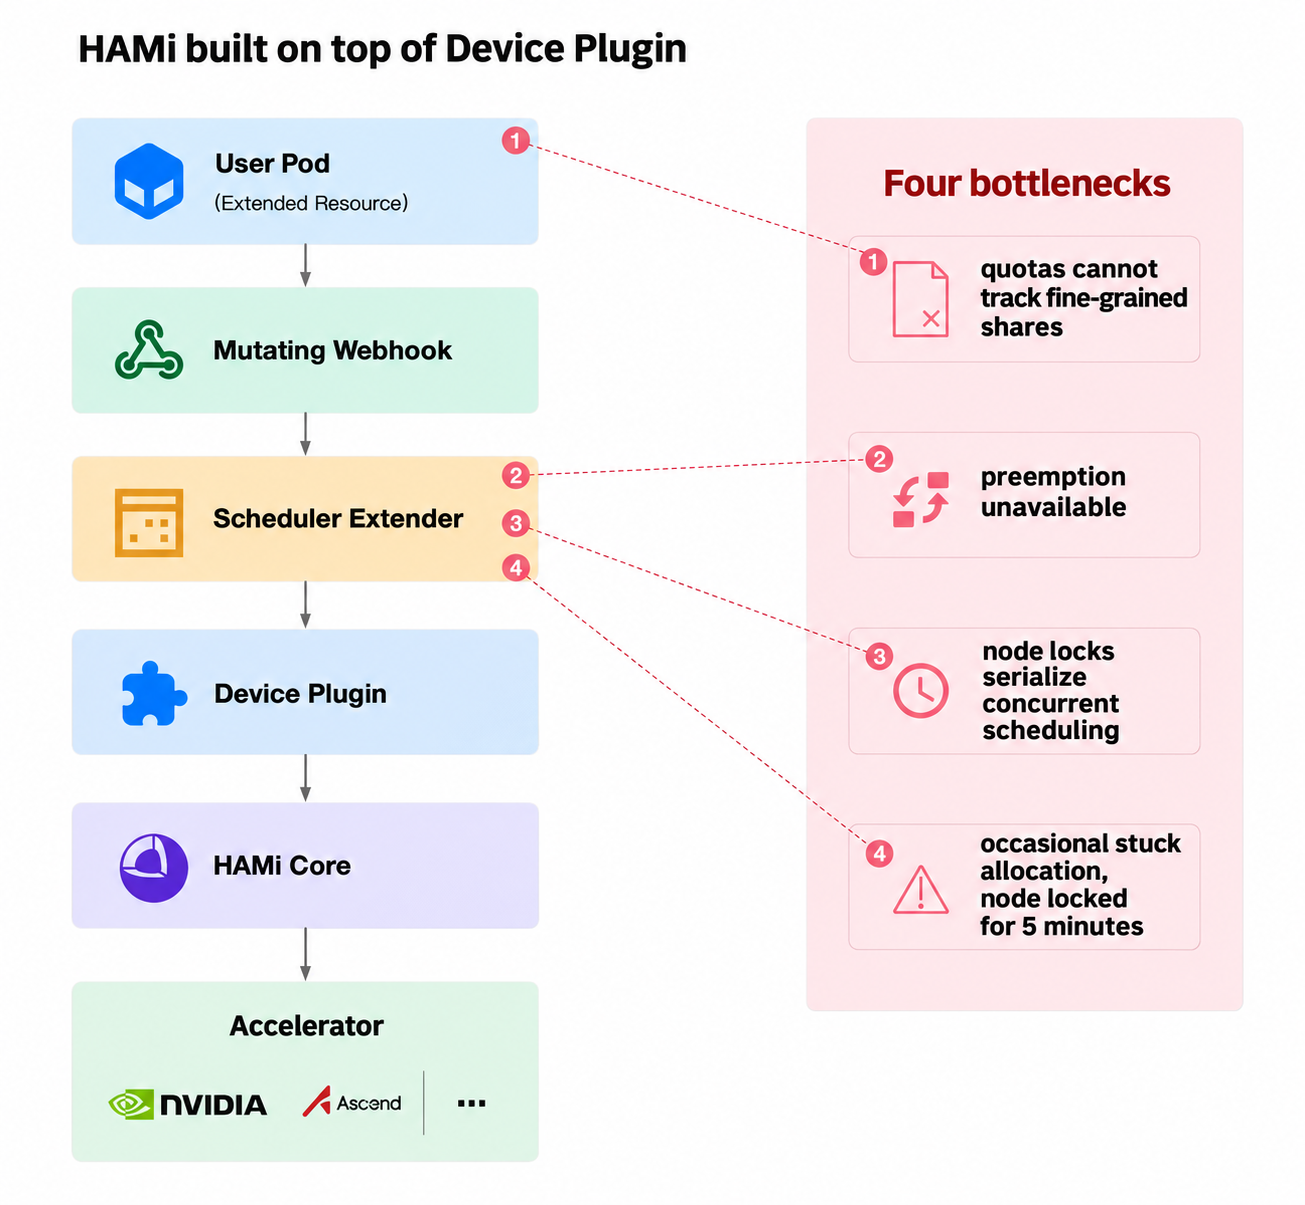
Links ist die von HAMi für die gemeinsame Nutzung selbst aufgebaute Kette vom Pod bis zum Beschleuniger dargestellt. Die gestrichelten Linien markieren vier Engpässe: Der erste betrifft die Ressourcenangabe, bei der native Quoten nur ganze Geräte statt der feinen HAMi-Anteile sehen. Die übrigen drei liegen beim Scheduler Extender. Preemption ist begrenzt, weil HAMi das optionale
preempt-Verb der Extender-API nicht implementiert hat; Knotensperren machen parallele Vorgänge seriell, und ein fehlgeschlagener Antrag kann einen Knoten fünf Minuten sperren.
Was Kubernetes DRA bringt
Mit Kubernetes 1.34 wurden die zentralen APIs für Dynamic Resource Allocation (DRA) allgemein verfügbar. Die Geräteverwaltung entwickelt sich von einer knotenorientierten Zuteilung zu einem deklarativen Modell mit Ressourcenobjekten. Vier Objekttypen stehen im Mittelpunkt:
- ResourceSlice beschreibt Gerätebestand, Eigenschaften und Kapazität.
- ResourceClaim deklariert Gerätebedarf und Einschränkungen eines Pods vor seiner Erstellung.
- DeviceClass dient als Vorlage für Gerätefilterung und Konfiguration.
- ResourceClaimTemplate erzeugt ResourceClaims für Controller wie StatefulSet in größerer Zahl.
Consumable Capacity
Für HAMi ist Consumable Capacity (KEP-5075) die wichtigste Neuerung. Ein Gerät kann mehrere verbrauchbare Kapazitäten wie Speicher und Rechenleistung veröffentlichen. Mit allowMultipleAllocations können mehrere ResourceClaims jeweils einen Anteil desselben Geräts anfordern. kube-scheduler teilt die einzelnen Dimensionen anhand der ResourceSlice zu und verbucht sie.
Unter Kubernetes 1.34 und 1.35 muss das zugehörige Feature Gate manuell aktiviert werden; ab 1.36 ist es standardmäßig aktiv.
Für ein Ascend-310P3-Gerät kann eine ResourceSlice Folgendes enthalten:
# ResourceSlice: ein device pro 310P3 mit zwei Kapazitätsdimensionen
devices:
  - name: npu-0-0
    attributes:
      productName: { string: 310P3 }
      uuid: { string: 68496E64-20E05477-92C31323-6E78030A-BD003019 }
    capacity:
      cores: { value: "100" }
      memory: { value: 21525Mi }
    allowMultipleAllocations: true

# ResourceClaim: Anforderung eines Anteils
capacity:
  requests:
    cores: "50"
    memory: "8589934592"
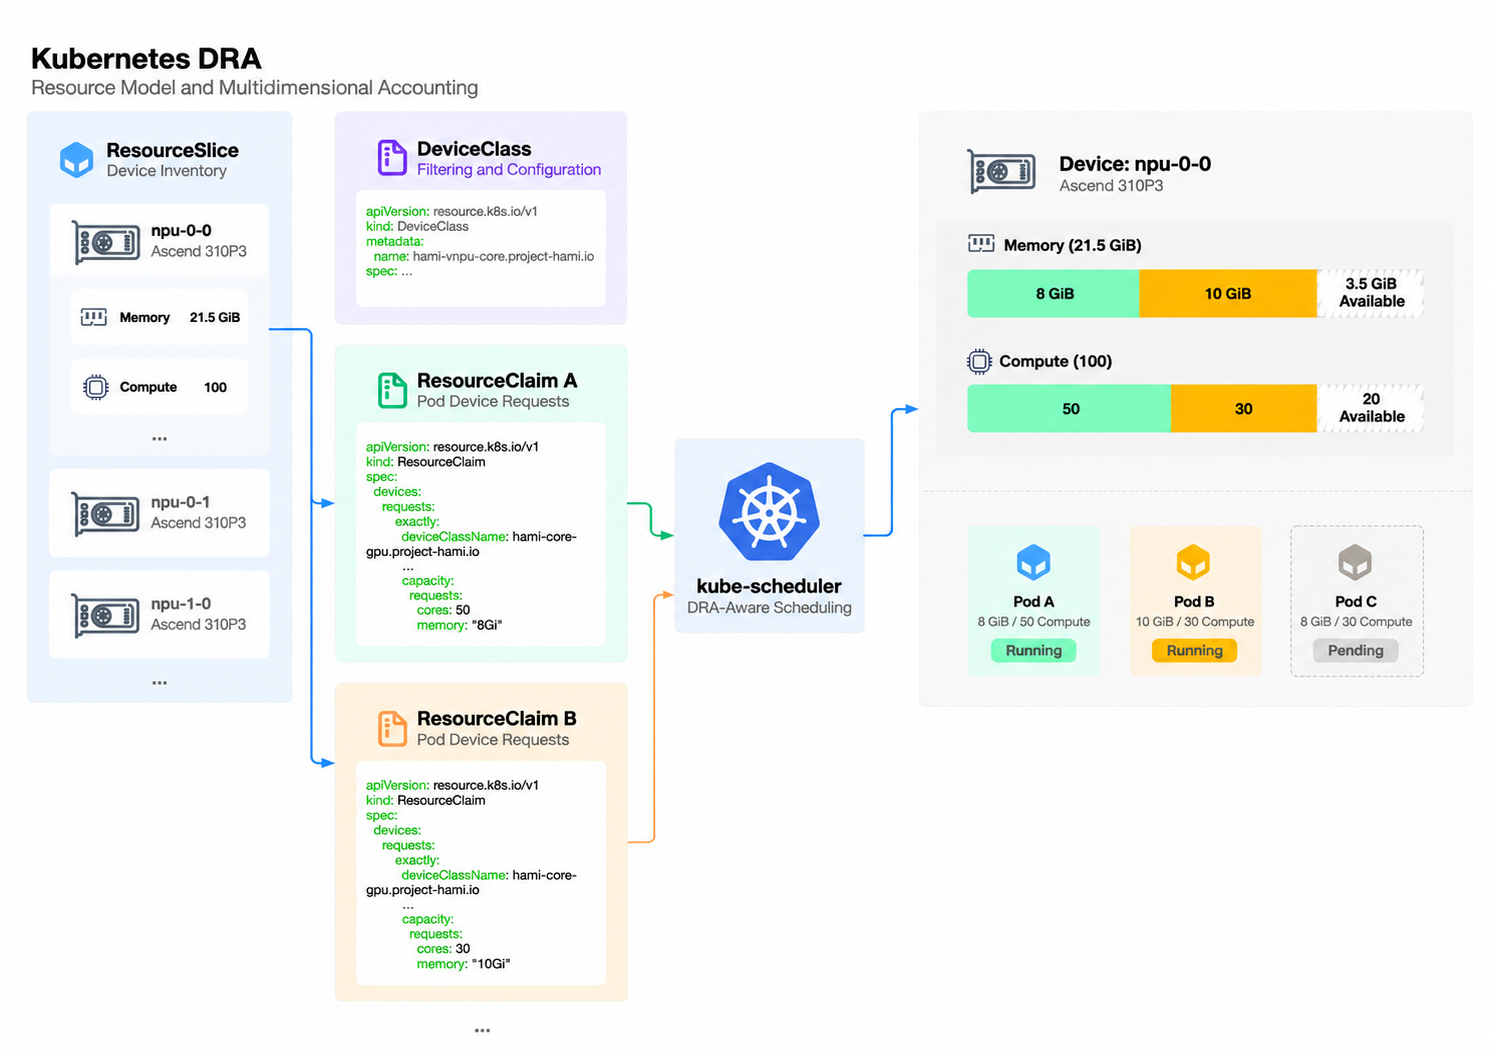
Claim A und B fordern jeweils einen Teil desselben Geräts (
npu-0-0) an.kube-schedulerverbucht jede Dimension gegen die ResourceSlice. Ist die Kapazität ausgeschöpft, bleibt Claim C Pending, bis ein Pod Kapazität freigibt. Das Device Plugin liefert nur einfache Kapazitätsangaben, sodass ein Ressourcenmangel unter Umständen erst nach der Knotenauswahl auffällt. DRA kann Geräteeigenschaften bereits während der Planung abgleichen.
Die Architektur von HAMi-DRA
HAMi-DRA verteilt die Aufgaben neu: Kubernetes-natives DRA übernimmt Planung und Kapazitätsbuchführung, HAMi-core behält die Isolation zur Laufzeit. HAMi muss nicht länger die vollständige Kette für die Planung geteilter Geräte selbst betreiben und kann GPUs, NPUs und andere Beschleuniger auf Grundlage der nativen Kubernetes-Geräteverwaltung feingranular teilen.
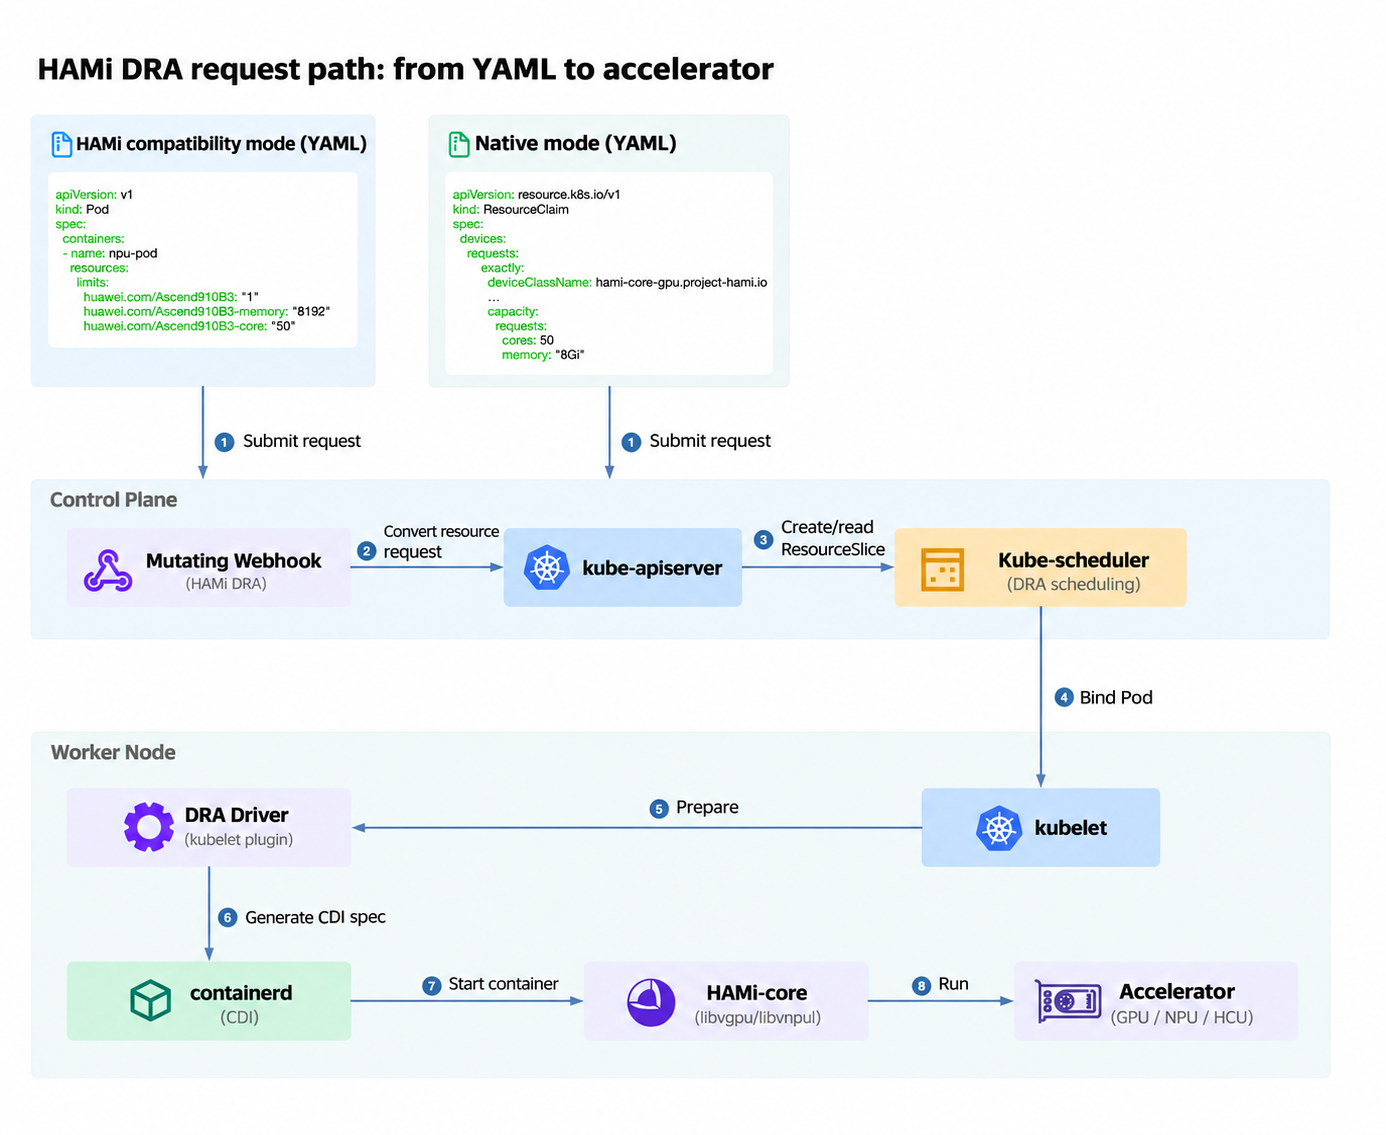
Von der Ressourcenanforderung zum laufenden Container
Der Ablauf beginnt mit dem eingereichten YAML. Im Kompatibilitätsmodus können Nutzer bisherige Ressourcennamen wie huawei.com/Ascend310P beibehalten. Der Mutating Webhook von HAMi-DRA erkennt die Anforderungen bei der Pod-Zulassung und wandelt sie in native ResourceClaims um. Bei direkter DRA-Nutzung wird ein ResourceClaim ohne diesen Schritt eingereicht.
Danach gleicht kube-scheduler Geräteattribute und Kapazitäten aus der ResourceSlice ab, teilt Ressourcen zu, verbucht sie und bindet den Pod an einen Knoten. Dort ruft kubelet die Vorbereitungsschnittstelle des DRA Driver auf. Dieser erzeugt eine CDI-Spezifikation (Container Device Interface) für die Geräteeinbindung. containerd erstellt anhand dieser Konfiguration den Container und bindet libvgpu oder libvnpu von HAMi-core ein.
Der Workload läuft auf einer GPU, NPU, DCU oder einem anderen Beschleuniger; HAMi-core setzt im Container die Speicher- und Rechenquote durch. Die drei Hauptkomponenten übernehmen verschiedene Aufgaben:
- HAMi-DRA Webhook: Umwandlung der Ressourcenangaben und Verwaltung des ResourceClaim-Lebenszyklus.
- DRA Driver: Geräteerkennung, Veröffentlichung von Ressourcen sowie Vorbereitung und Bereinigung auf dem Knoten.
- HAMi-core: gemeinsame Nutzung, Quoten und Isolation zur Laufzeit.
Webhook: Herkömmliche HAMi-Anforderungen in DRA umwandeln
Automatische Umwandlung mehrdimensionaler Anforderungen
Bisher verwendet HAMi mehrere ResourceNames für Gerätezahl, Speicher und Rechenleistung. Für Ascend sind dies huawei.com/Ascend310P, huawei.com/Ascend310P-memory und huawei.com/Ascend310P-core; NVIDIA verwendet nvidia.com/gpu zusammen mit Namen wie gpumem und gpucores.
Der Webhook ordnet diese Angaben den Feldern count und capacity.requests des ResourceClaim zu. Auswahl-Annotationen wie use-*-uuid werden zu CEL-Selektoren (Common Expression Language), mit denen Kubernetes die in ResourceSlice veröffentlichten Geräteattribute abgleichen kann.
Lebenszyklus des ResourceClaim
Der Webhook erstellt den passenden ResourceClaim und verknüpft ihn mit dem Pod. Beim Löschen des Pods wird sein Claim automatisch bereinigt. HAMi-DRA enthält keinen eigenständigen Scheduler mehr: Kubernetes übernimmt die Planung und schafft damit eine Grundlage für die Zusammenarbeit mit Projekten wie Volcano.
DRA Driver: Geräteinformationen und Lebenszyklus
Der DRA Driver erkennt Beschleuniger und veröffentlicht Attribute und verfügbare Kapazität über ResourceSlice. So kennt der Scheduler die Geräte vor der Zuteilung.
Nach der Zuteilung ruft kubelet NodePrepareResources auf. Zur Vorbereitung gehören Umgebungsvariablen, gemeinsame Verzeichnisse und die CDI-Konfiguration. Nach der Nutzung bereinigt der Driver Ressourcen und über UnprepareResourceClaims auch temporäre Dateien von HAMi-core. Im Vergleich zum Device Plugin sind Vorbereitung und Freigabe damit klarer in den Ressourcenlebenszyklus eingebunden. Die standardisierte CDI-Schnittstelle verbindet die Geräteeinbindung mit Laufzeitumgebungen wie containerd.
HAMi-core: Isolation innerhalb des Containers
DRA bestimmt Gerät sowie zugeteilten Speicher und Rechenanteil, erzwingt diese Grenzen aber nicht im Container. Dafür verwendet HAMi-core weiterhin libvgpu, libvnpu und verwandte Komponenten.
DRA teilt Ressourcen zu; HAMi-core sorgt dafür, dass Workloads die Zuteilung einhalten. Dies ist auch der Kern des Community-Beitrags Wird Kubernetes DRA HAMi ersetzen?: Beide wirken auf unterschiedlichen Ebenen.
Planungsleistung und Beobachtbarkeit
Früher koordinierte HAMi die gemeinsame Zuteilung mit Scheduler Extender und Knotensperren. Bei parallelen Anforderungen für denselben Knoten konnten Sperren die Planung serialisieren und die Pod-Erstellungszeit mit der Zahl gleichzeitiger Anforderungen annähernd linear steigern lassen. Die native DRA-Zuteilung vermeidet einen Teil dieses Aufwands.
In einem internen Community-Test mit paralleler Planung auf demselben Knoten war die Pod-Erstellung mit HAMi-DRA deutlich schneller. DRA teilt Geräte schon in der Planungsphase zu und verbucht sie, sodass spätere Konflikte und Wiederholungen seltener werden. Das Ergebnis stammt aus einem bestimmten internen Test und lässt sich nicht unverändert auf alle Cluster oder Workloads übertragen.
Architektonisch zeigen sich vier Änderungen:
| Bisheriges HAMi | HAMi-DRA | Wesentliche Änderung |
|---|---|---|
| NodeLock | No Locks | Keine Abhängigkeit mehr von der bisherigen Knotensperre für die gemeinsame Zuteilung |
| ResourceName | ResourceClaim | Gerätebedarf wird durch native Ressourcenobjekte ausgedrückt |
| Device Plugin | DRA Driver | Vorbereitung und Lebenszyklus der Geräte laufen über DRA |
| Annotation | Attributes | Geräteattribute und Selektoren beschreiben Einschränkungen |
Auch die Beobachtbarkeit verbessert sich. Bisher stammten Geräteinformationen hauptsächlich aus Node; für die Workload-Nutzung mussten Pod-Konfiguration und Laufzeitstatus zusammengeführt werden. DRA beschreibt Bestand und Kapazität mit ResourceSlice und Bedarf sowie Zuteilung mit ResourceClaim. Betriebsteams können diese Objekte abfragen und sehen, welchen Workloads Geräte und Kapazitäten zugewiesen wurden und wie viel noch frei ist. Die Zuteilungsbeziehungen werden Teil des nativen Kubernetes-Ressourcenmodells.
Zwei Betriebsarten: native Möglichkeiten und Migrationsaufwand
DRA kann Geräte genauer beschreiben, macht Ressourcenangaben aber komplexer. Im Device-Plugin-Modus reicht die Gerätezahl im Pod:
resources:
  limits:
    nvidia.com/gpu: 1
Im nativen DRA-Modus beschreibt meist ein eigener ResourceClaim den Bedarf mit count und capacity.requests, zum Beispiel:
spec:
  devices:
    requests:
      - exactly:
          allocationMode: ExactCount
          count: 1
          capacity:
            requests:
              memory: 4194304k
CEL-Selektoren können Geräteeigenschaften einschränken. Für Unternehmen mit umfangreicher Device-Plugin- oder HAMi-Nutzung entstehen dadurch YAML-Änderungen und Lernaufwand zu ResourceClaim, Geräteauswahl und Lebenszyklus. HAMi-DRA bietet deshalb einen nativen DRA-Modus und einen Device-Plugin-Kompatibilitätsmodus.
Nativer DRA-Modus
Nutzer erstellen ResourceClaims für Gerätezahl, Speicher und Rechenleistung und verweisen aus Pods über resourceClaims darauf. CEL-Selektoren können Modell, Topologie, NUMA-Affinität und andere Attribute berücksichtigen; auch andere Gerätearten wie Netzwerkkarten können dieses Modell nutzen. Mit firstAvailable lassen sich auf unterstützten Kubernetes-Versionen alternative Zuteilungen formulieren. Der Modus eignet sich für neue Workloads und Cluster, die deklarative Verwaltung und Attributabgleich umfassend nutzen wollen.
Device-Plugin-Kompatibilitätsmodus
Bestehende Workloads behalten Angaben wie nvidia.com/gpu oder huawei.com/Ascend310P. Der Webhook wandelt sie bei der Zulassung um; nicht jeder Workload muss einzeln auf native DRA-Angaben umgeschrieben werden.
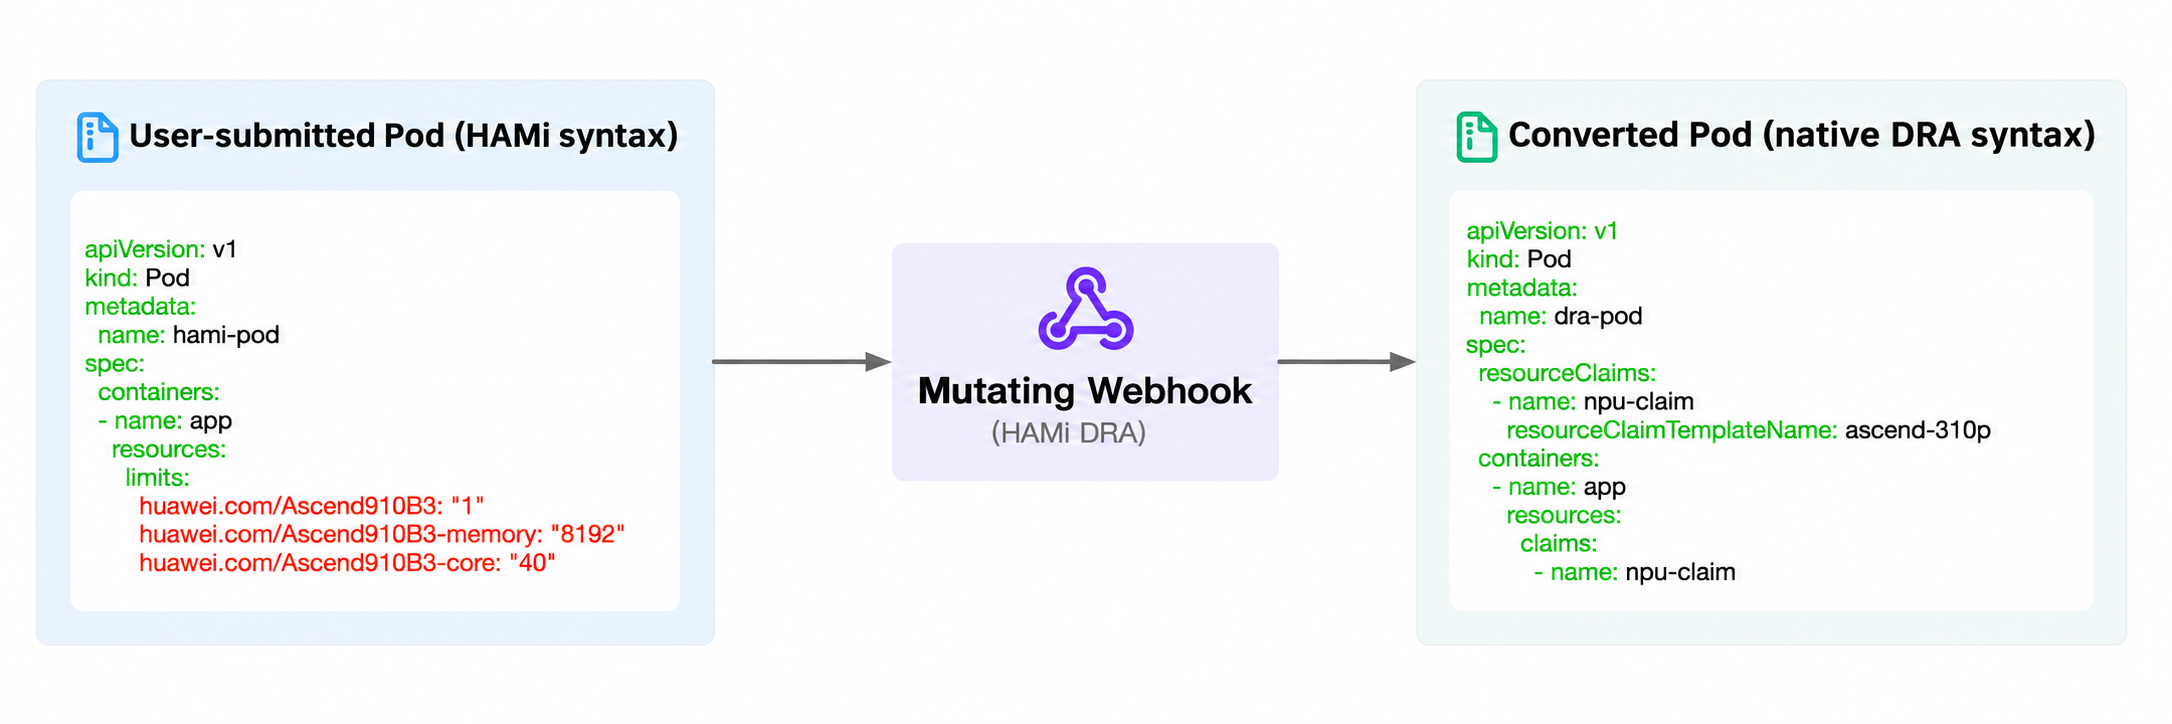
Ein Ascend-310P-Pod kann Folgendes anfordern:
resources:
  limits:
    huawei.com/Ascend310P: 1
    huawei.com/Ascend310P-memory: "8192"
    huawei.com/Ascend310P-core: "50"
Der Webhook erkennt die drei huawei.com/*-Einträge, erzeugt DRA-Angaben und verknüpft den Claim mit dem Pod. Die Gerätezahl wird zu count, Speicher und Rechenleistung zu capacity.requests, Auswahlanmerkungen zu CEL-Selektoren. Die Regeln lauten:
| ResourceClaim-Feld | Ursprüngliche HAMi-Anforderung | Umwandlung |
|---|---|---|
count: 1 | Ascend310P: 1 | Gerätezahl unverändert übernehmen |
capacity.requests.memory: 8589934592 | -memory: 8192 (MiB) | MiB in Byte umrechnen: 8192 × 1024 × 1024 |
capacity.requests.cores: "50" | -core: 50 | Prozentwert der Rechenleistung übernehmen |
| CEL-Selektor | Annotation use-Ascend310P-uuid | Zu uuid in ["..."] umwandeln und Geräte-UUID in ResourceSlice abgleichen |
Der Claim bleibt mit dem Pod verknüpft und wird bei dessen Löschung freigegeben. Die Änderung des zugrunde liegenden Modells bleibt so weitgehend in der Infrastruktur. Dennoch müssen Kubernetes-Version, DRA Driver, HAMi-core und weitere Komponenten passen.
Ascend-310P-Versuch: Zuteilung und Isolation
In einem Community-Versuch forderten zwei Pods jeweils 8192 MiB Speicher und 50 % Rechenleistung derselben NPU an. Nach der Webhook-Umwandlung wurden beide ResourceClaims demselben Gerät zugewiesen, jeweils mit eigener shareID. kube-scheduler verbuchte den ersten Claim, bevor er den zweiten bewertete. Nach beiden Zuteilungen war die Rechenkapazität mit 100/100 ausgeschöpft. Ein dritter Workload mit weiteren 50 % blieb Pending, obwohl noch Speicher frei war. Beim Löschen eines Pods wurde sein Claim zurückgegeben und die Kapazitätsbuchführung aktualisiert.
Zuteilung ist nicht gleich Laufzeitisolation
Im Container erzwingt HAMi-core mit libvnpu.so das Speicherlimit. Anforderungen über der Grenze werden abgefangen und können als OOM im Container erscheinen. Im Versuch sah jeder Container nur die zugewiesenen 8 GiB statt der gesamten rund 21 GiB der NPU. Damit wird das Zusammenspiel nativer DRA-Buchführung und HAMi-core-Isolation gezeigt.
Vollständige Befehle, Zuteilungen und Ausgaben stehen im Community-Tutorial Experiment 21: Ascend-NPU mit HAMi DRA teilen.
Stand der Unterstützung heterogener Geräte
Die Möglichkeiten von HAMi-DRA hängen stark von den DRA Drivern der Hersteller ab:
- September 2025: NVIDIA DRA Driver mit Consumable Capacity einsatzbereit.
- März 2026: Integration des Hygon DCU DRA Driver mit HAMi DRA abgeschlossen.
- April 2026: Integration des Enflame DRA Driver in Arbeit.
Diese Fortschritte schaffen eine Grundlage für weitere Geräte. Integration, experimentelle Prüfung und Produktionsreife müssen jedoch für jedes Gerät getrennt beurteilt werden.
Ascend NPU
Der Ascend DRA Driver ist ein wichtiges Beispiel. In Experiment 21 nutzte die Community einen Server mit Ascend 310P3 und den offiziell gepflegten Project-HAMi/ascend-dra-driver. Sie prüfte die vollständige Kette von der HAMi-Anforderung über native DRA-Zuteilung bis zur gemeinsamen NPU-Nutzung. Die Driver-Chart-Version war 0.1.1.
Das Experiment verwendete ein Entwicklungs-Image mit Korrektur für die UUID-Erzeugung; Verhalten und Implementierung können sich vor der offiziellen Veröffentlichung ändern. Die Release Notes zu HAMi v2.10.0 verwiesen im August 2026 für Ascend-DRA-Unterstützung auf dieses Repository; der Driver selbst war noch eine Vorabversion.
Praktische Grenzen vor der Einführung
Kubernetes-Version und Funktionen
Consumable Capacity benötigt mindestens Kubernetes 1.34; andere DRA-Funktionen können neuere Versionen voraussetzen. Die Standardeinstellungen der Feature Gates unterscheiden sich. Bei einem älteren Produktionscluster müssen beim Upgrade auch Scheduler, Treiber, Netzwerk und andere Komponenten auf Kompatibilität geprüft werden.
Begrenzte Unterstützung durch Hersteller-Driver
Für einzelne Geräte gibt es noch wenige direkt nutzbare DRA Driver, deren Reife variiert. Unterstützung für DRA-Angaben und Zuteilung bedeutet nicht automatisch, dass feingranulare Teilung, Isolation und der gesamte Lebenszyklus produktiv validiert sind. Driver, DRA-Funktionen und HAMi-core müssen gemeinsam bewertet werden.
Komplexere Geräteplanung
DRA kann Geräteeigenschaften und Kapazitäten während der Planung abgleichen; weitergehende Optimierungen wie Scoring auf Geräteebene sind noch begrenzt.
Lern- und Wartungsaufwand
ResourceSlice, ResourceClaim, DeviceClass, Selektoren sowie Vorbereitung und Freigabe bringen neue Konzepte für Betrieb und Plattformentwicklung. Der Webhook-Kompatibilitätsmodus verringert den Migrationsaufwand für Anwendungen, beseitigt aber den Lernaufwand für Installation und Wartung nicht.
Die passende Variante wählen
Traditionelles HAMi und HAMi-DRA eignen sich für unterschiedliche Umgebungen. Maßgeblich sind Clusterarchitektur, Planungsanforderungen und Geräteunterstützung.
Standardisierte Kubernetes-Cluster
Wenn Optimierungen wie topologiebewusste Planung besonders wichtig sind, empfiehlt sich zunächst traditionelles HAMi mit seinen ausgereiften Planungsfunktionen.
Stark angepasste Cluster
Wenn bereits ein eigener Scheduler läuft oder die Gerätefreigabe über Kubernetes-natives DRA erfolgen soll, kann HAMi-DRA zuerst geprüft werden.
Dabei sind zwei Punkte wichtig: Eine Ressourcenanforderung darf nicht zugleich beide Zuteilungspfade durchlaufen. Traditionelles HAMi und HAMi-DRA können im selben Cluster nebeneinander bestehen, wenn die Webhook-Ausnahme aus Experiment 21 doppelte Verarbeitung verhindert.
DRA deklariert, plant und teilt Ressourcen zu; HAMi-core erzwingt weiterhin Speicher- und Rechenquoten im Container. Beide Wege bedienen unterschiedliche Clusteranforderungen.
Ausblick
HAMi-DRA soll weitere Geräte wie MetaX und Iluvatar CoreX unterstützen, DRA-Funktionen wie List Attributes und Partitionable Devices untersuchen und standardisierte Kubernetes-Geräteattribute wie resource.kubernetes.io/pcieRoot besser nutzen. Auch die Integration mit Volcano und Kueue soll ausgebaut werden.
HAMi verwaltet heterogene GPUs und NPUs für KI-Training, Inferenz und Agent-Workloads. Ressourcenabstraktion, Planung und Virtualisierung verbinden dabei Hardware und Anwendungen. HAMi-DRA ist ein wichtiger Schritt dieser Entwicklung: Mit Kubernetes DRA für Deklaration, Zuteilung und Planung kann HAMi sich stärker auf Laufzeitisolation und heterogene Geräte konzentrieren, feingranulare Teilung erhalten und weniger zusätzliche Scheduler-Erweiterungen benötigen.
Wer eine Migration vom Device-Plugin-Modell zu DRA prüft oder eine einheitliche Ressourcenverwaltung für heterogene Cluster sucht, kann HAMi DRA ausprobieren und der Community Rückmeldung geben.