

Dynamia Case Study|Wie iFLYTEK F&E- und Online-Workloads Compute teilen lässt
 Fallstudien
iFLYTEK behielt bestehende Workflows wie Airflow und Spark und nutzte Kubernetes, Volcano und HAMi-Core für gemeinsam genutzte GPUs – mit Ressourcengarantien für kritische Services und bedarfsgerechter Nutzung freier Kapazität für F&E-Jobs.
Auf dieser Seite
Als Technologieunternehmen mit Schwerpunkt intelligente Sprache und künstliche Intelligenz spannt iFLYTEKs Geschäft Bildung, Gesundheitswesen, Smart Cities und mehr ab. Die KI-Plattform dahinter muss nutzerseitige Inferenzdienste ebenso betreiben wie Datenverarbeitung, Modelltraining, F&E-Experimente und weitere Workloads.
Unterschiedliche Workloads haben unterschiedliche Rechenbedarfe: Online-Services brauchen stabile Garantien, F&E-Teams wollen GPUs schnell für Experimente und Modellvalidierung. Teilen sie denselben Rechenpool, wird kritische Services stabil halten und gleichzeitig freie GPUs besser nutzen zur zentralen Plattform-Herausforderung.
iFLYTEK behielt Workflows wie Airflow und Spark und kombinierte Kubernetes, Volcano und HAMi-Core zu einem GPU-Ressourcenmanagement, das Garantien und elastisches Teilen ausbalanciert.
In diesem System liefert HAMi – initiiert und fortlaufend gepflegt vom Dynamia-Kernteam – feingranulare Kontrolle über GPU-Speicher und -Rechenleistung, damit vorhandene GPUs nach Workload-Bedarf zugewiesen werden und Multi-Workload-Sharing auf der Plattform fundiert ist.
Warum Multi-Workload-GPU-Sharing schwierig ist
Für iFLYTEK geht es beim GPU-Teilen nicht nur um Flexibilität, sondern um drei konkrete Probleme.
- Unterschiedliche Ressourcenbedarfe. Online-Inferenz braucht stabile Garantien; F&E nutzt freie Kapazität flexibel. Feste GPU-Partitionierung lässt Ressourcen idle; völlig offenes Teilen gefährdet kritische Services.
- Bestehende Prozesse bleiben. Airflow, Spark und ähnliche Tools tragen große Teile der Geschäftsprozesse. GPU-Sharing nur durch Neubau von Einstiegspunkten oder Migrations der Orchestrierung würde Änderungskosten und Risiko erhöhen.
- Teilen erhöht Komplexität. Ausleihe und Rückgabe, gegenseitige Störungen und Nachvollziehbarkeit bei Ausfällen brauchen klare Regeln und Laufzeitprotokolle.
iFLYTEK behielt den Business-Stack und nutzte Task-Scheduling plus feingranulare GPU-Kontrolle, um Compute flexibler zuzuweisen – mit Garantien für kritische Services und elastischer F&E-Nachfrage.
Workflows behalten, GPUs bedarfsgerecht zuweisen
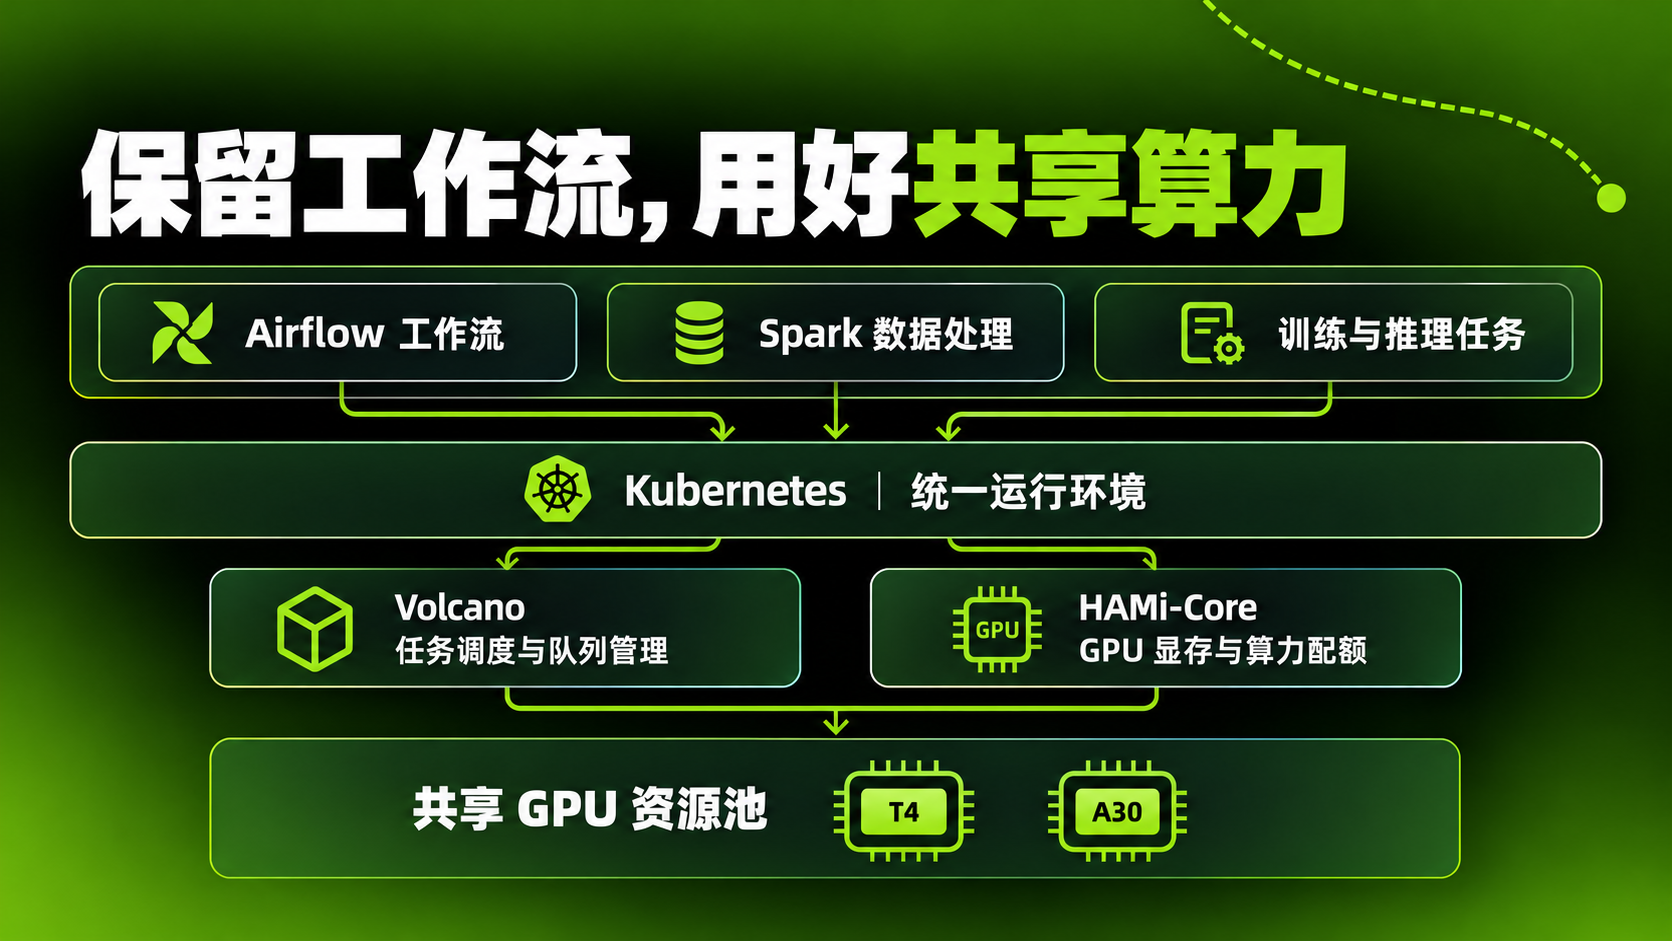
Geschäftsseitig blieb die Workflow-Orchestrierung; unterliegende Jobs laufen in einer einheitlichen Kubernetes-Laufzeit. Ingenieure können Validierung an definierten Workflow-Knoten mit Teilmengen der Daten starten – ohne jedes Mal die gesamte Pipeline neu zu fahren.
Ressourcenseitig nutzt die Plattform eine geschichtete Architektur: Kubernetes für die Laufzeit, Volcano für Queues und Job-Scheduling, HAMi-Core für GPU-Speicher und -Rechen pro Job.
Volcano steuert Ressourcenzugang; HAMi-Core begrenzt die Nutzung auf einer geteilten GPU. Gemeinsam geht die Zuweisung über Ganzkartenbelegung zu feingranularer Quotenverwaltung nach Job-Bedarf.
Damit ist GPU-Management nicht mehr auf Ganzkarten beschränkt: Im Business-Rahmen lassen sich feinere Quoten pro Workload setzen.
In der Praxis band iFLYTEK GPUs wie T4 und A30 in F&E-Szenarien ein und nutzte HAMi-Core, damit Jobs diese Geräte flexibler nutzen.
So blieben die ursprünglichen Workflows erhalten, GPU-Sharing wurde in den bestehenden Scheduling-Stack integriert, Business-Änderungen sanken – und vorhandene Compute-Ressourcen wurden flexibler nutzbar.
Garantien für kritische Workloads, elastischer Zugang für F&E
Wenn GPUs geteilt werden, bleibt die Frage: Wie idle Kapazität nutzen, ohne wichtige Workloads zu gefährden?
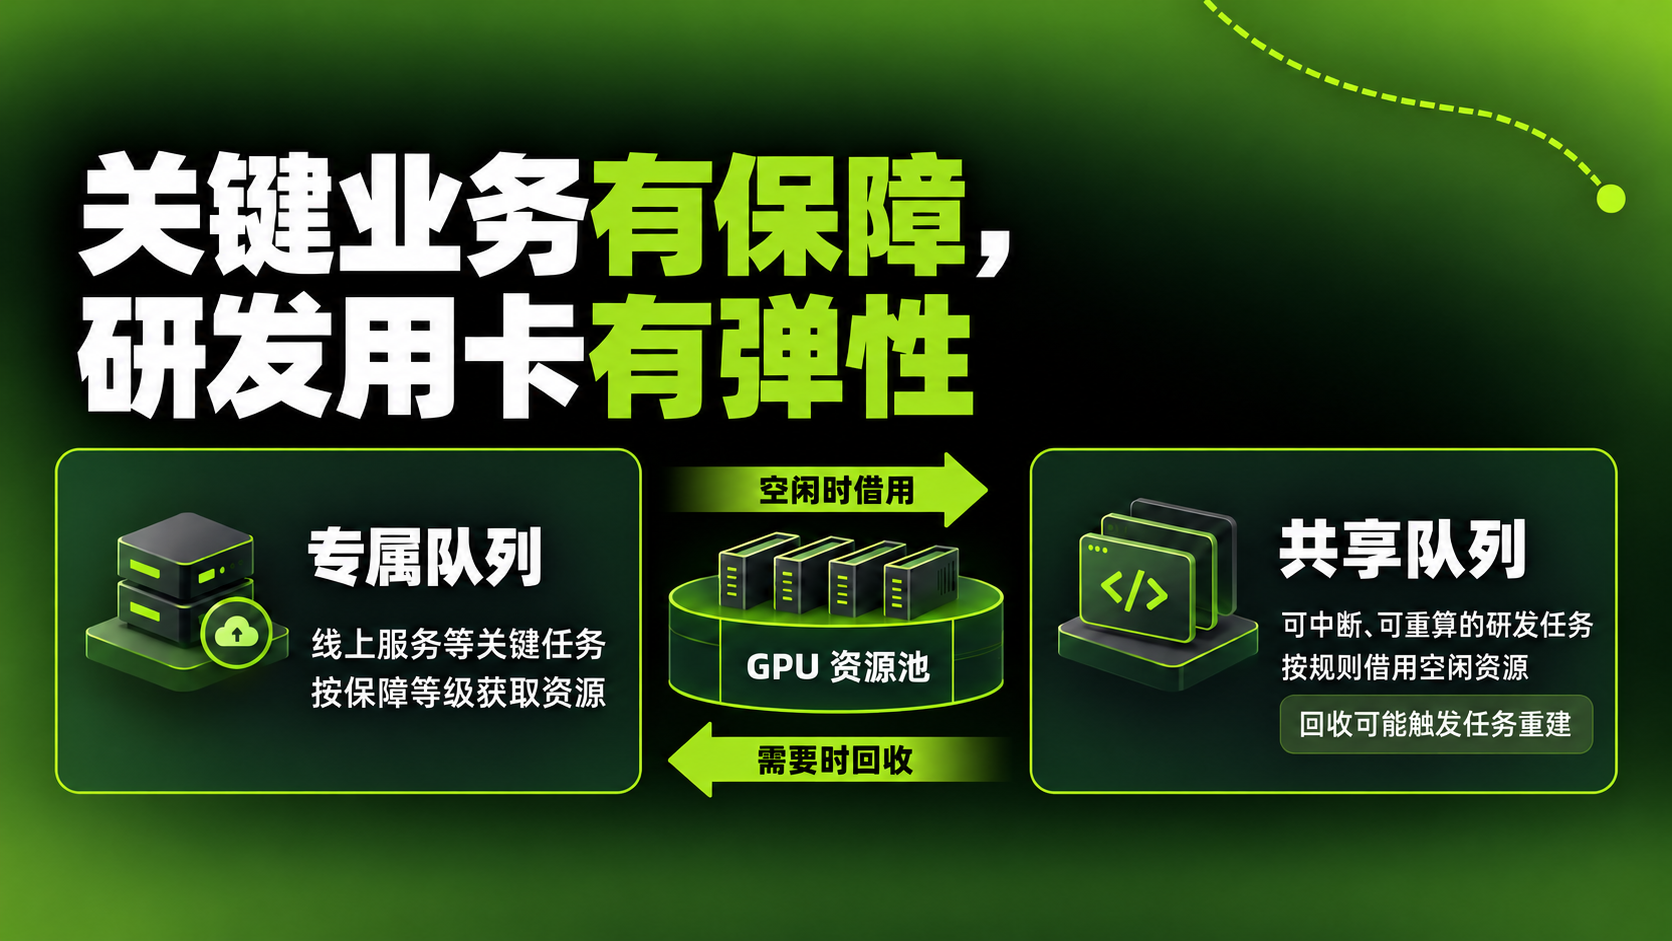
Online-Inferenz braucht kontinuierliche stabile Versorgung; manche F&E-Jobs tolerieren Unterbrechung oder Neustart. iFLYTEK nutzte dedizierte und gemeinsame Queues mit Mindestgarantien, Maximalquoten und Gewichten.
Kritische Workloads erhalten Garantien; unterbrechbare F&E-Jobs können freie Kapazität ausleihen. Bei Rücknahme passt die Plattform nach Queue-Regeln zu – Teilen mit klaren Prioritäten: kritische Jobs schützen, Flexibilität für vorhandene Compute verbessern.
Elastisches Teilen hat Grenzen. Rücknahme kann Eviction und Rebuild auslösen; Regeln müssen Unterbrechbarkeit und Neuberechnung abbilden. HAMi-Cores Userspace-Limits sind nicht gleichbedeutend mit Hardware-Fehlerisolation; bei geteilter GPU sind Störungen und Ausfallwirkungen zu bewerten.
Damit Sharing-Regeln langfristig greifen, verbesserte iFLYTEK GPU-Observability und Nachverfolgbarkeit.
Die Plattform integriert Monitoring wie DCGM und DCMI, GPU-zu-Pod-Mapping und protokolliert Lebenszyklus-Ereignisse. Das hilft bei Nutzung, Anomalien, Preemption und Kostenverteilung.
Über Queue-Management, feingranulare Kontrolle und Monitoring wurde GPU-Sharing von simpler Zuweisung zu Ressourcen-Governance nach Geschäftsbedarf erweitert.
Sharing in den bestehenden Enterprise-Stack integrieren
iFLYTEKs Praxis zeigt: Mit reifen Workflows und Infrastruktur muss GPU-Sharing nicht alles neu bauen. Eine Schichtenarchitektur verbindet Scheduling und feingranulare Kontrolle schrittweise mit bestehenden Systemen.
Workflows bleiben; GPUs wie T4 und A30 dienen F&E feiner; kritische vs. elastische Workloads nutzen Ressourcen nach Garantiebedarf; Laufzeitprotokolle unterstützen Troubleshooting und Quotenanpassung.
Das zeigt HAMis Wert im Unternehmenseinsatz: feingranulares GPU-Sharing mit bestehenden Schedulern, Workflows und Regeln. Bei iFLYTEK teilen sich HAMi-Core und Volcano die Zuständigkeiten für In-GPU-Kontrolle im Job-Scheduling.
Dynamia baut weiter auf HAMis Sharing und Governance, bleibt offen und neutral und arbeitet mit Hardware-, Scheduling- und Anwendungsökosystemen – damit mehr Unternehmen Compute flexibler und beherrschbar nutzen.