

Jede GPU optimal nutzen: Dynamia teilt Praxis auf ContainerDays Singapore
 Community
Auf ContainerDays & AI Context Singapore 2026 präsentierte Dynamia HAMi-Praktiken für GPU-Sharing und Scheduling in Kubernetes durch Hands-on-Labs und Produktionsfälle sowie GPU-Auslastungsoptimierung für Neocloud-Szenarien.
Auf dieser Seite
Am 27. Oktober eröffnete ContainerDays & AI Context Singapore 2026 im Suntec Singapore. Die Konferenz fokussierte Cloud Native, KI-Infrastruktur und Platform Engineering und zog Entwickler und Praktiker weltweit an.
Dynamia Open Source Ecosystem VP Jimmy Song und Global Marketing & Solutions Engineering Lead Reza Jelveh hielten zwei HAMi-Fokusvorträge — zu GPU-Sharing und Scheduling in Kubernetes sowie zu GPU-Auslastung in Neocloud-Szenarien.
Eine Session startete mit Hands-on-Labs, die andere mit Produktionsfällen. Gemeinsam zeigten die Speaker HAMis Fähigkeiten und Anwendung in KI-Infrastruktur aus unterschiedlichen Blickwinkeln.
Von null an: Hands-on GPU-Sharing und Scheduling
Vortragstitel: From Zero to Shared GPUs: Hands-on GPU Scheduling in Kubernetes with HAMi
Speaker: Reza Jelveh, Jimmy Song
Zeit: 27. Oktober, 12:30–13:15
Ort: Workshop Room
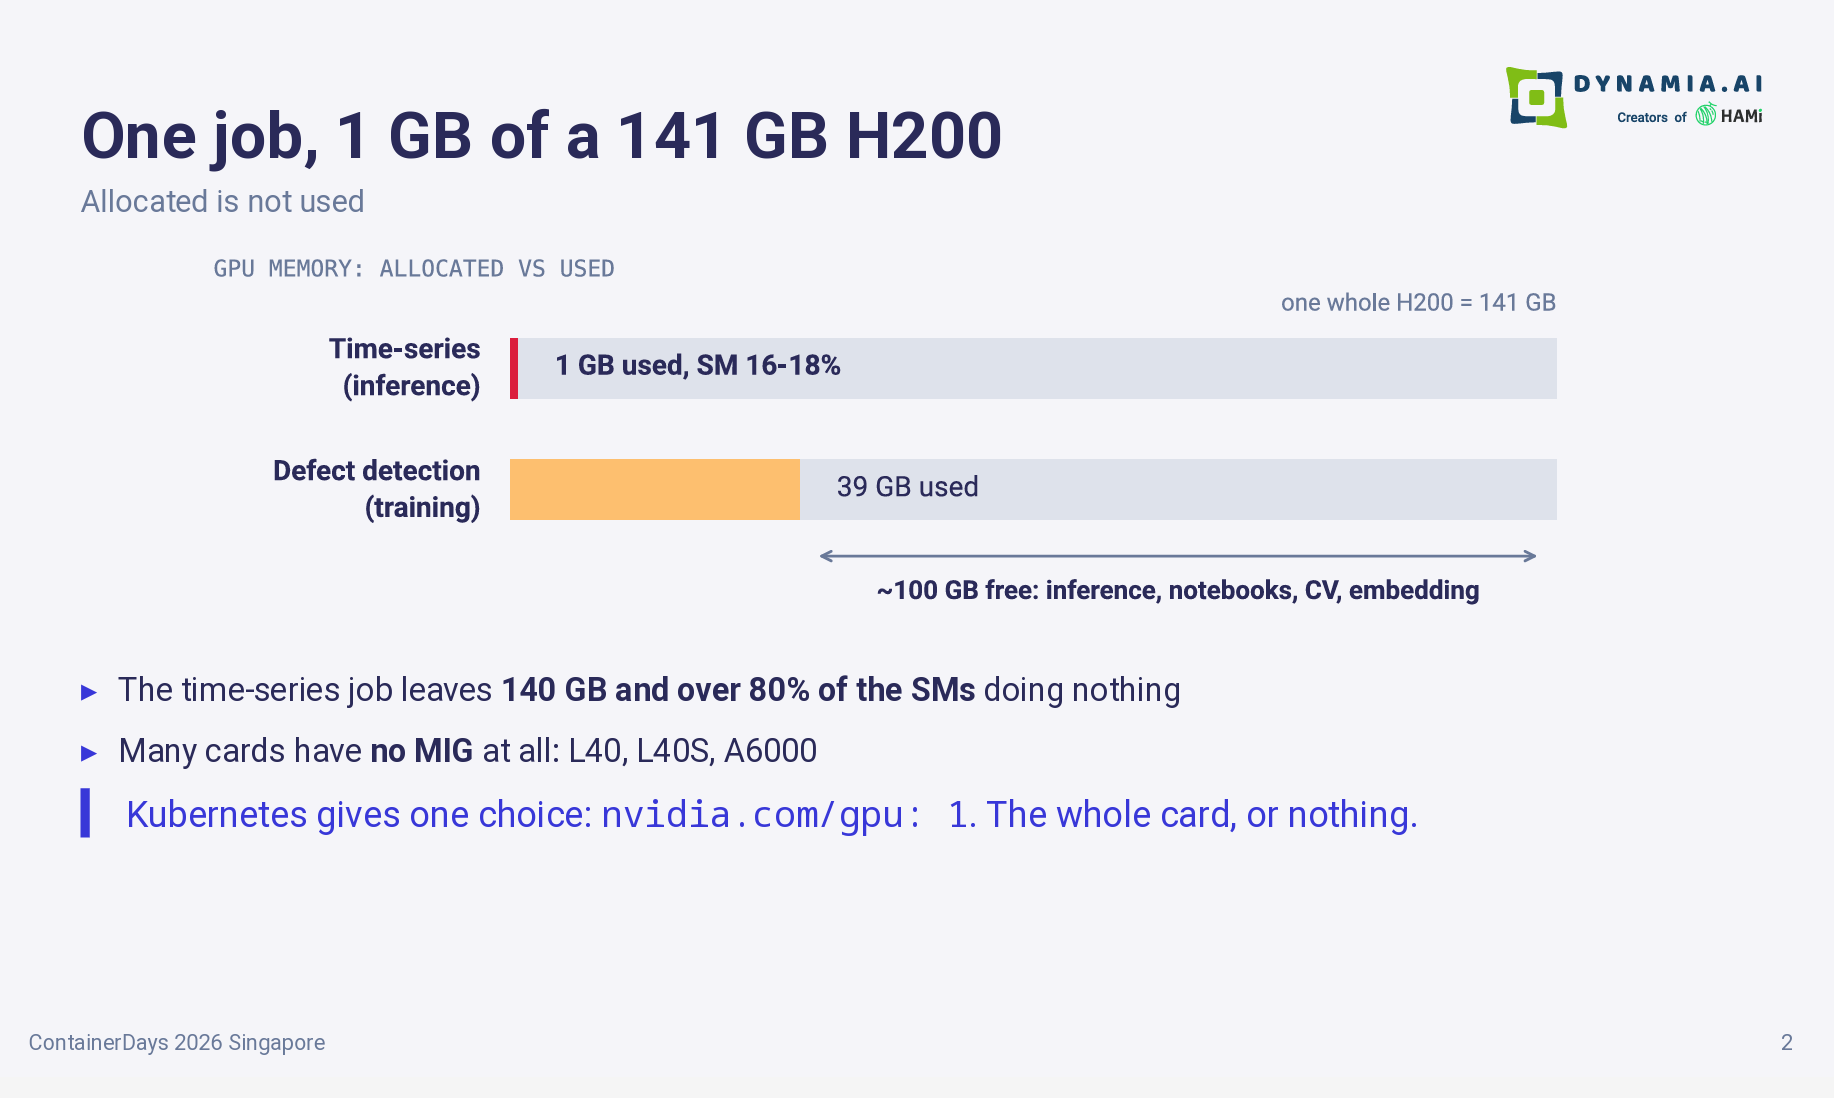
In Kubernetes werden GPUs oft als ganze Geräte zugewiesen. Workloads unterscheiden sich: manche brauchen wenig Speicher, andere eine volle GPU. Ganzgeräte-Zuweisung führt zu Belegung bei gleichzeitiger Unterauslastung.
Wie können mehrere Jobs eine GPU teilen und trotzdem den benötigten Speicher und die Rechenleistung erhalten?
In diesem 45-minütigen Workshop führten die Speaker durch die HAMi-Bereitstellung von Grund auf und vermittelten GPU-Sharing und Scheduling in Kubernetes durch Praxis.
Zur Senkung der Hürde nutzte das Workshop einen lokalen kind-Cluster mit simulierten GPUs. Ohne GPU-Laptop konnten Teilnehmer einen echten HAMi-Scheduler betreiben und GPU-Anfrage und -Zuweisung beobachten.
Das Lab startete mit HAMi-Installation, zeigte gemeinsame GPU-Nutzung mehrerer Pods und Scheduler-Verhalten, wenn ein Job mehr verlangt als eine GPU bietet.
Anschließend verglichen die Speaker Binpack und Spread sowie unterschiedliche Zuweisungsergebnisse.
- Binpack packt Jobs eher auf weniger GPUs und lässt mehr intakte Kapazität für spätere große Jobs;
- Spread verteilt Jobs auf verschiedene GPUs. Beide Policies passen zu unterschiedlichen Workloads und sollten nach realem Bedarf gewählt werden.
Über diese Labs sahen Teilnehmer, wie GPU-Ressourcen zugeteilt werden und wie Scheduling-Policies die Platzierung beeinflussen.
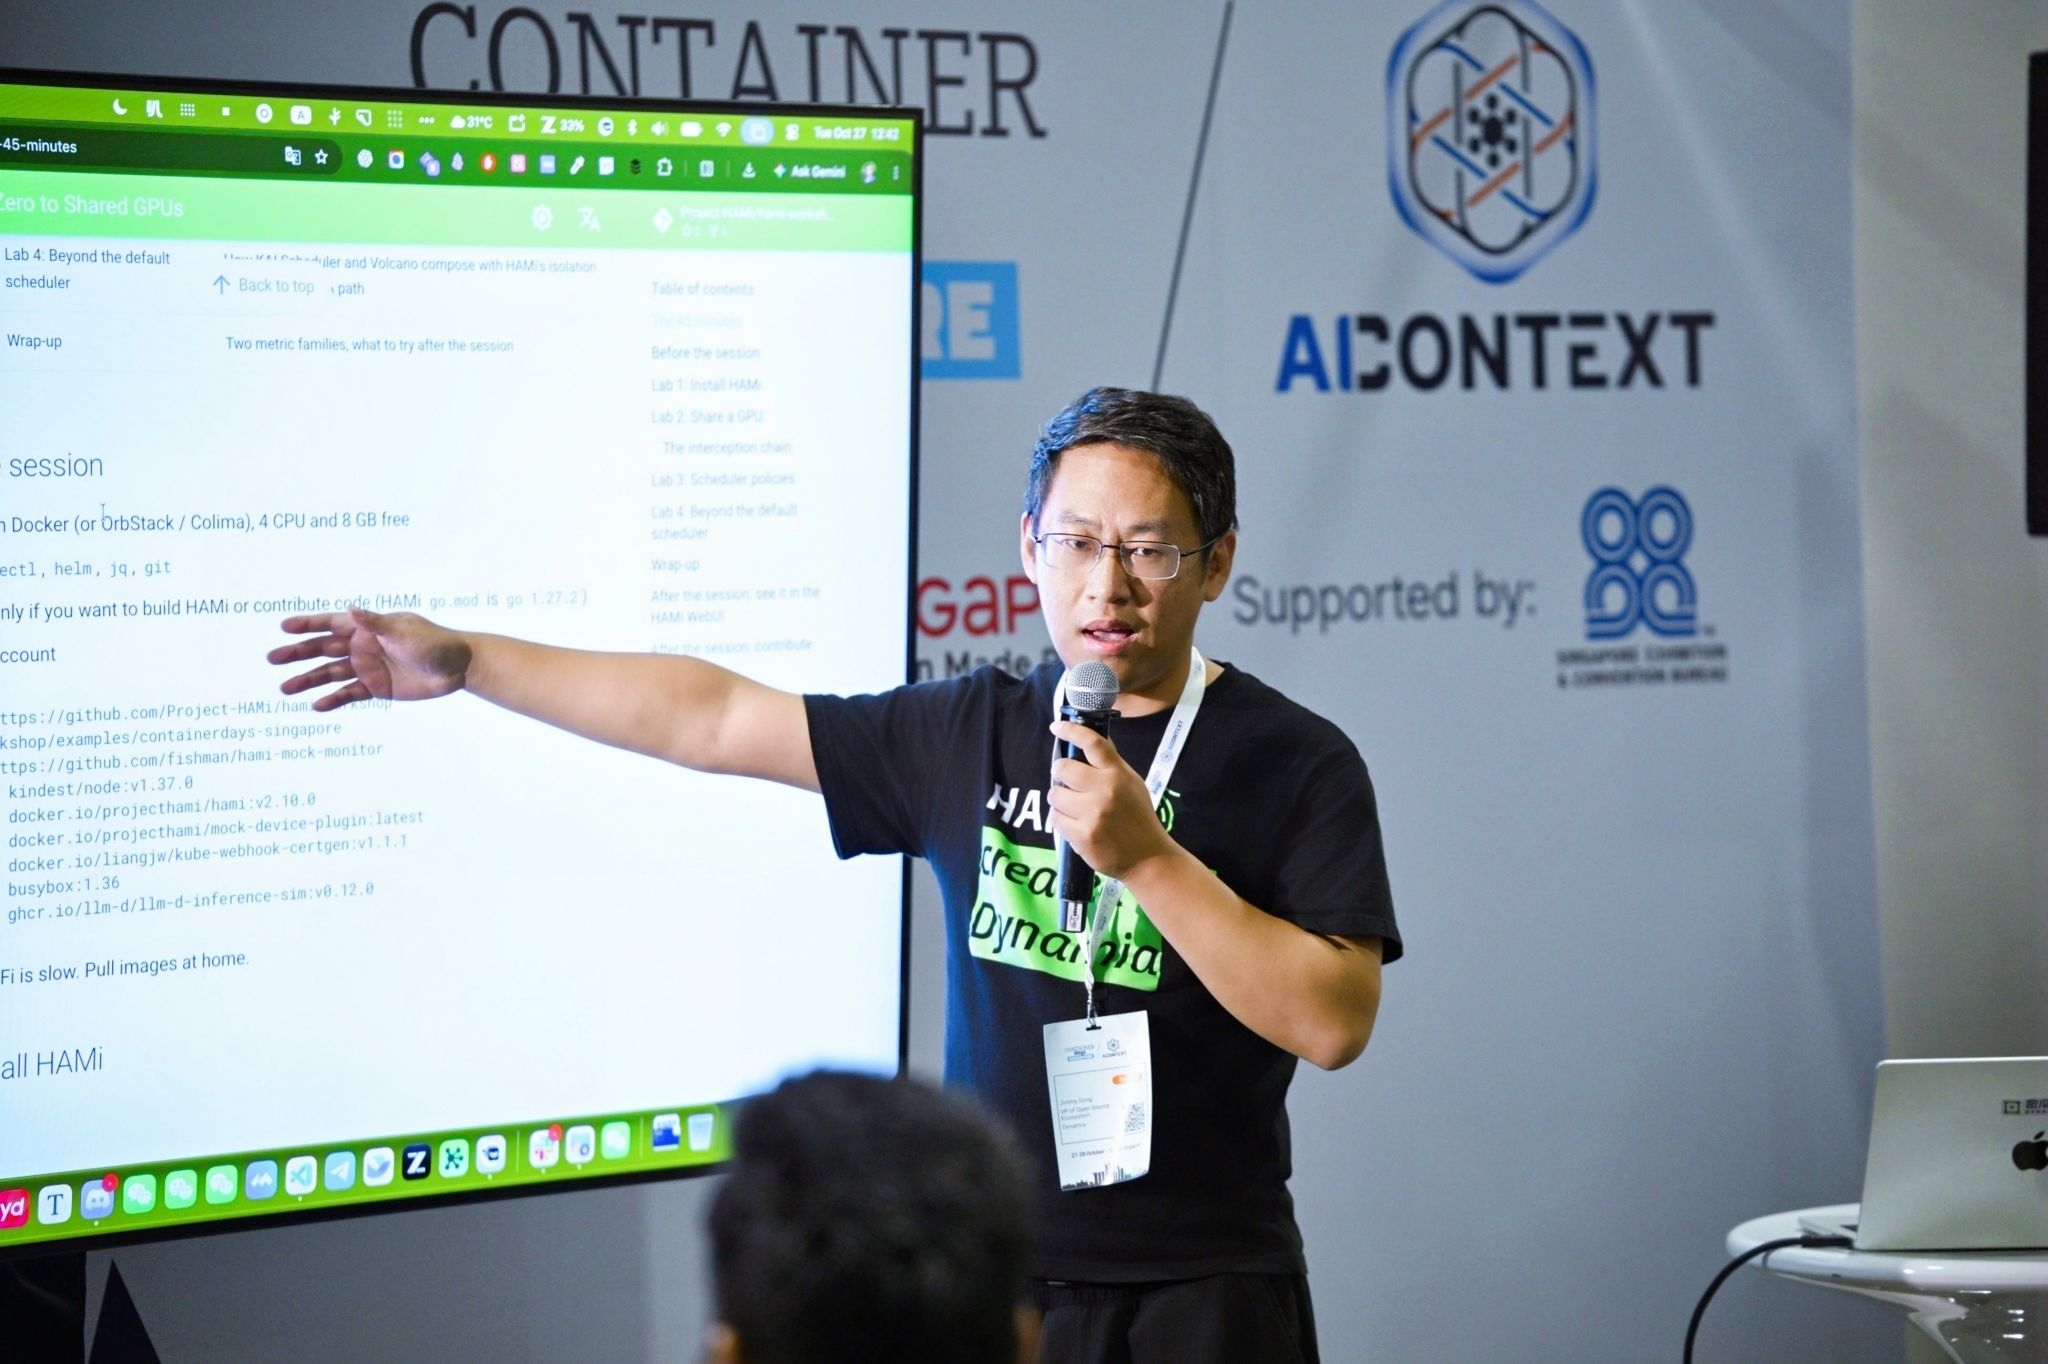
Über Basis-Labs hinaus behandelte das Workshop die Zusammenarbeit von HAMi mit Projekten wie KAI Scheduler und Volcano sowie die Richtung HAMi-DRA mit Kubernetes Dynamic Resource Allocation. In diesen Architekturen übernimmt der Scheduler Workload-Platzierung und Queue-Management, HAMi-core erzwingt GPU-Limits zur Laufzeit.
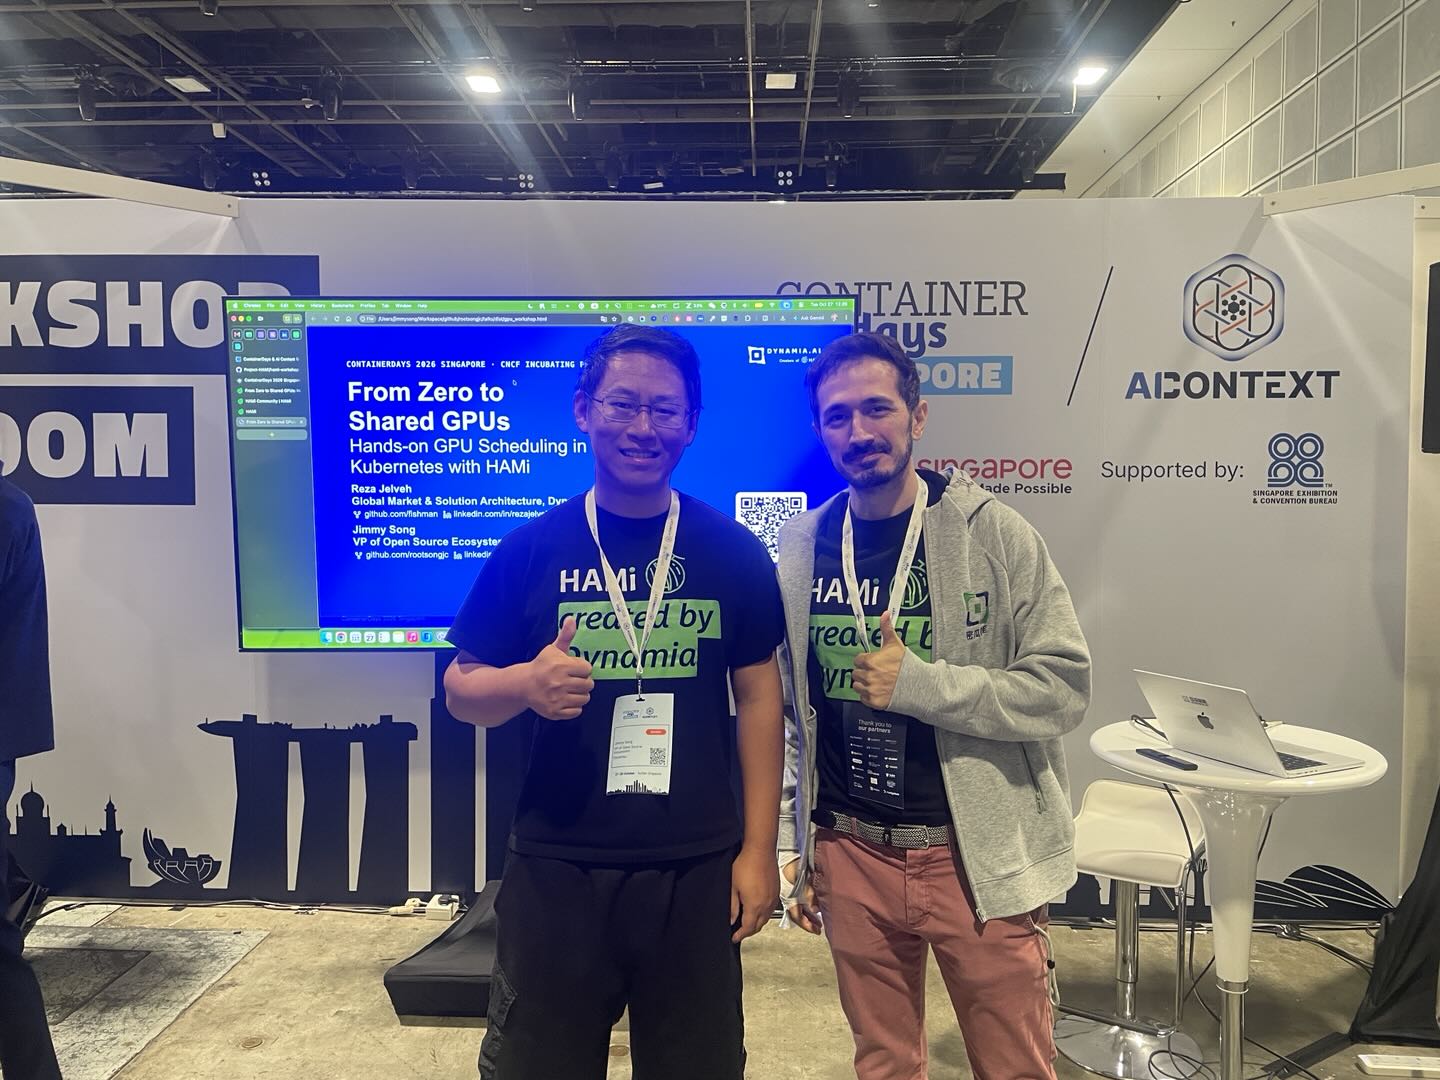
Von Ressourcenanfragen über Job-Scheduling bis zur Laufzeit-Isolation erhielten Teilnehmer ein konkreteres Bild von HAMis GPU-Ressourcenmanagement.
Neocloud-Compute-Auslastung optimieren
Vortragstitel: 10X Your Neocloud's GPU Utilization with HAMi
Speaker: Reza Jelveh
Zeit: 27. Oktober, 15:05–15:40
Ort: CDS Theatre
Das erste Workshop behandelte Funktionsweise von Sharing und Scheduling. Der zweite Vortrag richtete den Blick auf Neocloud und die Frage, wie GPU-Sharing in echter KI-Infrastruktur zu höherer Auslastung wird.
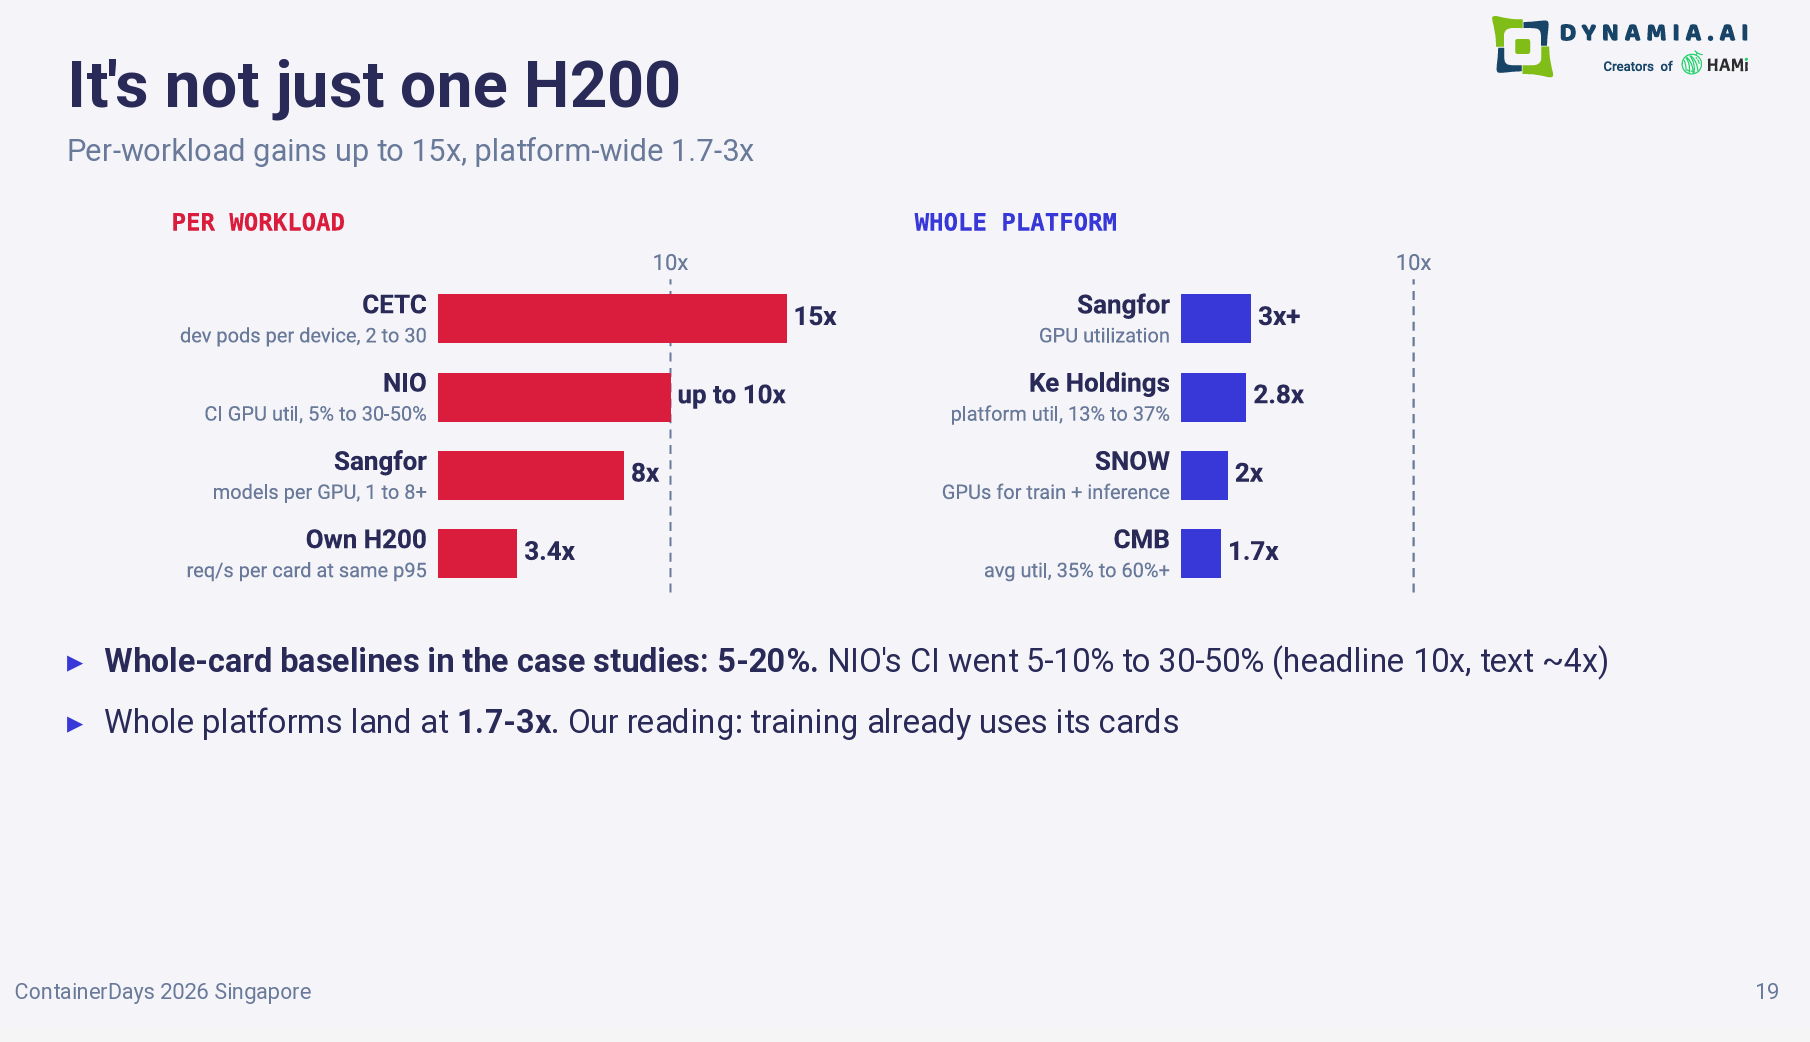
In Neocloud-Szenarien müssen GPUs Training, Inferenz, Entwicklungsumgebungen, Notebooks, Multi-Tenant-Zuweisung und Messung bedienen. Große Trainingsjobs brauchen ggf. eine volle GPU; kleine Inferenz und Dev-Tests oft nur einen Bruchteil.
Eine NVIDIA H200 mit 141 GB Speicher: nutzt ein Job nur ~1 GB und bekommt trotzdem die ganze Karte, bleibt viel Kapazität ungenutzt.
Der Vortrag beschrieb, wie HAMi feingranulare GPU-Zuweisung, Laufzeitlimits und Scheduling-Policies verschiedene Workloads auf Geräten teilen lässt — innerhalb der Ressourcengrenzen.
Höhere GPU-Auslastung heißt nicht, dass ein einzelner Job schneller wird — sondern dass zuvor freie Kapazität passendere Arbeit aufnehmen kann.
Eine GPU, mehr Inferenz-Workloads
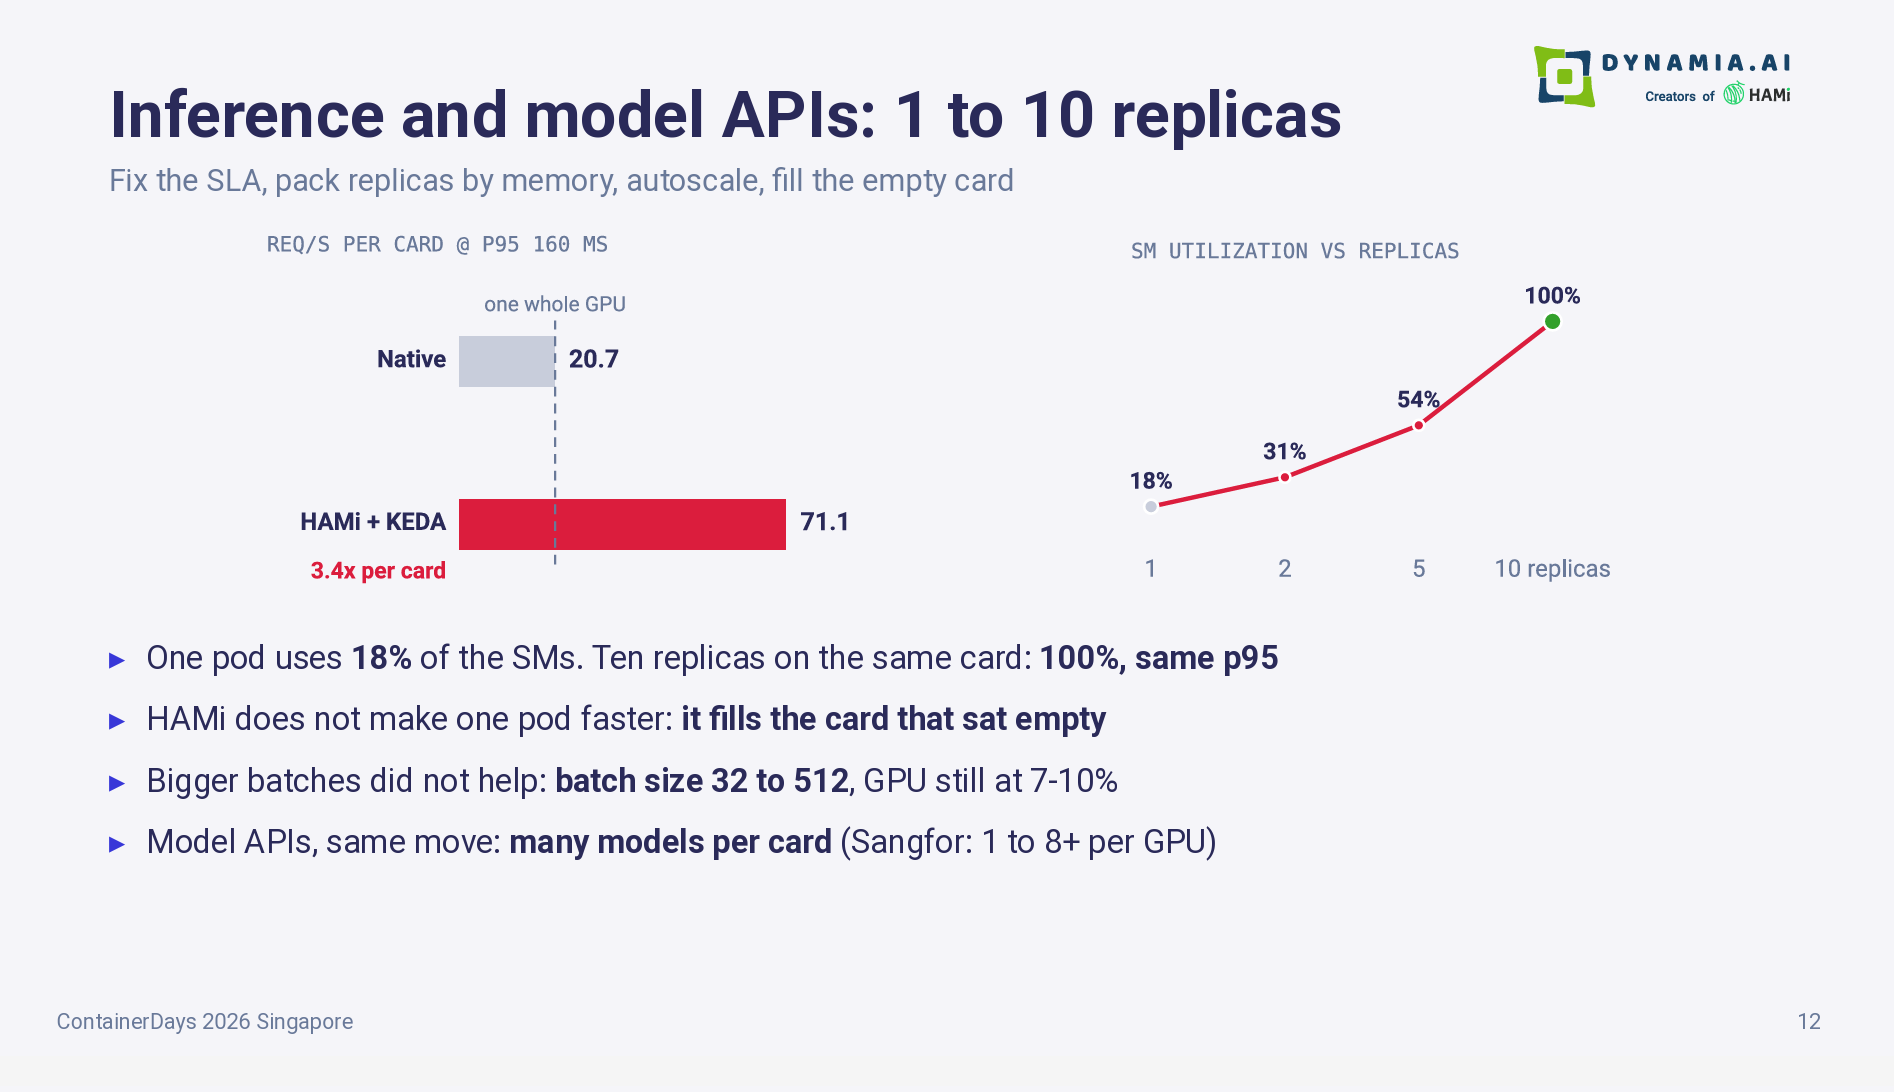
Bei Inferenz-Serving nutzt eine Instanz oft keine volle GPU. Statt nur die Allokation einer Instanz zu vergrößern, können speicherbewusste Platzierung und Multi-Replica-Deployment Restkapazität effektiver nutzen.
Reza teilte Test- und Falldaten zu Auslastung und Serviceverhalten bei unterschiedlicher Replik-Anzahl pro GPU.
Ein Test zeigte: bei gleichem p95-Latenzniveau stieg die GPU-Compute-Auslastung mit mehr Inferenz-Replikas auf einer GPU — für kleinere, parallel geeignete Workloads können Sharing und Scheduling die Gerätekapazität erhöhen.
GPU-Sharing passt nicht zu jedem Szenario.
Großes Modelltraining und großes LLM-Serving können weiterhin besser auf einer vollen GPU laufen; bei strenger Multi-Tenant-Isolation können MIG oder exklusive Geräte nötig sein.
In der Praxis zuerst Ressourcenbedarf pro Workload verstehen, dann Sharing oder Exklusivität wählen — nicht blind feineres Slicing verfolgen.
Von einer GPU zu heterogenem Compute-Management
Mit mehr GPU-, NPU- und weiteren Gerätetypen wird heterogenes Ressourcenmanagement auf einer Plattform zentral für den Betrieb.
Der Vortrag behandelte HAMis Unterstützung für NVIDIA, AMD, Ascend und andere Beschleuniger sowie ein einheitliches Ressourcenanfrage-Modell mit hardwarespezifischen Limit-Mechanismen für flexibleres Gerätemanagement.
Darauf aufbauend arbeitet HAMi mit Volcano, Kueue, KAI Scheduler und ähnlichen Projekten für Batch, Queue-Scheduling und Multi-Tenant-Management.
Für Unternehmen heißt das: bestehenden Kubernetes-Stack behalten und GPU-Sharing, Scheduling und Ressourcenmanagement pro Szenario zusammensetzen — ohne jede Anforderung an eine einzelne Komponente zu binden.
Von Zuweisung zu feinerem Betrieb
Wichtig ist die Unterscheidung von zugewiesenen Ressourcen und tatsächlicher Nutzung.
Ein Mandant kann hohe GPU-Quota anfragen, zur Laufzeit aber nur einen Teil nutzen. Nur zugewiesene Kapazität zu messen, verzerrt die reale Last.
Der Vortrag behandelte getrenntes Monitoring von Zuweisung und Nutzung für Quoten, Messung und Kapazitätsplanung — plus Produktionsfälle zu Sharing, Scheduling und Autoscaling.
GPU-Optimierung lässt sich nicht aus einem Einzeljob-Test beurteilen; sie braucht Workload-Mix, Scheduling und Laufzeitmanagement der Plattform.
Von Piloten zu Skalierung: messbarer Wert für Enterprise-KI
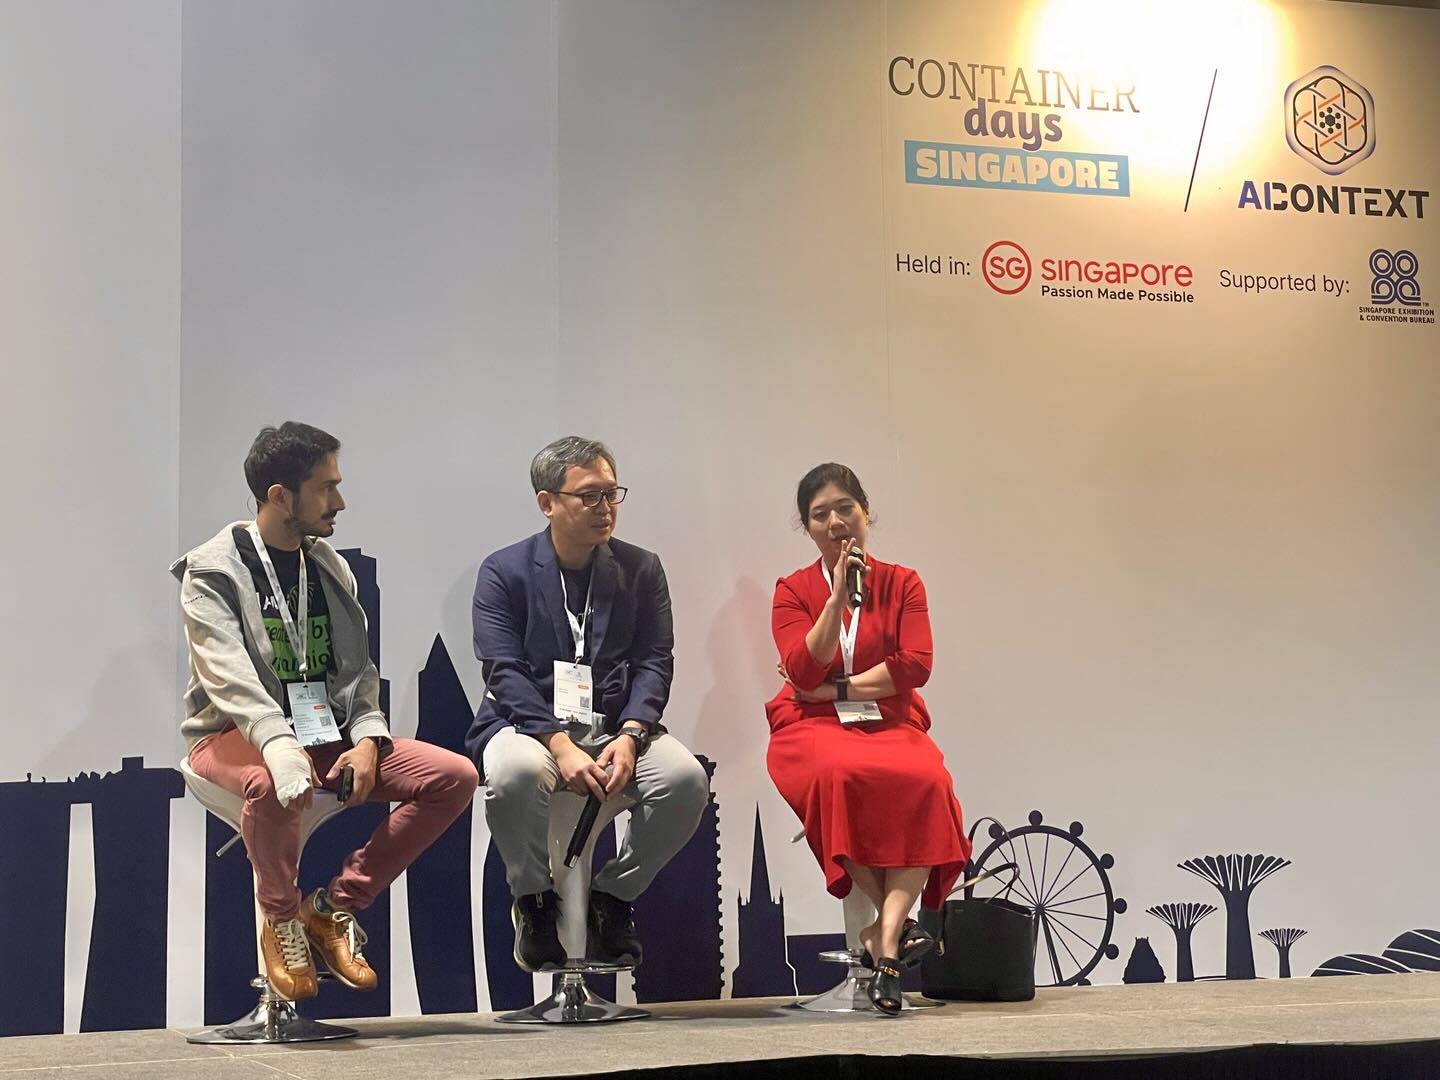
Am 28. Oktober moderierte Reza Jelveh das Panel „Building Enterprise AI at Scale: From Pilots to Measurable Value.“
Diskutiert wurden Herausforderungen beim Übergang von Piloten zu skaliertem Einsatz — nachhaltige Produktion und Messung des Geschäftswerts von KI-Anwendungen.
Im Vergleich zu den technischen Vorträgen zu GPU-Sharing, Scheduling und Auslastung erweiterte das Panel den Blick auf Business-Bedarf und Wertbewertung.
Die beiden Vorträge starteten aus Praxis und Produktion und zeigten, wie HAMi GPU-Sharing und Scheduling in Kubernetes ermöglicht und auf Inferenz, heterogene Hardware und Multi-Tenant-Betrieb anwendet.
Während der Veranstaltung tauschten sich Team und Peers über reale Anforderungen und Praktiken im GPU-Ressourcenmanagement aus.
Als Initiator und Treiber des HAMi-Open-Source-Projekts wird Dynamia weiter zum Cloud-Native- und KI-Infrastruktur-Ökosystem beitragen — mit F&E und Open-Source-Zusammenarbeit zu GPU-Sharing, heterogenem Scheduling und Laufzeitmanagement, damit mehr Unternehmen vorhandene Compute flexibel und effizient nutzen.