

Modelle werden größer – warum brauchen Unternehmen trotzdem feingranulares Compute-Scheduling?
 Engineering
In einem geteilten Ressourcenpool müssen Unternehmen Voll-GPU- und Multi-GPU-Deployments für große Modelle unterstützen und gleichzeitig On-Demand-Sharing für leichte Inferenz, F&E und Batch-Jobs ermöglichen. Anhand von Modellnutzungsdaten und Produktionscluster-Forschung erörtert dieser Beitrag, wie GPUs nach Workload-Bedarf zugewiesen und heterogenes Compute teamübergreifend geteilt werden kann.
Auf dieser Seite
Von Modelltrends und hyperskalen Produktionsclustern zu unternehmerischen KI-Anwendungen: die nächste Stufe der Compute-Infrastruktur
In den letzten zwei Jahren stand Modellfähigkeit im Zentrum der KI-Branche. Größere Parameter, stärkeres Reasoning, Agents mit komplexen Aufgaben – KI-Anwendungen reichen von Content-Generierung bis in unternehmerische Produktionsabläufe.
Wenn Modelle wachsen und der Speicher einer einzelnen GPU manche Laufzeitanforderungen nicht mehr erfüllt – warum brauchen Unternehmen trotzdem GPU-Virtualisierung? Wenn Voll-GPU- und Multi-GPU-Deployments häufiger werden – nimmt der Wert von GPU-Sharing und Ressourcen-Slicing ab?
Für ein einzelnes großes Modell ist oft eine volle GPU – oder mehrere – die bessere Wahl. In Produktion laufen jedoch Retrieval, Ranking, leichte Inferenz und F&E-Validierung parallel. Diese Workloads unterscheiden sich in Speicher, Compute und Latenz; manche brauchen nur einen Bruchteil einer GPU.
Das Nebeneinander von Voll-GPU, Multi-GPU und On-Demand-Sharing ist genau der Grund für feingranulares Compute-Scheduling. Um zu sehen, wie diese Bedürfnisse die Zuteilung prägen, beginnt man bei den Modellen und Workloads, die Unternehmen tatsächlich betreiben.
Modelle werden größer – aber Unternehmen betreiben nicht nur eine Art
Über die Richtung der KI-Modelle gibt es lange zwei Sichten.
Die eine: Fähigkeit konzentriert sich in immer größeren Frontier-Modellen, die mehr Aufgaben abdecken. Die andere: kleinere Modelle mit Kostenvorteil, einfacherem Deployment und schnellerer Antwort werden in Enterprise-Szenarien breiter genutzt.
OpenRouter-Nutzungsdaten liefern einen Blickwinkel.
Im Dezember 2025 veröffentlichten OpenRouter und a16z State of AI: An Empirical 100 Trillion Token Study – Analyse von Modellnutzung, Entwicklerverhalten und KI-Trends aus über 100 Billionen Tokens realer Interaktionen auf der OpenRouter-Plattform.
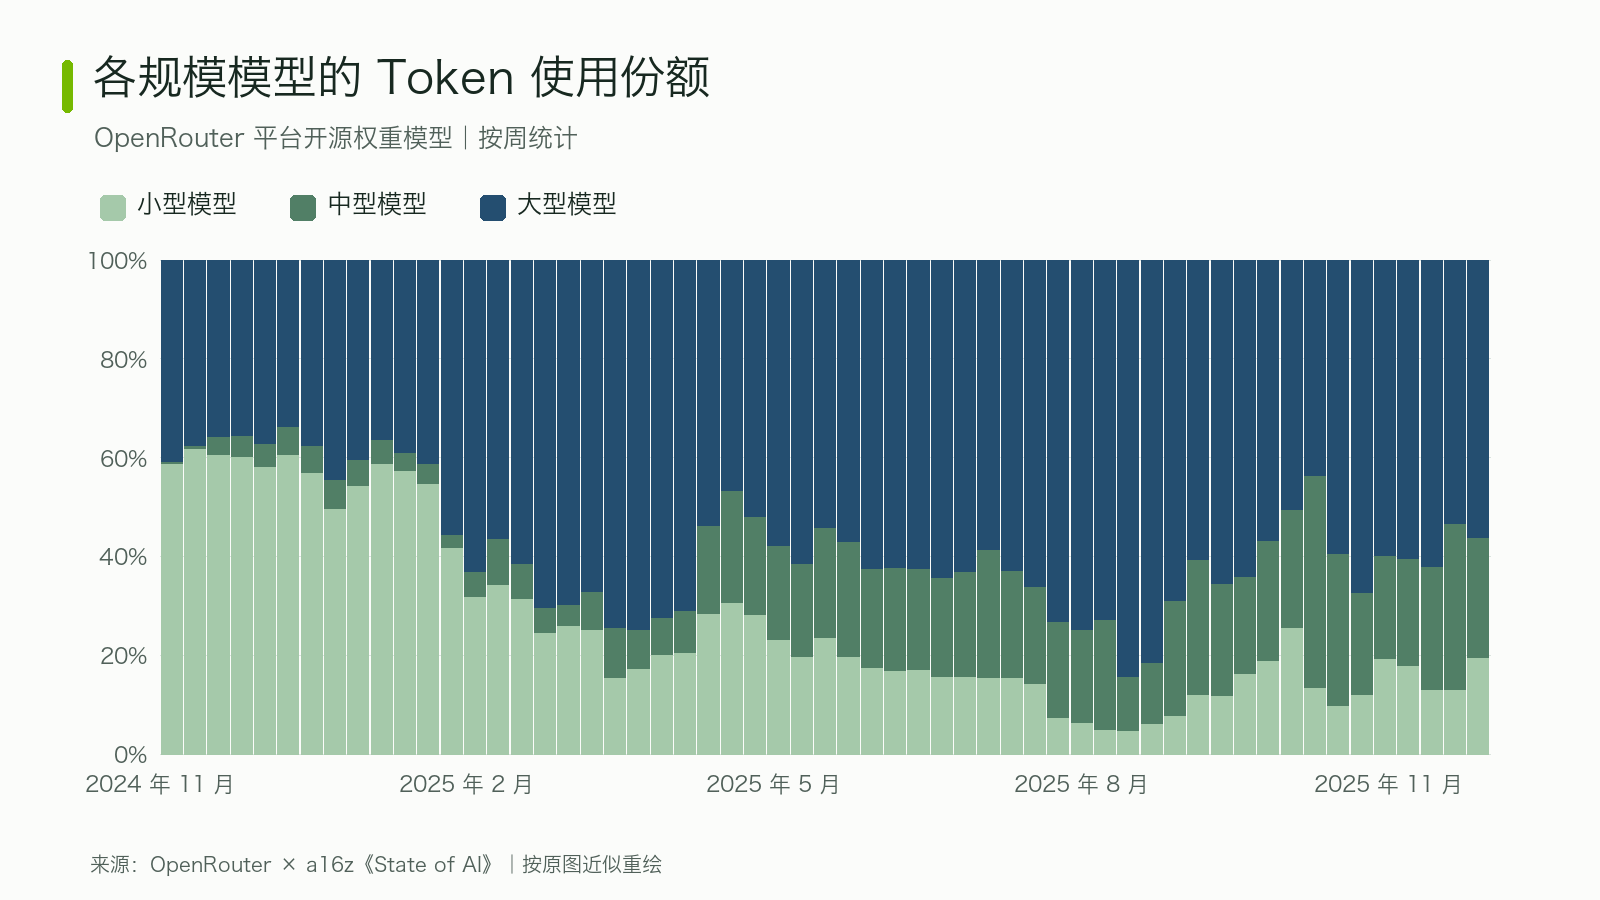
Die Studie gruppierte Open-Weight-Modelle in klein, mittel und groß.
Sie fand: Die Nutzungsmischung offener Modelle verschob sich im vergangenen Jahr klar – Anteil kleiner Modelle sank, mittlere und große wuchsen.
Bemerkenswerter Befund:
Medium is the New Small – mittlere Modelle werden die neuen kleinen Modelle.
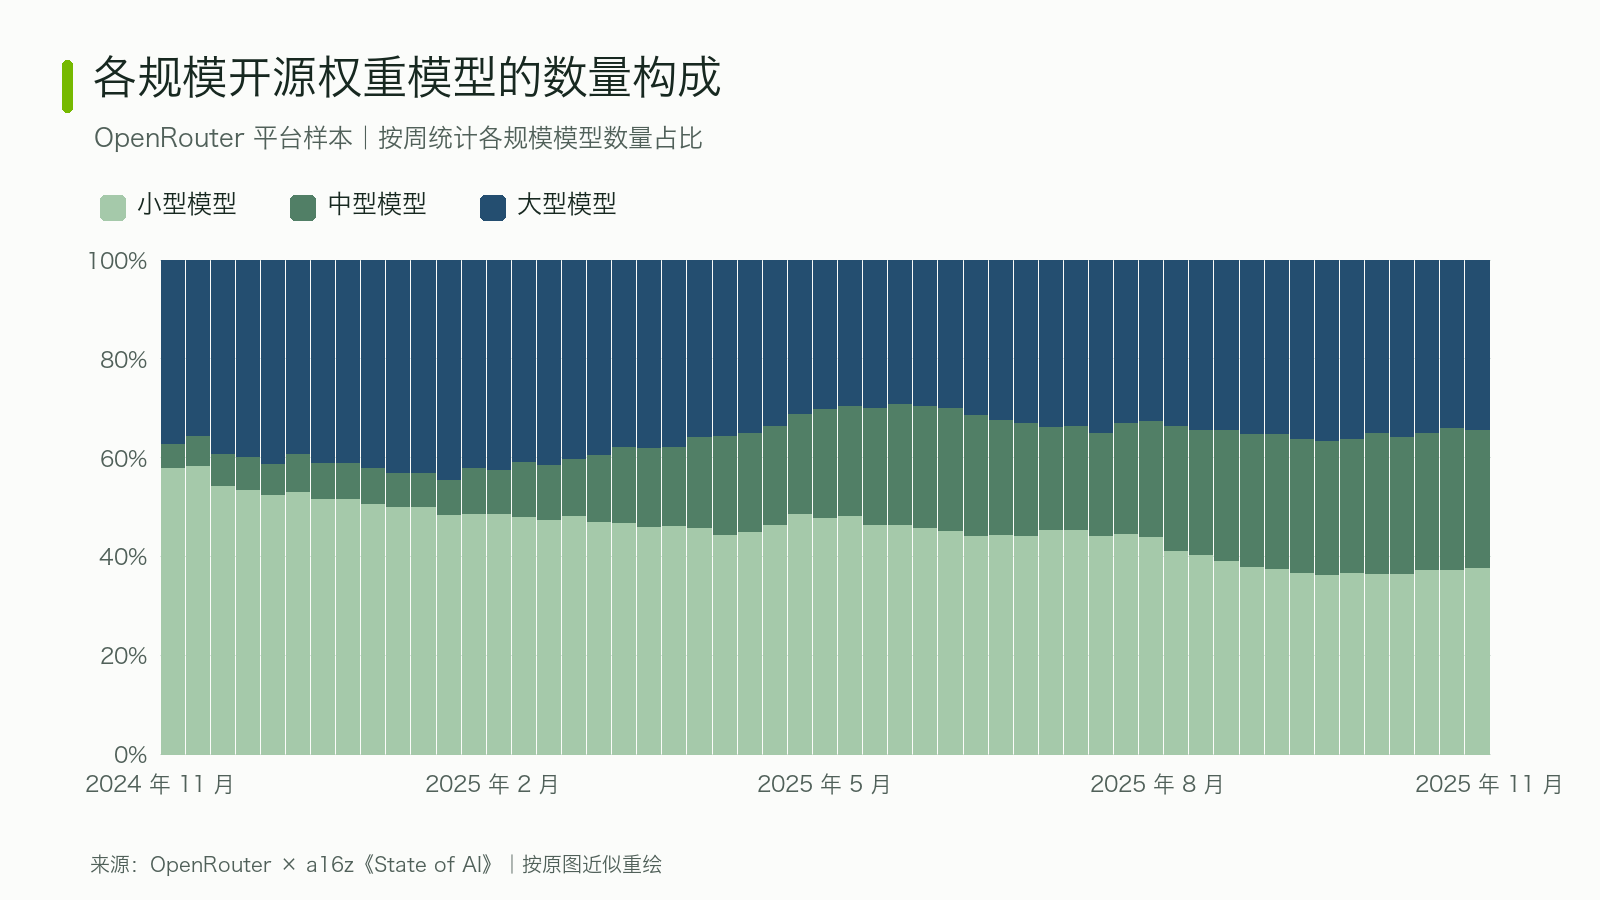
Mittlere Modelle bieten Entwicklern einen Kompromiss zwischen Fähigkeit und Deploy-Kosten.
OpenRouter-Call-Daten zeigen die Verschiebung nach Modellgröße; Menlo Ventures’ Bericht zeigt, dass Unternehmen für hochwertige Aufgaben weiter stärkere Modelle wählen. In der Praxis wählen sie nach Aufgabenschwere, Genauigkeit, Latenz und Deploy-Kosten.
Ein Enterprise-KI-System kann gleichzeitig etwa Folgendes bedienen – mit unterschiedlicher Modellwahl:
- Große Modelle: komplexes Reasoning, Planung, Entscheidungen;
- Mittlere Modelle: domänenspezifische Arbeit und Teil der Produktionsinferenz;
- Kleine Modelle: eher feste Aufgaben wie Klassifikation, Informationsextraktion, Intent-Erkennung;
- Embedding- und Rerank-Modelle: Retrieval und Relevanz;
- Multimodale Modelle: Bilder, Sprache, Video und andere Datentypen.
Manche Dienste laufen über Cloud-APIs. Wer eigene KI-Infrastruktur, private Deployments oder GPU-Pools betreibt, fragt direkter: Wenn Aufgaben mit unterschiedlichem Speicher-, Compute- und Latenzbedarf in denselben Pool kommen – können vorhandene GPUs den passenden Workloads zugewiesen werden?
KI in Produktion: Compute-Effizienz auf Cluster-Ebene betrachten
Welche Modelle und Workloads Unternehmen nutzen, war im vorigen Abschnitt Thema. In einem Produktionscluster hängt die Erfüllung dieser Bedürfnisse auch davon ab, wie GPUs, CPUs, Netzwerk und andere Ressourcen auf Nodes verteilt sind. Eine Alibaba-Studie zu einem Produktionscluster betrachtete diese Frage in einer realen Betriebsumgebung.
Im Juli 2026 präsentierte das USENIX OSDI 2026-Paper Heterogeneity at Hyperscale: Characterization and Scheduling of Large Production AI Clusters at Alibaba eine systematische Untersuchung von Alibabas Serverless Infrastructure (ASI) Produktionsclustern.
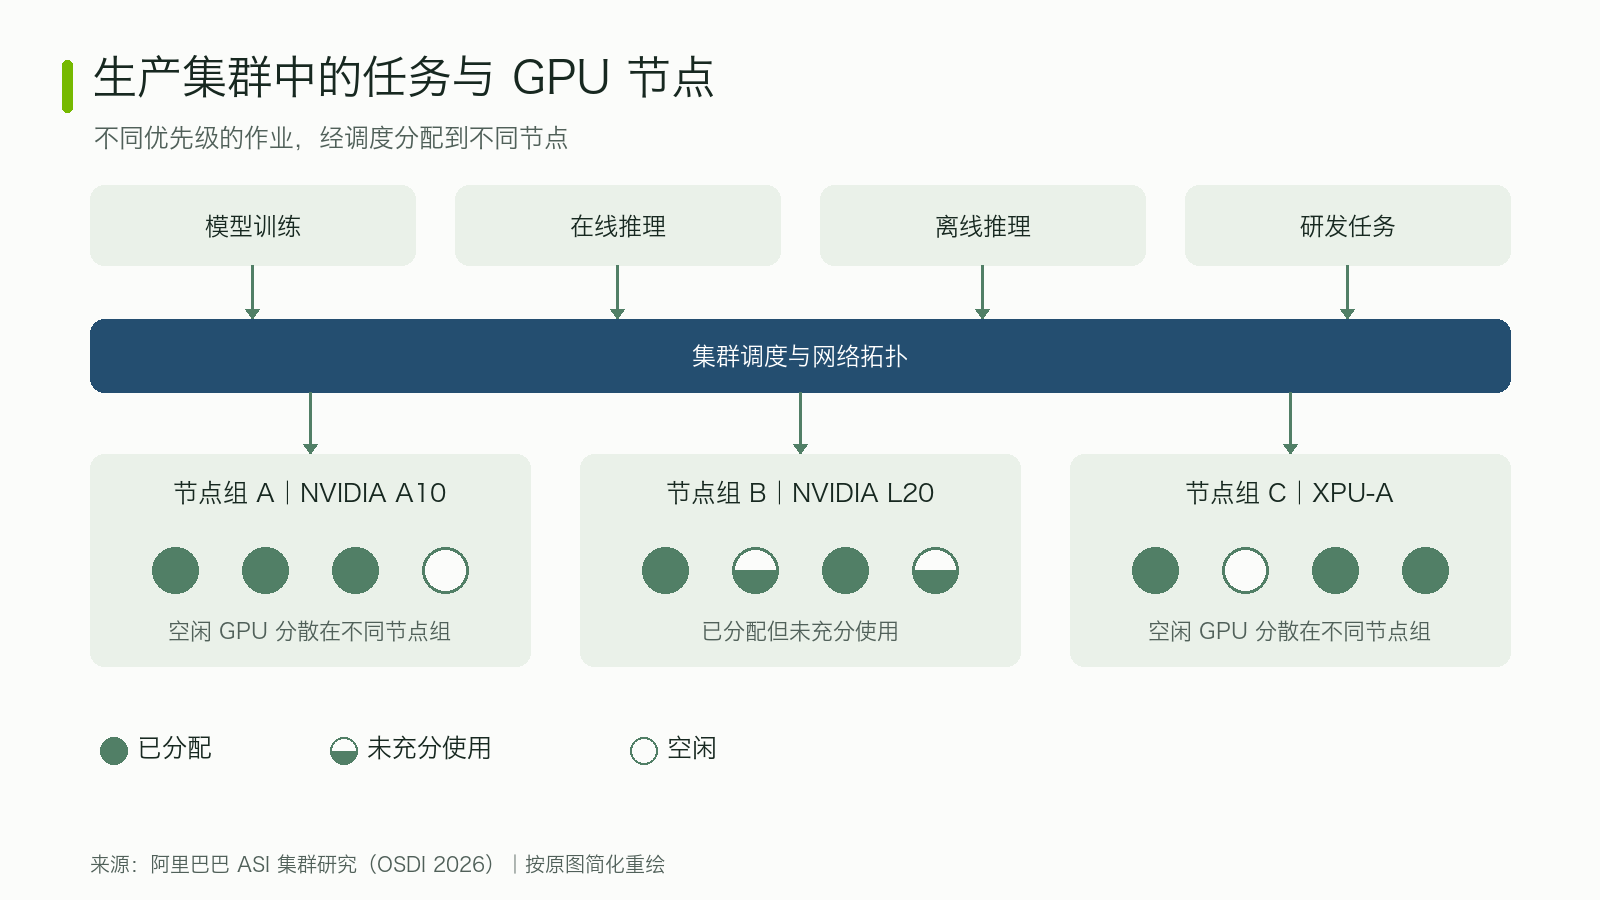
Sechs Monate Produktionsdaten: 155.410 GPUs verschiedener Anbieter und Generationen, 81 Business Units, Workloads von kurzlebiger F&E über Training bis Online- und Offline-Inferenz.
Selbst bei starker GPU-Nachfrage bleibt ein Teil ungenutzter Kapazität schwer zuweisbar. Das hängt mit Node-Platzierung, CPU- und Netzanforderungen der Jobs und Reservierungen für Produktionsdienste zusammen – in vier Kategorien.
1. Fragmentierung auf Node-Ebene
Leere GPUs liegen über Nodes verstreut. Cluster-weit gibt es Reserve, aber manche Job-Anforderungen an GPU-Anzahl und Node-Ressourcen-Kombinationen sind nicht erfüllbar.
2. CPU–GPU-Mismatch
Manche Nodes haben freie GPUs, aber zu wenig oder unpassende CPU-Ressourcen – diese GPUs nutzen Jobs nicht effektiv.
3. Netzwerk-Topologie-Constraints
Multi-GPU-Jobs hängen an Interconnects und Topologie-Platzierung. Selbst bei freien GPUs im Cluster erfüllen sie evtl. nicht die Kommunikationsanforderungen.
4. Produktions-Reservierung
Für Traffic-Spitzen und Stabilität reservieren Unternehmen Compute-Kapazität – zeitweise idle, aber nicht bedingungslos an andere Jobs.
Zur Lösung deployte das Forschungsteam zwei Optimierungen in Produktion – auf Cluster-Organisation und Job-Scheduling.
Erstens GPU Defragmentation: Konsolidierung fragmentierter Ressourcen auf Cluster-Ebene.
Anpassung der GPU-Verteilung über Nodes, um Zuweisungsschwierigkeiten durch verstreute Reste zu reduzieren.
Ergebnis: Nach Konsolidierung fiel die Anzahl Nodes mit Rest-Ressourcen um 20,2 %.
Zweitens: preemptible Jobs nutzen temporär freie GPUs.
Spot-GPUs sind günstigere, zurücknehmbare Kapazität für unterbrechbare Jobs. Im OSDI-2026-Paper nannte Alibaba den Ansatz SpotGPU: Gibt ein High-Priority-Job GPUs kurz frei, nutzen preemptible Jobs die Kapazität; bei Bedarf des High-Priority-Jobs reclaimt der Scheduler und unterbricht bevorzugt Jobs mit geringerem Compute-Verlust.
In den beobachteten Clustern stieg die GPU-Allokationsrate von 68 % auf 93 %. Klarstellung: 93 % ist Allokationsrate, nicht Compute-Auslastung – unterschiedliche Metriken.
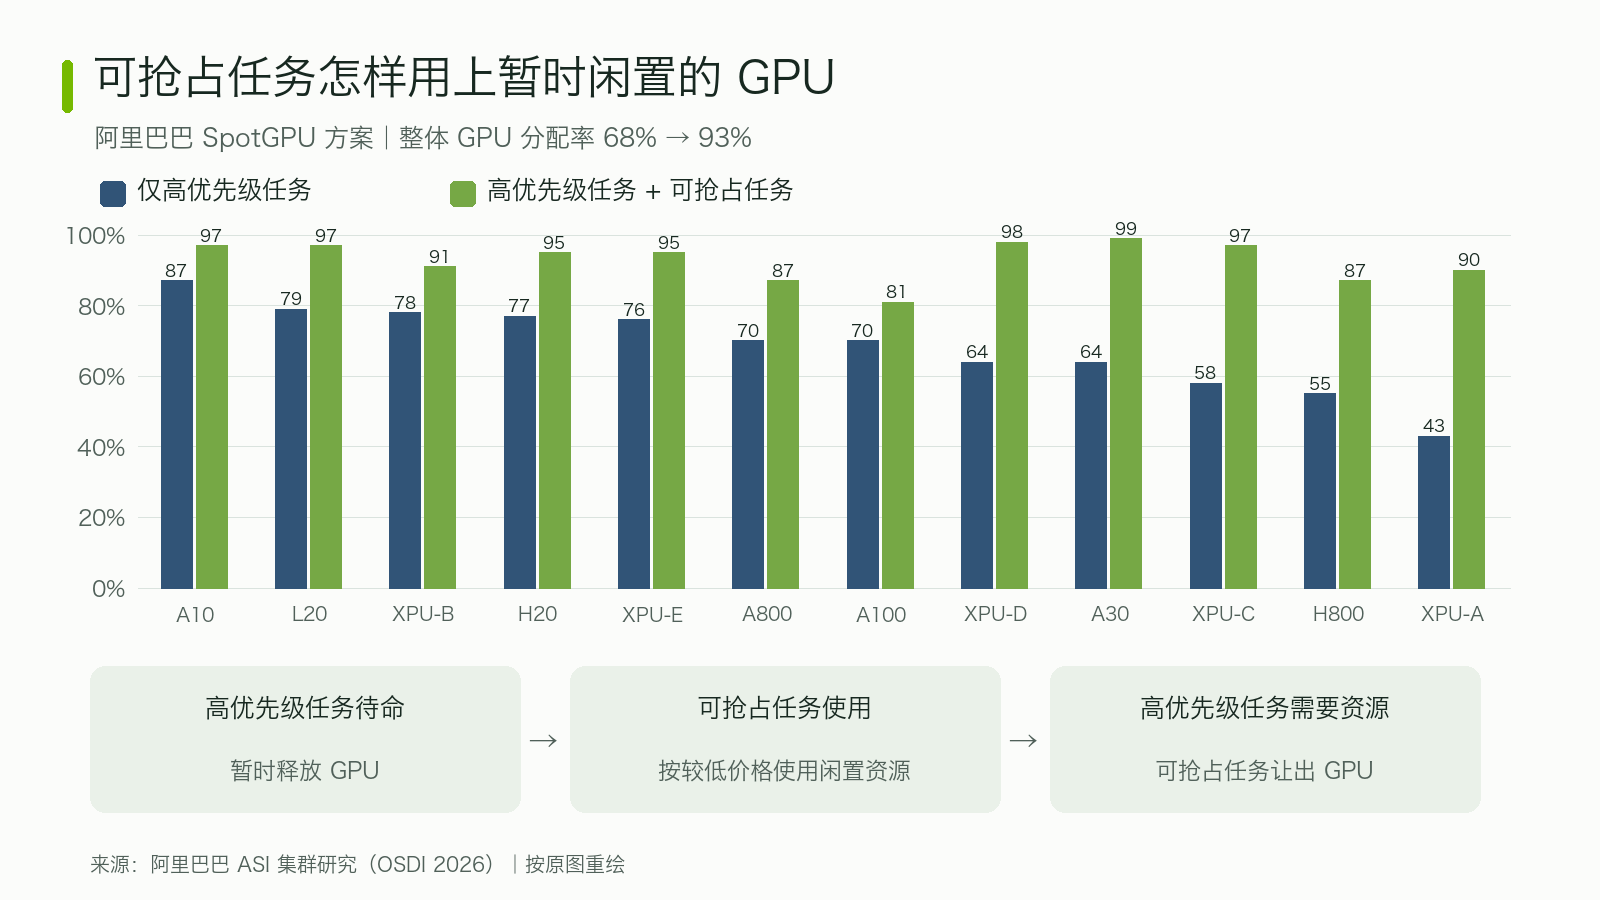
Diese Praktiken zeigen: In hyperskalen heterogenen GPU-Clustern können Konsolidierung und Job-Scheduling Kapazität freisetzen, die zuvor schwer effektiv zuweisbar war – nicht nur durch mehr Hardware.
Ein weiterer Befund: In diesem Produktionscluster war GPU-Sharing selten; feine Fragmentierung innerhalb einer GPU war nicht der Haupt-Engpass.
Das gilt für die untersuchte Umgebung. Intra-GPU-Fragmentierung: Restkapazität auf einer GPU schwer weiterzuvergeben; Cluster-Fragmentierung: leere GPUs über Nodes, die keine passende Kombination für einen Job bilden. In dieser Stichprobe bestimmten Platzierung, CPU-Pairing, Topologie und Produktionsreservierungen die Zuweisbarkeit stärker.
Cluster-Allokationseffizienz hängt davon ab, ob Geräte, Nodes und begleitende Ressourcen die Kombinationen bilden, die Jobs brauchen. Nur zu fragen, ob eine GPU belegt ist, sagt wenig darüber, welche zusätzlichen Workloads die vorhandene Kapazität noch aufnehmen kann.
Voll-GPU, Multi-GPU oder Sharing – wie sollten Unternehmen wählen?
Ein großer Modell-Job braucht evtl. mehrere zusammenarbeitende GPUs; mehrere leichte Inferenz-Instanzen teilen eine GPU. Im ersten Fall: kann der Cluster GPUs mit passendem Speicher, Compute und Kommunikation zusammenstellen? Im zweiten: bekommt jede Instanz genug Ressourcen und hält Latenz-Ziele? Die Wahl startet aus diesen zwei Bedarfsarten und hängt vom konkreten Workload ab.
Für großes Modell-Training und High-Load-Inferenz ist Voll-GPU oder Multi-GPU-Koordination oft sinnvoller.
Diese Jobs brauchen anhaltend stabiles Compute und hohe Anforderungen an Inter-GPU-Kommunikation, Speicher und Durchsatz. Sharing erzwingen kann Kontention und Effizienzverlust bringen.
Für Inferenz mehrerer leicht belasteter Modelle kann Sharing die Auslastung verbessern.
Ein Unternehmen betreibt etwa mehrere Klassifikations-, Embedding-, Rerank- und Domänenmodelle parallel – unterschiedlicher Traffic, Speicher, Compute.
Monopolisiert jedes Modell eine GPU, bleibt Kapazität lange idle, während andere auf GPUs warten.
Für F&E-Tests und Offline-Batch ist flexible Zuteilung ebenfalls wertvoll.
Notebooks, Debugging, Parameterexperimente und Batch-Evaluierung brauchen nicht durchgehend eine volle GPU. Sinnvolles Sharing, Quotas und Scheduling reduzieren unnötiges Blockieren.
Nach der Nutzungswahl prüfen, ob sie in Spitzenzeiten hält: Multi-GPU-Jobs mit gruppierten Ressourcen; Shared-Jobs mit Throughput und Latenz. Wenn mehrere Teams dieselbe Kapazität nutzen, müssen Quotas, Prioritäten und Nutzungsnachweise den Alltag tragen.
Von GPU-Virtualisierung zu Heterogen-Compute-Governance
Wie ein einzelner Job GPUs nutzt, löst nur eine Zuweisung. Wenn mehrere Teams Compute über Zeit teilen, muss die Plattform weiter beantworten: wo Ressourcen in Clustern liegen, wie viel jedes Team nutzen darf, wer bei Knappheit geschützt ist, wie viel der zugewiesenen Kapazität wirklich genutzt wird.
Unternehmen können folgendes gleichzeitig haben:
- KI-Modelle unterschiedlicher Größe und Architektur;
- Training, Inferenz, F&E, Batch;
- NVIDIA-GPUs und inländische GPUs;
- Multi-Department-, Multi-Tenant-Nachfrage mit Prioritäten;
- Produktionsdienste mit unterschiedlichen Throughput-, Latenz-, Stabilitäts- und Kostenanforderungen.
Mehr Hardware allein löst nicht jedes Ressourcenmanagement-Problem.
Benötigt wird Ressourcenmanagement, das KI-Workloads mit heterogener Hardware verbindet – mindestens:
1. Einheitliches Management heterogener Ressourcen
Möglichst konsistentes Modell über Beschleuniger verschiedener Anbieter und Modelle.
2. Flexible Ressourcenzuteilung
Voll-GPU, Sharing, unterschiedliche Anteile nach Job-Bedarf.
3. Isolation und Performance-Garantien
Keine unkontrollierte Kontention; Garantien passend zum Business.
4. Multi-Tenancy und Ressourcen-Governance
Klare Quotas, Prioritäten und Grenzen für Abteilungen, Teams, Geschäftsbereiche.
5. Observability und Kostenmanagement
Nicht nur wer GPUs zugewiesen bekam, sondern reale Nutzung, Job-Effizienz, Kosten.
Diese Fähigkeiten müssen nicht in einer Komponente liegen. GPU-Virtualisierung, Kubernetes-native Device-Ressourcen und diverse Job-Scheduler müssen als Enterprise-KI-Infrastruktur zusammenspielen.
Von Compute-Management zu Infrastruktur-Effizienz: Dynamias Langzeitpraxis
Wenn mehrere Teams verschiedene GPU-Typen teilen, müssen Quotas, Isolation und Nutzungsnachweise in bestehenden Clustern und Workflows landen.
Dynamia wurde von den Initiatoren und Core-Maintainern des CNCF-Projekts HAMi gegründet und baut einen Open-Source-Kern für KI-Infrastruktur. Wir helfen KI-Teams, heterogene GPUs und KI-Chips einfacher, effizienter und steuerbarer zu nutzen – komplexes Computing als cloud-native Infrastruktur zum Teilen, Isolieren und On-Demand-Verbrauchen.
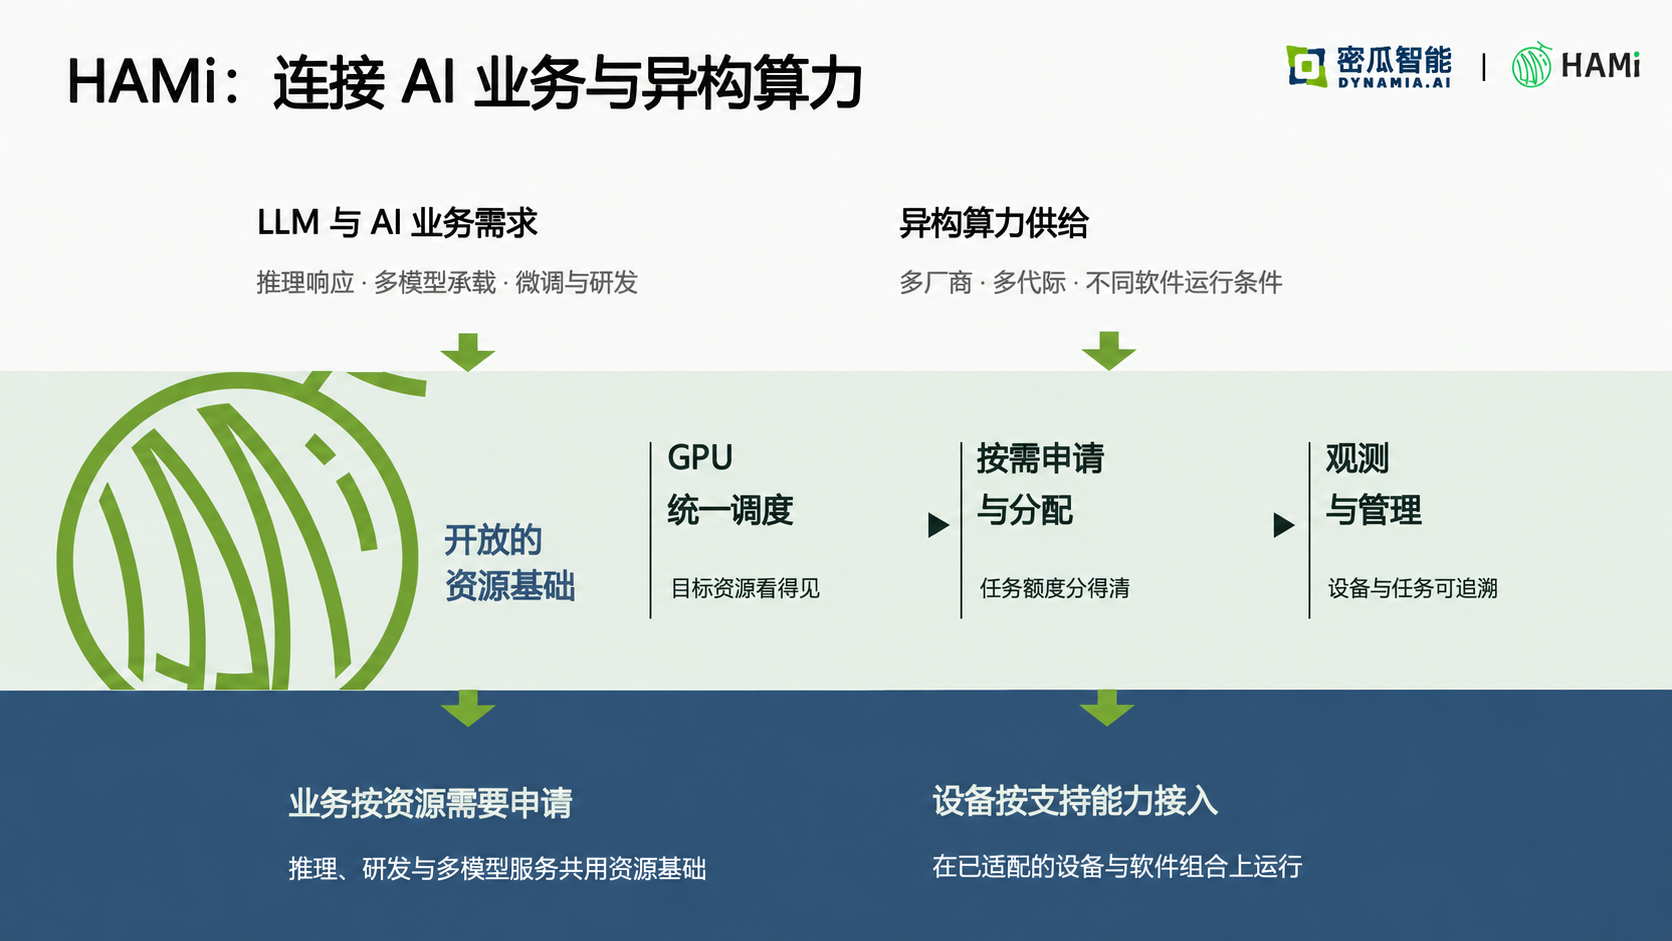
Auf Open-Source-HAMi bietet Dynamia Scheduling-Produkte und Services für Produktion – von GPU-Zuteilung pro Job bis Multi-Team-/Multi-Cluster-Management. Auf Geräteschicht: HAMi Enterprise für shareable Workloads nach Speicher und Compute; fortlaufend Compute für Großmodell-Inferenz-„Token-Factories“. Plattformschicht: HAMi AI Platform für Verteilung und Nutzung über verbundene Cluster, Team-Quotas, Access Control; auf Enterprise-Basis Modell-Deployment, Inferenz, Runtime-Observability und Ressourcen-Ops auf einer Plattform. Topologie-Matching für Multi-GPU-Jobs, Cluster-Konsolidierung und Job-Scheduling weiterhin mit passenden Cluster-Scheduler-Komponenten.
Während sich KI-Modelle und Anwendungen weiterentwickeln, vertieft Dynamia Basis-Technologie und treibt mit Community, Hardware-Anbietern, Plattformpartnern und Nutzern das heterogene Compute-Ökosystem.
Referenzen
- OpenRouter & Andreessen Horowitz, State of AI: An Empirical 100 Trillion Token Study, Dezember 2025.
https://openrouter.ai/state-of-ai/ - Suyi Li et al., Heterogeneity at Hyperscale: Characterization and Scheduling of Large Production AI Clusters at Alibaba, USENIX OSDI 2026.
https://www.usenix.org/conference/osdi26/presentation/li-suyi - Menlo Ventures, 2026: The State of Enterprise AI, November 2026.
https://menlovc.com/perspective/2026-the-state-of-enterprise-ai/
Hinweis: Branchenausgaben in diesem Artikel sind Schätzungen von Forschungsorganisationen; Modellnutzungsdaten stammen aus einer Plattformstichprobe; GPU-Cluster-Befunde aus einer konkreten Produktionsumgebung. Stichproben und Definitionen unterscheiden sich – nicht direkt vergleichen.