Dynamia teilt vLLM-Cluster-Optimierungspraktiken, damit Compute Enterprise-KI besser stützt
 Community
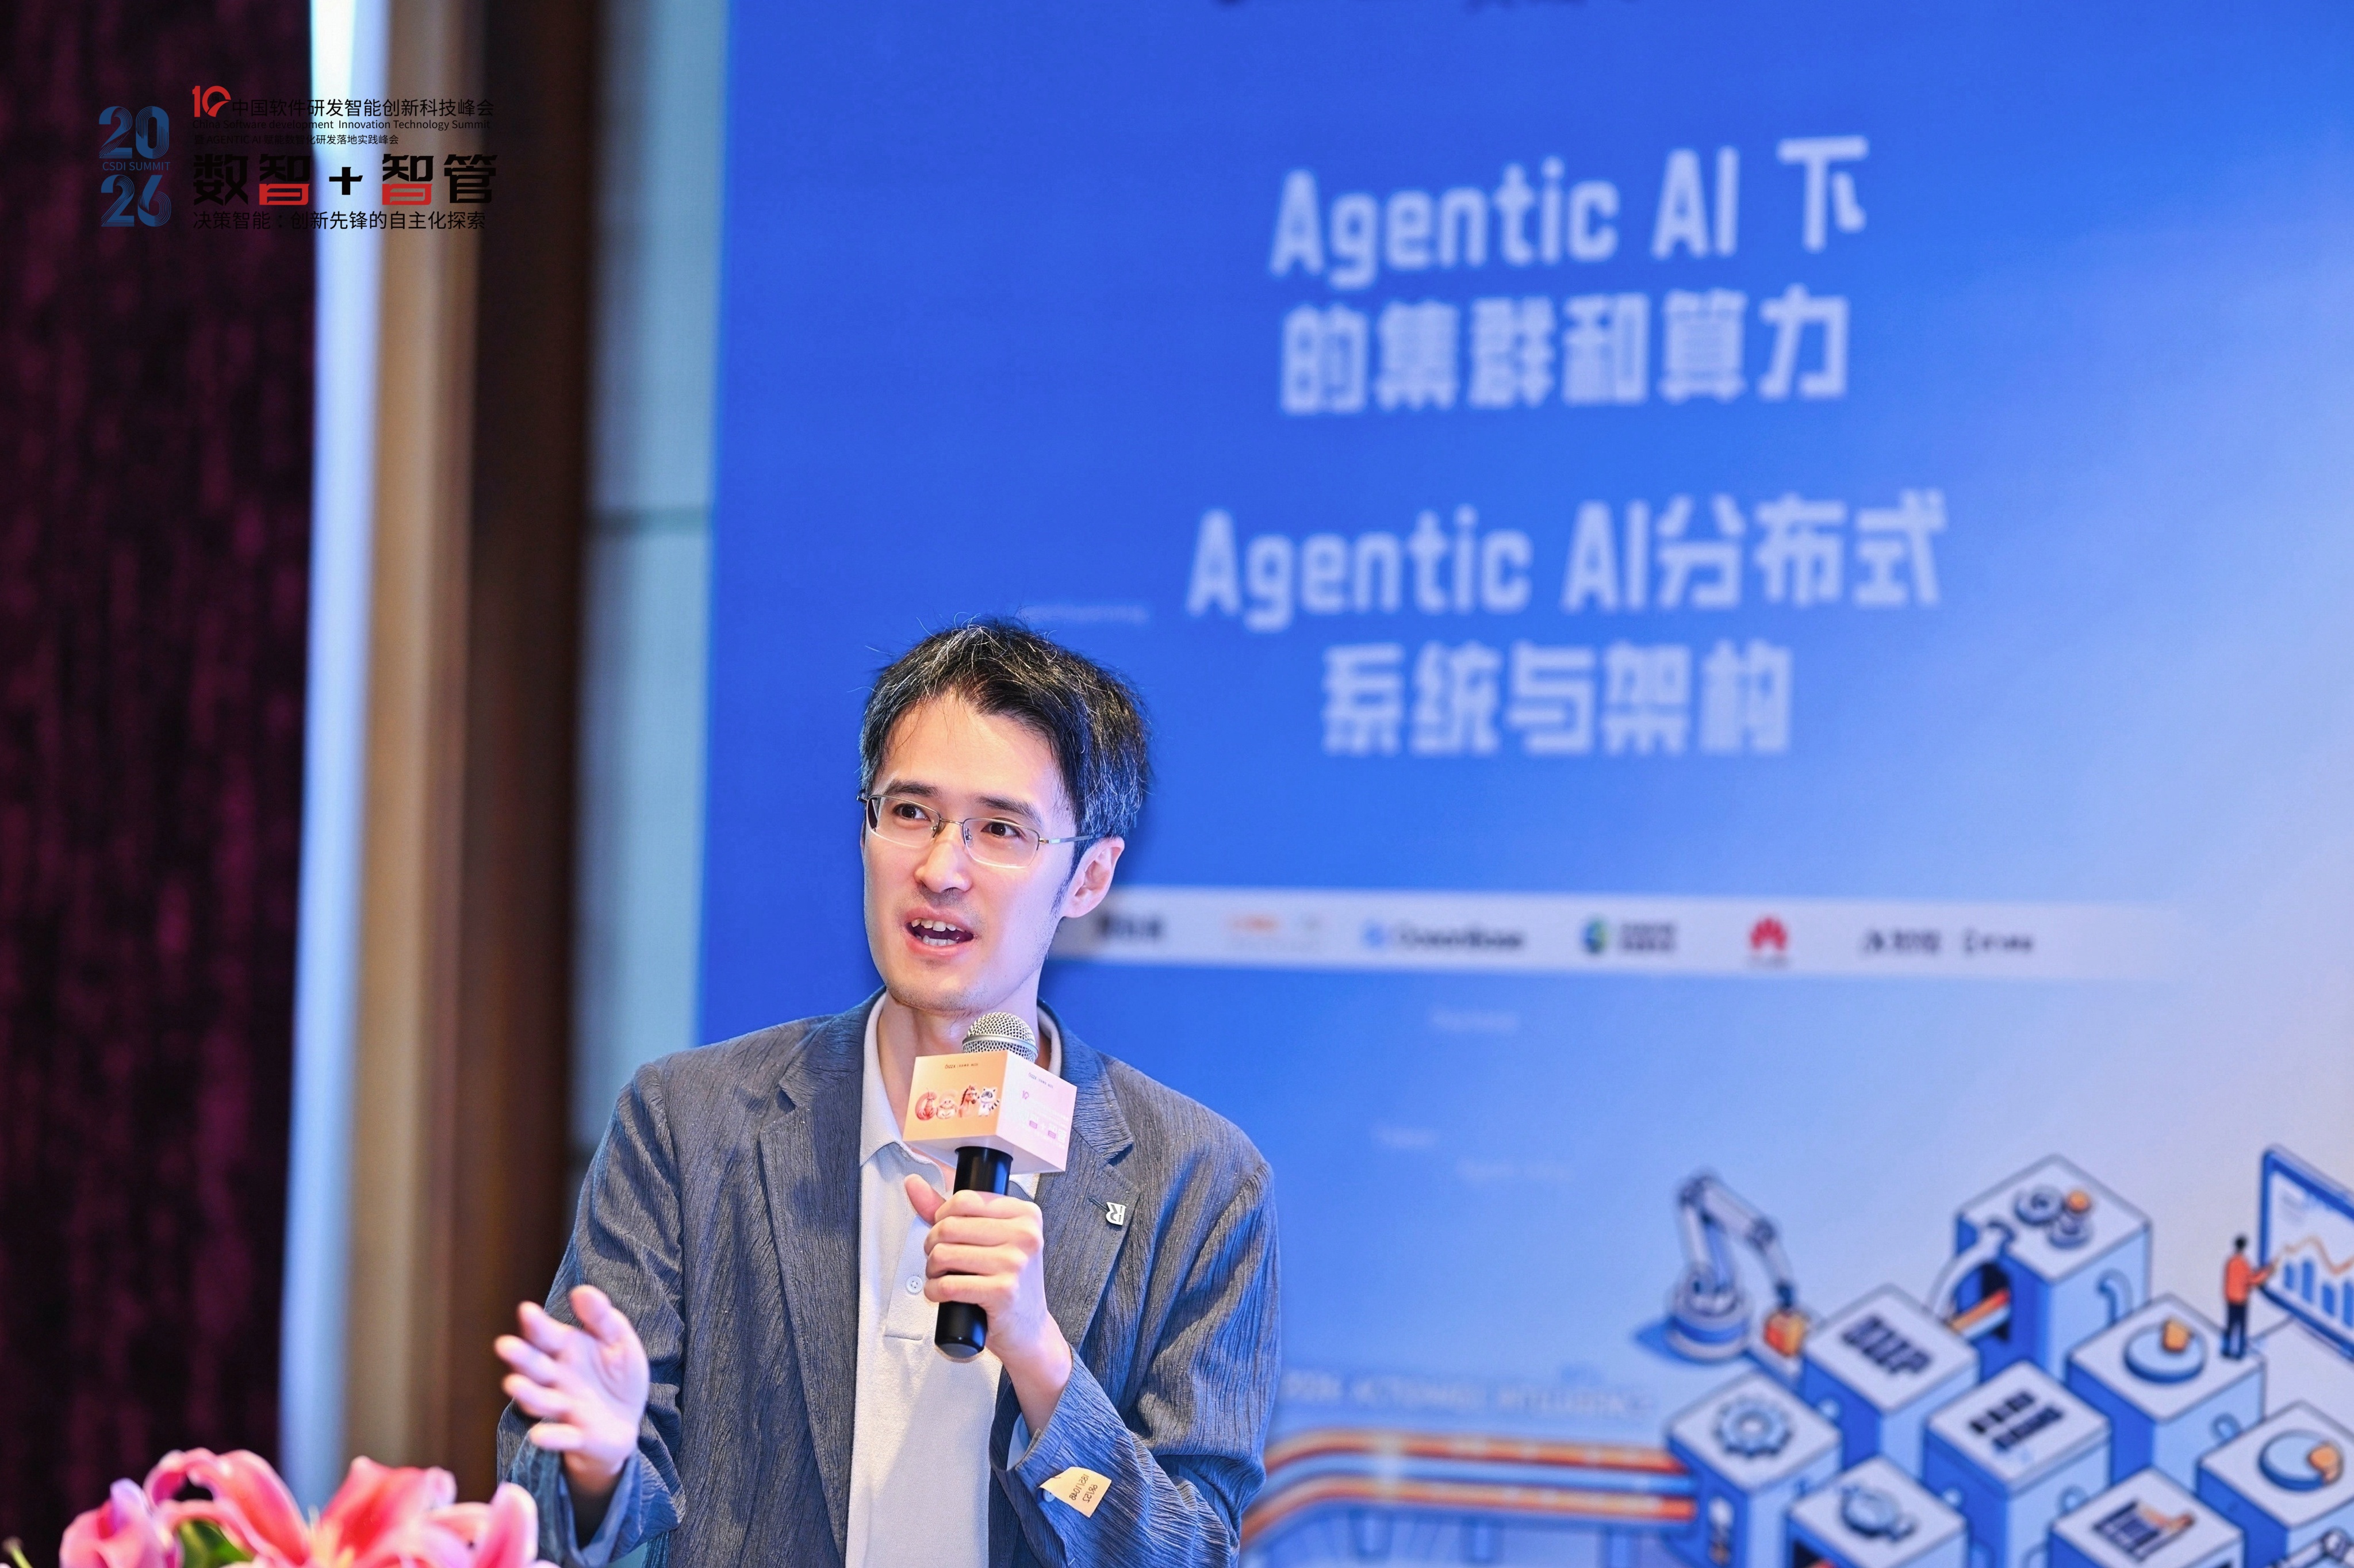
Auf dem 10. CSDI Summit teilte Dynamia-Mitgründer und CTO Mengxuan Li Praktiken zur vLLM-Inferenzcluster-Optimierung — darunter, wie Request-Routing, Cache-Management und GPU-Sharing zusammenwirken, um Inferenzerlebnis, Auslastung und Kosten auszubalancieren.
Auf dieser Seite
Vom 16. bis 18. Oktober 2026 fand der 10. CSDI China Software R&D Intelligent Innovation Technology Summit & Agentic AI Empowering Digital R&D Practice Summit, ausgerichtet von Bailinzhe, im Sheraton Grand China Hotel in Shenzhen statt. Unter dem Motto „Digital Intelligence + Intelligent Management“ lag der Schwerpunkt auf Agentic AI und Unternehmens-F&E-Praxis. Mengxuan Li, Mitgründer und CTO von Dynamia, war Producer der Spur „Clusters and Compute under Agentic AI“ und hielt einen Vortrag mit dem Titel Verbesserung der Unternehmens-Rechenauslastung und bessere GPU-Nutzung — vLLM-Inferenzcluster-Optimierung.
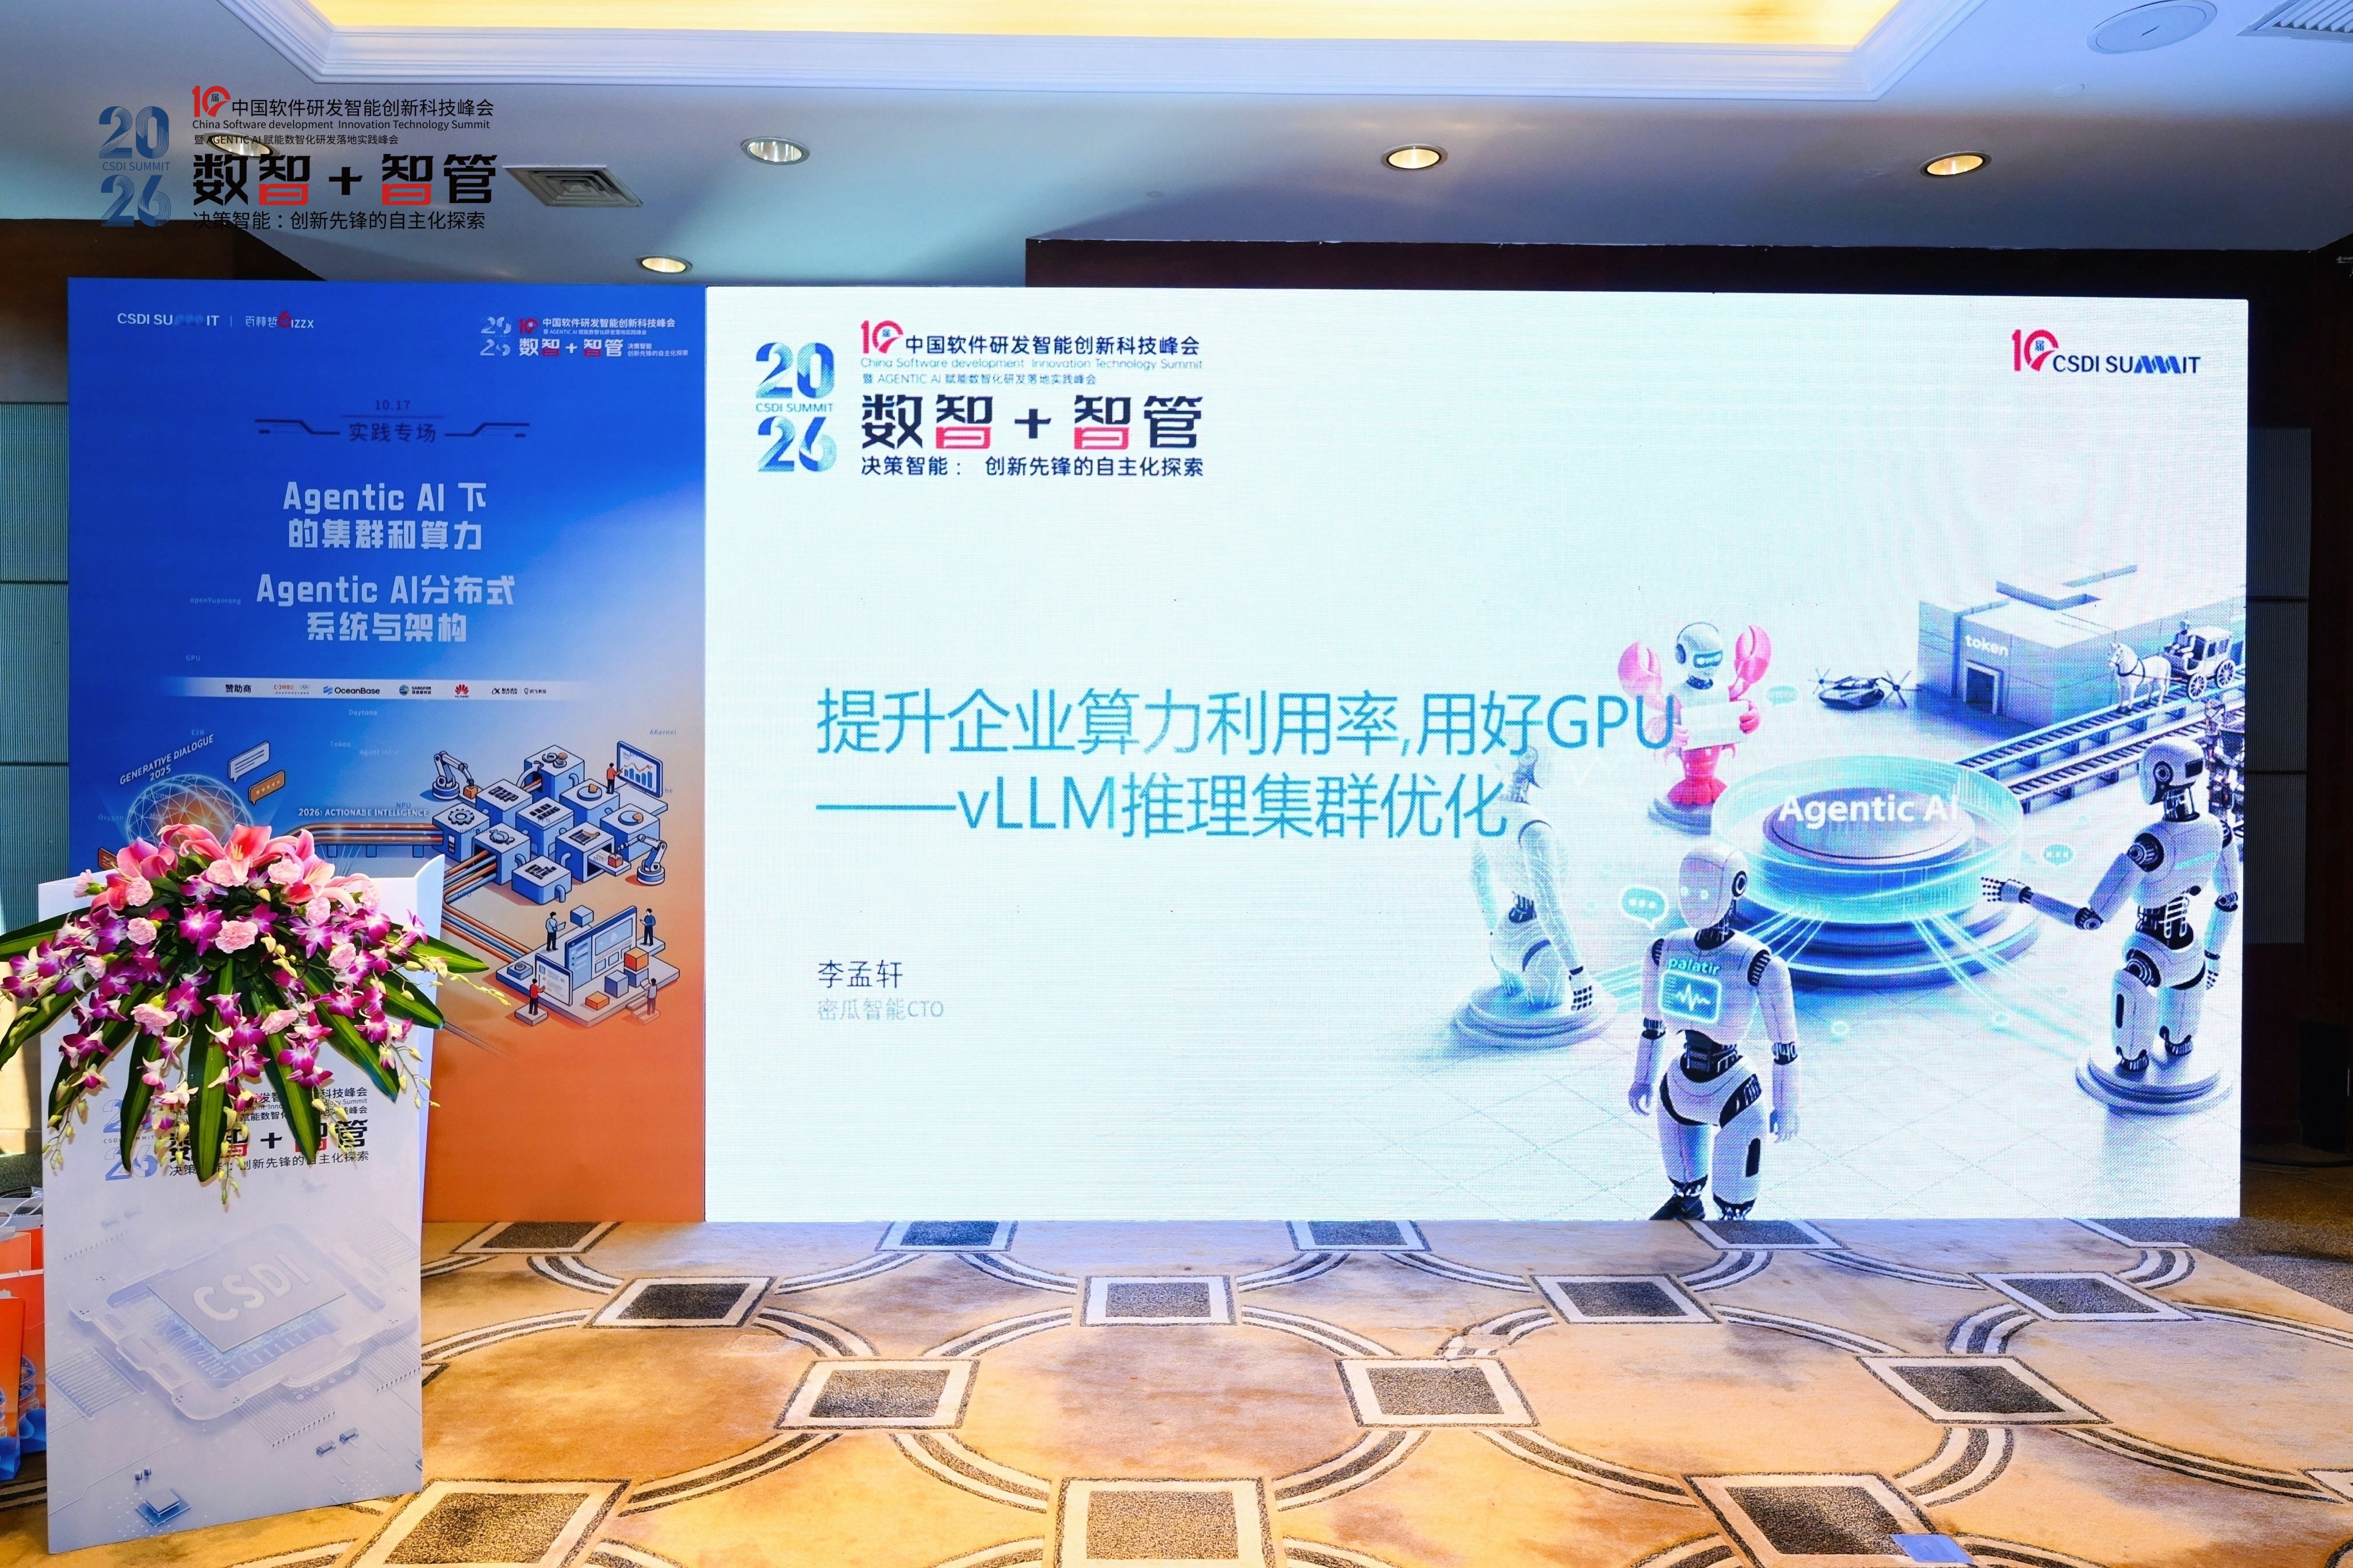
Die Themen des diesjährigen Summits reichten von Enterprise-KI-Plattformen und Agent-Produkten über F&E-Engineering bis zu verteilter Infrastruktur. Die Spur „Clusters and Compute under Agentic AI“ verband vLLM-Inferenzcluster-Optimierung, heterogenes Compute-Scheduling für KI-Workloads und den Aufbau von KI-Infrastruktur auf heterogener Rechenleistung — und verknüpfte Inferenz-Serving mit dem darunterliegenden Ressourcenmanagement. So erhielten Unternehmen eine mehrschichtige Sicht darauf, wie Compute Agentic-KI-Anwendungen trägt.
Inferenzcluster rund um Erlebnis und Kosten optimieren
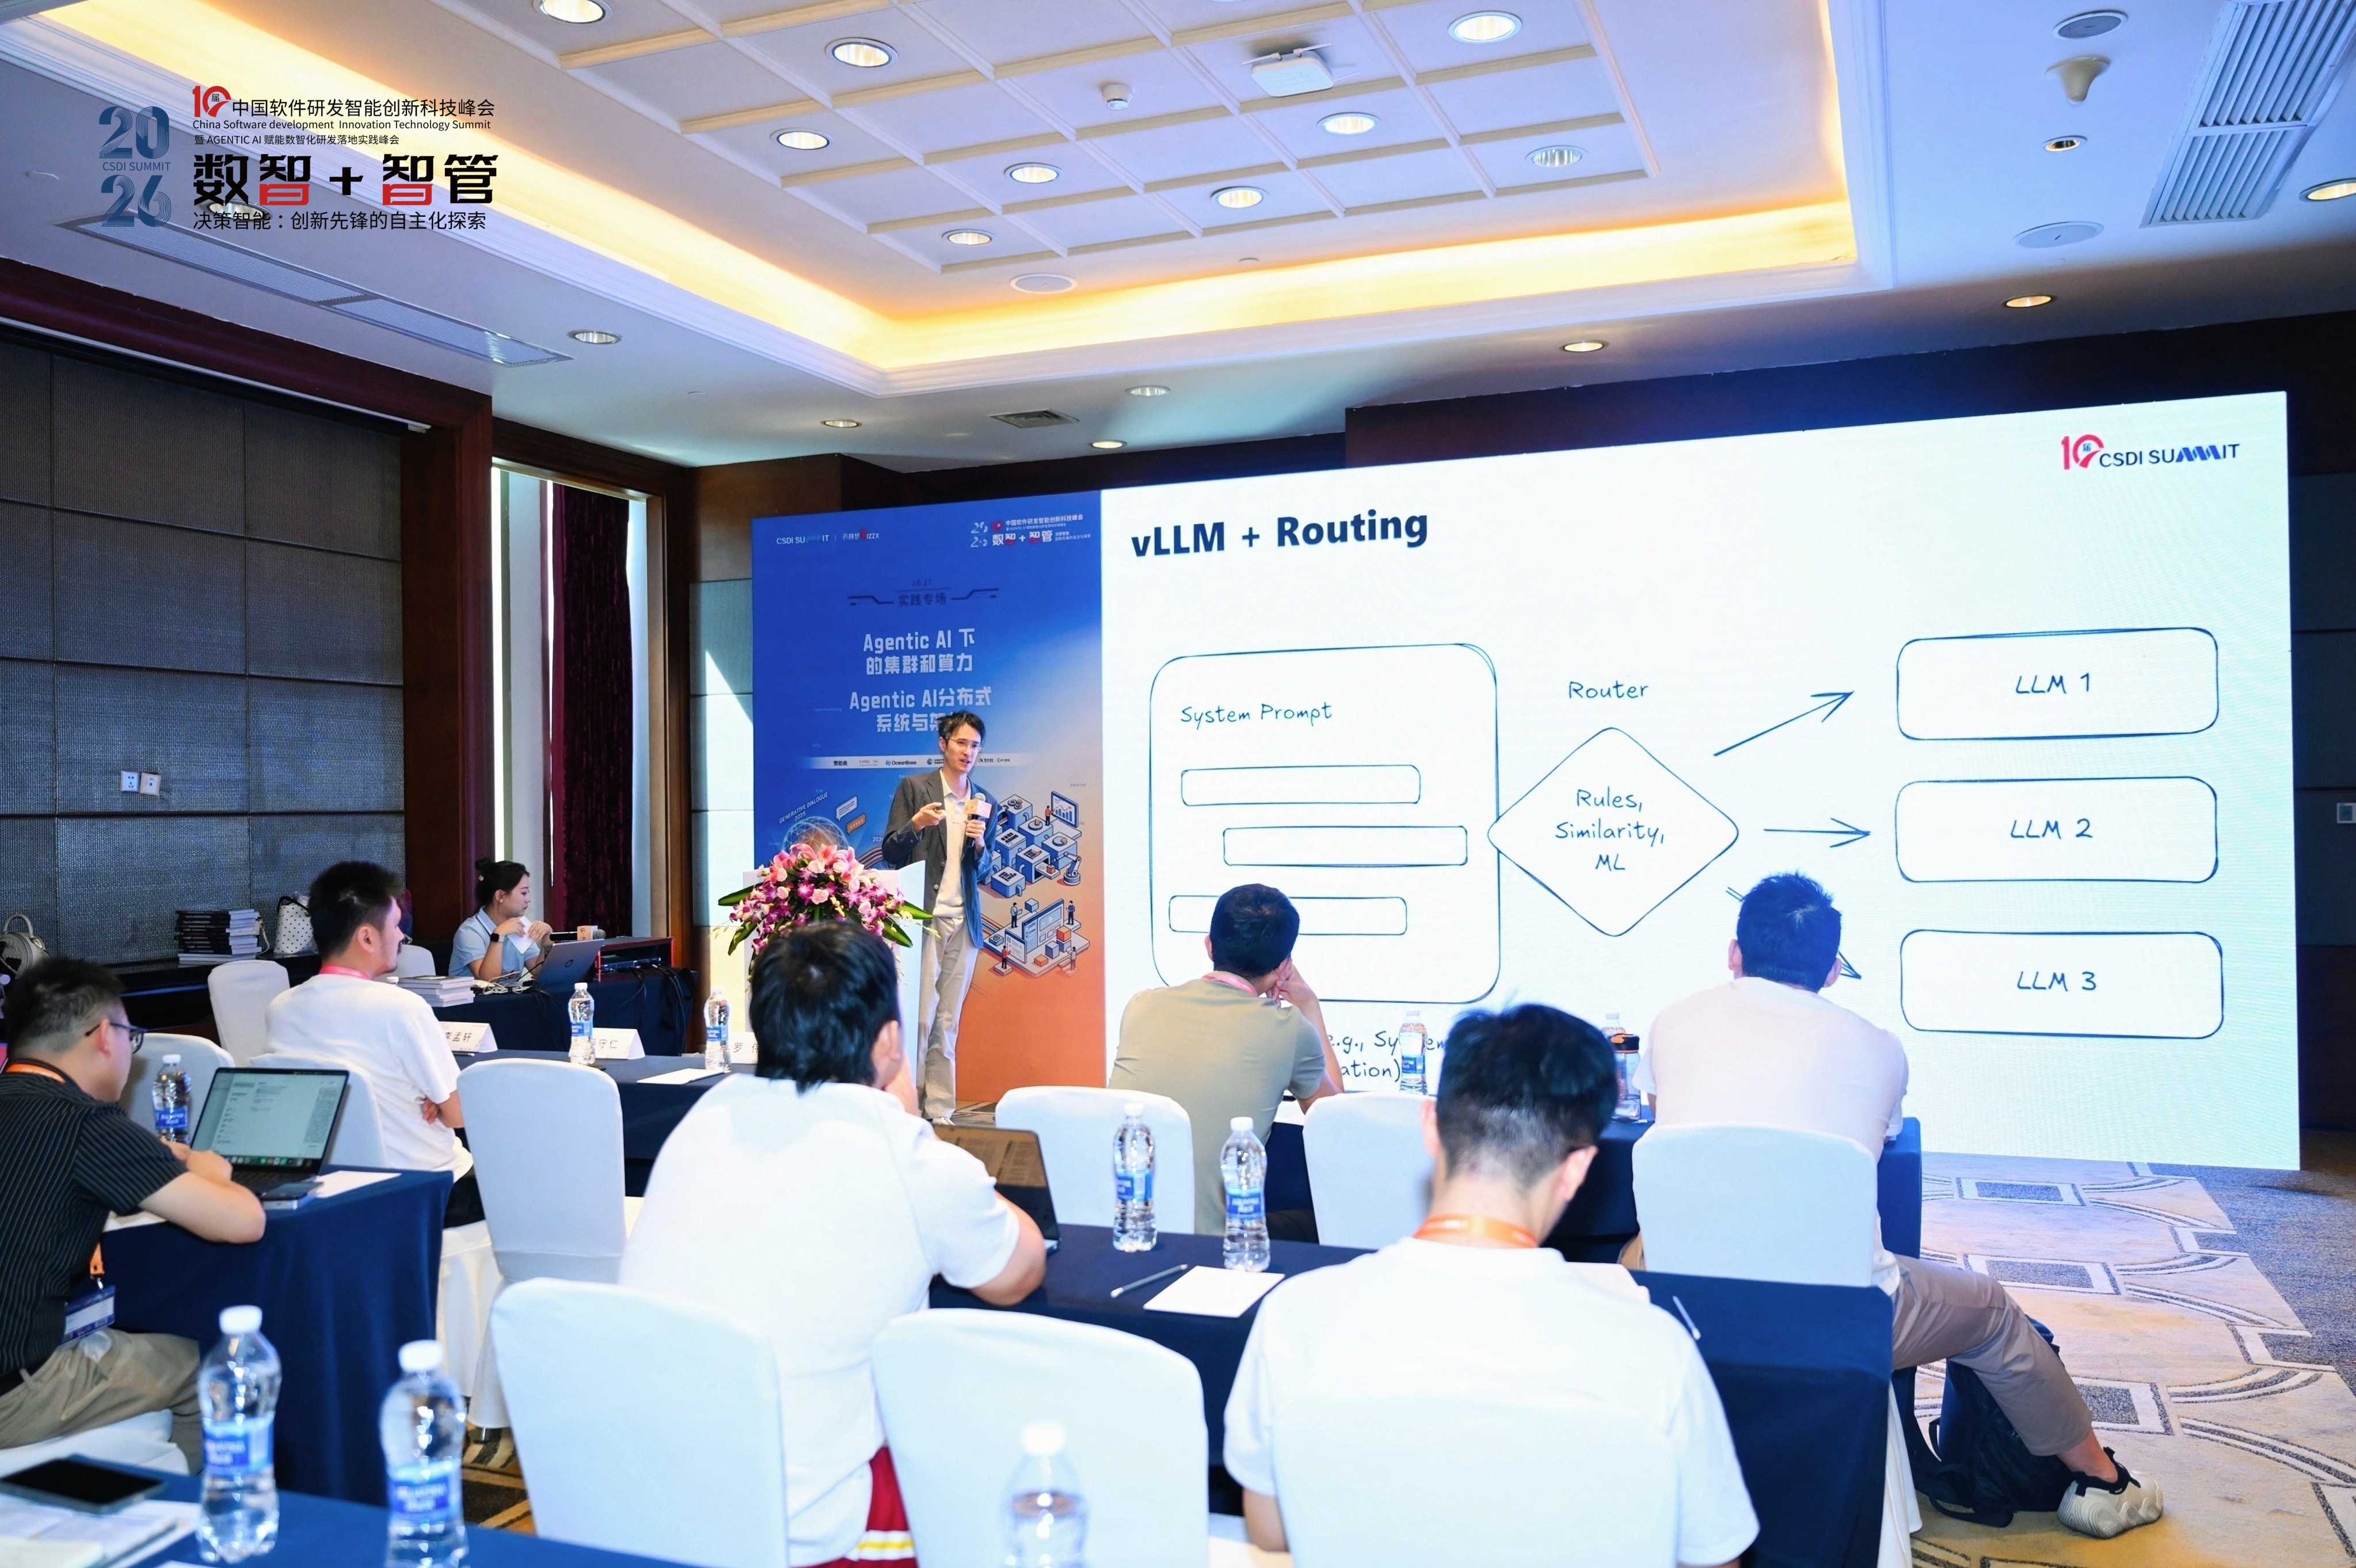
Auf der Bühne stand die Frage im Mittelpunkt: Wie organisieren Unternehmen vorhandene GPUs zu Inferenzdiensten, die im Erlebnis stabil und gut ausgelastet sind? Ausgehend von Metriken wie Time to First Token (TTFT) und Time per Output Token (TPOT) verband der Vortrag Inferenzoptimierung mit Token-Kosten und erläuterte das Zusammenspiel von Inferenz-Frameworks, Caching, Routing und Scheduling.
Entlang der Evolution von vLLM von Prozess über Cluster-Workload bis Dienst kartierte der Vortrag die Probleme in jeder Phase. Einzelknoten-Läufe helfen, Modellinferenz schnell zu validieren; in Clustern erfordern der stateful Charakter der Inferenz und Cache-Lokalität feinere Bereitstellung und Request-Platzierung. Mit llm-d ermöglichen cache-bewusstes Request-Routing, KV-Cache-Management und Prefill/Decode-(PD-)Trennung, Ressourcen nach den Anforderungen der Rechenphasen zu organisieren und Request-Handling mit Inferenzausführung besser abzustimmen.
Darauf aufbauend diskutierte der Vortrag die Rolle der GPU-Virtualisierung. Selbst mit optimierter Inferenzarchitektur kann die Vergabe einer vollen GPU pro Instanz bei manchen Modellen und Lasten Auslastungsreserven lassen. Die Folien zeigten eine Architektur mit HAMi für GPU-Slicing und -Sharing, damit Ressourcenzuteilung besser zu den tatsächlichen Bedürfnissen der Inferenzinstanzen passt.
Dieser Weg spiegelt laufende Abwägungen in der Produktion wider: Antwortgeschwindigkeit und flüssige Generierung beobachten und gleichzeitig prüfen, ob Ressourcen effektiv genutzt werden. Architekturentscheidungen sollten schrittweise mit Modellgröße, Request-Mustern und Servicezielen voranschreiten und unter realer Last auf das Gleichgewicht von Latenz, Durchsatz und Auslastung validiert werden. Diese Metriken gemeinsam zu betrachten, hilft, Inferenzoptimierung Kostenkontrolle und stabile Betriebsführung zu dienen.
Request-Routing und Compute-Management koordinieren
In der präsentierten Gesamtarchitektur übernimmt llm-d Request-Routing und Koordination zwischen Inferenzinstanzen auf der oberen Ebene, während HAMi darunter GPU-Slicing, Sharing und Scheduling bereitstellt. Beide optimieren jeweils von Request- und Ressourcenseite und verbinden Inferenznachfrage mit zugrunde liegender Rechenversorgung.
Das spiegelt eine konkrete Richtung der Arbeit von Dynamia an Open-Source-Infrastruktur wider: Über HAMi-Engineering-Praxis Compute flexibler für Workloads darüber nutzbar zu machen, damit Unternehmen vorhandene GPUs weiter verwalten und nutzen können, während Inferenz-Engines laufen. Inferenz-Engines, Service-Orchestrierung und Ressourcen-Scheduling haben jeweils ihre Rollen; wie sie zusammenwirken, müssen Unternehmen beim Aufbau von KI-Infrastruktur gemeinsam bedenken.
Ausgehend von dieser CSDI-Diskussion braucht nachhaltiger Agentic-AI-Betrieb das Zusammenspiel von Inferenz-Frameworks, Caching und Transport, Request-Routing, Ressourcen-Scheduling und heterogener Hardware. Dynamia wird die technische Zusammenarbeit mit der Open-Source-Community und Ökosystempartnern rund um die Positionierung als „Open-Source-Kern für KI-Infrastruktur“ fortsetzen, heterogene Rechenleistung über Open Source leichter nutzbar machen und so eine solideres Fundament für Enterprise-KI in der Produktion schaffen.