

HAMi v2.11.0 veröffentlicht: Mehr gemeinsame Nutzung heterogener Rechenressourcen für Enterprise AI
 Engineering
HAMi v2.11.0 erweitert Remote GPU, AMD-GPU-Sharing, Ascend ENPU, NUMA Refit und Flexible MIG und verbessert Scheduling-Sicherheit, Plattformkompatibilität und Beobachtbarkeit. Der Artikel stellt auch die Enterprise- und Platform-Editionen von Dynamia auf Basis von HAMi vor.
Auf dieser Seite
HAMi v2.11.0 ist veröffentlicht worden. Das CNCF-Incubating-Open-Source-Projekt wurde vom Dynamia-Team initiiert und wird von ihm weiter betreut.
Das Update entwickelt Remote GPU, AMD-GPU-Sharing, Ascend ENPU, NUMA-topologiebewusstes Scheduling und Flexible MIG weiter. Es verbessert die gemeinsame Nutzung, fein abgestufte Verwaltung und Planung heterogener Rechenressourcen und stärkt zugleich Scheduling-Sicherheit, Plattformkompatibilität und Laufzeitunterstützung.
Von der technischen Entwicklung des Open-Source-Projekts bis zu Unternehmensfunktionen für den Produktivbetrieb verfolgt Dynamia ein zentrales Ziel: Heterogene Rechenressourcen sollen KI-Anwendungen in Unternehmen flexibler, effizienter und zuverlässiger unterstützen.
HAMi v2.11.0
Mit zunehmender Komplexität von KI-Workloads in Unternehmen steigen die Anforderungen an das GPU-Management. Rechenressourcen liegen nicht immer auf denselben Knoten wie die Workloads, Beschleuniger verschiedener Hersteller müssen gemeinsam geplant werden, und komplexe Hardwaretopologien stellen höhere Anforderungen an die Zuweisung.
HAMi v2.11.0 erweitert die Virtualisierung und Planung heterogener Rechenressourcen für diese praktischen Szenarien.
Remote GPU
Herkömmlicherweise müssen GPU-Anwendungen auf Knoten mit GPU-Hardware und passenden Treibern laufen. Rechenaufgaben sind dadurch eng an die Knoten gebunden, auf denen sich die GPUs befinden.
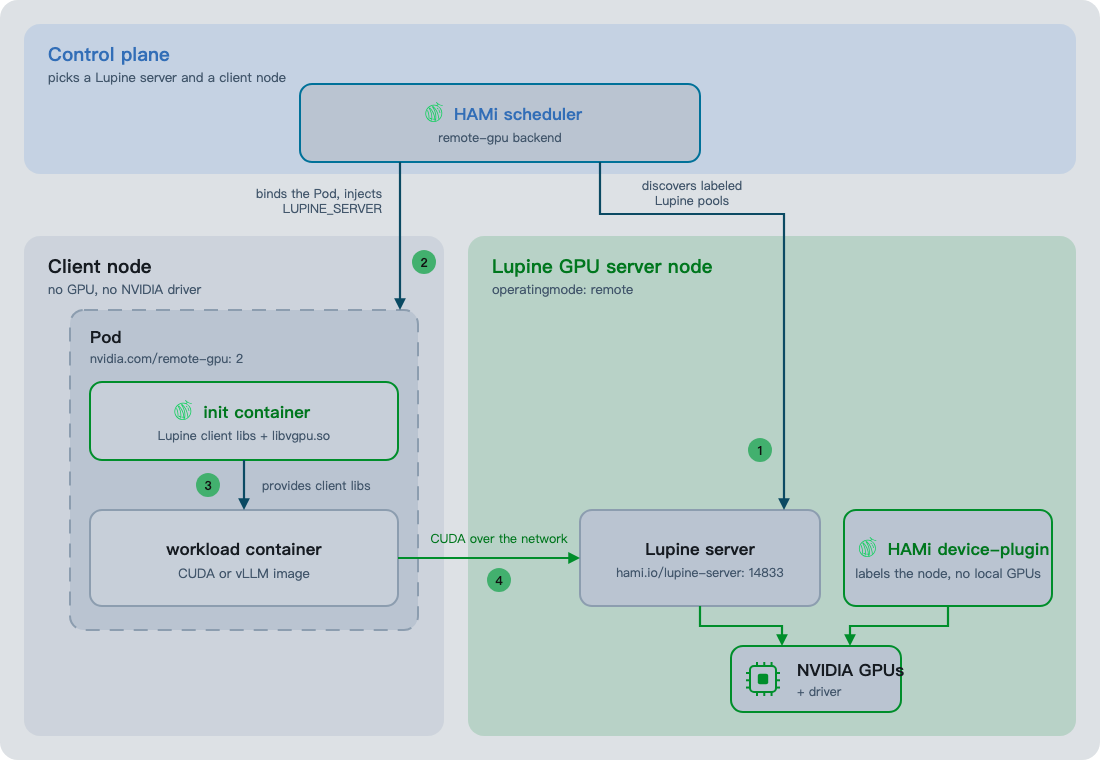
Diese Version führt Remote GPU auf Basis von Lupine ein. Client-Knoten ohne lokale GPU und ohne NVIDIA-Treiber können über das Netzwerk auf Ressourcen eines separaten GPU-Servers zugreifen und CUDA- sowie vLLM-Workloads ausführen.
Der HAMi-Scheduler wählt einen Client-Knoten und den zugehörigen Lupine-GPU-Server aus. Eine Client-Komponente ermöglicht anschließend den entfernten GPU-Zugriff. GPU-Server lassen sich mithilfe von Knoten-Labels in Ressourcenpools gliedern; Workloads können den gewünschten Pool angeben.
Remote GPU hat derzeit noch Einschränkungen: Client- und Server-Knoten müssen getrennt bereitgestellt werden, und Workloads reservieren jeweils einen ganzen GPU-Server. Die Funktion wird weiterentwickelt.
AMD-GPU-Sharing
GPUs verschiedener Hersteller verwenden unterschiedliche Schnittstellen und Laufzeitmechanismen zur Ressourcenverwaltung. Eine fein abgestufte gemeinsame Nutzung innerhalb eines einheitlichen Scheduling-Frameworks ist eine wichtige Voraussetzung für bessere Auslastung heterogener Cluster.
Nachdem v2.10.0 grundlegende Funktionen für Grafikspeicher, Rechenleistung und Geräteauswahl bei AMD-GPUs eingeführt hatte, verbessert v2.11.0 die native gemeinsame Nutzung und Planung von AMD Instinct GPUs (ROCm).
Für die Isolation können Workloads eine feste Größe oder einen Prozentsatz des GPU-Grafikspeichers anfordern. amd-hami-core setzt Grafikspeicherlimits auf Container-Ebene durch; Compute-Unit-Masken steuern den Anteil an Rechenleistung.
Das Scheduling wurde in folgenden Bereichen verbessert:
- Topologiebewusstes Scheduling: Berücksichtigt NUMA-Bindung und XGMI-Verbindungen und bevorzugt GPU-Kombinationen, die den Topologieanforderungen einer Aufgabe entsprechen.
- Mehrere Scheduling-Strategien: Unterstützt Binpack, Spread, Mutex und Topology-aware für unterschiedliche Zuweisungsanforderungen.
- Geräteauswahl und Priorität: Unterstützt die Auswahl oder den Ausschluss von GPU-Typen und UUIDs sowie die Prioritätssteuerung in Pod-Warteschlangen.
- Integration in das DRA-Ökosystem: AMD DRA Driver und HAMi-DRA erweitern Grafikspeicher- und Rechenlimits auf den Kubernetes-Pfad für Dynamic Resource Allocation.
Damit erhalten AMD-GPUs in HAMi vollständigere Mechanismen für Sharing und Scheduling. Zugleich wachsen die Möglichkeiten, NVIDIA-, AMD- und andere GPUs über eine einheitliche Scheduling-Schicht gemeinsam zu verwalten.
Ascend ENPU
Für Ascend-NPUs ergänzt diese Version einen ENPU-Partitionierungsmodus. Zusammen mit den bestehenden Template- und HAMi-core-Modi ergibt sich ein flexibleres Verfahren zur gemeinsamen Gerätenutzung.
ENPU unterstützt drei Isolationsstrategien:
- fixed-share: Isoliert einen festen Ressourcenanteil.
- elastic: Ermöglicht eine elastische Ressourcennutzung.
- best-effort: Ermöglicht gemeinsame Nutzung nach dem Best-Effort-Prinzip.
Außerdem kann ENPU Grafikspeicher- und Rechenkontingente direkt zuweisen, ohne auf feste Hardwarevorlagen aufrunden zu müssen. Die Isolation physischer DIEs behandelt nicht miteinander vereinbare Mandantenstrategien.
Neben dem neuen Isolationsmodus optimiert v2.11.0 hami-vnpu-core: weniger Lock-Konflikte bei der Initialisierung, verbesserte Berechnung des Ressourcenraums und verfeinerte Limits pro NPU.
NUMA Refit
Auf Servern mit mehreren GPUs bestehen komplexe NUMA-Beziehungen zwischen CPU, Arbeitsspeicher und GPUs. Liegen CPU und GPU auf verschiedenen NUMA-Knoten, können zusätzliche Kosten für knotenübergreifende Datenzugriffe entstehen und die Workload-Leistung sinken.
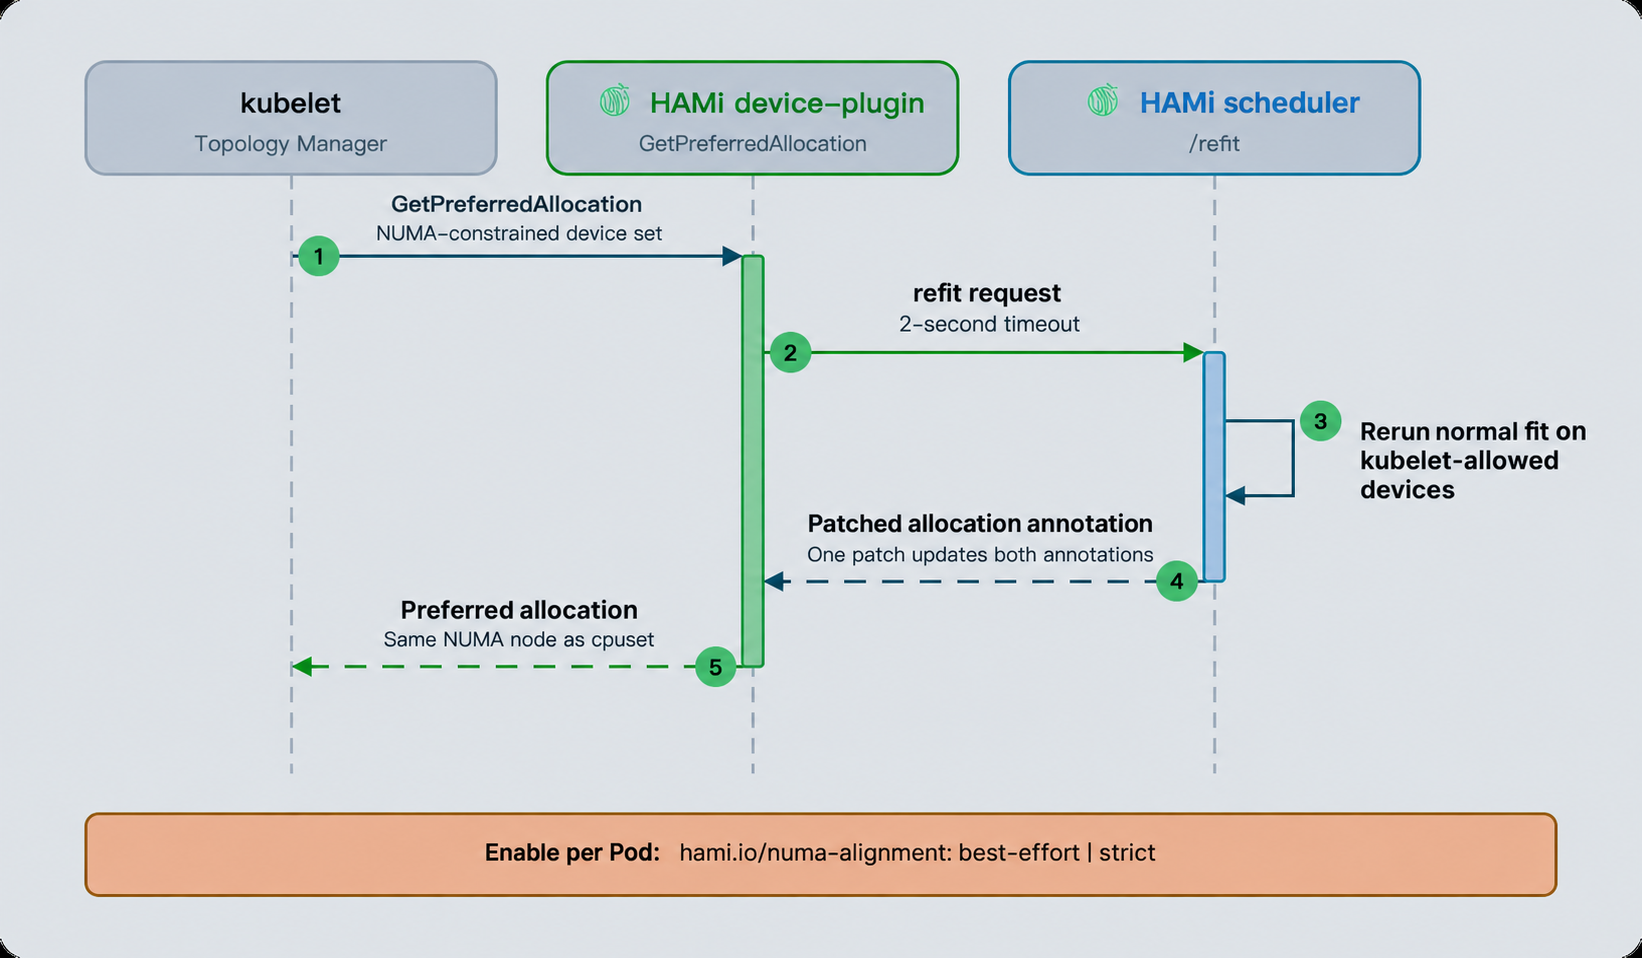
Bisher konnten HAMi-Scheduler und Kubernetes kubelet bei der topologischen Ressourcenzuweisung zu unterschiedlichen Ergebnissen kommen: Der Scheduler wählte eine GPU, während kubelet anschließend eine dazu nicht passende CPU-Affinität bestimmte.
Mit NUMA Refit kann HAMi die GPU-Ressourcen unter den Topologievorgaben von kubelet erneut abgleichen. CPU-Affinität und GPU-Platzierung bleiben dadurch nach Möglichkeit auf demselben NUMA-Knoten.
Der Mechanismus bietet die Ausrichtungsmodi strict und best-effort für strenge Topologievorgaben beziehungsweise Scheduling mit möglichem Fallback.
Bei Workloads, die auf ein effizientes Zusammenspiel von CPU und GPU angewiesen sind, kann dies die Zuordnung zur Hardwaretopologie verbessern und mögliche Leistungsverluste durch unpassende Platzierung verringern.
Flexible MIG
NVIDIA MIG (Multi-Instance GPU) unterteilt unterstützte physische GPUs in mehrere hardwareisolierte GPU-Instanzen, denen Ressourcen für verschiedene Workloads zugewiesen werden können.
Mit Flexible MIG führte HAMi in v2.10.0 die dynamische Erstellung und Freigabe von MIG-Instanzen ein. Version 2.11.0 verbessert die Laufzeitkompatibilität, Ressourcenplatzierung und Lebenszyklusverwaltung für dynamisches MIG weiter.
Wichtige Änderungen:
- CDI-Unterstützung: Dynamisch erzeugte MIG-Geräte unterstützen nun Container Device Interface (CDI) und lassen sich besser in kompatible Container-Laufzeiten integrieren.
- Platzierungsbewertung und Fallback: Die Platzierung von MIG-Ressourcen wird bewertet und bei ungeeigneter Erstauswahl erneut versucht.
- Profile-Präferenz pro Pod: Workloads können ein bevorzugtes MIG Profile angeben, um die Instanzgröße flexibler zu wählen.
- Lebenszyklus und Gesundheit: Verbesserungen bei der Freigabe und Überwachung von MIG-Instanzen sowie der Kennzeichnung fehlerhafter Geräte erhöhen die Zuverlässigkeit.
Diese Änderungen stärken die Ressourcenzuweisung von Flexible MIG bei dynamischen Workloads und bieten KI-Anwendungen mit NVIDIA MIG flexiblere Möglichkeiten für GPU-Partitionierung und Scheduling.
Weitere Verbesserungen bei Sicherheit, Kompatibilität und Beobachtbarkeit
Die Version enthält zudem Optimierungen für Sicherheit, Kompatibilität und Betrieb in Produktivumgebungen:
- Scheduling-Sicherheit und -Leistung: Scheduler Extender und Webhook wurden nach einem Sicherheitsaudit gehärtet. Pod-Identitätsprüfung und Schutz der Zuweisungsannotationen wurden verbessert; Scheduling-Filter, Ressourcensnapshots und Knotenbewertung wurden optimiert.
- Plattformkompatibilität: Anpassungen für OpenShift und SELinux sowie die Meldung von GPU-Grafikspeicher und Rechenleistung in Node Capacity / Allocatable verbessern die Zusammenarbeit mit Komponenten wie Cluster Autoscaler.
- Geräteökosystem und Beobachtbarkeit: Weitere Verbesserungen bei der Unterstützung verschiedener Hersteller, GPU-Gesundheitsmetriken, MIG-Monitoring und Ressourcennutzungsmetriken erhöhen die Transparenz in heterogenen Clustern.
Gemeinsam mit der Community entwickelt
Für HAMi v2.11.0 wurden mehr als 220 Pull Requests von über 50 Mitwirkenden zusammengeführt; 29 von ihnen trugen erstmals bei. Die globale Open-Source-Community entwickelt sowohl die grundlegenden Scheduling-Mechanismen als auch die Hardwareunterstützung gemeinsam weiter.
Als Initiator und wichtiger Maintainer von HAMi war das Entwicklungsteam von Dynamia maßgeblich an den zentralen Funktionen und ihrer Pflege beteiligt, darunter Remote GPU, Flexible MIG, Plattformkompatibilität und technische Verbesserungen:
- Release und Kernkomponenten: @archlitchi koordinierte die Version, arbeitete an Client-Werkzeugen für Remote GPU und Monitoring-Korrekturen und unterstützte Integration und Veröffentlichung.
- GPU-Virtualisierung und Ressourcenverwaltung: @FouoF verbesserte Flexible MIG, härtete den Remote-GPU-Modus und arbeitete an der automatischen Erkennung des NVIDIA-Treiberpfads.
- Plattformkompatibilität und Entwicklung: @spencercjh passte HAMi für OpenShift und SELinux an, überarbeitete die Konfigurationsarchitektur des Helm Chart und verbesserte die Installationsdokumentation.
Diese Beiträge reichen von GPU-Virtualisierung und Scheduling über Plattformintegration bis zur technischen Auslieferung. Sie zeigen Dynamias fortgesetzte Investition in Open-Source-Kerntechnologie.
Dies ist ein Überblick über die wichtigsten Änderungen dieser Version. Technische Details, Konfigurationsbeispiele, Einschränkungen und Hinweise zu Upgrade und Kompatibilität stehen im offiziellen Blog der HAMi-Community.
Von Open-Source-Innovation zur Unternehmensbereitstellung
Die kontinuierliche Entwicklung von HAMi schafft eine breitere technische Grundlage für die gemeinsame Nutzung und Planung heterogener Rechenressourcen.
In der Praxis müssen Unternehmen jedoch mehr lösen als die Frage, wie mehrere Aufgaben auf einer GPU laufen. Sie müssen geschäftskritische Anwendungen stabil halten, Rechengeräte verschiedener Hersteller einheitlich verwalten und den Betrieb über mehrere Cluster und Teams hinweg sichern.
Der Weg von Resource Sharing über zuverlässigen Produktivbetrieb bis zum einheitlichen Betrieb von Rechen- und Modelldiensten ist eine Aufgabe, die beim Aufbau von KI-Infrastruktur schrittweise gelöst werden muss.
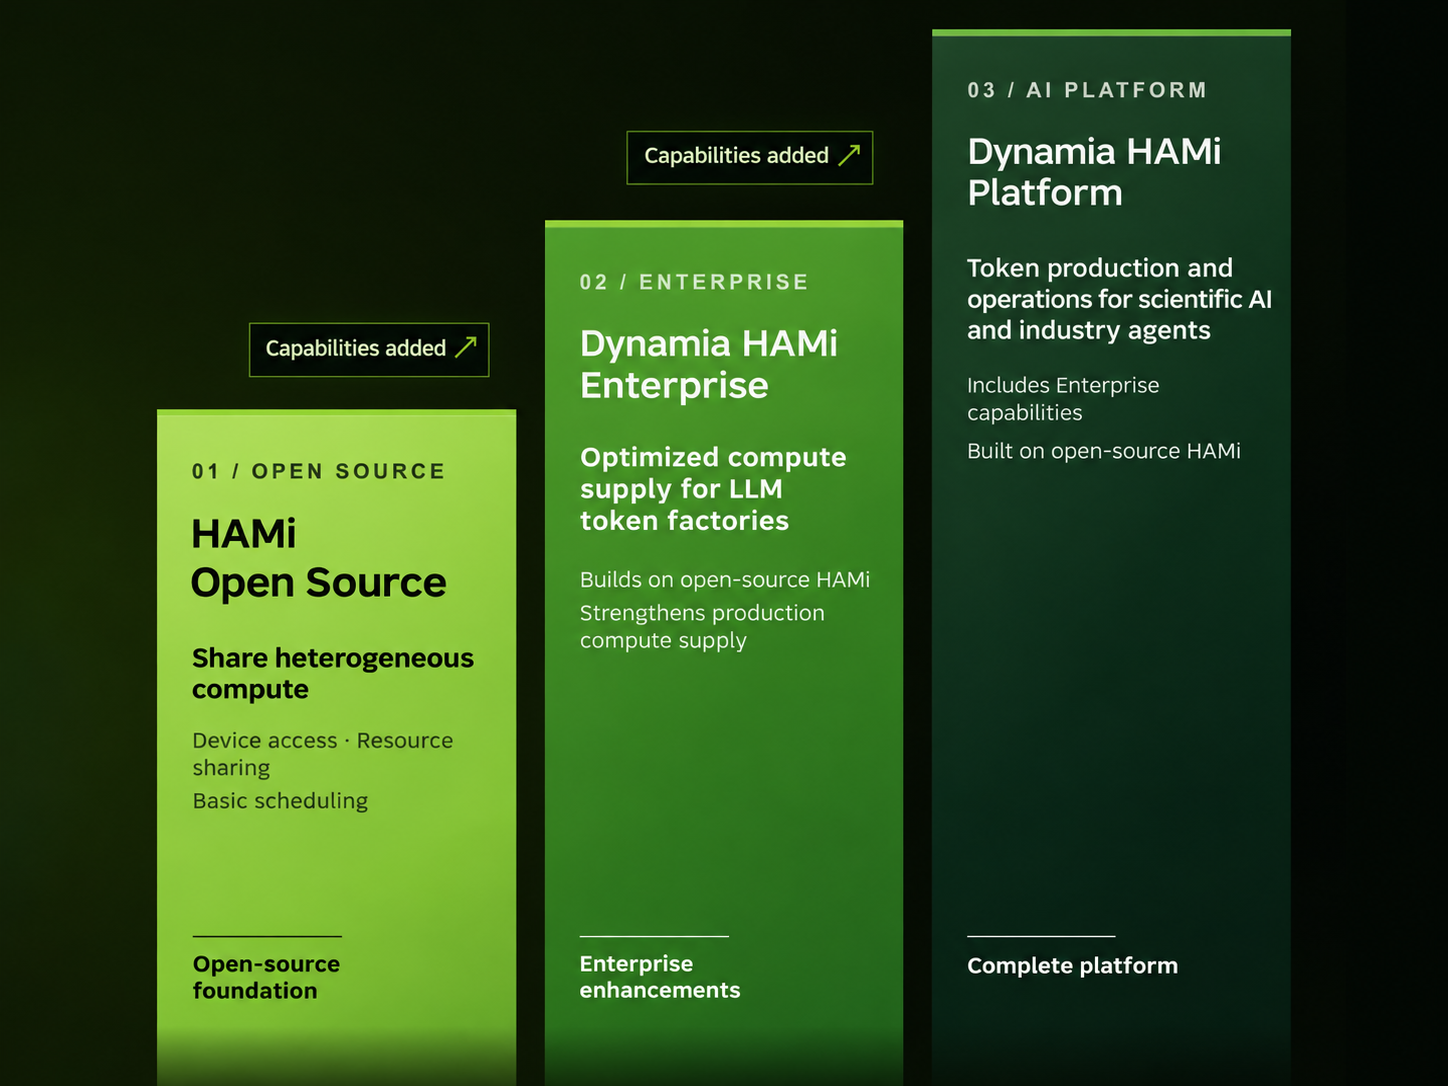
Als Initiator und Kern-Maintainer von HAMi entwickelt Dynamia Enterprise-Produkte auf derselben Open-Source-Technologie. Dynamia Enterprise for HAMi und Dynamia AI Platform for HAMi erweitern die Fähigkeiten um Auslieferung, Ressourcensteuerung und Plattformbetrieb für Unternehmen.
Dynamia Enterprise for HAMi
Dynamia Enterprise for HAMi erweitert Open-Source-HAMi um stärkere GPU-Virtualisierung, Ressourcenisolation und Scheduling und bietet eine effizientere, stabilere und besser kontrollierbare Grundlage für heterogene Rechenressourcen.
Um Anforderungen an Ressourceneffizienz und Geschäftskontinuität im Produktivbetrieb zu erfüllen, bietet die Enterprise-Edition zusätzliche Funktionen:
Feiner abgestufte Ressourcenverwaltung und Isolation
Aufbauend auf der gemeinsamen Nutzung von Grafikspeicher und Rechenleistung bietet die Enterprise-Edition stärkere Isolation, Überbelegung von Grafikspeicher und Rechenkapazität, den HAMi-Turbo-Modus und nahtlose automatische Anwendungsskalierung für flexiblere Zuweisung.
Auf Geschäftsanforderungen optimiertes Scheduling
Sie unterstützt parallele Optimierungen des Scheduling-Engines, Statistiken über freie Kapazitäten und Grafikspeicherbelegung sowie eine tiefe Integration mit Volcano. Das verbessert die Planung und Koordination komplexer Workloads.
Absicherung der Produktivbereitstellung
Die Enterprise-Edition bleibt quellkompatibel mit dem vorgelagerten HAMi. Dynamia bietet Produkthärtung, technischen Support, langfristige Wartung und SLA-Service, um Bereitstellung und langfristigen Betrieb zu vereinfachen.
Unternehmen, die Token-Fabriken für große Modelle, MaaS-Plattformen oder mandantenfähige GPU-Cluster aufbauen, sollen mit Dynamia Enterprise for HAMi verstreute, exklusiv belegte Rechenressourcen in gemeinsam nutzbare und flexibel zuweisbare Kapazität für elastischere Modelldienste verwandeln können.
Dynamia AI Platform for HAMi
Wenn die KI-Infrastruktur eines Unternehmens von einem Cluster auf mehrere Teams und Anwendungsszenarien wächst, reichen reine Rechenressourcenfreigabe und Scheduling nicht mehr aus.
Dynamia AI Platform for HAMi enthält alle Funktionen der Enterprise-Edition und ergänzt sie um Multi-Cluster-Verwaltung, visuelle Betriebsfunktionen und Ressourcenmanagement. Sie hilft Unternehmen, eine einheitliche, beobachtbare und betreibbare KI-Infrastruktur aufzubauen.
Einheitliche Multi-Cluster-Verwaltung und Beobachtbarkeit
Eine gemeinsame GUI und ein Dashboard zentralisieren clusterübergreifende Ressourcen, Workloads und den GPU-Zustand. Hardware-Monitoring, Alarmregeln und Betriebsbeobachtung erhöhen die Effizienz in komplexen Umgebungen.
Ressourcenkontingente und Mandantenbetrieb
Enterprise-Mandantenverwaltung, Ressourcenkontingente, Erfassung und Abrechnung sowie OpenAPI-Funktionen helfen, Zuweisung, Nutzung und Kosten der Rechenressourcen besser zu überblicken.
Modelldienste und Geschäftsanwendungen
Die Plattform verbindet Modelbereitstellung, Inferenzdienste und Laufzeitverwaltung, damit Unternehmen von der zugrunde liegenden Rechenkapazität bis zur Bereitstellung von Modelldiensten für ihre Anwendungen reichen können.
Kontinuierliche Open-Source-Entwicklung und vertiefte Enterprise-Funktionen
HAMi v2.11.0 ist ein weiterer wichtiger Schritt der Open-Source-Community bei entfernter GPU-Nutzung, Unterstützung heterogener Geräte und Scheduling.
Für Dynamia schafft diese Entwicklung eine stabile Grundlage für Enterprise-Produkte und bestätigt den technischen Wert von gemeinsam genutzter heterogener Rechenleistung und einheitlicher Planung.
Gleichzeitig erfordern Zuverlässigkeit im Produktivbetrieb, tiefgreifende Ressourcensteuerung, Multi-Cluster-Betrieb, visuelle Verwaltung und Modelldienste eigene Enterprise-Funktionen.
Dynamia wird sich weiter am HAMi-Open-Source-Ökosystem beteiligen und die Enterprise- und Platform-Editionen anhand konkreter Geschäftsanforderungen ausbauen: Heterogene Rechenressourcen sollen von der gemeinsamen Nutzung zu effizienter Versorgung und vom Infrastrukturmanagement zum dauerhaften Betrieb von KI-Diensten gelangen.
Open-Source-Innovation und Unternehmenspraxis verbinden, um den Nutzen heterogener Rechenressourcen weiter zu erschließen.