

HAMi GPU Descheduler: GPU-Defragmentierung in Kubernetes-Clustern
 Engineering
HAMi GPU Descheduler nutzt eine HamiPodPlacement-CRD und einen Admission Webhook, um GPU-Workloads zu verdrängen, neu zu erstellen und gezielt zu platzieren. So lassen sich verteilte vGPU-Ressourcen nach deklarativen Plänen konsolidieren.
Auf dieser Seite
GPUs gehören zu den kostspieligeren Ressourcen eines Kubernetes-Clusters. Ihr bedarfsgerechter Einsatz wird immer wichtiger. In Produktionsumgebungen teilen viele Teams GPUs, um die Ressourcen insgesamt besser auszulasten.
Bei längerem Clusterbetrieb stellt sich jedoch eine neue Frage: Warum lässt sich ein neuer Pod nicht einplanen, obwohl noch viel GPU-Kapazität frei ist?
Eine häufige Ursache ist die GPU-Fragmentierung. Wenn Pods erstellt, gelöscht, skaliert und neu aufgebaut werden, verteilen sich zuvor gebündelte GPU-Ressourcen zunehmend. Insgesamt kann viel Kapazität frei sein, ohne dass eine einzelne GPU die zusammenhängenden Ressourcen bereitstellen kann, die ein Pod benötigt.
Um dieses praktische Problem zu lösen, haben die HAMi-Community und Ingenieure der Yixin Group gemeinsam HAMi GPU Descheduler entwickelt und implementiert. Das Werkzeug bringt GPU-Defragmentierung in Kubernetes und führt verteilte GPU-Workloads entsprechend der gewünschten Platzierung zusammen.
Das Problem: Kapazität vorhanden, aber kein Platz
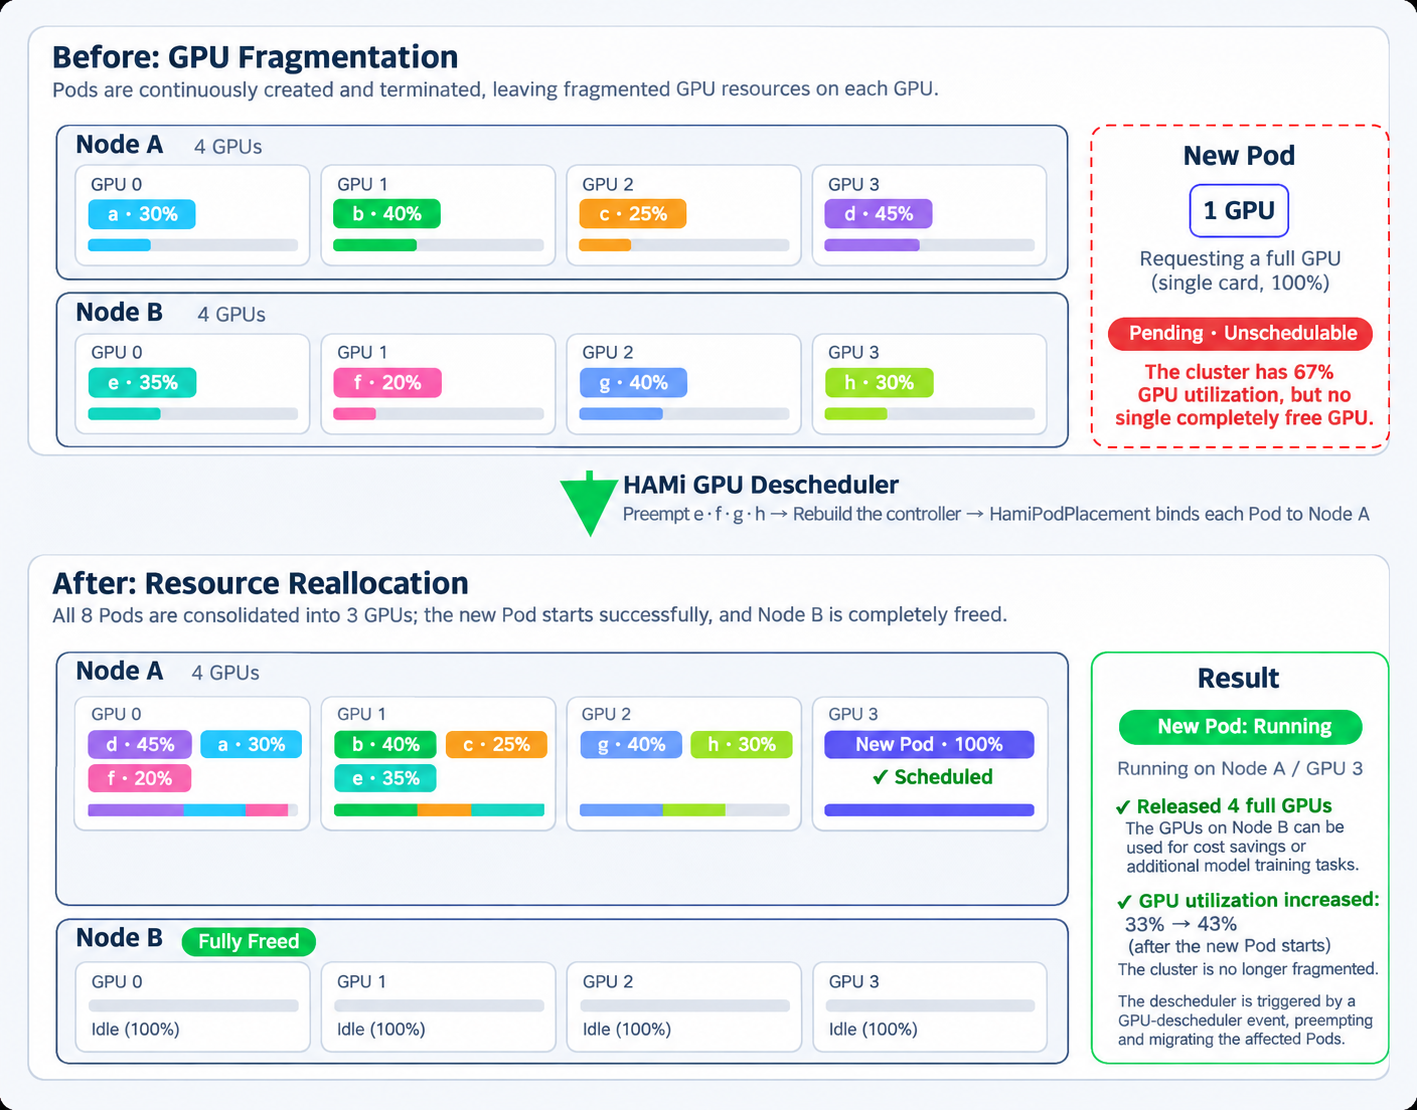
Betrachten wir einen Kubernetes-Cluster mit zwei Knoten, die jeweils vier GPUs über HAMi gemeinsam nutzbar machen.
Im laufenden Betrieb belegen acht Pods Ressourcen auf verschiedenen GPUs:
- Knoten A:
a30 %,b40 %,c25 %,d45 % - Knoten B:
e35 %,f20 %,g40 %,h30 %
Clusterweit sind nur 33 % des GPU-Speichers belegt. Ein großer Teil der Kapazität bleibt frei.
Trotzdem lässt sich ein neuer Pod, der eine ganze GPU anfordert, möglicherweise nicht einplanen.
Denn die freien Ressourcen sind auf keiner vollständig freien GPU gebündelt. Der Scheduler findet keinen Platz, der Pod bleibt im Zustand Pending, und ein großer Teil der GPU-Kapazität liegt brach.
Das ähnelt der Speicherfragmentierung: Gesamtkapazität ist nicht gleich aktuell verfügbarer zusammenhängender Kapazität.
Der Unterschied: Ein Speicherallokator kann Speicherfragmente zusammenführen, GPU-Fragmente jedoch nicht. Ein Pod, der eine ganze Karte benötigt, etwa ein Inferenzdienst ohne Modellparallelität, braucht ein vollständig freies Gerät. Über mehrere GPUs verteilte Fragmente lassen sich nicht zu einer ganzen Karte zusammensetzen.
Fragmentierung betrifft nicht nur Anforderungen ganzer GPUs. Jede vGPU-Anforderung, die den größten freien Anteil auf sämtlichen Geräten übersteigt, kann nicht platziert werden.
Benötigt ein Pod beispielsweise 70 % einer GPU, während auf jeder GPU höchstens 40 % zusammenhängend verfügbar sind, kann er trotz insgesamt reichlich freier Ressourcen dauerhaft Pending bleiben.
Eine hohe GPU-Auslastung bedeutet deshalb nicht automatisch, dass GPU-Ressourcen gut nutzbar sind.
Warum GPU-Fragmentierung zunimmt
GPU-Fragmentierung ist kein Bug. Sie entsteht leicht, wenn ein Cluster mit gemeinsam genutzten GPUs über längere Zeit dynamisch betrieben wird.
- Elastische Skalierung: Beim Herunterskalieren werden über mehrere Knoten verteilte Pods entfernt. Viele GPUs bleiben teilweise belegt.
- Rolling Updates: Neue Pods landen auf Knoten mit freien Ressourcen. Nach dem Entfernen alter Pods entstehen Lücken.
- Neustarts nach Fehlern: Trainingsaufgaben können bei jedem Neustart auf einem anderen Knoten landen.
- Gemischte Workloads: Inferenz-Pods mit 20 % bis 40 % GPU-Speicherbedarf verteilen sich zwischen Aufgaben, die ganze GPUs benötigen.
Das dauerhafte Nebeneinander unterschiedlich großer Ressourcenanforderungen verstärkt die Fragmentierung. Ein typisches Ergebnis: Die Gesamtauslastung sieht gut aus, doch die für große Aufgaben verfügbaren zusammenhängenden Ressourcen werden immer knapper.
Besonders problematisch ist, dass Fragmentierung oft die wichtigsten Aufgaben trifft. Kleine Pods finden weiterhin Lücken, während Aufgaben mit größerem GPU-Bedarf immer schwerer einzuplanen sind.
Die Schwierigkeiten manueller GPU-Defragmentierung
Die direkteste Lösung ist manuell: Fragmente aufspüren, verschiebbare Pods mit kubectl delete pod löschen, ihre Neuerstellung durch den Controller abwarten und auf eine passende Platzierung hoffen, gegebenenfalls mit Node-Selektoren. Das wird wiederholt, bis eine Karte genug freie Kapazität für den wartenden Pod hat.
Gelegentlich mag das funktionieren. Für dauerhaft betriebene Produktionscluster sind die Nachteile jedoch deutlich:
- Hoher manueller Aufwand: Jede Verdrängung erfordert eine Entscheidung darüber, ob die Aufgabe unterbrochen werden darf und wo sie anschließend laufen soll.
- Instabile Ergebnisse: Ein gelöschter Pod durchläuft erneut das Kubernetes-Scheduling. Ohne explizite Platzierungsvorgaben kann er anderswo landen und die neue Anordnung rasch wieder auflösen.
- Keine deklarative Platzierungsabsicht: Ohne dokumentierte Absicht verschlechtert sich die Verteilung erneut, und dieselben Schritte müssen wiederholt werden.
Teams benötigen eigentlich eine deklarative, einmalige Anweisung: Diese Workloads sollen auf den GPUs jenes Knotens zusammengeführt werden. Genau das ermöglicht HAMi GPU Descheduler.
HAMi GPU Descheduler
HAMi GPU Descheduler ist ein Werkzeug zur GPU-Defragmentierung für Kubernetes-Cluster mit HAMi-Virtualisierung.
Es führt über Knoten verteilte vGPU-Workloads mithilfe zweier Mechanismen zusammen:
- Mutating Admission Webhook
HamiPodPlacement-CRD
Seine Rolle ähnelt der eines Defragmentierungswerkzeugs für Festplatten: Verteilte Workloads werden gebündelt, damit auf den Geräten wieder zusammenhängende freie Kapazität entsteht.
Es ergänzt HAMi Scheduler. Der Scheduler übernimmt GPU-Virtualisierung, Scheduling und Isolation. Der Descheduler ordnet bereits laufende GPU-Workloads neu an, um eine kompaktere Ressourcenverteilung zu erreichen.
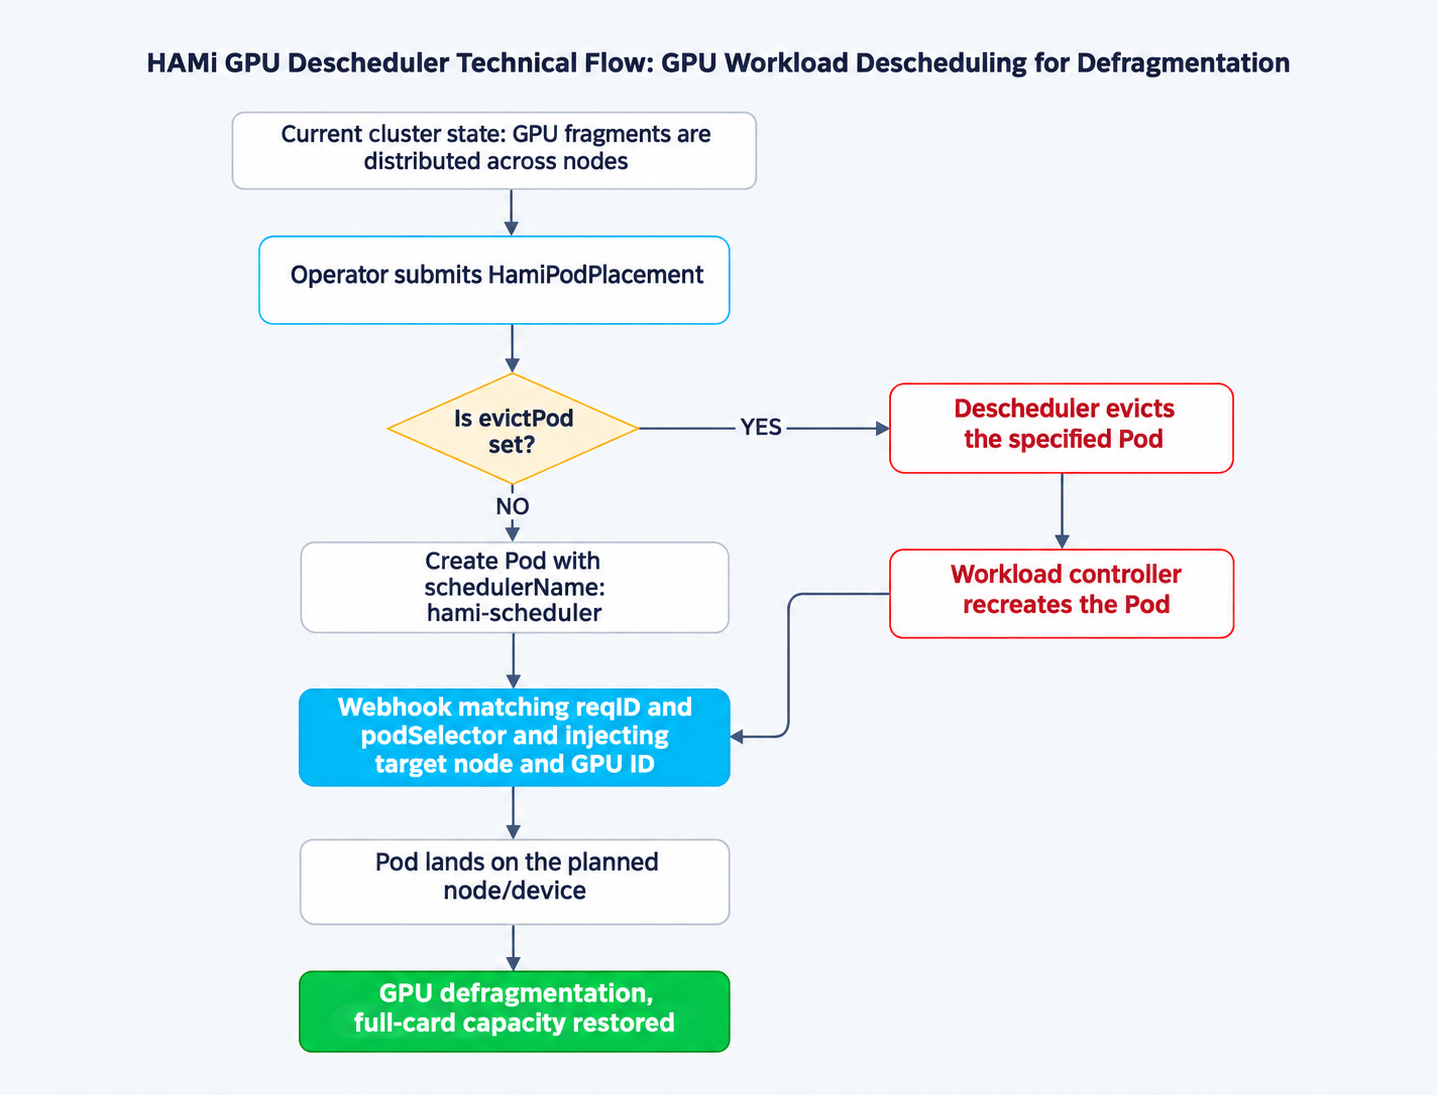
Der Ablauf sieht so aus:
- Ein
HamiPodPlacementbeschreibt die gewünschte Platzierung mit Zielknoten, GPU-Geräten und passenden Pods. Optional wird ein Pod angegeben, der zum Freigeben von Ressourcen verdrängt werden soll. - Ist
evictPodgesetzt, verdrängt der Descheduler diesen Pod und wartet. Der zuständige Controller, etwa ein Deployment oder StatefulSet, erstellt ihn neu. - Erreicht der neue oder neu erstellte Pod die Admission-Phase, ordnet der Webhook ihn über
reqIDundpodSelectoreinemHamiPodPlacementzu und injiziert die geplante Platzierung. - Der Pod wird auf dem festgelegten Knoten und den festgelegten GPU-Geräten eingeplant. Jedes
HamiPodPlacementwird von genau einem Pod verbraucht. Damit ist der Vorgang idempotent und nachvollziehbar.
Da die Platzierung als CRD beschrieben wird, wird Defragmentierung zu einem gewöhnlichen Kubernetes-Vorgang: deklarativ, in Git prüfbar und automatisierbar.
Diesen Cluster konsolidieren
Kehren wir zum eingangs beschriebenen Cluster mit zwei Knoten zurück.
Sechs einmalige HamiPodPlacement-Vorgänge reichen aus, um Knoten B zu leeren und auf Knoten A zusammenhängende Kapazität zu schaffen. Die Pods e, f, g und h wechseln von B nach A. c und d werden innerhalb von A neu festgelegt, sodass alle acht Pods auf den GPUs 0 bis 2 laufen.
Für Pod e sieht das beispielsweise so aus:
apiVersion: scheduling.hami.placement.com/v1
kind: HamiPodPlacement
metadata:
  name: consolidate-e
  namespace: default
spec:
  reqID: "defrag-e-0001" # 最短 5 个字符,仅消费一次
  podSelector:
    matchLabels:
      app: inference
  nodeName: gpu-node-a
  gpuDevices:
    - gpu-1 # 或 gpu-1/70 表示 GPU 1 的 70%
  evictPod: inference-e-6cd5964877-zdb5z # 需要驱逐并重新放置的 Pod
Bei podSelector ist ein Punkt wichtig: Der Selektor bestimmt, welcher Pod diese Platzierung verbraucht. Der erste passende Pod, der die Admission-Phase durchläuft, verbraucht sie.
Tragen alle Pods im Namespace das Label app: inference, kann statt e auch ein anderer zugehöriger Pod die Platzierung verbrauchen.
Labels wie pod-template-hash eines ReplicaSets lösen das Problem nicht. Alle Replikate desselben ReplicaSets tragen denselben Wert. Ein zuvor zugelassener anderer Pod kann die Platzierung weiterhin verbrauchen. Verwenden Sie ein Label, das nur der zu verschiebende Workload trägt und andere Pods ausschließt. Verschieben Sie bei mehreren Replikaten jeweils nur eines und vermeiden Sie die Verschiebung, während weitere zugehörige Pods erstellt werden.
Was evictPod bewirkt und wie es verwendet wird
evictPod ist das entscheidende Feld, das aus einer Platzierung eine Verschiebung macht. Es benennt einen laufenden Pod im selben Namespace und teilt dem Descheduler mit, welcher Pod seine GPU-Ressourcen zunächst für diese Platzierung freigeben muss.
Der Descheduler verdrängt zunächst den angegebenen Pod und wartet auf dessen Neuerstellung durch Deployment, StatefulSet oder einen anderen Controller. In der Admission-Phase gleicht der Webhook reqID und podSelector mit dem passenden HamiPodPlacement ab und legt den neuen Pod auf die geplanten Werte für nodeName und gpuDevices fest.
Ohne dieses Feld betrifft die Platzierung nur später erstellte Pods und dient als Planungswerkzeug. Mit dem Feld lassen sich laufende Workloads aktiv verschieben, wie es für die Defragmentierung erforderlich ist.
Dass dieses Feld optional ist, hat praktische Gründe.
Die Verdrängung erfolgt vor der Validierung des Ziels. Prüfen Sie deshalb vor dem Setzen des Feldes, ob nodeName und gpuDevices ein gültiges Ziel mit ausreichend freier Kapazität bezeichnen. Andernfalls findet der verdrängte Pod möglicherweise keinen Platz.
Außerdem wartet der Descheduler lediglich auf Ersatz-Pods und erstellt selbst keine. Verdrängte Workloads müssen deshalb von einem Controller verwaltet werden. Setzen Sie evictPod bewusst ein und verschieben Sie jeweils nur einen Pod.
Während jeder Pod verdrängt, neu erstellt und auf einer bestimmten GPU von Knoten A festgelegt wird, entsteht schrittweise der im Diagramm gezeigte Zustand: Acht Pods belegen drei GPUs, der neue Pod die vierte, und Knoten B ist vollständig frei. Ohne zusätzliche Kapazität werden vier ganze GPUs zurückgewonnen. Die clusterweite GPU-Speicherauslastung steigt von 33 % auf 43 %, ausschließlich durch den zuvor nicht startbaren neuen Pod.
Der freie Knoten kann zur Kostensenkung entfernt werden oder Trainingsaufgaben für große Modelle übernehmen, die ganze GPUs benötigen.
Vor der Verdrängung
Eine aktive Verdrängung beendet laufende Pods und kann die Verfügbarkeit kurzzeitig reduzieren. Ein Controller wie Deployment oder StatefulSet muss die Workloads verwalten, damit die Pods neu erstellt werden. Prüfen Sie vor der Konsolidierung Bereitschaft und Unterbrechungsschutz der Workloads.
Schnellstart
Die Bereitstellung erfolgt mit Helm. Erforderlich sind HAMi Scheduler v2.10.0+ und Kubernetes v1.24+. Empfohlen wird Kubernetes v1.28+.
git clone https://github.com/Project-HAMi/gpu-descheduler.git
cd gpu-descheduler
helm install gpu-descheduler ./chart --namespace kube-system --create-namespace
Prüfen Sie, ob der Webhook läuft:
kubectl get pods -n kube-system -l app=gpu-descheduler-webhook -w
Der Webhook bietet auf Port 8083 außerdem eine REST-API für den GPU-Status im Cluster und Platzierungsdatensätze. Diese Informationen helfen bei der Entscheidung, was konsolidiert werden soll. Der Port wird nicht über einen Service bereitgestellt. Leiten Sie ihn zunächst auf den lokalen Rechner weiter. Der Befehl läuft dauerhaft, verwenden Sie daher ein separates Terminal:
kubectl port-forward -n kube-system deploy/gpu-descheduler-webhook 8083:8083
Fragen Sie anschließend die API ab:
# 查看节点、GPU 设备与健康状态
curl -s http://localhost:8083/api/v1/cluster-info

# 查看当前 Placement CRD 缓存与分配记录
curl -s http://localhost:8083/api/v1/placements
Ziel-Pods müssen schedulerName: hami-scheduler verwenden. Ihre Labels müssen mit dem podSelector im HamiPodPlacement übereinstimmen. Den vollständigen Ablauf beschreibt das Benutzerhandbuch.
Fazit
GPU-Fragmentierung ist ein Verfügbarkeits- und Kostenproblem, das mit der Dynamik eines Clusters wächst. Vorhandene Kapazität bleibt ungenutzt, während manuelle Konsolidierung fehleranfällig ist und ihre Absicht kaum nachvollziehbar festhält.
HAMi GPU Descheduler bietet dafür einen neuen Ansatz. Eine HamiPodPlacement-CRD beschreibt den Platzierungsplan. Ein Admission Webhook ermöglicht Verdrängung, Neuerstellung und gezielte Platzierung von Pods. Damit wird GPU-Defragmentierung zu einem flexibleren und kontrollierbaren Vorgang der Kubernetes-Ressourcenverwaltung.
HAMi Issue #2072 formulierte den Bedarf an GPU-Defragmentierung innerhalb eines Knotens.
Anschließend übernahm das Team der Trainings- und Inferenzplattform von Yixin den Entwurf und den Großteil der Implementierung der Webhook- und CRD-Lösung und stellte den Code der HAMi-Community als Open Source zur Verfügung.
Nach der Veröffentlichung des Repositorys beteiligten sich Maintainer und Anwender der Community weiter an Prüfung und Verbesserung.
Vielen Dank an alle, die Ideen, Code und Rückmeldungen beigesteuert haben.
Die Pläne zur GPU-Defragmentierung werden derzeit weiterhin von Menschen erstellt. Welche Pods zusammengeführt werden und welche Zielknoten und GPUs geeignet sind, erfordert menschliches Urteilsvermögen. Der Descheduler setzt diese Pläne präzise um. Workloads lassen sich bereits über Knotengrenzen hinweg verschieben.
Darauf aufbauend untersucht die Community weitere Automatisierung: GPU-Fragmente automatisch erkennen, mehrere mögliche Maßnahmenpläne zur Auswahl und Ausführung erzeugen und den Umfang der Konsolidierung von einzelnen Knoten auf den gesamten Cluster ausweiten.
Wenn Sie GPUs in einem dynamischen Cluster mit HAMi teilen, achten Sie auf Pods, die wegen fragmentierter GPU-Ressourcen lange Pending bleiben. Besonders deutlich zeigt sich das bei Anforderungen ganzer GPUs.
HAMi GPU Descheduler ausprobieren:
- Code und Releases: github.com/Project-HAMi/gpu-descheduler
- Benutzerhandbuch: GPU-Ressourcenfragmente mit HAMi GPU Descheduler konsolidieren