

Auf dem Weg zu globaler Open-Source-Infrastruktur: Eine vollständige Einführung in das CNCF-Incubating-Projekt HAMi
 Engineering
HAMi ist Open-Source-Middleware für Virtualisierung und Scheduling heterogener Rechenressourcen in Kubernetes. Sie bietet Ressourcenteilung, feingranulare Zuweisung, Laufzeit-Isolation und gerätebewusstes Scheduling für Beschleuniger wie GPUs und NPUs. Dieser Artikel führt das Projekt, das im Juli 2026 CNCF Incubating wurde, in fünf Dimensionen vor: Forschungskontext, Geschichte, Technikarchitektur, Community-Governance sowie Ökosystem und Anwendungen.
Auf dieser Seite
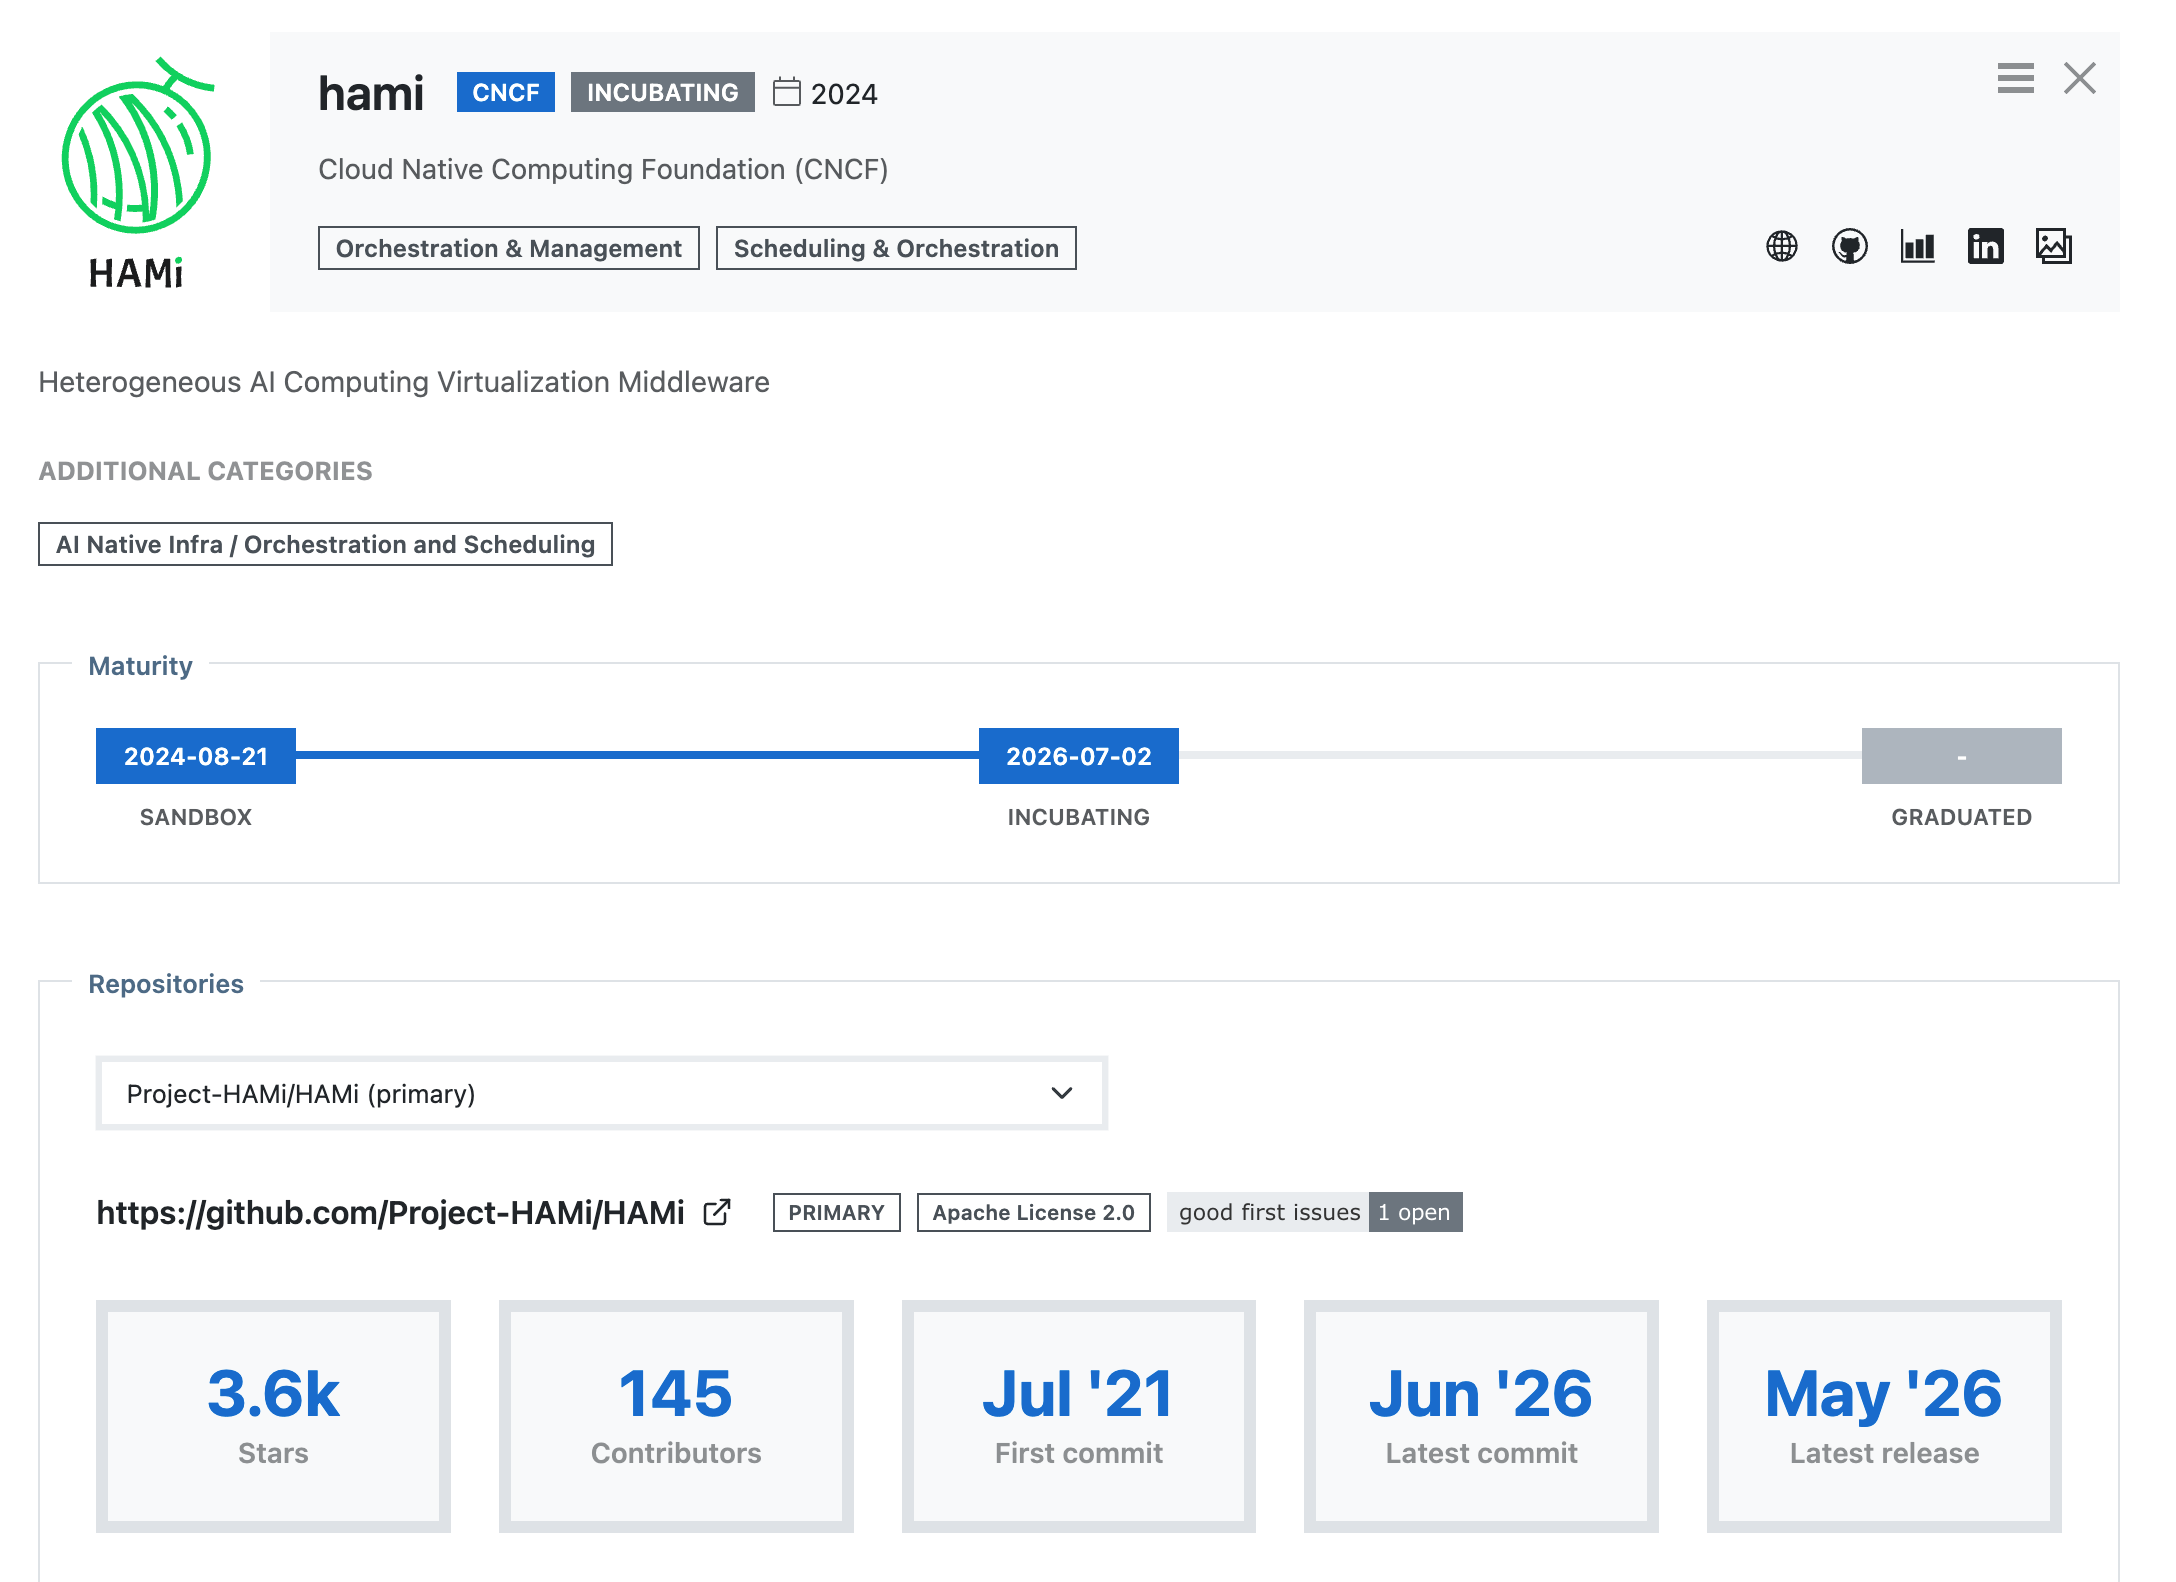
HAMi (Heterogeneous AI Computing Virtualization Middleware) ist Open-Source-Middleware für Virtualisierung und Scheduling heterogener KI-Rechenressourcen in Kubernetes. Sie bietet Ressourcenteilung, feingranulare Zuweisung, Laufzeit-Isolation und gerätebewusstes Scheduling für Beschleuniger wie GPUs und NPUs. HAMi unterstützt die Zuweisung von Beschleunigerressourcen nach Speicher, Rechenkernen oder Geräteanzahl und passt mehrere Hardwaretypen über ein einheitliches Kubernetes-Nutzungsmodell an.
HAMi wurde von Zhang Xiao und Li Mengxuan initiiert und mit Beteiligung von Entwicklern und Organisationen weltweit aufgebaut. Das Projekt trat am 21. August 2024 in die CNCF Sandbox ein und wurde am 2. Juli 2026 CNCF-Incubating-Projekt. Die Community-Governance folgt den vendor-neutralen Prinzipien der CNCF.
Dieser Artikel führt HAMi in fünf Dimensionen vor: Forschungskontext, Geschichte, Technikarchitektur, Community-Governance sowie Ökosystem und Anwendungen.
1. Forschungskontext
Mit dem Übergang von Machine-Learning- und KI-Workloads in Kubernetes-Umgebungen führte die traditionelle Ganzkarten-Zuweisung oft zu Fragmentierung und Unterauslastung von Beschleunigern. HAMi konzentriert sich auf feingranulares Teilen, Laufzeit-Isolation und gerätebewusstes Scheduling für heterogene Beschleuniger wie GPUs, damit mehrere Workloads Beschleuniger nutzen können, ohne Anwendungscode oder bestehende Kubernetes-Ressourcenmanifeste zu ändern.
Getrieben von Initiatoren und Maintainers wie Zhang Xiao und Li Mengxuan sowie Entwicklern weltweit entwickelte sich HAMi als Open-Source-Projekt weiter – von einem Ansatz für GPU-Teilen und -Scheduling zu Cloud-nativer Virtualisierungs- und Scheduling-Middleware für mehrere heterogene Beschleuniger.
2. Geschichte
Im März 2020 erfolgte der erste Code-Commit im HAMi-Projekt. Frühe Arbeiten untersuchten GPU-Teilen und -Scheduling in Kubernetes und bildeten schrittweise Virtualisierungs- und Scheduling-Fähigkeiten für heterogene Beschleuniger heraus.
Am 21. August 2024 wurde HAMi von der CNCF als Sandbox-Projekt aufgenommen und treibt offene Governance, technische Weiterentwicklung und Ökosystemaufbau im CNCF-Rahmen voran.
Am 2. Juli 2026 verabschiedete das CNCF Technical Oversight Committee die Inkubationsabstimmung für HAMi; HAMi wurde CNCF-Incubating-Projekt. CNCF-Ankündigungen zeigen, dass das Projekt die Anforderungen der Incubating-Stufe in Technik, Sicherheit, Community-Governance, Produktionsnutzung und Ökosystemintegration erfüllt hat und eine multi-organisatorische Contributor-Basis etabliert ist.
3. Technikarchitektur
Die Technikarchitektur von HAMi umfasst Module für Admission, Scheduling, Gerätemanagement, Laufzeit-Isolation und Observability:
- Mutating Webhook erkennt und verarbeitet heterogene Geräteressourcenanfragen;
- Scheduler Extender führt gerätebewusstes Scheduling auf Basis von Knoten- und Gerätestatus durch;
- hardwarespezifische Device Plugins registrieren und weisen Geräteressourcen in Kubernetes zu;
- HAMi-Core erzwingt Speicher- und Rechen-Isolation zur Container-Laufzeit;
- WebUI und Monitoring zeigen Gerätestatus, Ressourcenzuweisung und Nutzung.
HAMi unterstützt Anfragen nach Speicher, Rechenkernen und Geräteanzahl und bietet Scheduling-Strategien wie Concentrated, Spread und Topology-Aware. Über eine einheitliche Kubernetes-Schnittstelle passt das Projekt mehrere heterogene Beschleuniger an und reduziert Unterschiede in Hardwareverwaltung und Workload-Scheduling.
4. Community-Governance
HAMi nutzt ein Open-Source-Community-Modell, wird von der CNCF gehostet und nach vendor-neutralen Prinzipien geführt. Code-Beiträge, Issue-Tracking, Releases und technische Zusammenarbeit laufen über öffentliche Repositories. Teilnehmer können über Issues, Pull Requests und Community-Meetings beitragen.
HAMi wird gemeinsam von mehreren Organisationen und unabhängigen Entwicklern gepflegt. Governance-Dokumente zeigen, dass aktuelle Core Maintainer (Committers) von Dynamia, NVIDIA, 4Paradigm und unabhängigen Entwicklern kommen; unter ihnen sind die Projektinitiatoren Zhang Xiao und Li Mengxuan derzeit bei Dynamia. Diese multi-organisatorische Maintainer-Struktur spiegelt HAMis vendor-neutrale Governance im CNCF-Rahmen wider.
5. Ökosystem und Anwendungen
HAMi liefert heterogenes Compute-Ressourcenmanagement für das Kubernetes-Ökosystem und integriert sich mit oder arbeitet neben Scheduling- und Queue-Projekten wie Volcano, Koordinator und Kueue, damit Nutzer Geräteteilung, Isolation und Scheduling in verschiedenen Cluster-Scheduling-Systemen anwenden können.
HAMi kommt in Finanz, Internet und Cloud-nativer Infrastruktur zum Einsatz – u. a. für KI-Training und -Inferenz, GPU-Ressourcen-Pooling, höhere Cluster-Auslastung und Multi-Tenant-Isolation.
Der Eintritt in die CNCF-Incubating-Stufe ist ein neuer Ausgangspunkt für HAMi als globale Open-Source-Infrastruktur. Mehr zu Nutzung, Beiträgen und Produktionsfällen: HAMi-Website und GitHub-Repository.