
使用 Kubernetes 与 HAMi 的 GPU 虚拟化,扩展机器学习基础设施
13% → 37%
AIStudio 平台规模
AIStudio 平台规模
本文目录
背景
贝壳是一家位于中国、融合线上线下的房产交易及相关服务平台。为支撑快速增长的 AI 业务,集中式基础设施团队运营着各业务部门共用的机器学习平台。
团队为模型开发、训练和大规模推理提供端到端算力服务,同时支持内部研究负载和面向生产的 AI 服务。随着模型使用和请求量增长,GPU 效率与负载隔离成为关键平台要求。
| 关键成果 | 数据 |
|---|---|
| 平台 GPU 利用率 | 提升近 3 倍 |
| 同时运行的 Pod | 10,000 多个 |
| 每日处理请求 | 1,000 万以上 |
面临的挑战
随着机器学习业务扩大,基础设施团队在 GPU 资源管理方面面临多重挑战。
规模与复杂性: 平台拥有跨公有云与私有云的 5 个集群、数千张不同型号的 GPU,包括 H200、H20、V100、4090、H100 和 A100;每天承载数百万业务请求,同时运行超过 10,000 个 Pod,需要可靠且可扩展的基础设施。
混合云环境: 公有云覆盖火山引擎、腾讯云和阿里云,私有云包含约 1,000 张 NVIDIA GPU 的自建集群,需要跨环境管理 GPU 资源。
不同负载需求: 大模型训练显存需求高、运行时间长,需要整张 GPU;小模型推理服务较轻,通常仅需 1—2GB 显存,但要求高吞吐。
最初,多云复杂性和负载差异使整体 GPU 利用率仅为 13%,团队因此寻找提升集群资源利用率的方案。
解决方案
贝壳基础设施团队以 CNCF 项目 HAMi 和 Kubernetes 为基础,设计并实施 AIStudio 智算平台,作为组织机器学习基础设施的底座。平台通过 Kubernetes 与 HAMi 实现 GPU 虚拟化,连接上层 SaaS 服务和底层算力资源,提供以下能力:
- 多场景支持: 同时支撑推理服务、A/B 测试与训练任务,使不同负载在同一基础设施上高效共存。
- 优化与加速: 为推理框架、数据集、镜像、检查点和模型提供加速,并支持硬件故障容错,包括坏卡处理。
- 多框架支持: 支持 PyTorch、DeepSpeed、Megatron、vLLM、RLHF 和 SGLang,适应不同用例。
- AI 资产管理: 集中管理资源池、模型仓库、镜像仓库、队列、CubeFS 卷与监控组件,为 AI 相关资产提供统一入口。
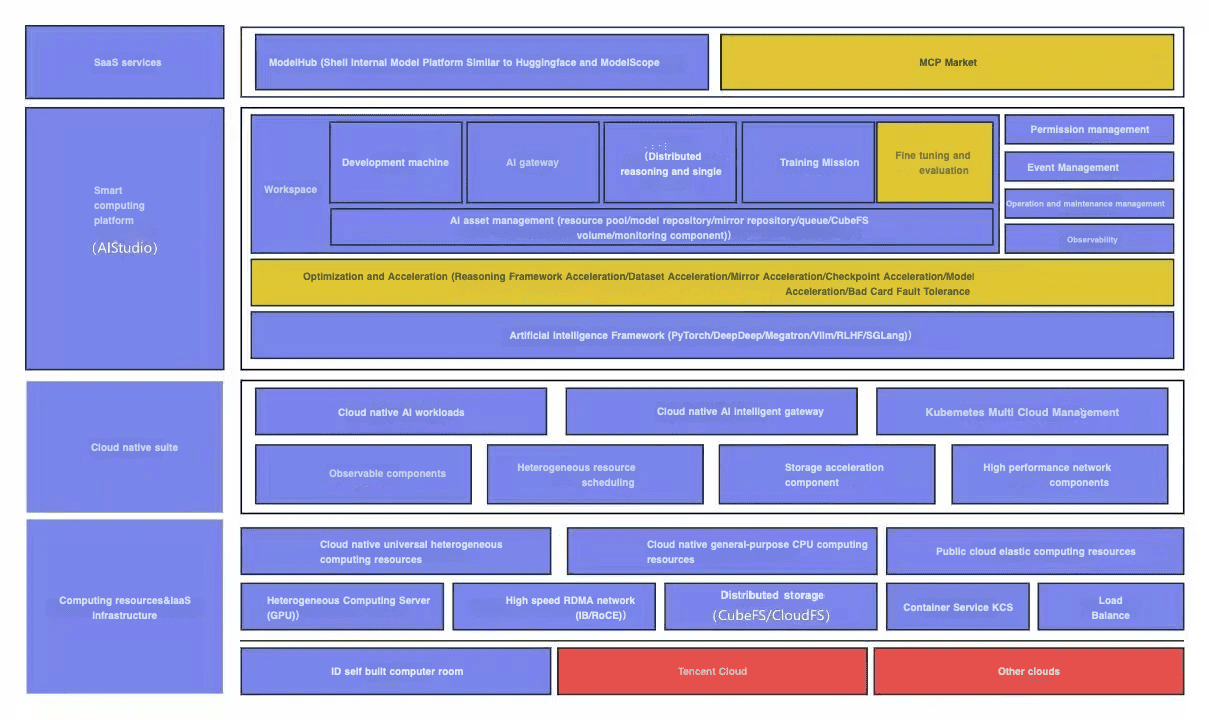
AIStudio 解决方案架构,来源:CNCF 原文。
为此,团队基于 Kubernetes 构建 GPU 资源管理平台,并使用 HAMi 实现 GPU 虚拟化。Kubernetes 具有出色的稳定性和集群调度管理能力,能显著降低大规模集群的运维复杂性与维护成本;其与 CNCF 开放生态的集成,也便于引入 HAMi 等适配不同场景的开源方案。团队选择 HAMi,是因为它的 GPU 复用和异构计算能力最符合 AIStudio 的需求。
团队采用双集群方式,按资源需求分离负载:
- GPU 集群: 由原生 NVIDIA device plugin 管理,采用 H200、H100 等高性能 GPU,专门运行需要完整 GPU 和可预期独占分配的大参数量 LLM 与训练任务。
- vGPU 集群: 由 HAMi 管理显存虚拟化,采用 H20、V100、A100、4090 等 GPU,为小模型推理服务细粒度分配显存,通常每个服务 1—2GB。场景包括 TensorFlow 推理和 Qwen 8B 等轻量语言模型。
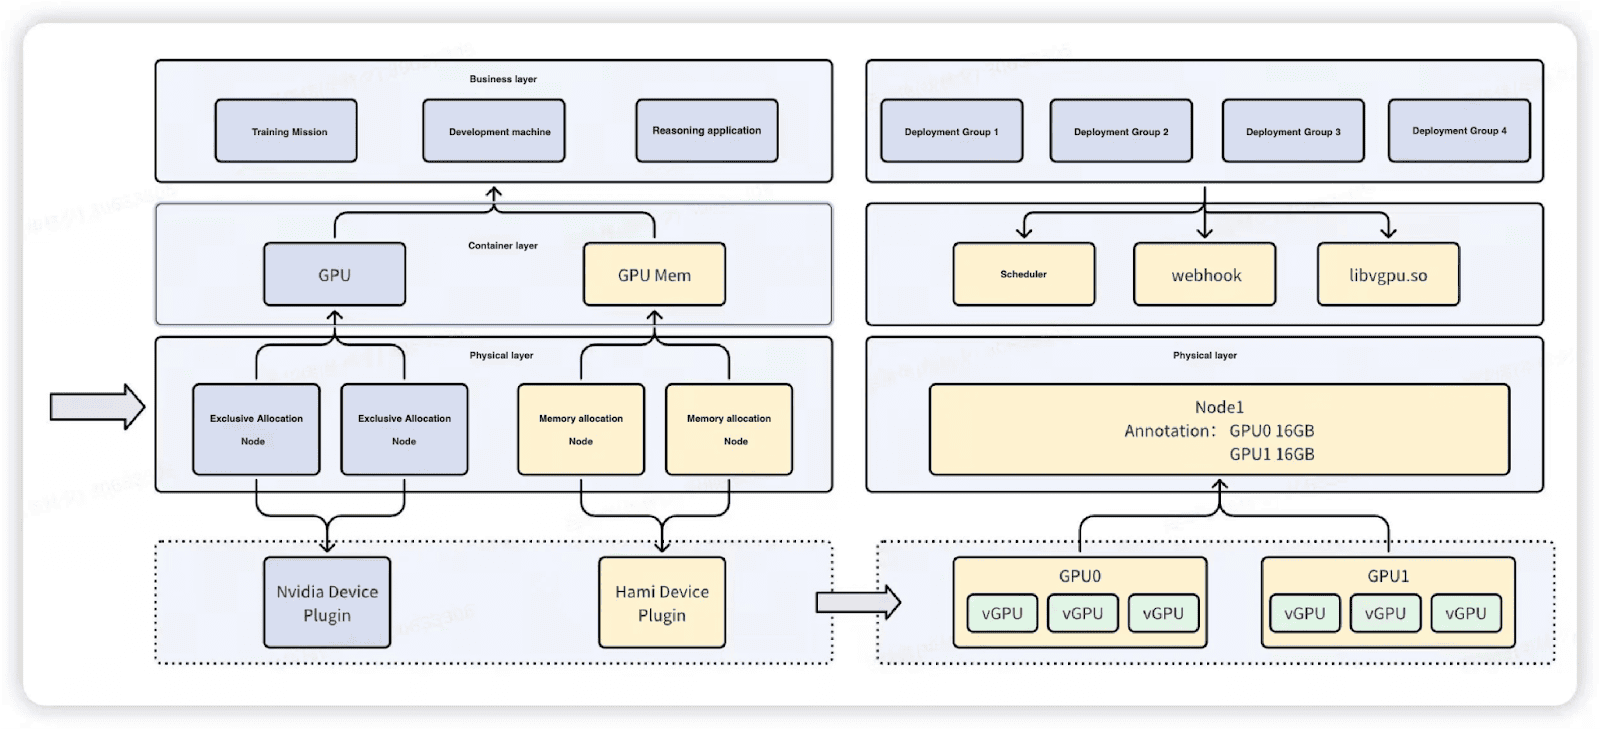
按资源需求分离 GPU 与 vGPU 集群,来源:CNCF 原文。
这种架构让训练作业获得独占、可预期的资源,推理服务则通过显存共享实现高密度部署,消除不同负载类型之间的资源竞争,提升整体基础设施效率。
实施效果
借助 HAMi、Kubernetes 等开源技术,基础设施团队开发的 AIStudio 实现了:
大规模稳定运行
- 超过 10,000 个 Pod 同时运行。
- 迁移和运行期间零停机。
- 5 个集群稳定运行。
- 公有云与私有云无缝集成。
- 统一支撑训练与推理负载。
多云环境中更具成本效益的资源管理
- 针对不同负载设计高效显存分配策略。
- GPU 利用率从 13% 提升到 37%,接近 3 倍。
关键业务负载的生产级可靠性
- 高负载下保持一致性能。
- 为关键负载提供高可用性和可靠性。
- 每天平稳处理数千万业务请求。
成功将 HAMi 集成为基础组件,展示了开源技术如何帮助组织提升基础设施效率。Kubernetes 作为底层平台,凭借调度和管理能力支撑每天数千万业务请求和数万个 Pod 的稳定运行;HAMi 的 GPU 复用与异构调度优化能力,使集群 GPU 利用率提升近 3 倍。
后续计划
贝壳基础设施团队继续在 HAMi 与 Kubernetes 之上创新和扩展平台:
- 采用异构设备: 计划引入华为昇腾和其他非 NVIDIA 加速器。
- 云环境扩展: 接入阿里云,补充现有火山引擎和腾讯云部署。
- 混合负载的高级调度策略: 包括网络拓扑感知、卡型指定和基于 UUID 的分配。
原文:Scaling machine learning infrastructure with GPU virtualization using Kubernetes and HAMi ↗
发布方:Cloud Native Computing Foundation(CNCF) · 2026-02-05
本页为 CNCF 案例的中文翻译,保留原文技术信息与数据口径;并非 CNCF 官方中文版本。架构图沿用原文,图内英文保留。项目阶段及产品信息以文章发布时为准。
原文依 Linux Foundation 内容条款使用,适用 CC BY 3.0;本页进行了中文翻译和版式调整,品牌标识归各权利人所有。