
从 GPU 独占到细粒度共享:赛力斯如何利用 HAMi 支撑日均百亿 Token 推理业务?
 实践案例
赛力斯在 SeresCloud 推理平台中引入 HAMi,为轻量级模型按需分配 GPU 显存和算力,并与平台弹性伸缩协同。案例介绍其日均 Token 处理量突破 100 亿后的小模型推理资源管理实践及 GPU 利用率变化。
本文目录
关于赛力斯
赛力斯集团股份有限公司成立于 1986 年,总部位于重庆,是一家以新能源汽车为核心业务的科技企业,旗下与华为联合打造的问界(AITO)系列汽车在市场上具有较高知名度。
SeresCloud 是赛力斯自研的内部 AI 基础设施平台,向上为各类业务系统与智能体应用提供统一模型服务,向下对接 Kubernetes 集群及 GPU 资源池,承载着 Embedding、Rerank、语音合成、OCR 和大语言模型等推理工作负载。
业务挑战:当日均 Token 消耗突破百亿
随着 AI Agent 在企业内部的应用不断深入,赛力斯的模型推理业务迎来了快速增长。
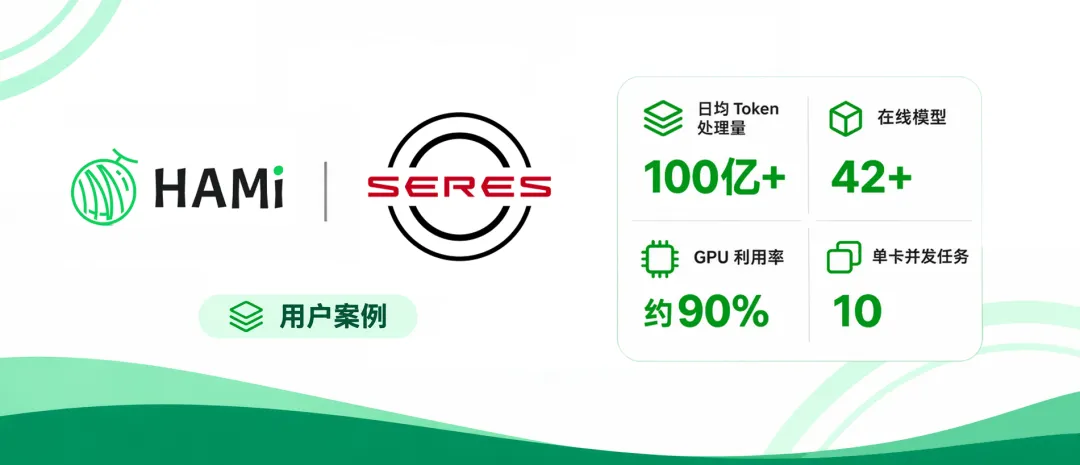
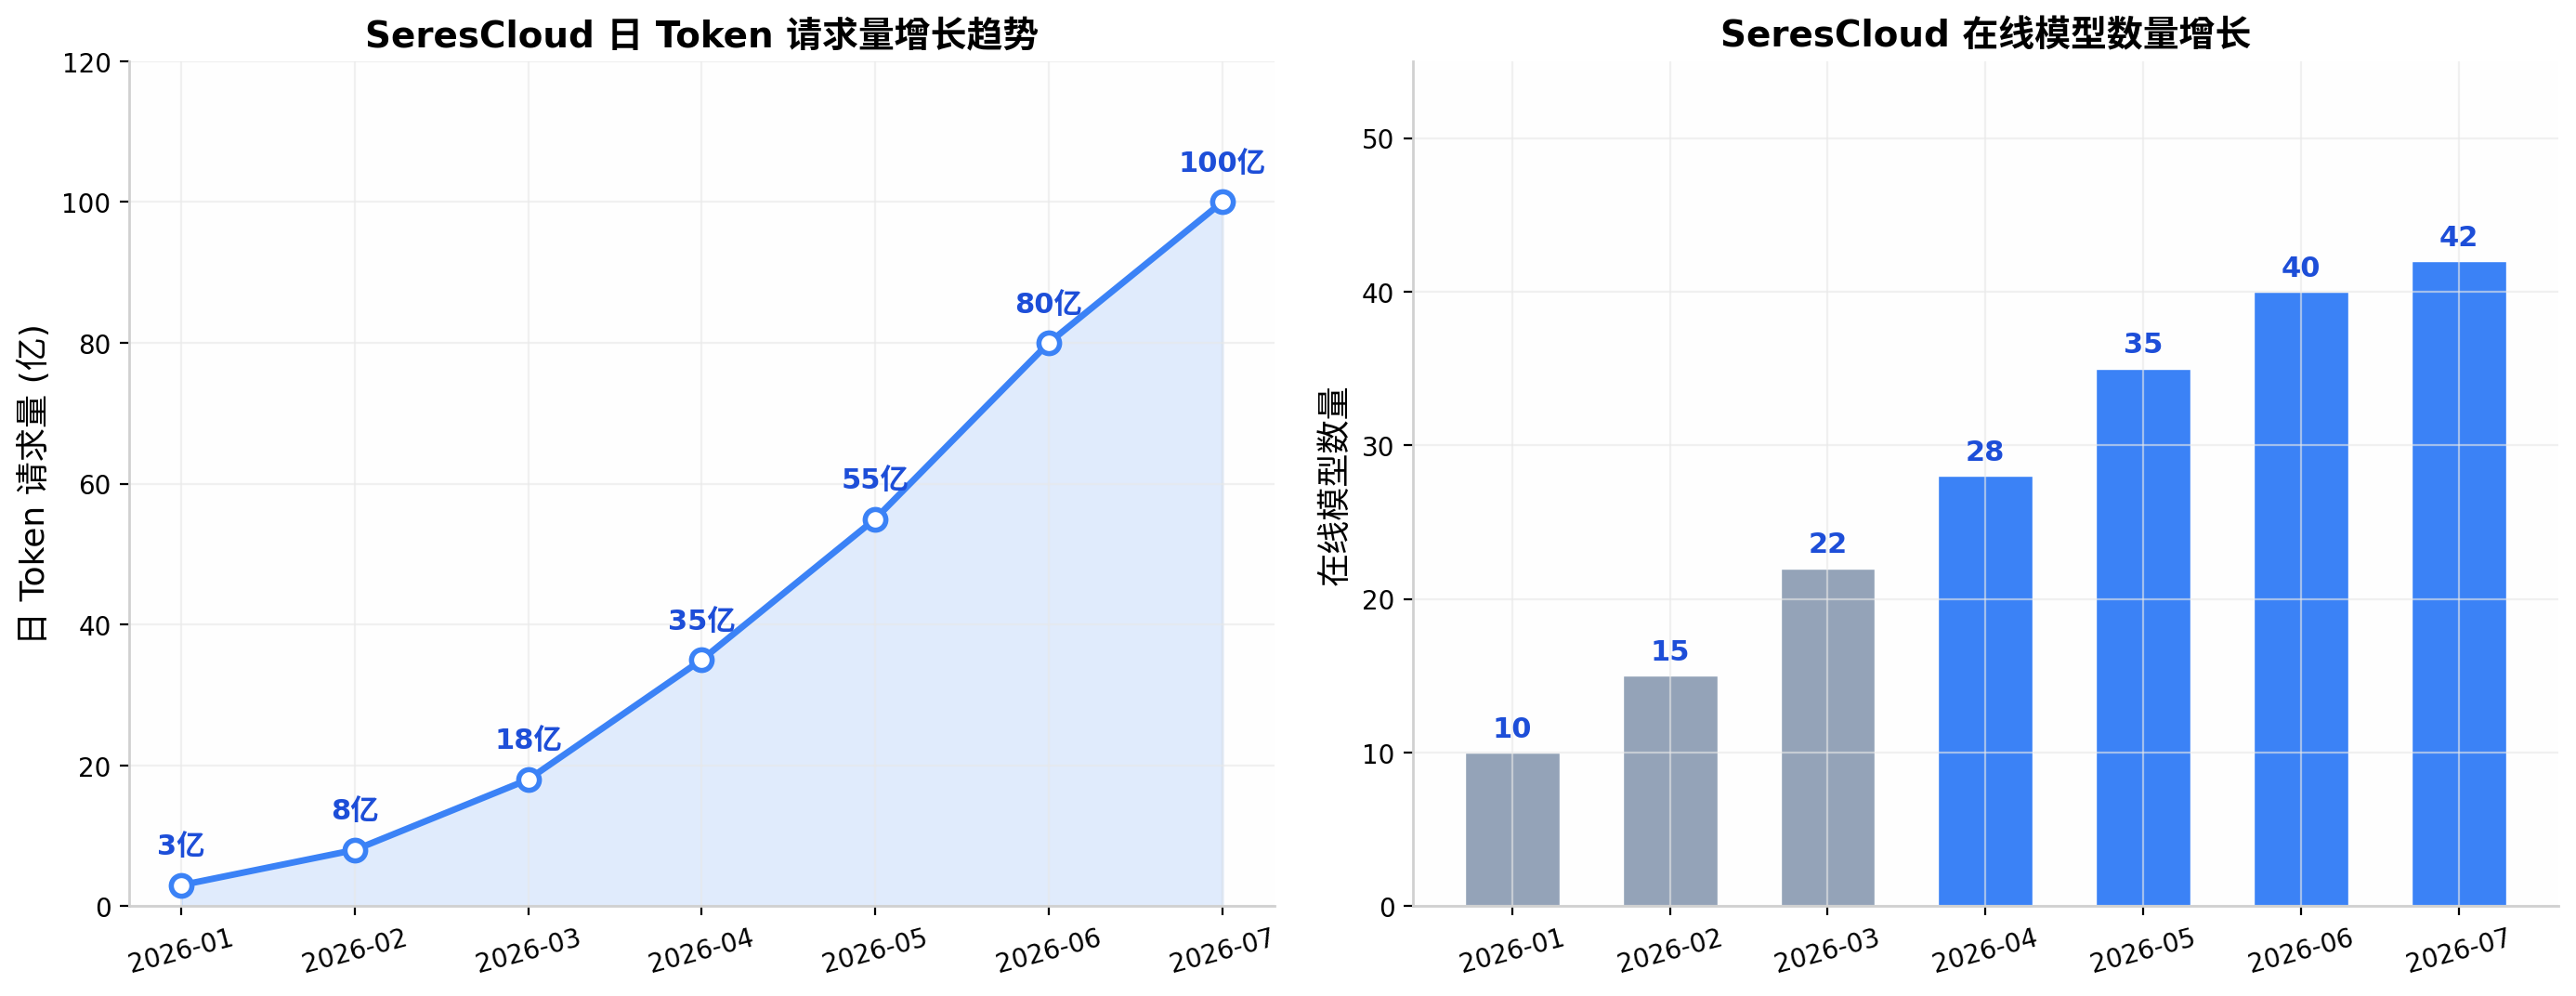
2026 年初,赛力斯的自研内部平台 SeresCloud 运行的在线模型大约有 10 个,日均 Token 处理量约为 3 亿。短短数月后,在线模型数量已增加至 42 个以上,日均 Token 处理量更是突破 100 亿,增幅超过 3000%。
业务规模的增长,也让 GPU 资源管理面临新的挑战。
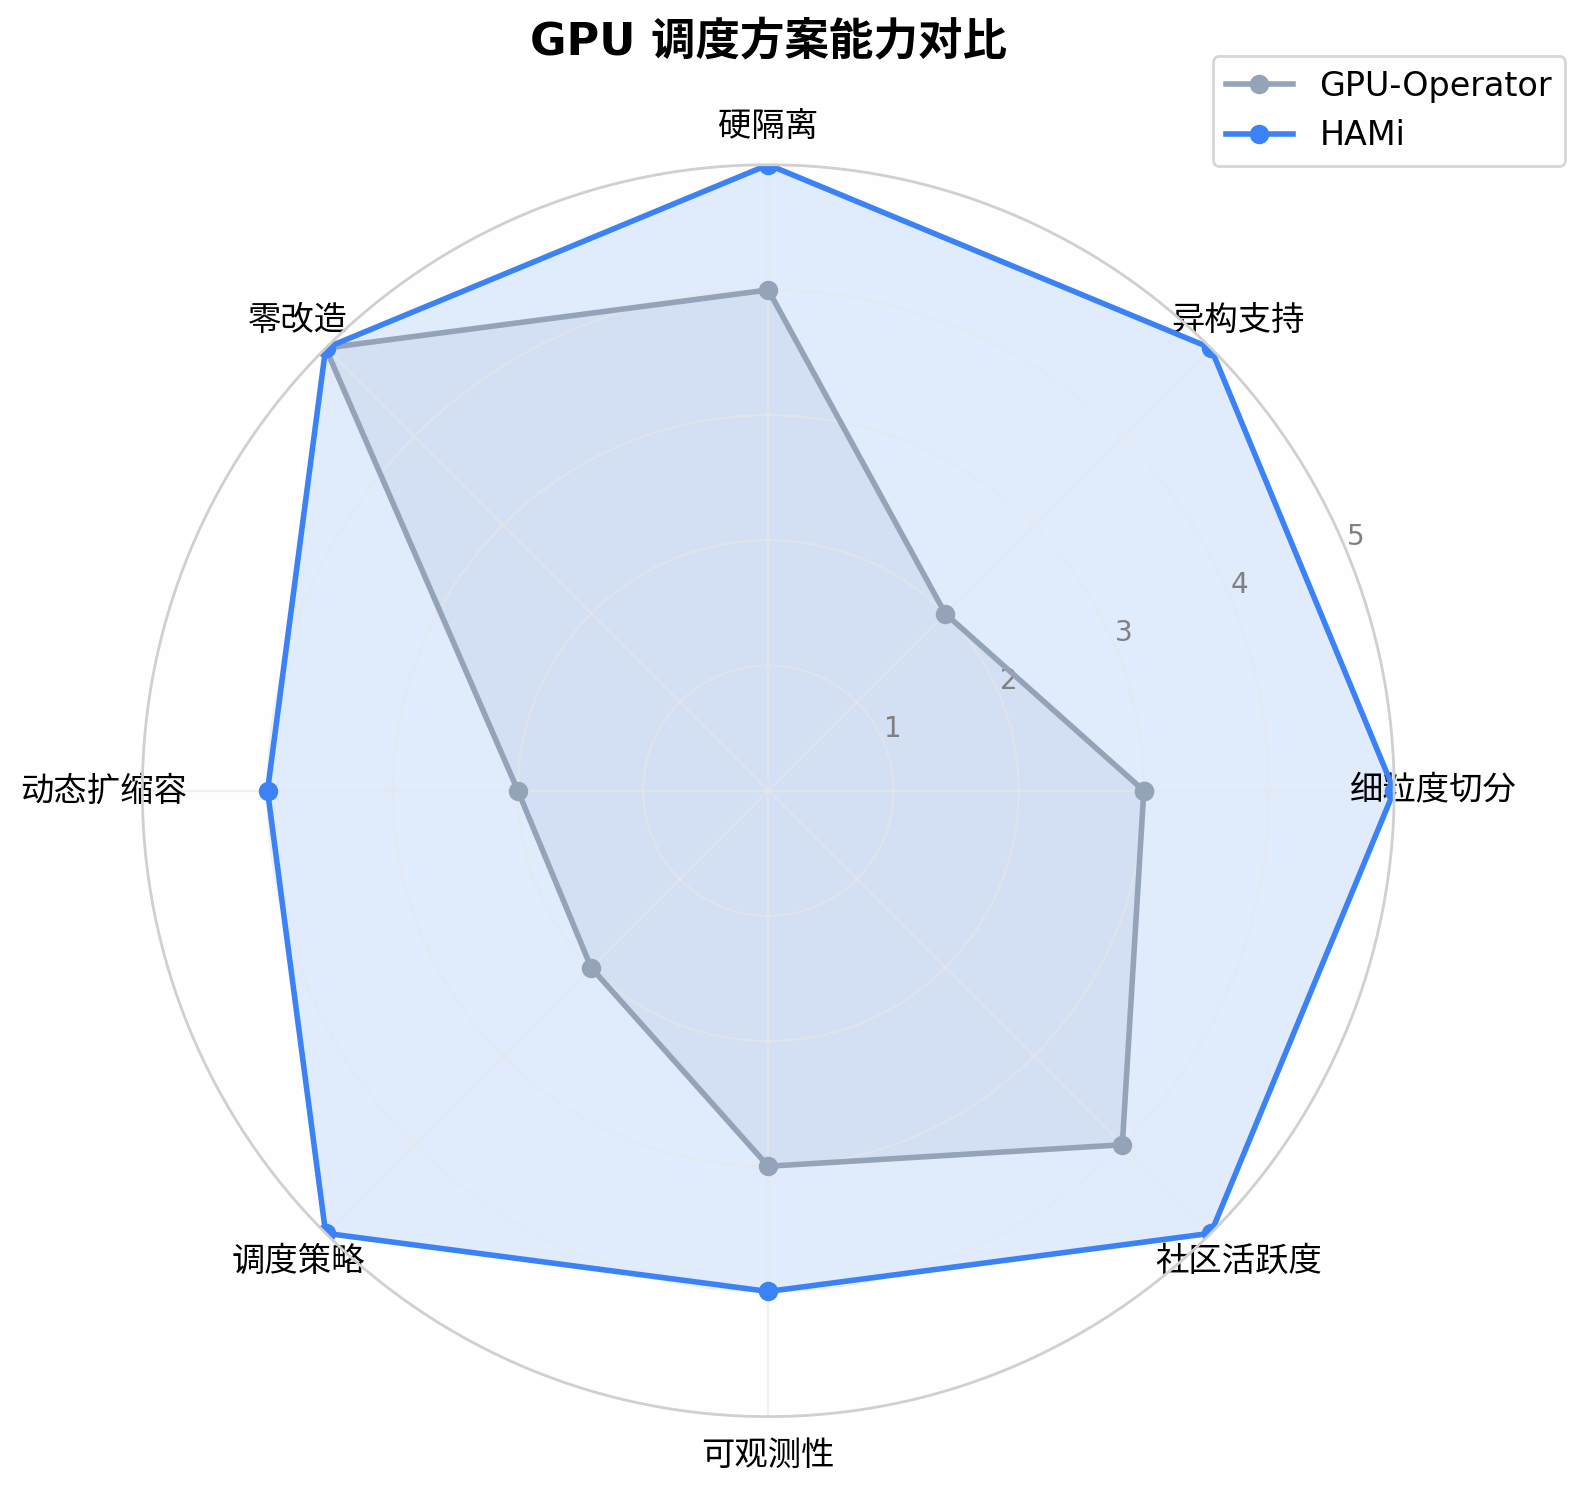
在早期,赛力斯主要使用 NVIDIA GPU Operator 作为管理 GPU 资源的方案。对于一般的 GPU 任务,可以直接将整张 GPU 分配给 Pod;对于 A100、H100 等支持 MIG(Multi-Instance GPU)的设备,则可以通过硬件分区,将一张 GPU 划分为多个独立实例。
这套方案能够满足早期的业务需求,但随着推理模型种类增加、GPU 集群规模扩大,问题就逐渐显现。
一方面,大量轻量级推理任务并不需要独占整张 GPU。另一方面,不同型号 GPU 的资源管理方式存在差异,如何在提高资源利用率的同时保证业务隔离与稳定性,成为平台需要解决的问题。
赛力斯开始寻找一种更加灵活的 GPU 共享方案,并最终选择引入开源项目 HAMi。
HAMi 支持 GPU 显存与算力的细粒度分配,可按百分比配置算力资源,并能为 NVIDIA、华为昇腾、海光 DCU、寒武纪 MLU 等多种异构加速设备提供统一的资源管理能力。作为 CNCF 孵化项目,HAMi 在 GPU 共享、资源隔离和异构设备支持方面的能力,与赛力斯的需求较为契合。
解决方案
引入 HAMi 并不意味着赛力斯需要重新构建整套 AI 推理平台。
在此之前,赛力斯已经基于 SeresCloud 建立了自研推理算力平台,向上为内部业务系统和 Agent 应用提供统一的模型服务,向下连接 Kubernetes 集群与 GPU 资源池。
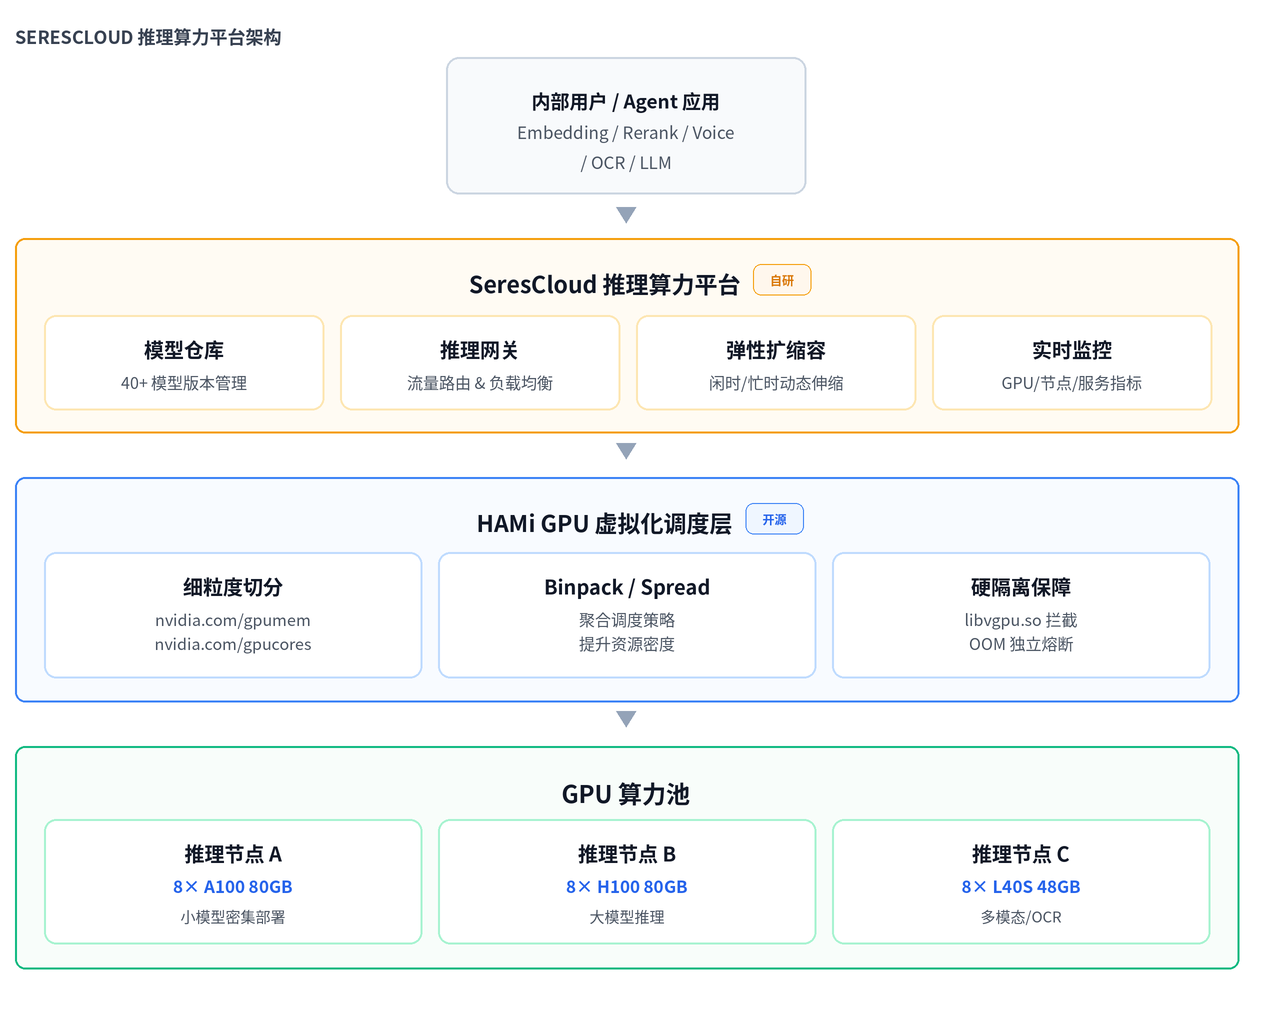
这一平台已经具备较为完整的推理服务管理能力:
- 模型仓库: 统一管理 40 多种模型的版本、镜像与配置,支持一键部署。
- 推理网关: 为业务提供统一的服务入口,处理流量路由、负载均衡、限流与熔断。
- 弹性伸缩: 根据实时 QPS、GPU 利用率和请求队列深度等指标,自动调整推理服务的 Pod 副本数量。
- 实时监控: 对模型服务、GPU 节点,以及显存和算力使用情况进行端到端监控。
赛力斯需要的并不是另一套推理服务平台,而是一种能够与现有架构配合、更精细地管理底层 GPU 资源的能力,HAMi 作为底层 GPU 虚拟化与调度层,正好补上这一环。
在新的架构中,SeresCloud 负责业务层的弹性伸缩,HAMi 负责 GPU 资源的细粒度分配、调度与隔离。
具体来说,SeresCloud 根据业务请求量和服务负载决定何时扩容或缩容,HAMi 则在 Pod 创建时,根据 GPU 的可用显存、算力等资源情况,将任务调度到合适的设备上。
这种分层协同的方式既保留了赛力斯原有平台的业务管理能力,也让 GPU 资源分配更加灵活,无须为每一个轻量级推理服务单独预留整张 GPU。
工程实践
从整卡独占到细粒度共享
赛力斯内部运行着大量轻量级推理服务,例如 Embedding、Rerank、语音合成(Voice)和 OCR,这类服务通常只需要几百 MB 到数 GB 的模型存储空间,单个推理实例的显存需求一般在 1–4 GB 左右。
除此之外,企业内部的请求量往往存在明显的时间差异:工作时间请求集中,夜间负载则相对较低。
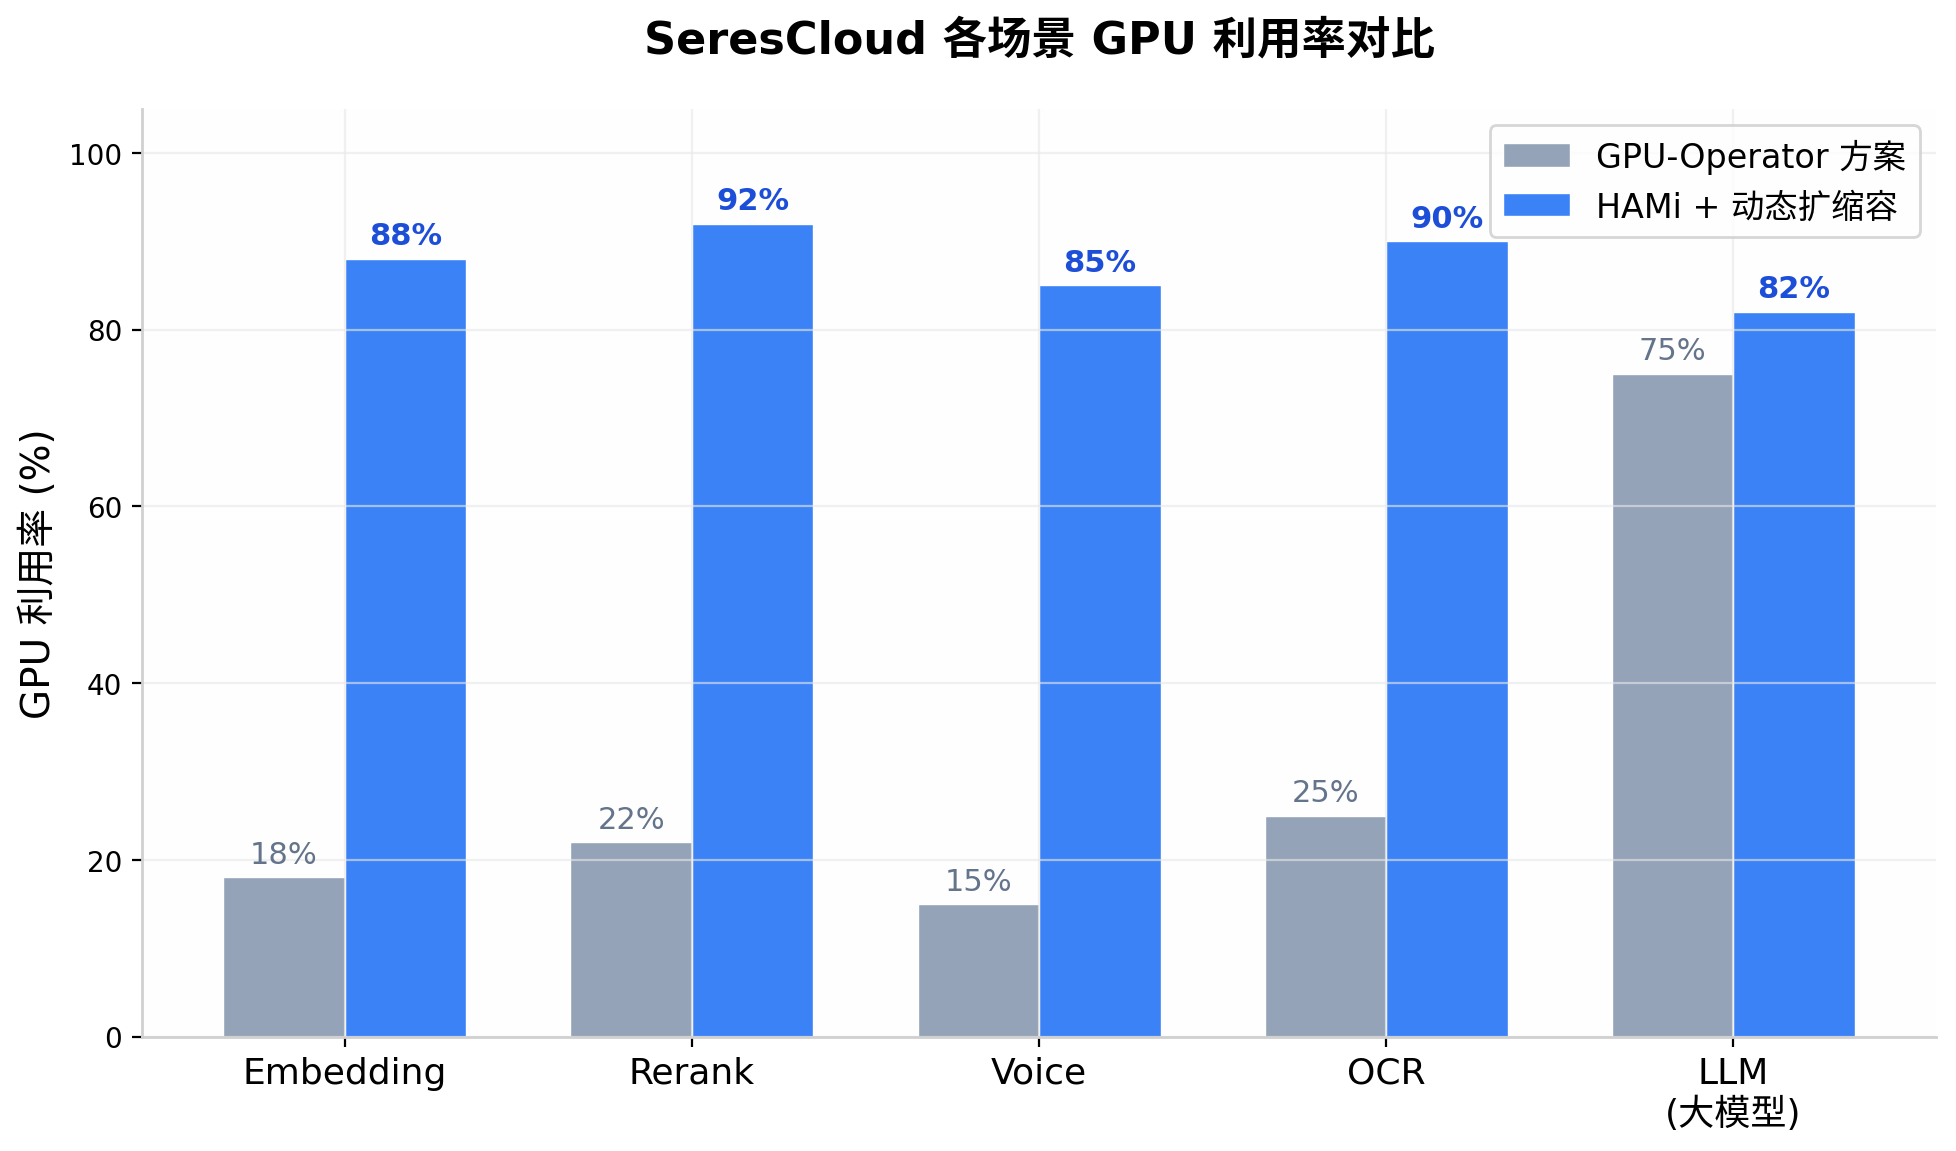
如果仍然采用整卡独占的分配方式,即使某个 Pod 只使用了少量显存和算力,也会占用一整张 GPU,剩余资源难以分配给其他任务。在独占模式下,这类小模型推理场景的 GPU 利用率长期处于 15%–25% 左右。
为改善资源闲置问题,团队曾尝试使用 Time-Slicing,让多个 Pod 通过时间片复用同一张 GPU。这种方式虽然提高了设备的共享程度,其实并没有解决资源隔离问题。
当某个 Pod 的显存使用量突然上升时,可能影响同卡运行的其他任务,甚至触发 OOM;当多个高负载任务同时竞争算力时,推理延迟也容易出现波动。对于需要满足 SLA 的生产业务来说,这些风险是无法忽视的。
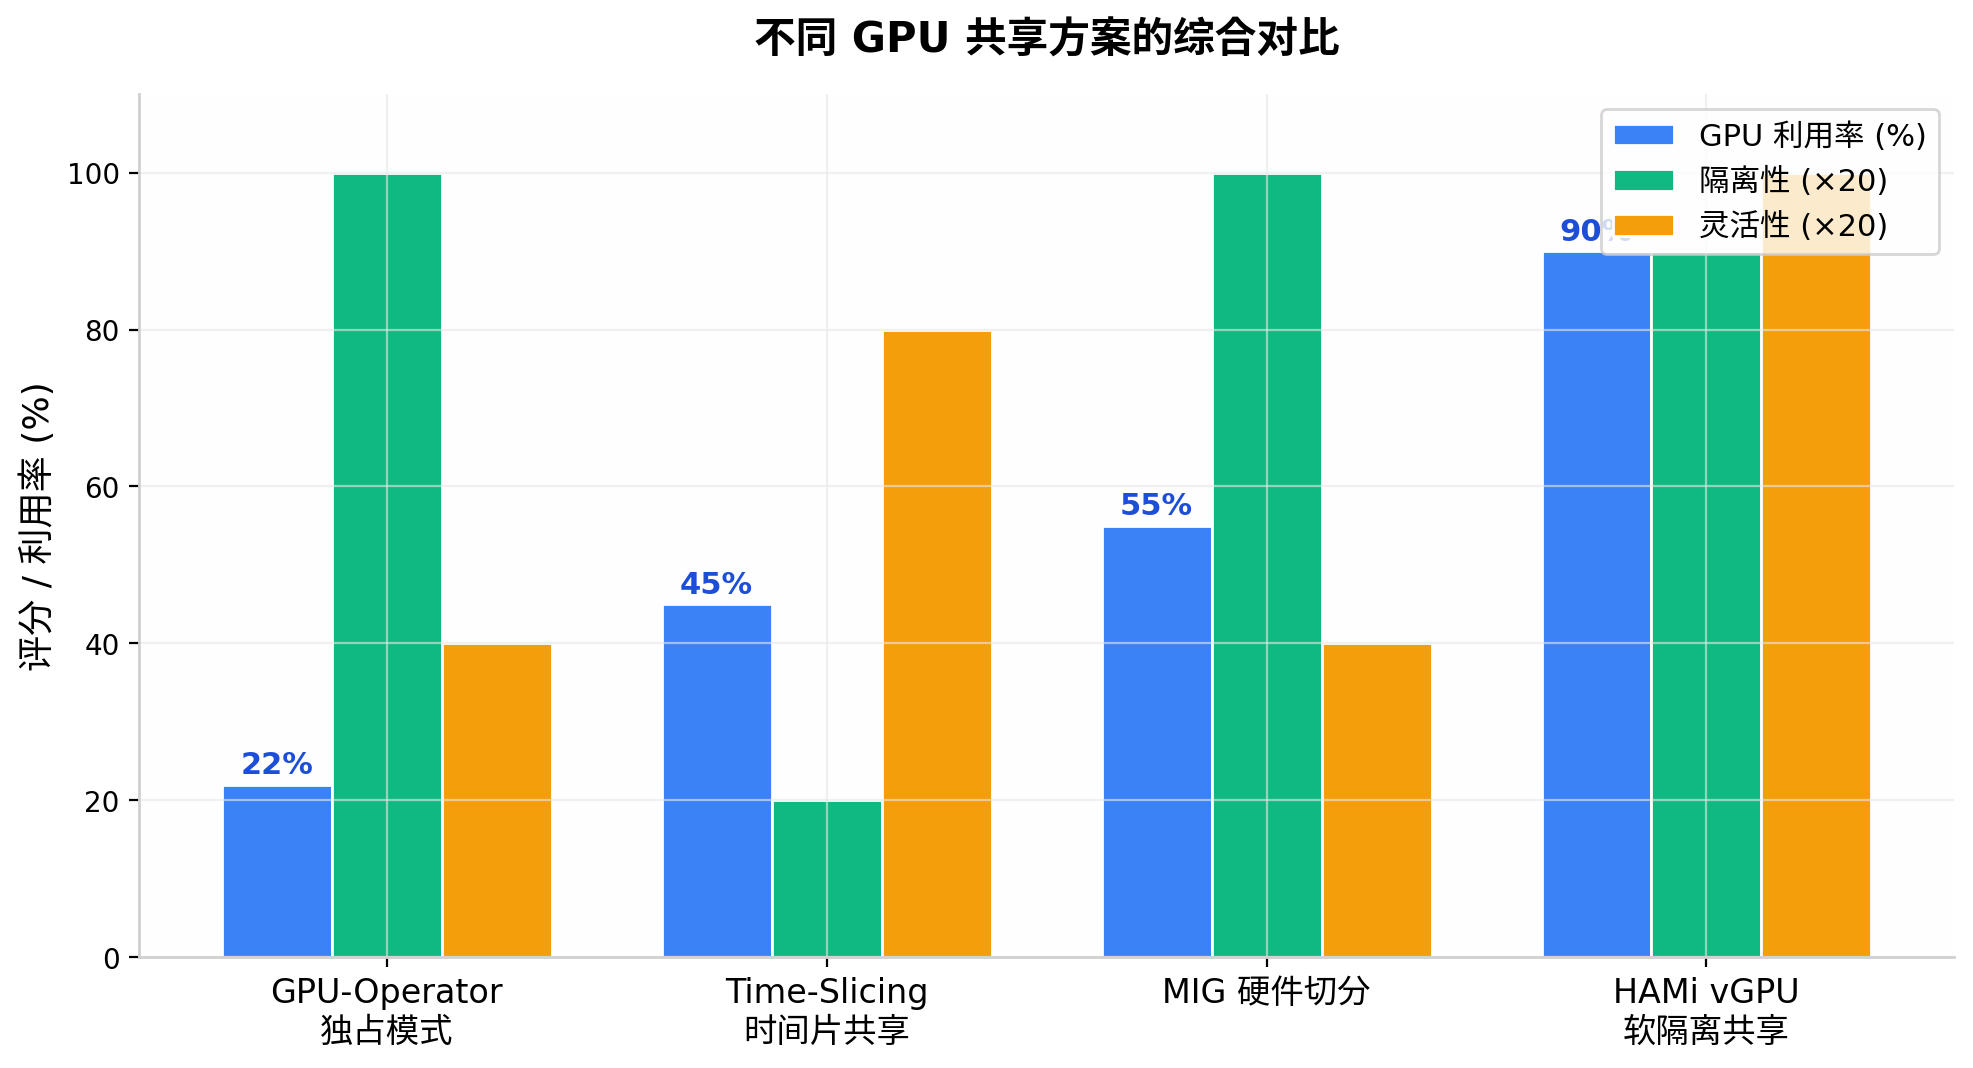
为解决上述问题,赛力斯最终在相关业务场景中采用了 HAMi vGPU 软隔离共享模式。
HAMi 通过容器内的 libvgpu.so 拦截 CUDA 调用,对 GPU 显存和算力实施硬性资源限制,实现更细粒度的 GPU 共享与资源管理。
例如,以下配置为一个任务申请一份 vGPU 资源,并设置相应的显存与算力上限:
resources:
  limits:
    nvidia.com/gpu: 1          # Request 1 vGPU share of a physical GPU
    nvidia.com/gpumem: 3000    # Limit memory to 3000 MiB
    nvidia.com/gpucores: 30    # Limit compute to 30%
其中:
nvidia.com/gpu: 1:申请一个 GPU 共享资源实例,而不是独占整张物理 GPU。nvidia.com/gpumem: 3000:将该任务的 GPU 显存使用上限设置为 3000 MiB。nvidia.com/gpucores: 30:将该任务可使用的 GPU 算力比例限制为 30%。
通过这种方式,赛力斯可以根据不同模型的实际资源需求分配 GPU,而不再以整张物理 GPU 作为最小分配单位。
与此同时,SeresCloud 的弹性伸缩机制也在发挥作用:业务低峰时减少推理实例、释放资源;请求量上升时再增加 Pod 副本,由 HAMi 为新增任务分配 GPU 资源。
在这一组合方案下,赛力斯小模型推理场景的 GPU 利用率从此前的 15%–25% 提升至约 90%。
根据业务需求选择调度策略
对于企业级推理平台来说,提高 GPU 利用率并不是唯一目标,在资源使用效率和业务稳定性之间取得平衡同样重要。根据不同工作负载的特点, HAMi 可以提供的不同调度策略。
- Binpack:优先将 Pod 调度到已使用的 GPU 上,最大化单卡利用率,尽可能提高单卡资源使用密度,适合小模型密集部署、资源碎片敏感的使用场景。
- **Spread:**优先将 Pod 分散到不同 GPU,适用于Latency-sensitive、高并发推理场景。
通过针对不同工作负载选择适当的调度策略,赛力斯在提高 GPU 利用率的同时,也兼顾了关键业务的 SLA(服务等级协议)要求。
关键生产环境配置
以下是赛力斯在生产环境中部署 HAMi 时使用的部分核心 Helm 配置:
devicePlugin:
  deviceSplitCount: 10        # Max 10 shared tasks per physical GPU
  deviceMemoryScaling: 1      # Memory based on actual physical VRAM (no oversubscription)
  deviceCoreScaling: 1        # Compute based on actual physical compute
  migStrategy: none           # MIG disabled (handled by HAMi soft slicing)
  disablecorelimit: "false"   # Enable compute limiting

scheduler:
  defaultMem: 5000            # Default memory allocation 5000 MiB
  defaultCores: 0             # No compute reserved by default (dynamically allocated by the scheduler)
主要配置说明:
deviceSplitCount: 10:单张物理 GPU 最多支持 10 个并发共享任务;deviceMemoryScaling: 1:基于实际物理显存进行资源分配,不进行显存超卖;deviceCoreScaling: 1:基于实际物理算力进行资源分配;migStrategy: none:关闭 MIG,由 HAMi 软切分机制负责 GPU 共享;disablecorelimit: "false":启用算力限制;defaultMem: 5000:默认分配 5000 MiB 显存;defaultCores: 0:默认不预留固定算力,由调度器动态分配。
其中,deviceSplitCount=10 是一个关键的并发上限参数,它定义了每张 GPU 上最多可以同时运行多少个 vGPU 任务,但并不改变物理显存和算力的总量——调度器仍会根据实际资源余量进行准入控制,确保不会出现超卖导致的运行时 OOM。
HAMi 调度器仍会根据剩余的实际资源进行准入控制,避免因资源超额分配导致运行时 OOM。
实践经验:生产环境中的关键问题
将 GPU 共享方案应用到生产环境,除了完成部署,还需要考虑调度兼容性、故障排查、资源配置以及监控体系等问题。赛力斯在实际使用 HAMi 的过程中,也总结了以下几项经验。
Webhook 与特权 Pod 的兼容
HAMi 的 Mutating Webhook 会自动将申请 vGPU 资源的 Pod 的 schedulerName 修改为 hami-scheduler。
但对于需要设置 privileged: true 的调试 Pod,Webhook 会跳过相关处理。因此,在排查调度问题时,需要特别关注这一行为。
提升调度失败的可观测性
从 HAMi v2.x 版本开始,项目显著改进了调度失败原因的输出,提供了更加标准化的错误代码,包括:
NodeInsufficientDeviceCardTypeMismatchCardInsufficientMemory
赛力斯建议将 HAMi 的监控指标接入 Prometheus/Grafana,以便快速定位 GPU 调度过程中出现的问题。
合理设置 deviceSplitCount
并发任务数量并非越多越好,当一张 GPU 同时运行过多任务时,资源竞争、上下文切换开销以及运维复杂度也可能随之增加。
经过实际压力测试,赛力斯最终在推理场景中选择 deviceSplitCount=10,在任务部署密度与系统稳定性之间取得平衡。
这一数值是针对赛力斯当前工作负载作出的选择,并不意味着其他环境也应该采用相同配置。对于不同类型的推理任务,仍然需要根据模型大小、并发量和延迟要求进行测试。
与自研扩缩容机制协同
HAMi 解决的是 GPU 资源如何分配的问题,而推理服务何时需要扩容、何时可以缩容,仍然需要业务平台作出判断。
赛力斯将 HAMi 的 vgpu_monitor 指标与 SeresCloud 自身的 QPS、推理延迟等指标结合起来,为弹性伸缩提供参考。
两者协同的关键在于**统一监控指标体系,**通过将业务层和资源层的监控数据结合起来,GPU 资源管理不再只是静态的容量分配,而能够更好地适应推理业务的负载变化。
下一步探索
随着 AI 基础设施持续演进,赛力斯计划在现有实践基础上进一步拓展 HAMi 的应用能力。
扩展异构算力资源池
随着异构 AI 加速设备生态逐步成熟,计划将华为昇腾、海光 DCU 等设备纳入 HAMi 统一调度框架,构建真正的异构算力资源池。
HAMi-DRA 适配
持续关注 HAMi 社区围绕 Kubernetes DRA(Dynamic Resource Allocation,动态资源分配)标准的开发进展,未来希望通过 Kubernetes 原生 DRA 接口实现更加灵活的 GPU 资源分配。
调度策略精细化
进一步探索基于优先级的资源抢占、GPU 拓扑感知调度等高级能力,提升大模型推理场景下的资源使用效率。
持续回馈开源社区
将生产环境中发现的问题与改进建议持续反馈给 HAMi 社区,与社区开发者共同推动项目发展。
实践成果:GPU 利用率提升至约 90%
通过 Kubernetes、HAMi 与自研推理算力平台的协同,赛力斯在支撑 AI 业务快速增长的同时,实现了 GPU 资源使用效率的显著提升。
- 日均 Token 处理量,从 3 亿增长至 100 亿以上,增幅超过 3000%
- 小模型推理场景 GPU 利用率,从此前的 15%–25% 提升至约 90%
对于赛力斯而言,HAMi 的价值不仅在于让一张 GPU 能够承载更多任务,更在于让 GPU 资源可以按照不同模型的实际需求进行分配,减少整卡独占带来的资源浪费,同时兼顾推理服务的稳定性。
这一实践也为其他正在建设 Kubernetes AI 推理平台的企业提供了参考:面对模型数量增加、推理请求持续增长以及 GPU 资源类型日益复杂的情况,细粒度共享与分层资源管理是一条值得探索的技术路径。