
云游戏的显卡,是怎么被几十个玩家「分」着用的?
 技术博客
HAMi 将 GPU 资源管理从 CUDA 扩展到 Vulkan 渲染任务,使云游戏、自动驾驶仿真等工作负载能够在 Kubernetes 集群中共享和隔离 GPU 资源。CARLA 压力测试中,启用隔离后的整体性能差异控制在 2% 以内。
本文目录
前言
自 2020 年上线以来,米哈游自研的开放世界冒险游戏《原神》已运营六年。今年 7 月,《原神》公布了 7.0 版本的设备性能要求,新版本进一步提升了角色视觉表现与场景材质效果。对于这样一款拥有全球大量玩家的开放世界游戏而言,如何持续改善画面表现,同时兼顾不同设备的运行性能,始终是一项重要的技术挑战。
在图形渲染层面,Vulkan 凭借对 GPU 资源更精细的控制能力,已成为《原神》优化游戏性能的技术选择之一。2025 年科隆游戏展期间,米哈游在三星举办的游戏技术论坛上分享了 Vulkan 的应用成果:在其展示的高负载帧测试场景下,使用 Vulkan 后的 FPS 提升了 17.1%。
而当渲染任务从本地设备转移到云端,需要考虑的就不只是单个应用的渲染性能,还有多个任务之间的 GPU 资源分配与共享问题:一块 GPU 能同时承载多少个会话?如何合理分配显存、限制资源占用,避免不同任务相互干扰?
这不仅取决于 GPU 本身的计算能力,还取决于平台是否具备有效的资源共享与隔离机制。
由密瓜智能创始团队主导发起并持续运营的开源项目 HAMi ,致力于管理 Kubernetes 集群中异构 AI 计算设备,此前已具备针对 CUDA 计算任务的资源分配、使用限制和用量监控能力。此次新增的 Vulkan 渲染隔离,则将资源管理进一步延伸到图形渲染任务,让 CUDA 计算与 Vulkan 渲染能够在同一套机制下进行资源分配、限制和观测。
为什么 GPU 资源治理不能只关注 CUDA
在 GPU 应用生态中,CUDA 和 Vulkan 都能够让程序调用 GPU,但两者的定位和使用场景有所不同。
CUDA 是主要面向通用计算的并行计算平台与编程模型,广泛应用于 AI 训练、推理等计算密集型任务。Vulkan 则是一种跨平台图形与计算 API,允许应用以较低层级访问 GPU,更常见于游戏渲染、自动驾驶仿真和数字孪生等图形密集型场景。
两者虽然都使用 GPU 资源,却有着不同的运行时接口和调用路径,只治理 CUDA,并不能覆盖全部 GPU 工作负载。
对于 Kubernetes 集群中的 GPU 管理平台而言,这种差异会带来一个实际问题:当资源限制和用量监控只作用于 CUDA 调用路径时,那么通过 Vulkan 访问 GPU 的任务,就无法直接受到同一套机制的管理。
例如,一块 GPU 同时承担 AI 推理和三维场景渲染任务,如果平台只对 CUDA 计算负载进行资源限制,就难以通过这套机制准确管理 Vulkan 渲染任务的资源占用,也不利于统一评估不同任务之间的资源争用情况。
因此,要让更多类型的 GPU 工作负载在同一套基础设施中共享资源,就需要将资源管理能力从 CUDA 扩展到 Vulkan 等其他运行时接口。
HAMi 此次新增 Vulkan 渲染隔离,正是对现有 GPU 资源管理能力的进一步扩展。
如何将 Vulkan 纳入统一资源管理
在 Kubernetes 环境中,HAMi 的 GPU 资源管理主要涉及三个环节:
- 资源调度与分配: 为任务选择合适的 GPU,并确定可使用的资源。
- 资源隔离与限制: 根据分配结果约束任务的 GPU 资源使用,降低多任务共享时的资源争用风险。
- 资源监控与观测: 持续记录任务运行过程中的资源用量,为资源管理和运行状态分析提供依据。
对于 CUDA 计算任务,HAMi 已有相应的运行时资源控制机制。而要让 Vulkan 工作负载接受类似的管理,首先需要解决的是如何接入其 GPU 调用路径。
通过 Vulkan 隐式层接入应用
HAMi 的 Vulkan 渲染隔离采用 Vulkan 官方支持的隐式层(Implicit Layer)机制。
Vulkan Layer 是 Vulkan 提供的一种扩展机制,可以在应用程序与底层 Vulkan 驱动之间介入 API 调用流程。与需要应用显式启用的 Layer 不同,隐式层可以由 Vulkan Loader 根据运行环境中的配置自动加载。
借助这一机制,HAMi 可以在应用使用 Vulkan 的过程中接入资源管理逻辑,而不必要求开发者专门修改应用代码来调用 HAMi。对于满足运行环境及组件配置要求的现有 Vulkan 应用,只需部署和配置相应组件,即可引入资源隔离能力,减少对业务程序的改造。
共享资源管理机制
虽然 CUDA 和 Vulkan 的接入方式不同,但 HAMi 希望实现的资源管理目标是一致的——在 CUDA 路径下,沿用已有的资源控制方式;在 Vulkan 路径下,则通过隐式层机制接入渲染任务。
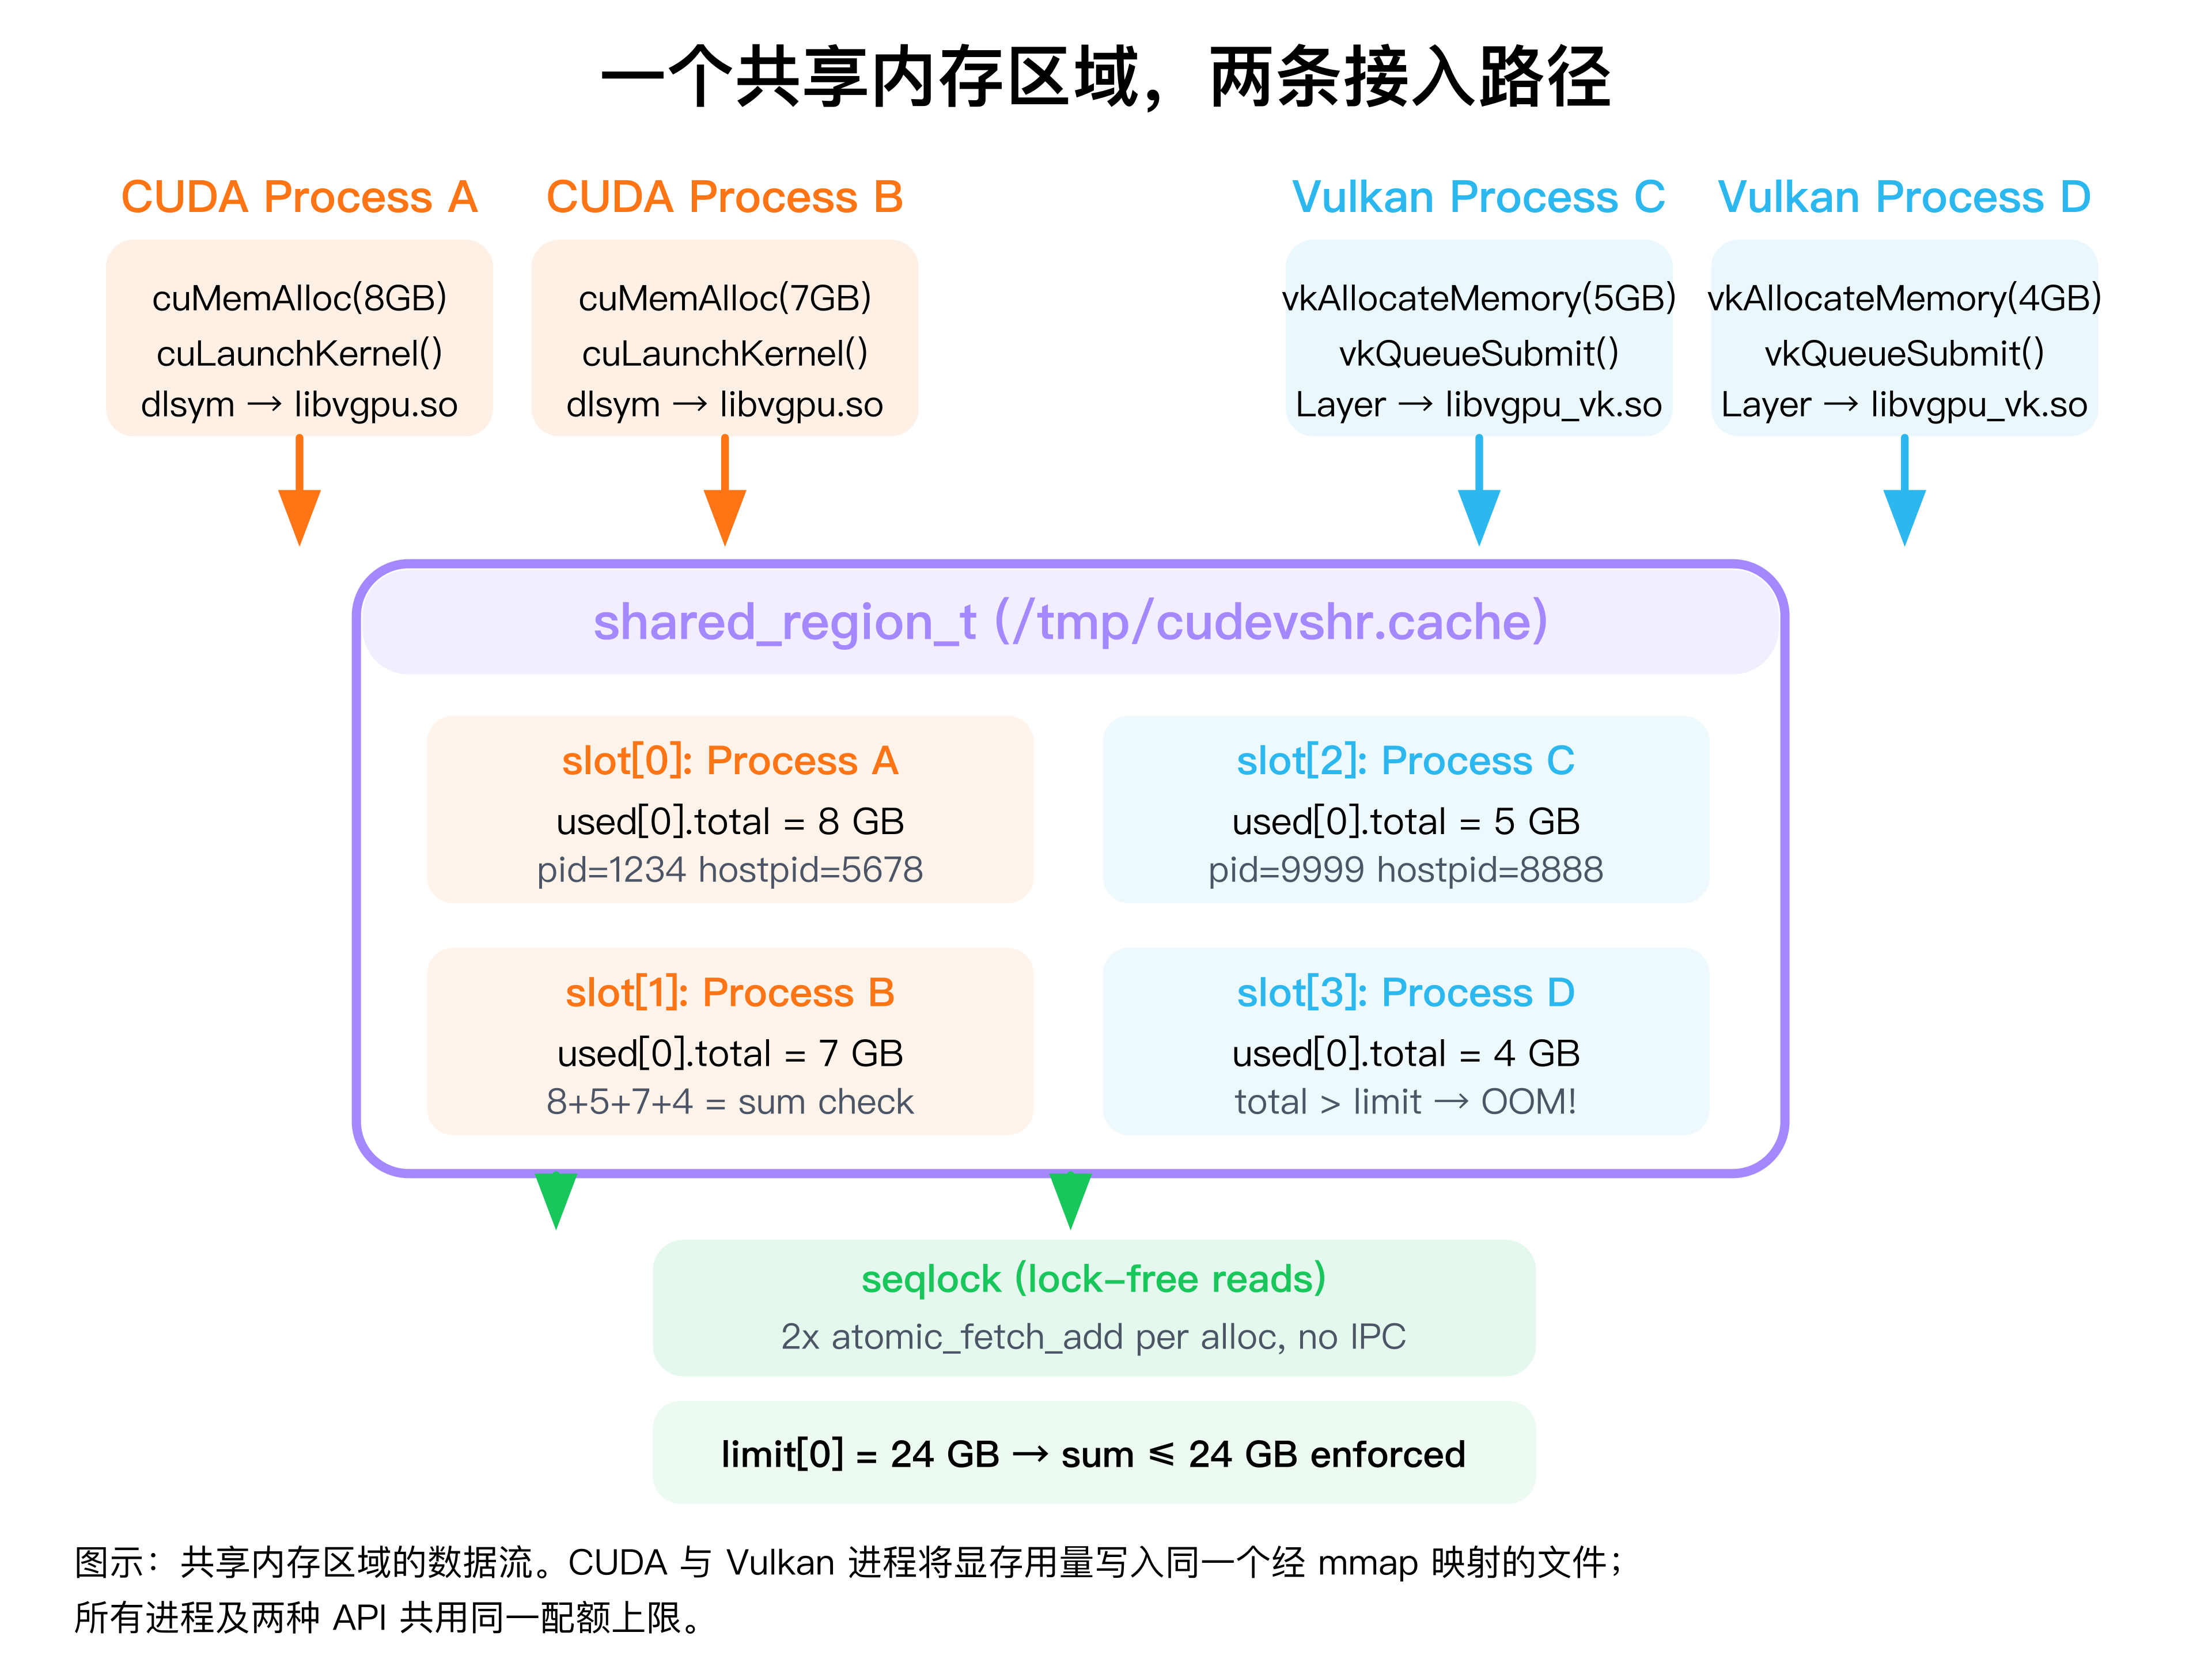
**两条路径分别处理不同类型的 GPU 调用,但最终需要遵循一致的资源分配结果,并纳入统一的资源限制和用量观测体系。**这样一来,平台便可以从统一的视角管理计算与渲染负载,无需针对不同调用接口建立完全独立的资源管理体系。
对于需要同时运行 CUDA 与 Vulkan 工作负载的环境,HAMi 还会同步必要的资源状态,以协调两类任务在共享 GPU 时的资源使用。
具体来看,Vulkan 渲染隔离主要带来了以下能力:
- 明确资源边界: 为渲染任务分配资源,并对其使用进行限制。
- 支持多任务共享: 降低单个任务过度占用 GPU 资源、影响其他任务的风险。
- 统一资源观测: 将计算与渲染任务纳入相同的资源管理视角,便于了解 GPU 的实际使用情况。
- 改善资源利用空间: 为同一块 GPU 承载更多业务负载提供管理基础。
当然,资源隔离并不意味着不同任务之间完全不存在性能干扰。GPU 硬件能力、并发规模以及负载特征,仍然会影响实际的共享效果。除了功能实现,隔离机制在实际运行中的稳定性和性能开销,也是需要重点验证的部分。
需要 Vulkan 渲染隔离的业务场景
从实际应用来看,Vulkan 渲染隔离的价值主要体现在需要多个 GPU 工作负载共享硬件资源的场景中。
云游戏
在云游戏环境中,每个玩家的游戏会话都需要持续完成场景渲染,消耗相应的 GPU 资源。如果每个会话都独占一块 GPU,硬件资源的使用效率和运营成本就容易受到限制。
通过 Vulkan 渲染隔离,平台可以为不同会话划定资源边界,使多个渲染任务能够在受控条件下共享同一块 GPU。这为提高单卡并发会话数量、改善 GPU 资源利用率提供了基础。至于一块 GPU 最终能够承载多少个会话,还需要结合游戏负载、帧率要求以及实际并发性能进行评估。
自动驾驶仿真
自动驾驶研发需要通过大量仿真测试,验证车辆在不同道路、交通状况、光照和天气条件下的表现。当多个仿真任务并行运行时,三维环境渲染会持续占用 GPU 资源,不同任务之间也可能出现资源竞争。
通过对不同仿真任务实施更细粒度的资源分配和限制,可以减少单个任务对其他任务资源使用的影响,让有限的 GPU 资源更合理地服务于多个测试任务。在满足仿真性能要求的前提下,更多任务有机会共享现有 GPU 资源,从而提高并行测试能力和整体仿真吞吐量。
数字孪生与云工作站
数字孪生和云工作站环境中的 GPU 负载往往更加多样,同一套基础设施可能既需要执行数据计算、模型推理等任务,也需要运行实时三维渲染应用。
如果计算与渲染分别通过 CUDA 和 Vulkan 使用 GPU,而平台仅覆盖其中一种接口,就可能造成资源管理能力不完整。有了 HAMi 对 Vulkan 渲染隔离的支持,可以让这两类工作负载遵循更一致的资源管理方式,便于平台统一分配资源、限制使用并监控运行状态。
从云游戏、自动驾驶仿真到数字孪生,上述场景虽然业务形态各不相同,但面临的问题相似:一套 GPU 基础设施需要同时承载多个资源需求不同的任务。
尤其是在 AI 计算与实时图形渲染相结合的应用中,例如一边执行感知推理、一边更新三维仿真环境,CUDA 与 Vulkan 的统一资源管理能够帮助平台更完整地掌握 GPU 使用情况,减少不同负载之间的管理盲区。
CARLA 实测:Vulkan 隔离性能表现
在生产环境中,资源隔离机制除了需要保证资源使用可控,还必须尽量减少对应用性能的影响。对于实时渲染任务而言,这一点格外重要,尤其是在云游戏和自动驾驶仿真等场景中,渲染任务往往需要长时间连续运行,对性能和稳定性都有较高要求。
为了验证 HAMi Vulkan 渲染隔离的实际表现,团队选择自动驾驶仿真平台 CARLA 作为测试负载,在 NVIDIA GeForce RTX 4090 上进行了连续两小时的压力测试。
CARLA 能够持续生成包含道路、车辆、光照及天气变化的复杂三维场景,适合用于观察渲染任务在长时间运行下的性能表现。
本次测试分别记录了两种运行状态下的表现:
- 未启用 HAMi Vulkan 隔离: 作为性能对照。
- 启用 HAMi Vulkan 隔离: 观察引入资源隔离机制后的运行表现。
测试结果
在本次 RTX 4090 测试环境及指定工作负载下,启用与未启用 HAMi Vulkan 隔离的两组测试,整体性能差异控制在 2% 以内,连续两小时运行保持稳定。
这一结果表明,在本次测试条件下,Vulkan 资源隔离机制能够持续运行,并将其对渲染任务的性能影响控制在较低水平。
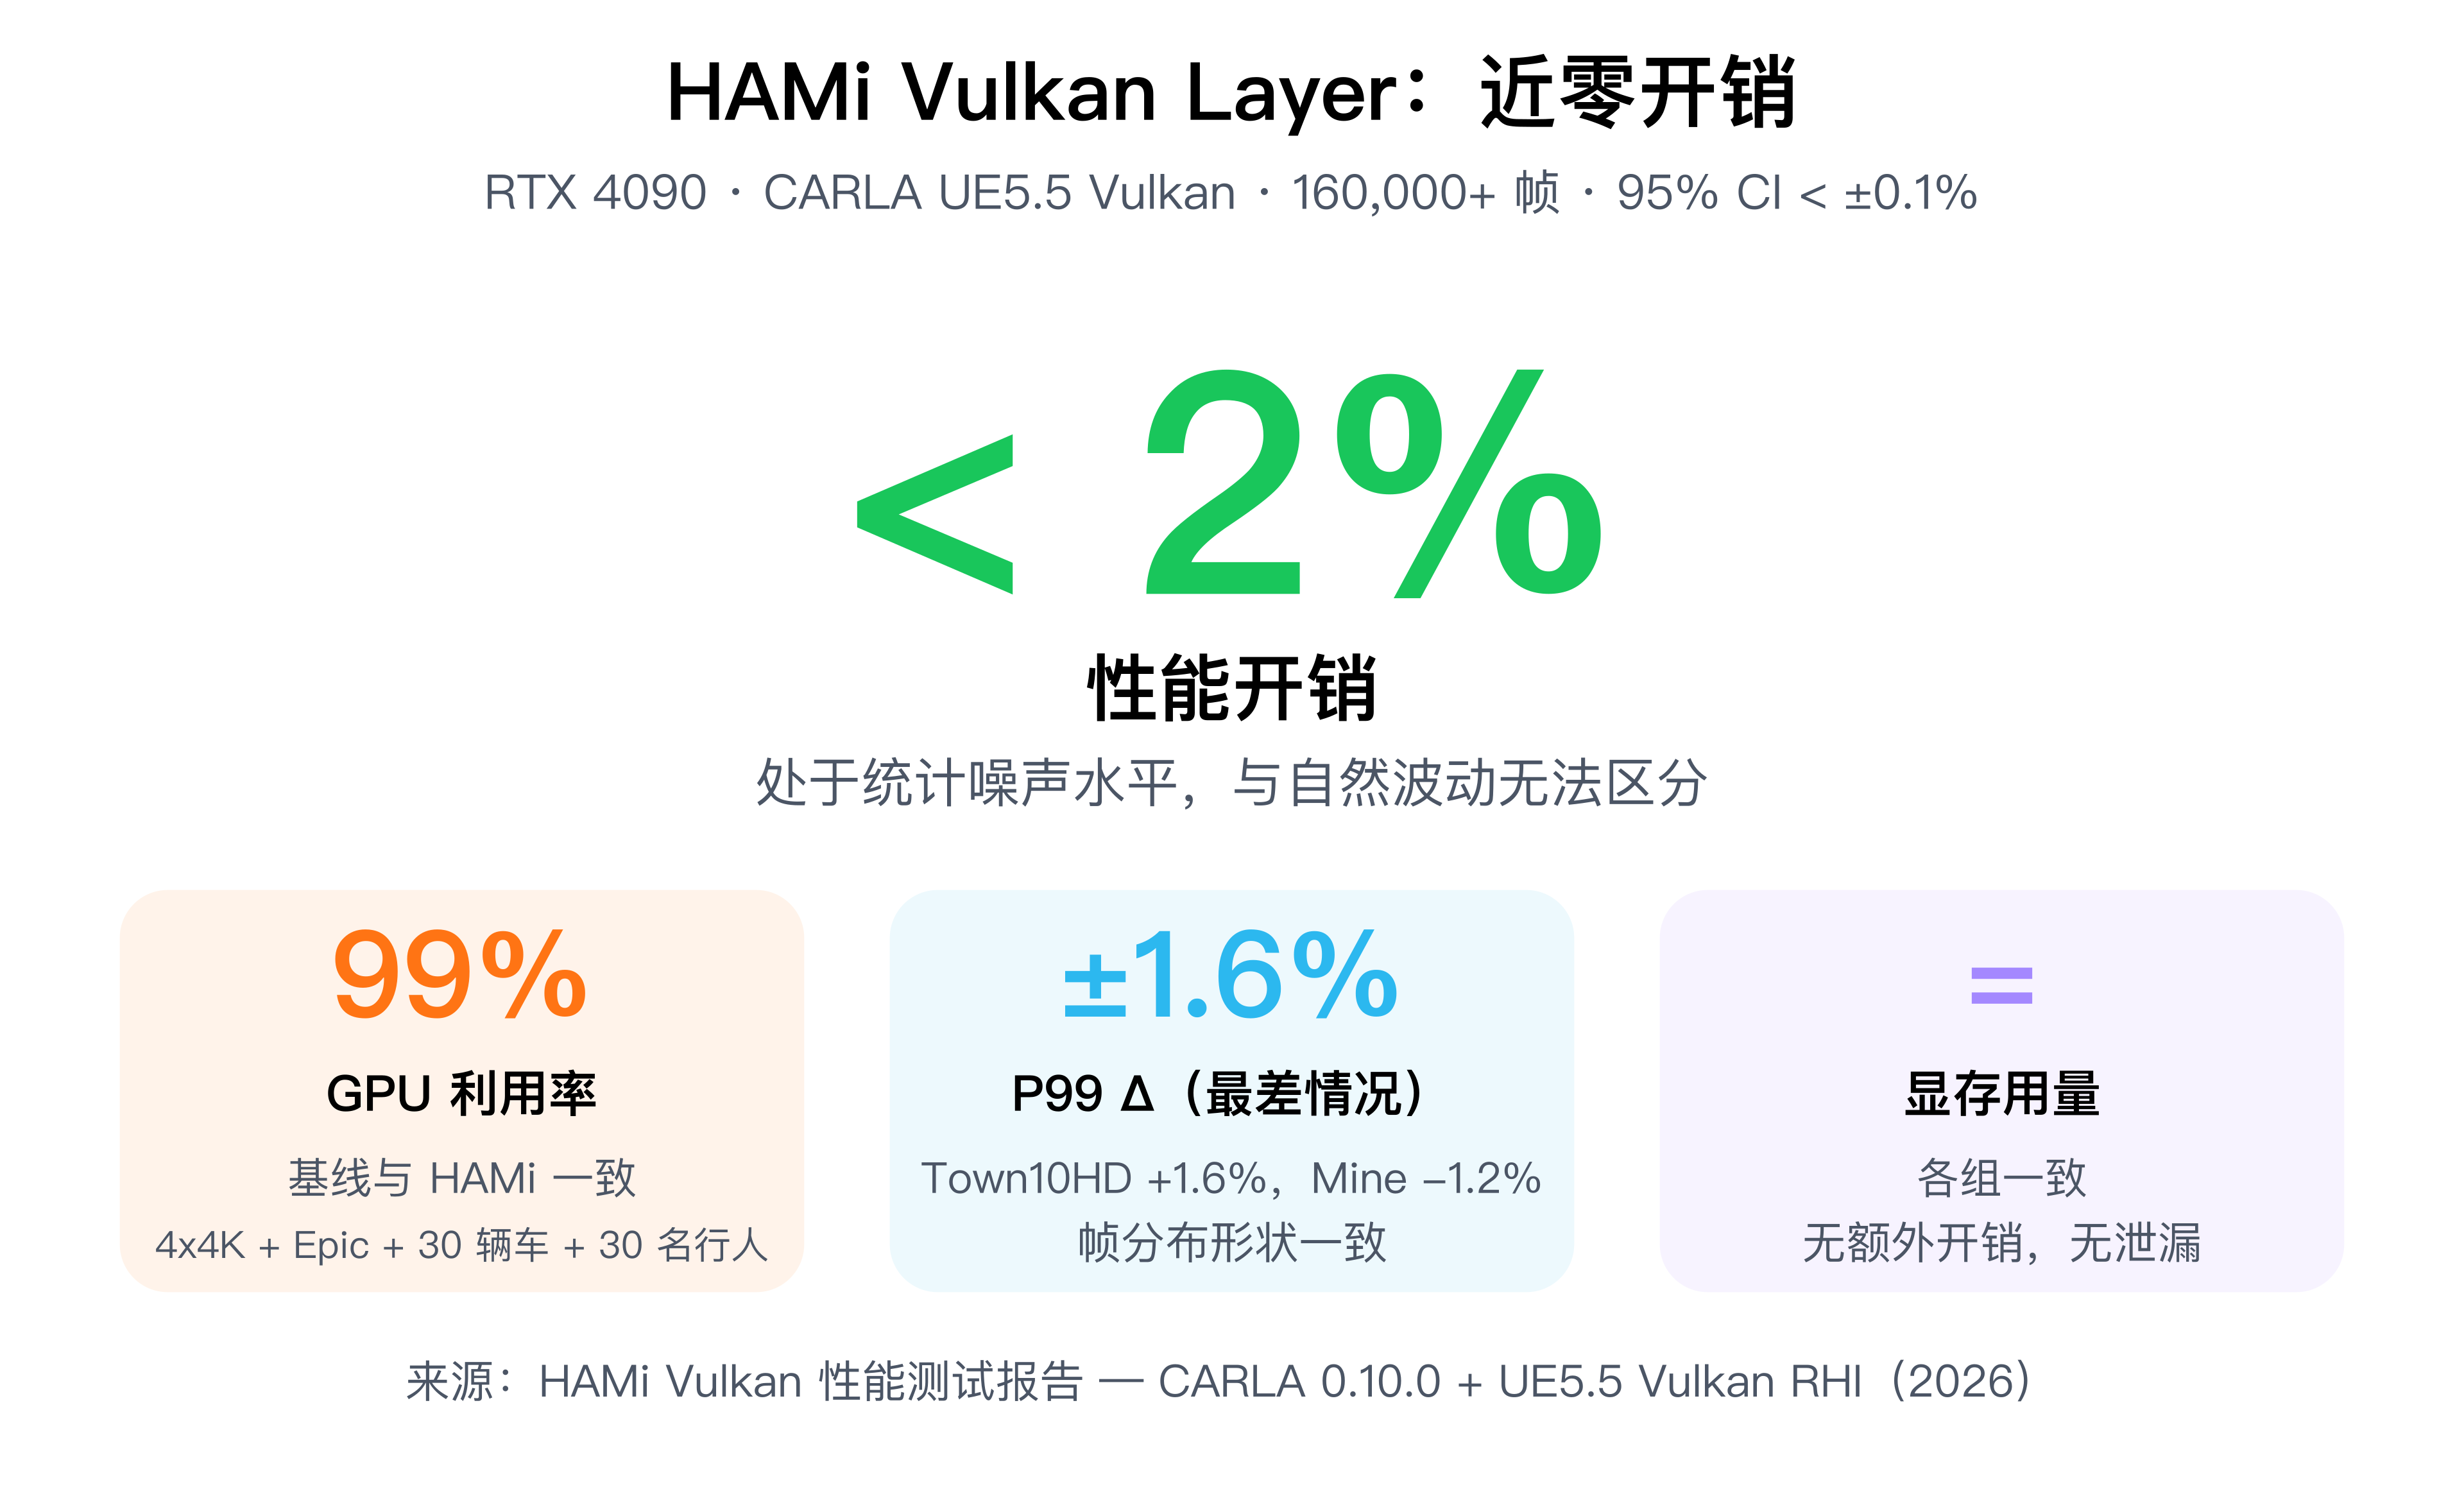
不过,测试结果需要结合具体环境理解,GPU 型号、驱动版本、并发任务数量及实际渲染负载,都可能影响资源隔离机制的性能表现。对于计划在生产环境中使用 Vulkan 隔离的企业,仍建议通过 PoC(概念验证)建立实际业务的性能基线,并结合目标并发规模、资源配置及长期运行情况进行评估。
如何体验
对于满足运行环境要求的现有 Vulkan 应用,HAMi 渲染隔离无需专门修改业务代码。
按照项目文档准备运行环境、安装并配置相关组件后,即可在容器中运行 Vulkan 工作负载,并观察对应的 GPU 资源使用情况。
生产部署
如果计划进一步用于生产环境,还需要结合实际业务,重点关注以下几个方面:
- GPU 与驱动兼容性: 确认目标硬件、驱动及 Vulkan 运行环境满足相关组件的要求。
- 集群资源调度: 根据实际工作负载配置 GPU 资源分配策略,评估混合负载和多任务并发情况。
- 监控与告警: 将 GPU 资源使用情况纳入现有监控体系,建立必要的运行状态检查和告警机制。
- 性能基线: 对比启用隔离前后的性能表现,评估具体业务下的资源利用率及运行开销。
- 升级与维护: 考虑组件版本、运行环境变化及现有集群的运维要求。
这些工作关系到资源隔离机制能否适应企业现有的基础设施,并在持续运行中满足业务需求。作为 HAMi 项目的主导团队,密瓜智能持续参与项目核心技术建设,并为企业提供方案评估、PoC 验证、生产部署、性能调优及长期技术支持,协助企业将相关能力应用到实际业务中。
结语
从 CUDA 计算到 Vulkan 渲染,不同运行时接口背后都存在 GPU 资源共享、隔离与观测的需求。
HAMi Vulkan 渲染隔离通过隐式层机制接入 Vulkan 应用,将图形渲染任务纳入已有的资源分配、限制与观测体系,进一步扩展了 GPU 资源管理的覆盖范围。
HAMi Vulkan 渲染隔离已在 hami-enterprise-v2.11.0 版本中正式上线。
如果你的业务正在面临 GPU 利用率不足、多任务资源争用或渲染负载管理困难等问题,欢迎与密瓜智能交流,了解 HAMi Vulkan 渲染隔离在实际业务中的应用方式。