
HAMi v2.11.0 正式发布|持续拓展异构算力共享能力,夯实企业级 AI 算力底座
 技术博客
HAMi v2.11.0 扩展 Remote GPU、AMD GPU 共享、昇腾 ENPU、NUMA Refit 和 Flexible MIG,并加强调度安全、平台兼容与可观测性。本文同时介绍密瓜智能基于 HAMi 的企业版与平台版能力。
本文目录
由密瓜智能团队发起并持续维护的 CNCF Incubating 开源项目 HAMi 正式发布 v2.11.0 版本。
本次更新围绕 Remote GPU、AMD GPU 共享、昇腾 ENPU、NUMA 拓扑感知调度及 Flexible MIG 等方向展开,进一步完善异构算力的资源共享、细粒度管理与调度能力,同时强化调度安全、平台兼容性及运行时支持。
从开源项目的技术演进,到面向生产环境的企业级能力建设,密瓜智能始终围绕一个核心目标:让异构算力资源更加灵活、高效、可靠地支撑企业 AI 业务。
HAMi v2.11.0
随着企业 AI 工作负载日益复杂,GPU 资源管理面临着更加多样化的需求:算力资源不一定与工作负载部署在同一节点,不同厂商的加速设备需要统一调度,复杂的硬件拓扑也对资源分配提出了更高要求。
HAMi v2.11.0 围绕这些实际场景,进一步拓展了异构算力虚拟化与调度能力。
Remote GPU
在传统 GPU 工作负载部署模式中,应用通常需要运行在具备 GPU 硬件及相应驱动的节点上,计算任务与 GPU 资源存在较强的节点绑定关系。
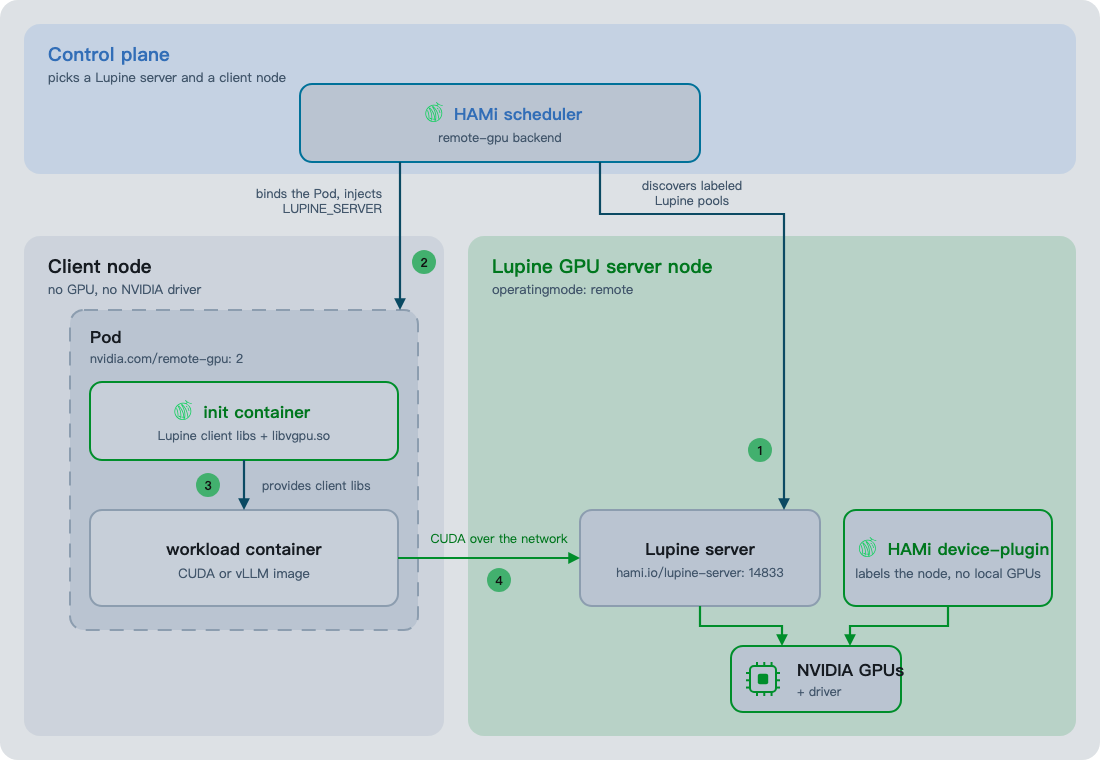
本次版本引入基于 Lupine 的 Remote GPU 能力,使没有本地 GPU、也未安装 NVIDIA 驱动的客户端节点,可以通过网络访问独立 GPU 服务器上的资源,运行 CUDA 与 vLLM 工作负载。
在这一架构下,HAMi 调度器负责选择客户端节点与对应的 Lupine GPU 服务器,并通过客户端组件完成远程 GPU 访问。GPU 服务器还可以根据节点标签划分资源池,工作负载能够通过指定资源池选择需要使用的远程算力。
需要注意的是,当前 Remote GPU 仍有一定的使用限制,包括客户端与服务器节点需要分离部署,以及工作负载按整台 GPU 服务器进行预留等。相关功能仍将持续迭代。
AMD GPU 共享
异构算力环境下,不同硬件厂商的 GPU 往往具有不同的资源管理接口与运行时机制,如何在统一调度框架下实现细粒度共享,是提升异构集群资源利用率的重要前提。
继 v2.10.0 引入 AMD GPU 的基础显存、算力及设备选择能力后,本次 v2.11.0 进一步完善了 AMD Instinct GPU(ROCm)原生共享与调度能力。
在资源隔离方面,支持按固定大小或百分比申请 GPU 显存,通过 amd-hami-core 在容器级执行显存限制,并通过计算单元掩码实现算力份额控制。
在资源调度方面,进一步完善了以下能力:
- 拓扑感知调度: 支持 NUMA 绑定与 XGMI 互联关系感知,优先选择符合任务拓扑需求的 GPU 组合。
- 多种调度策略: 支持 Binpack、Spread、Mutex 与 Topology-aware 等策略,适应不同的资源分配需求。
- 设备选择与任务优先级: 支持 GPU 类型、UUID 的选择或排除,以及 Pod 队列优先级控制。
- DRA 生态集成: 通过 AMD DRA Driver 与 HAMi-DRA 的协同,将显存、算力限制等能力扩展到 Kubernetes Dynamic Resource Allocation 路径。
这些更新使 AMD GPU 在 HAMi 中能够使用更加完整的共享和调度机制,也进一步拓展了 NVIDIA、AMD 等异构 GPU 在统一调度层下协同管理的可能性。
昇腾 ENPU
针对昇腾 NPU,本次版本新增 ENPU 切分模式,与现有的模板模式、HAMi-core 模式共同构成更加灵活的设备共享方案。
ENPU 支持三种资源隔离策略:
- fixed-share: 使用固定份额的资源隔离方式。
- elastic: 提供弹性资源使用策略。
- best-effort: 提供尽力而为的资源共享策略。
同时,ENPU 支持直接使用显存与算力配额进行分配,无需经过固定硬件模板取整,并通过物理 DIE 隔离处理不兼容的租户策略。
除新增隔离模式外,本次版本还对 hami-vnpu-core 进行了性能优化,包括降低初始化锁竞争、优化空间计算策略,以及完善按 NPU 维度的资源限制机制。
NUMA Refit
在多 GPU 服务器中,CPU、内存与 GPU 之间存在复杂的 NUMA 拓扑关系。若 CPU 与 GPU 分配在不同 NUMA 节点,可能产生额外的跨节点数据访问开销,影响工作负载性能。
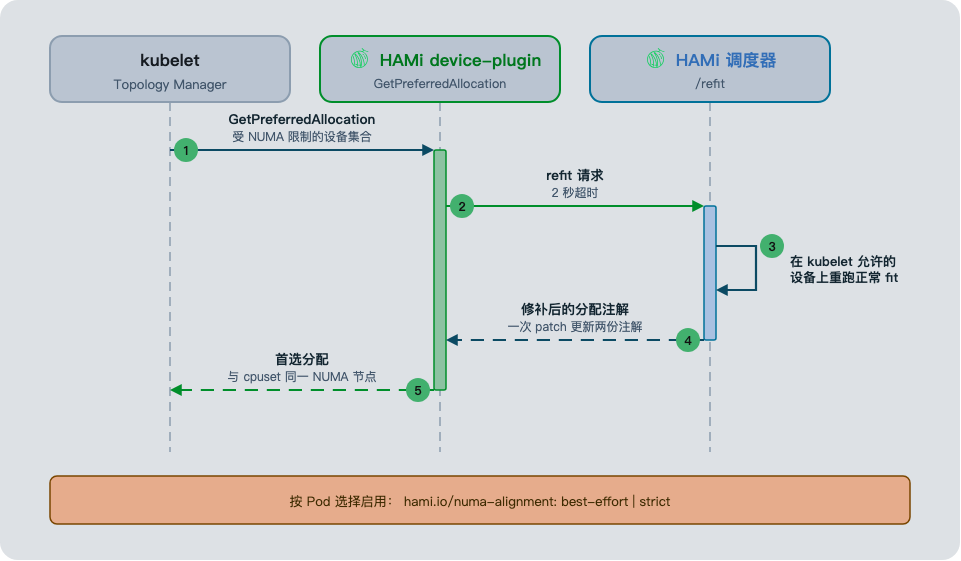
此前,HAMi 调度器与 Kubernetes kubelet 的拓扑资源分配过程可能出现不一致:调度器已选定 GPU,但 kubelet 后续确定的 CPU 亲和性与 GPU 放置不匹配。
v2.11.0 引入的 NUMA Refit 机制,允许 HAMi 根据 kubelet 的拓扑约束重新匹配 GPU 资源,使 CPU 亲和性与 GPU 放置尽可能保持在同一 NUMA 节点。
该机制提供 strict 与 best-effort 两种对齐模式,分别满足严格拓扑约束与允许回退的调度需求。
对于依赖 CPU 与 GPU 高效协同的工作负载,这一更新有助于改善硬件拓扑匹配,减少因资源放置不协调而带来的潜在性能损耗。
Flexible MIG
NVIDIA MIG(Multi-Instance GPU)可以将支持该技术的物理 GPU 划分为多个具备硬件隔离能力的 GPU 实例,为不同工作负载分配相应资源。
HAMi 在 v2.10.0 中引入 Flexible MIG,探索 MIG 实例的动态创建与释放。本次 v2.11.0 进一步完善了动态 MIG 的运行时兼容性、资源放置及生命周期管理。
主要更新包括:
- CDI 支持: 动态创建的 MIG 设备现已支持 Container Device Interface(CDI),改善与支持 CDI 的容器运行时的集成。
- 放置评分与回退机制: 在 MIG 资源分配过程中引入放置评分,并在初始选择不合适时回退重试。
- Pod 级 Profile 偏好: 允许工作负载指定偏好的 MIG Profile,提升实例规格选择的灵活性。
- 生命周期与健康管理: 完善 MIG 实例回收、监控与异常设备标记等机制,提升资源管理可靠性。
通过这些改进,Flexible MIG 进一步增强了在动态工作负载环境中的资源分配能力,为使用 NVIDIA MIG 的 AI 业务提供更加灵活的 GPU 切分与调度方案。
安全、兼容性与可观测性持续增强
除上述核心功能外,v2.11.0 还围绕生产环境中重要的安全性、兼容性及运维需求进行了多项优化。
- 调度安全与性能: 根据安全审计结果加固调度器 Extender 与 Webhook,完善 Pod 身份校验和分配注解保护,同时优化调度过滤、资源快照及节点评分流程。
- 平台兼容性: 增加 OpenShift、SELinux 适配,支持向节点 Capacity / Allocatable 上报 GPU 显存与算力资源,改善与 Cluster Autoscaler 等组件的协同。
- 设备生态与可观测性: 持续优化多厂商设备适配、GPU 健康指标、MIG 监控与资源使用指标,增强异构集群的运行状态感知能力。
社区共建
HAMi v2.11.0 共合并 220 多个 Pull Request,汇聚 50 多位贡献者的工作,其中 29 位是首次参与贡献。从核心调度机制到硬件生态适配,HAMi 正在全球开源社区的协作下持续完善。
作为 HAMi 项目的发起者与核心维护力量,密瓜智能研发团队深度参与了本次版本的核心功能开发与维护,涵盖 Remote GPU、Flexible MIG、平台兼容性及工程化优化等多个方向:
- 版本发布与核心组件维护: @archlitchi 参与版本协调、Remote GPU 客户端工具及监控相关修复,推动新版本功能集成与发布。
- GPU 虚拟化与资源管理: @FouoF 参与 Flexible MIG 增强、Remote GPU 模式加固及 NVIDIA 驱动路径自动检测等工作,持续完善 GPU 资源管理能力。
- 平台兼容与工程化建设: @spencercjh 参与 OpenShift、SELinux 适配、Helm Chart 配置架构重构及安装文档完善,提升 HAMi 在不同基础设施环境下的部署与维护体验。
这些贡献覆盖了 GPU 虚拟化、资源调度、平台适配与工程化交付等多个环节,也体现了密瓜智能团队持续投入开源核心技术研发的实践。
以上为本次版本的主要更新概览。有关技术实现、配置示例、功能限制及升级兼容性注意事项,欢迎阅读 HAMi 社区官方博客。
从开源创新到企业级落地
HAMi 的持续演进,为异构算力资源的共享与调度提供了更加丰富的技术基础。
但在真实生产环境中,企业面对的往往不只是“如何让一张 GPU 运行多个任务”,还包括如何保障关键业务的稳定运行、如何统一管理不同厂商的算力资源,以及如何在多集群、多团队环境下实现持续运营。
从资源共享到生产级保障,再到算力与模型服务的统一运营,是企业建设 AI 基础设施需要逐步解决的问题。
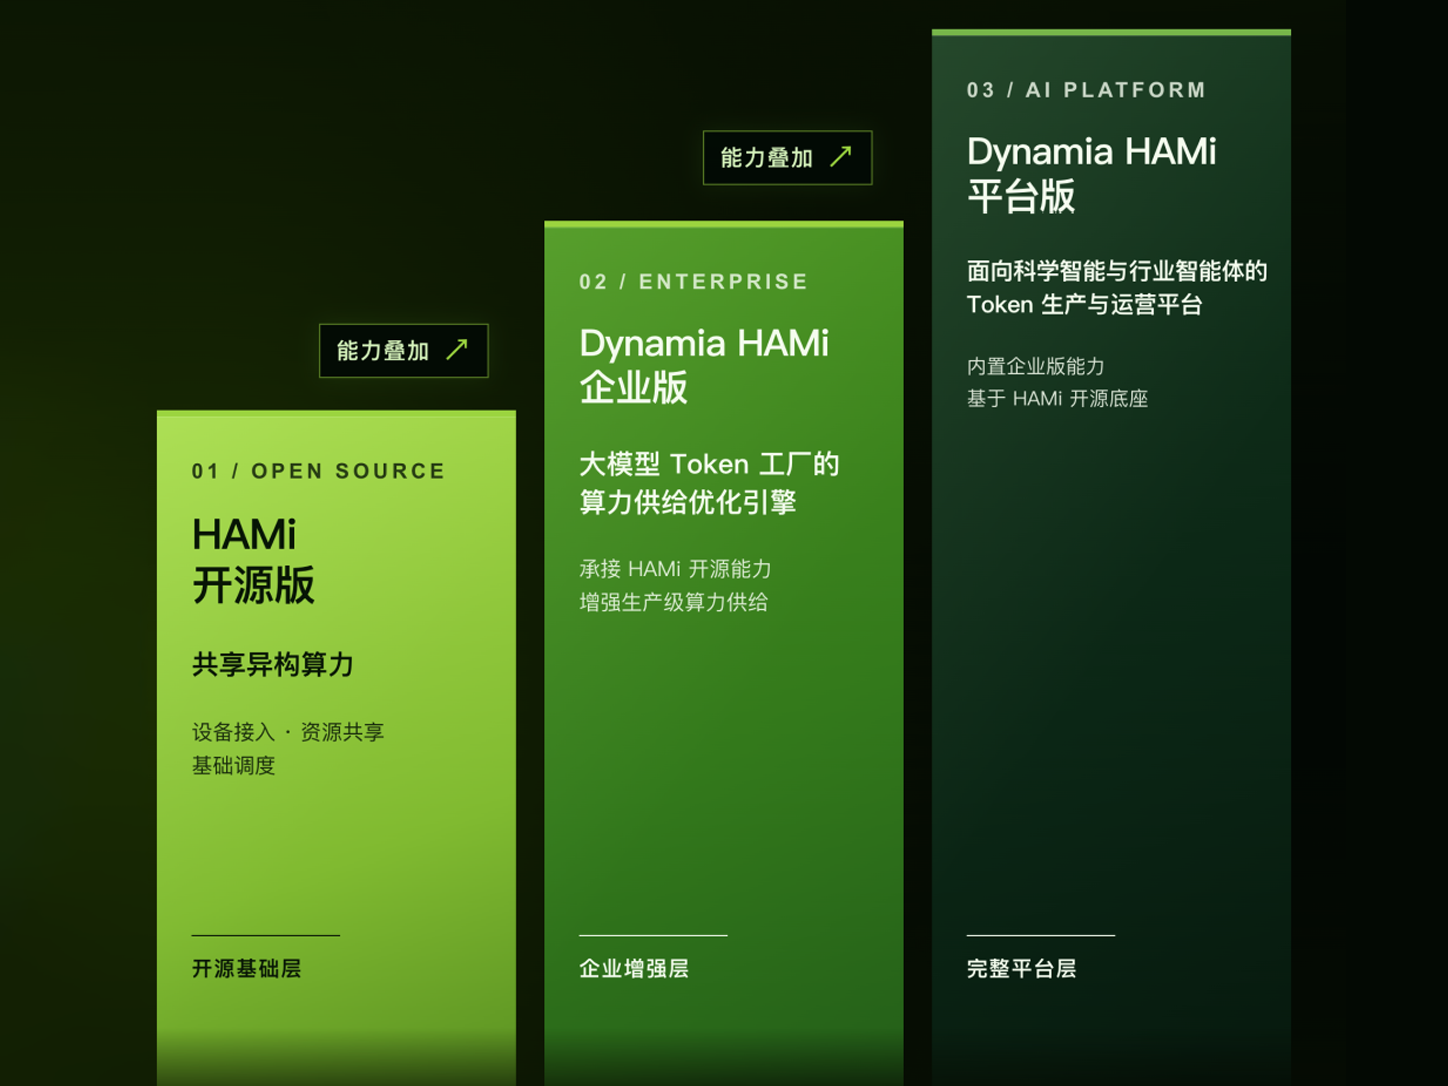
作为 HAMi 项目的发起者与核心维护团队,密瓜智能基于同源开源技术构建企业级产品体系,提供 Dynamia HAMi 企业版与 Dynamia HAMi 平台版,将开源技术能力延伸至企业级交付、资源治理与平台化运营。
Dynamia HAMi 企业版
Dynamia HAMi 企业版(Dynamia Enterprise for HAMi)在开源 HAMi 的基础上,进一步增强 GPU 虚拟化、资源隔离与调度能力,为企业构建更加高效、稳定、可控的异构算力资源底座。
围绕生产环境对资源效率与业务连续性的要求,企业版提供多项增强能力:
更精细的资源管理与隔离
在 GPU 显存和算力共享的基础上,提供更强的资源隔离、显存与算力超卖、HAMi Turbo 模式及应用无缝自动扩缩容等能力,提升资源分配的灵活性。
面向业务的调度优化
支持调度引擎并行优化、空闲统计与显存占用分析,并与 Volcano 深度集成,增强复杂业务场景下的算力调度与资源协同能力。
面向生产环境的交付保障
企业版与上游 HAMi 保持同源兼容,由密瓜智能原厂提供产品加固、技术支持、长期维护与 SLA 服务,帮助企业降低生产环境部署和长期运维的复杂度。
对于正在建设大模型 Token 工厂、MaaS 平台或多租户 GPU 集群的企业,Dynamia HAMi 企业版旨在将分散、独占的算力资源转化为可共享、可调配的资源供给,为上层模型服务提供更具弹性的算力支撑。
Dynamia HAMi 平台版
当企业的 AI 基础设施从单一集群拓展到多个团队、多个业务场景,仅有底层算力共享与调度能力还不够。
Dynamia HAMi 平台版(Dynamia AI Platform for HAMi)在完整包含企业版能力的基础上,进一步提供面向企业的多集群管理、可视化运维与资源运营能力,致力于帮助企业建立统一、可观测、可运营的 AI 基础设施。
多集群统一管理与可观测
通过统一 GUI 与 Dashboard,对跨集群资源、工作负载和 GPU 运行状态进行集中管理,并结合硬件监控、告警策略与运行观测,提升复杂环境下的运维效率。
资源配额与多租户运营
提供企业级多租户管理、资源配额、计量计费及 OpenAPI 等能力,帮助企业更清晰地掌握算力分配、使用与成本情况。
模型服务与业务应用支撑
围绕企业 AI 应用需求,进一步整合模型部署、推理服务与运行管理能力,支持企业从底层算力供给延伸到面向业务的模型服务交付。
开源技术持续演进,企业级能力同步深化
HAMi v2.11.0 的发布,是开源社区在远程 GPU 使用、异构设备适配与调度能力方面的又一次重要迭代。
对于密瓜智能而言,开源技术的持续发展不仅为企业级产品提供了坚实基础,也进一步验证了异构算力共享与统一调度的技术价值。
与此同时,面向企业生产环境的高可靠性保障、深度资源治理、多集群运营、可视化管理及模型服务交付等需求,也需要通过专门的企业级产品能力来满足。
未来,密瓜智能团队将继续参与 HAMi 开源生态建设,并基于企业实际业务需求持续完善 Dynamia HAMi 企业版与平台版,推动异构算力从资源共享走向高效供给,从基础设施管理走向持续的 AI 服务运营。
让开源技术创新与企业生产实践形成连接,持续释放异构算力的应用价值。