

Skalierung von Machine-Learning-Infrastruktur mit Kubernetes und HAMi-GPU-Virtualisierung
13% → 37%
Größenordnung der AIStudio-Plattform
Größenordnung der AIStudio-Plattform
Auf dieser Seite
Hintergrund
KE Holdings ist eine Plattform für Immobilientransaktionen und damit verbundene Dienstleistungen in China, auf der Integrationslinie. Um schnell wachsende KI-Operationen zu unterstützen, betreiben zentrale Infrastrukturteams maschinelle Lernplattformen, die von den Geschäftsbereichen geteilt werden.
Das Team bietet End-to-End-Comput-Ressourcen für Modellentwicklung, Schulung und großflächige Inferenz, unterstützt interne Forschungsbelastungen und produktionsorientierte KI-Dienste. Da Modelle verwendet werden und Anforderungen wachsen, werden GPU-Effizienz und Belastung zu den wichtigsten Plattformanforderungen.
| Wichtige Ergebnisse | Daten |
|---|---|
| Nutzung der Plattform GPU | Fast 3 mal höher |
| Einlauf Pod zusammen | Mehr als 10.000 |
| Tägliche Bearbeitung von Anfragen | Mehr als 10 Millionen |
Herausforderungen
Da sich das maschinelle Lernen erweitert, stehen Infrastruktur-Teams vor mehreren Herausforderungen bei der Verwaltung von GPU-Ressourcen.
Größe und Komplexität: Die Plattform verfügt über fünf Cluster von trans-öffentlichen und privaten Wolken, Tausende von verschiedenen Arten von GPUs, einschließlich H200, H20, V100, 4090, H100 und A100; sie trägt Millionen von Geschäftsanfragen pro Tag während Betrieb mehr als 10.000 Pods, die eine zuverlässige und skalierbare Infrastruktur erfordern.
Mixed Cloud Umgebung: Public Clouds decken vulkanische Motoren, Telekommunikationswolken und Ali Yun ab. Private Wolken umfassen etwa 1.000 NVIDIA GPU selbstkonstruierte Cluster, die ein umweltfreundliches Management von GPU-Ressourcen erfordern.
Verschiedene Belastungsanforderungen: Große Modelle trainieren GPU Memoory in hoher Nachfrage und langen Laufstunden, die eine komplette GPU erfordern; kleine Modelle bieten leichtere Dienstleistungen, meist nur 1-2GB GPU Memoory aber erfordern hohe Erbrechen.
Die Cloud-Komplexität und die Belastungsunterschiede hatten zunächst nur 13 Prozent der GPU insgesamt zur Folge und das Team suchte daher nach Optionen, um die Auslastung von Clusterressourcen zu erhöhen.
Loesungen
Das Infrastrukturteam von KE Holdings entwirft und implementiert die AIStudio Chile-Plattform als Basis für organisatorische maschinelle Lerninfrastruktur auf Basis der CNCF-Projekte HAMi und Kubernetes. Die Plattform bietet folgende Fähigkeiten durch Kubernetes und Hami, um GPU Virtualisierung zu erreichen, die oberen Ebenen von SaaS-Diensten und unteren Ebenen zu verbinden Compute Ressourcen:
- Viele Szenen unterstützen: Es unterstützt auch Inferenzdienste, A/B-Tests und Schulungsmissionen, die es ermöglichen, unterschiedliche Belastungen effizient auf derselben Infrastruktur zusammenzuarbeiten.
- Optimierung und Beschleunigung: Beschleunigen für Referenzrahmen, Datensätze, Spiegel, Prüfpunkte und Modelle und unterstützen Hardware-Versagenstoleranz, einschließlich der schlechten Kartenverarbeitung.
- Mehrrahmenunterstützung: Unterstützung für PyTorch, DeepSpeed, Megatron, vLLM, RLHF und SGLang zur Anpassung an verschiedene Anwendungen.
- AI Asset Management: Zentralisierte Verwaltung von Ressourcenpools, Modelllagern, Spiegelspeichern, Warteschlangen, CubeFS-Rollen und Kontrollkomponenten, um ein einziges Portal für KI-bezogene Assets bereitzustellen.
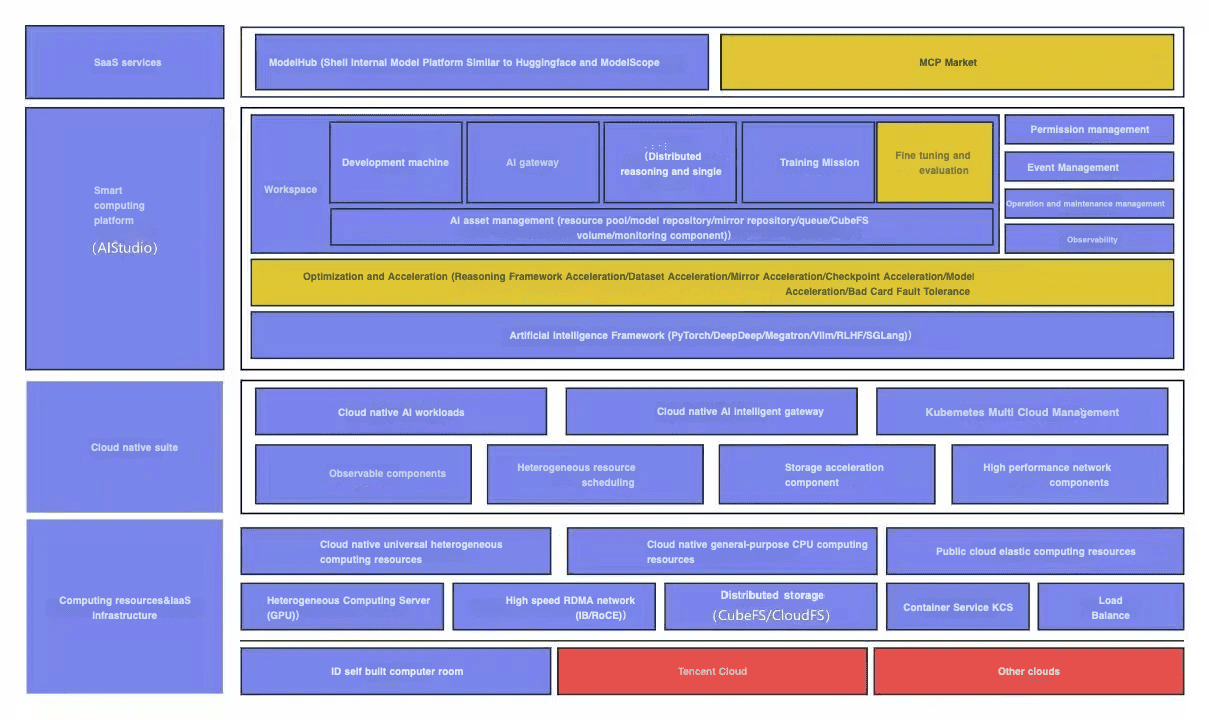
AIStudio Solutions Architecture, Quelle: CNCF Original.
Dazu baut das Team eine auf Kubernetes basierende GPU-Ressourcenverwaltungsplattform und nutzt HAMi, um die GPU-Virtualisierung zu erreichen. Kubernetes verfügt über hervorragende Stabilität und Clusterfähigkeiten, die die Komplexität großer Cluster und Wartungskosten deutlich reduzieren können; es integriert sich mit CNCF-Ökologie und erleichtert die Einführung alternativer Start-up-Szenarien wie Hami.
Das Team nutzt einen Zwei-Cluster-Ansatz, der die Last nach Ressourcenanforderungen trennt:
- GPU Cluster: Verwaltet durch natives NVIDIA-Geräte-Plugin mit leistungsstarken GPUs wie H200 und H100, erfordern spezielle Operationen komplette GPUs und eine erwartete exklusive Zuordnung von großen LLMs und Trainingsaufgaben.
- vGPU Cluster: Die GPS-Speichervirtualisierung wird von Hami verwaltet, indem GPUs wie H20, V100, A100, 4090 verwendet werden, um den GPU-Speicher für kleine Modelle feiner Partikelgröße zu verteilen, in der Regel 1-2GB pro Service.
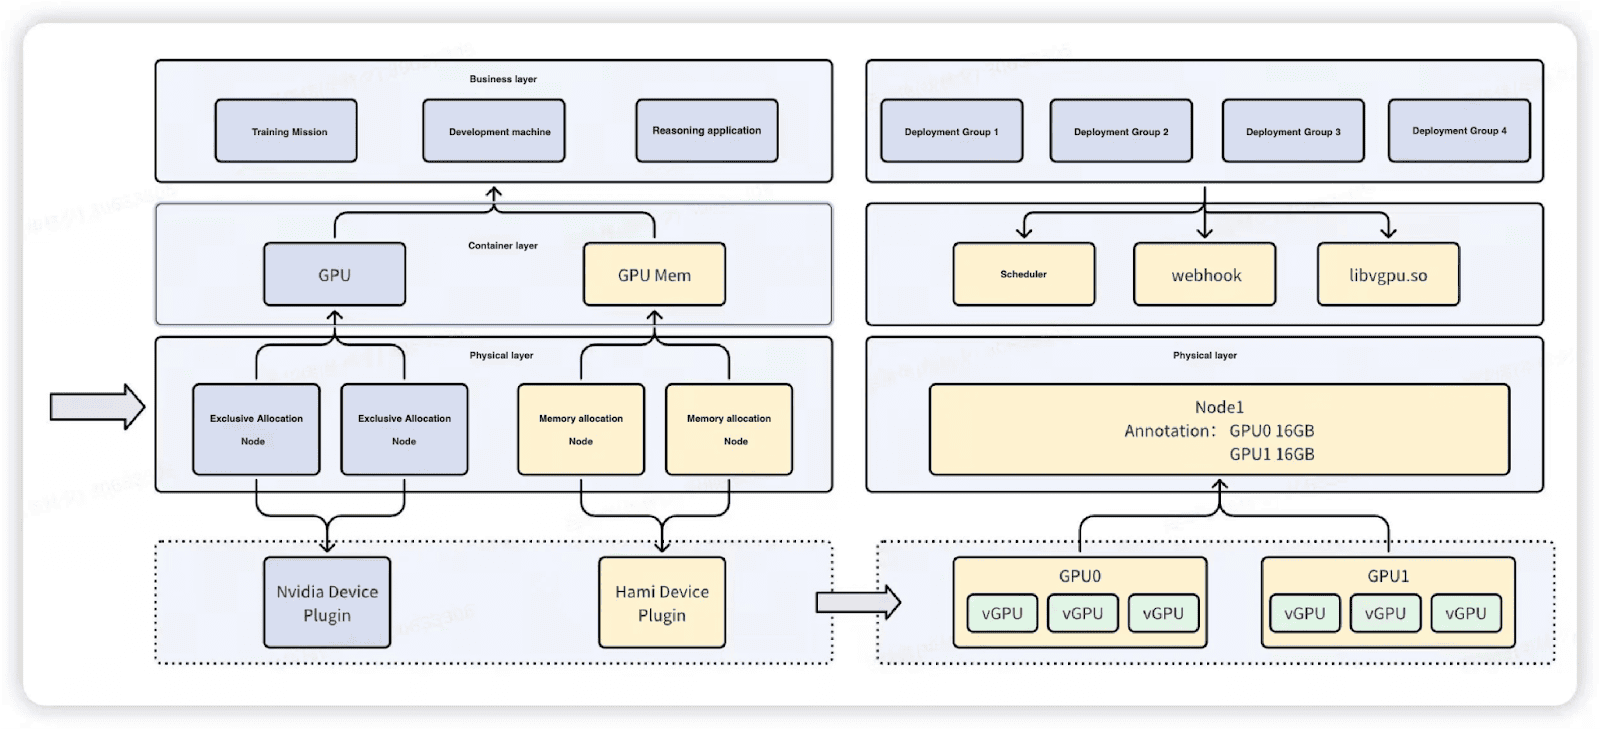
Split GPU und vGPU-Cluster nach Ressourcenbedarf, Quelle: CNCF Original.
Diese Struktur bietet Trainingsoperationen mit einzigartigen und vorhersehbaren Ressourcen, während der Inferenz-Service verwendet wird, um eine hochdichte Bereitstellung durch GPU-Speicher Sharing zu erreichen, Ressourcenwettbewerb zwischen verschiedenen Lasttypen zu beseitigen und die Gesamtinfrastruktureffizienz zu verbessern.
Wirksamkeit der Durchführung
Mit Open-Source-Technologien wie HAMi und Kubernetes, AIStudio, entwickelt vom Infrastrukturteam, erreicht:
Großer stationärer Betrieb
- Mehr als 10.000 Pods laufen gleichzeitig.
- Null-Stopp während der Verlagerung und Operation.
- 5 Cluster funktionieren stetig.
- Die Public Cloud ist nahtlos mit privaten Clouds integriert.
- Einheitliches Supporttraining mit Referenzlasten.
Kostengünstigeres Ressourcenmanagement in Cloud-intensiven Umgebungen
- Entwerfen Sie effiziente GPU-Speicherverteilungsrichtlinie für unterschiedliche Lasten.
- Die GPU-Auslastung stieg von 13% auf 37%, fast dreimal.
Produktionsstufe Zuverlässigkeit kritischer Betriebslasten
- Konsistenzleistung bei hoher Last.
- Für kritische Lasten bieten Sie hohe Verfügbarkeit und Zuverlässigkeit.
- Zehn Millionen von Geschäftsanfragen werden jeden Tag reibungslos verarbeitet.
Die erfolgreiche Integration von HAMi in die Basiskomponente zeigt, wie Open-Source-Technologien Organisationen helfen, die Infrastruktureffizienz zu verbessern. Kubernetes unterstützt als Plattform den stetigen Betrieb von zehn Millionen von Geschäftsanfragen und Zehntausenden von Pods pro Tag mit Schieduling- und Managementfähigkeiten; die Wiederverwendung von HAMi und heterogener Scheduling optimierte Kapazität, was eine fast dreimal höhere Auslastung von GPUs zur Folge hat.
Folgeplan
Das Infrastrukturteam von KE Holdings baut auf HAMi und Kubernetes weiterhin Plattformen auf:
- Verwendung heterogener Geräte: Der Plan ist, China Ascend und andere Nicht-NVIDIA Beschleuniger einzuführen.
- Cloud-Umgebungserweiterung: Zugang zu Aliyun, Ergänzung bestehender vulkanischer Motoren und Telekommunikations-Cloud-Bereitstellung.
- Die erweiterte Scheduling-Politik für die Vermischung von Lasten: Dazu gehören Web-Bewusstsein, kartenbasierte Bezeichnungen und UUID-basierte Distribution.
Original:Scaling machine learning infrastructure with GPU virtualization using Kubernetes and HAMi ↗
Herausgeber: Cloud Native Computing Foundation (CNCF) · 2026-02-05
Diese lokalisierte Fassung übernimmt die technischen Informationen und den Messumfang des Originalartikels. Sie ist keine offizielle CNCF-Übersetzung. Architekturdiagramme behalten ihren Originaltext. Projektstatus und Produktangaben beziehen sich auf das ursprüngliche Veröffentlichungsdatum.
Das Original wird unter den Inhaltsbedingungen der Linux Foundation und CC BY 3.0 verwendet. Diese Fassung wurde übersetzt und neu gestaltet. Alle Marken gehören ihren jeweiligen Inhabern.