

卓驭科技如何借助 Koordinator 将 Kubernetes 上的 GPU 分配率提升至 95% 以上
已调度 / 可调度卡数,不含故障设备
Koordinator 与 HAMi 协同治理
算法与数据工程开发环境
本文目录
卓驭科技的驾驶云在 Kubernetes 上运行自动驾驶数据流水线,并为算法和数据工程师提供配备 GPU 的开发环境,内部称为 Codespaces。使用默认调度器时,多租户突发提交、GPU/CPU 资源碎片,以及无法让所有 Pod 同时启动的分布式作业,限制了资源分配率和利用率。团队引入 Koordinator 的 ElasticQuota、Reservation、Device Share 和 Gang Scheduling 扩展调度器,并将 Device Share 与 HAMi 结合,实现运行时 GPU 隔离。引入这些能力后,平台管理着 100 多个 ElasticQuota,每天调度 30 万至 80 万个 Pod。GPU 分配率超过 95%,整体利用率超过 55%,Codespaces 所需整卡数量减少约 60%。
关于卓驭科技
卓驭科技提供自动驾驶系统和自研核心部件。围绕数据闭环,公司构建了驾驶云,将数据生产、模型训练、模型评估和模型推理连成持续迭代的“数据飞轮”,供十多个算法、数据和平台团队共享。Koordinator 已作为平台核心调度引擎运行两年,负责多租户治理和提升 GPU 部署密度。
面临的挑战
生产环境主要有四个问题:
- 多租户竞争缺乏公平性。 突发提交和硬性的 ResourceQuota 限额导致任务启动失败、资源分配率偏低;团队之间无法按权重借用配额。
- GPU 资源被闲置。 纯 CPU Pod 占用 GPU 节点上的 CPU 和内存,使昂贵的 GPU 无法被调度;与此同时,GPU 作业又经常让节点近一半的 CPU 和内存处于空闲状态。
- GPU 利用率低。 算法和数据工程师日常使用的 Codespaces,以及小模型推理,在独占整卡时利用率经常低于 15%。调试期间 GPU 大部分时间闲置,单次请求的需求也远小于整张卡。
- 分布式死锁。 分布式作业需要多个 Pod 一起就绪;逐个调度 Pod,会导致部分 Pod 持有资源,而同一作业的其他 Pod 一直处于 Pending 状态。
为什么选择 Kubernetes 与 Koordinator
原生 Kubernetes 提供硬性 ResourceQuota、逐 Pod 绑定和整卡分配,但不提供租户间按权重借用配额、为 GPU 保留 CPU/内存的机制、细粒度 GPU 共享,也不提供分布式作业的全有或全无绑定。Koordinator 通过调度器扩展补齐这四项能力,无需改变集群 API;HAMi-Core 则为共享 GPU 执行运行时算力和显存限制。
团队也将生产经验转化为上游修复。自 2023 年以来,已有十多个 PR 合入 Koordinator,包括让调度器感知节点上 HAMi-Core 的可用性(#2577),以及提供 vGPU 分配和利用率指标(#2578)。
解决方案
ElasticQuota:按权重公平借用资源
两层树形结构将配额组与叶子业务配额分开。配额组按 GPU 类型或业务关键程度划分,通过标签绑定节点,不同组之间不互相借用资源。同一组内,叶子配额可以借用超过保障值 Min 的空闲容量;发生竞争时,由 Max 决定各自获得的份额。若配额 A 的 Max 是 B 的两倍,A 获得的可借用容量大致也是 B 的两倍。
自动标注任务的突发需求只能使用本组内的空闲 GPU,不能占用其他训练组受保护的 GPU。每个 GPU 业务配额又拆为 .gpu 和 .cpu,避免 CPU Pod 耗尽 GPU 调度所需的资源。空闲资源因而可以在受控资源池内的业务之间流动,受保护的资源池则保持隔离。
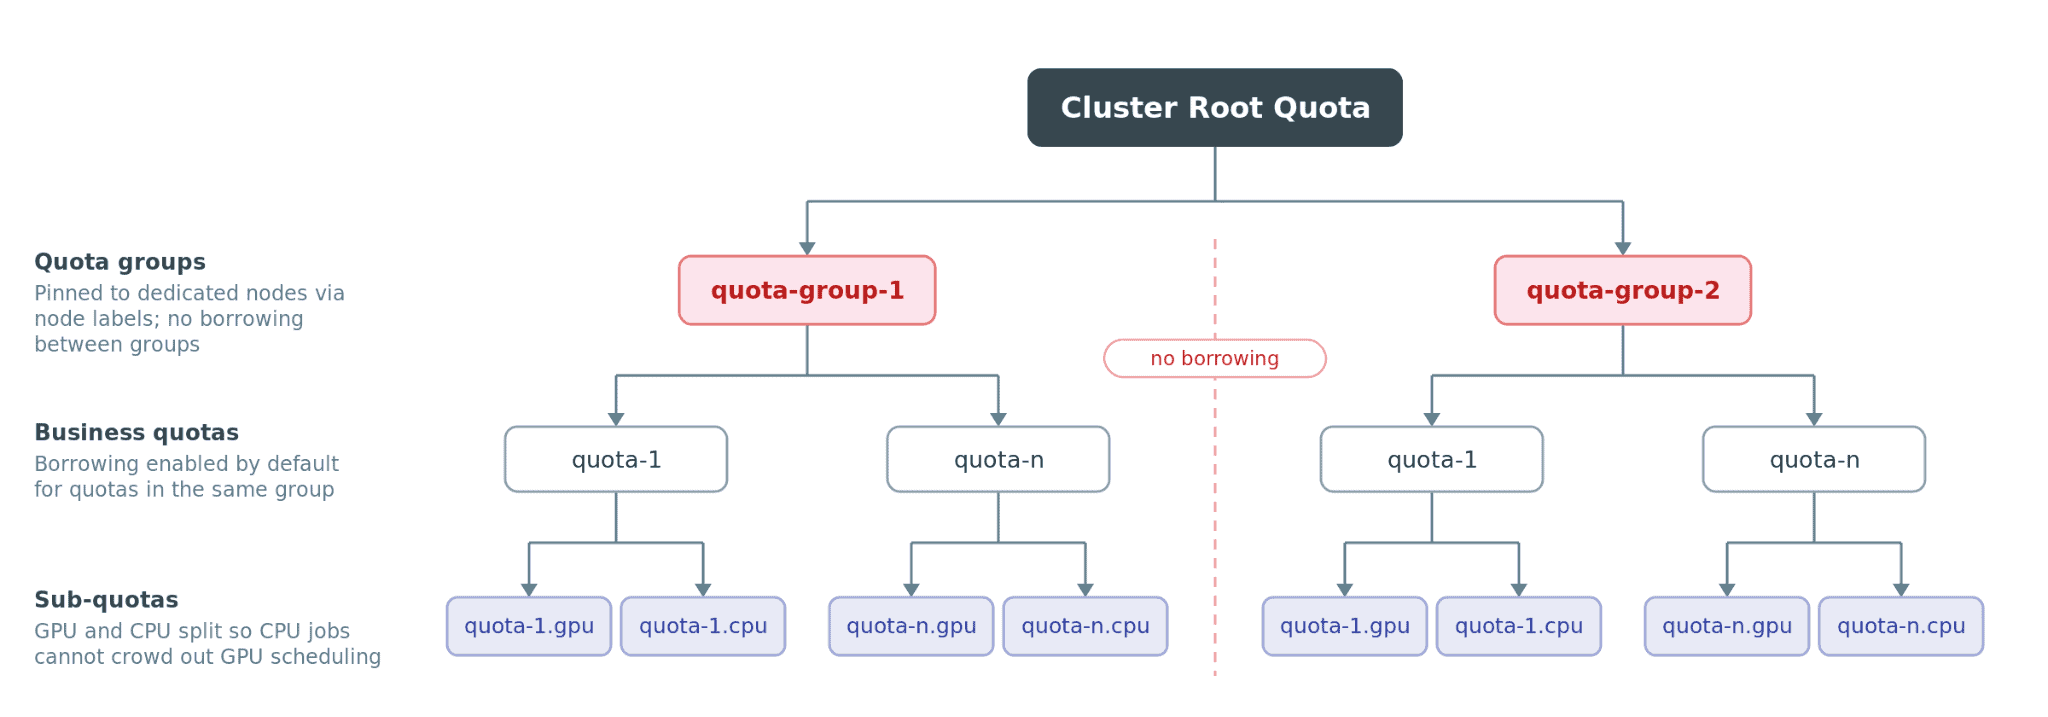
配额组隔离资源池;叶子配额在组内借用资源,并分开管理 GPU 与 CPU 需求。
Reservation:安全提高 GPU 节点的资源利用密度
在 8 GPU / 224 CPU 的节点上,Reservation 为 GPU Pod 预留 CPU 和内存,使 CPU 工作负载可以使用剩余容量,而不会阻碍后续 GPU 任务的调度。这相当于划出一个虚拟 CPU 池,约 112 核、500Gi,具体按 GPU 作业的资源形态调整,无需额外购买纯 CPU 机器。
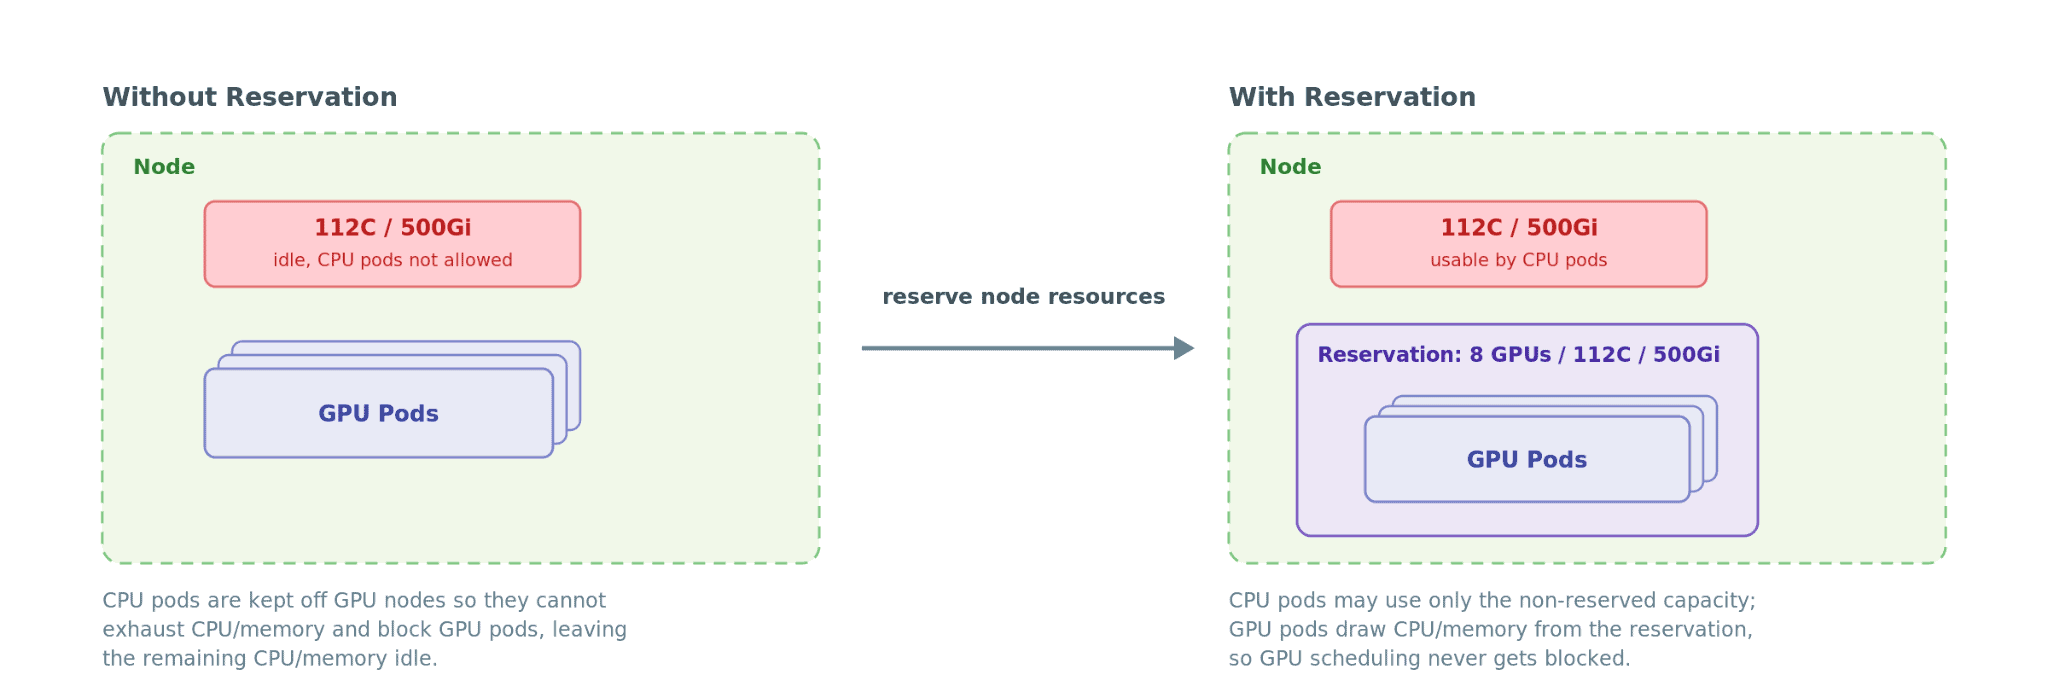
Reservation 为 GPU Pod 保护 CPU/内存资源,CPU 工作负载使用剩余容量。
Device Share + HAMi:GPU 切分与隔离
细粒度 GPU 共享经过四个步骤:Pod 请求 gpu-core 和 gpu-memory-ratio;koord-scheduler 的 Device Share 插件绑定一个切片;koordlet 通过 NRI 将设备环境变量注入 CRI Runtime,而不是直接注入容器;HAMi-Core(由 hami-daemon 挂载的 libvgpu.so)拦截 CUDA API 调用,在转发给 NVIDIA 驱动之前执行显存与算力限制。
同机任务因此能够保持在各自的分配限额内,让 Codespaces 和小模型推理共享 GPU,而不必独占整卡。
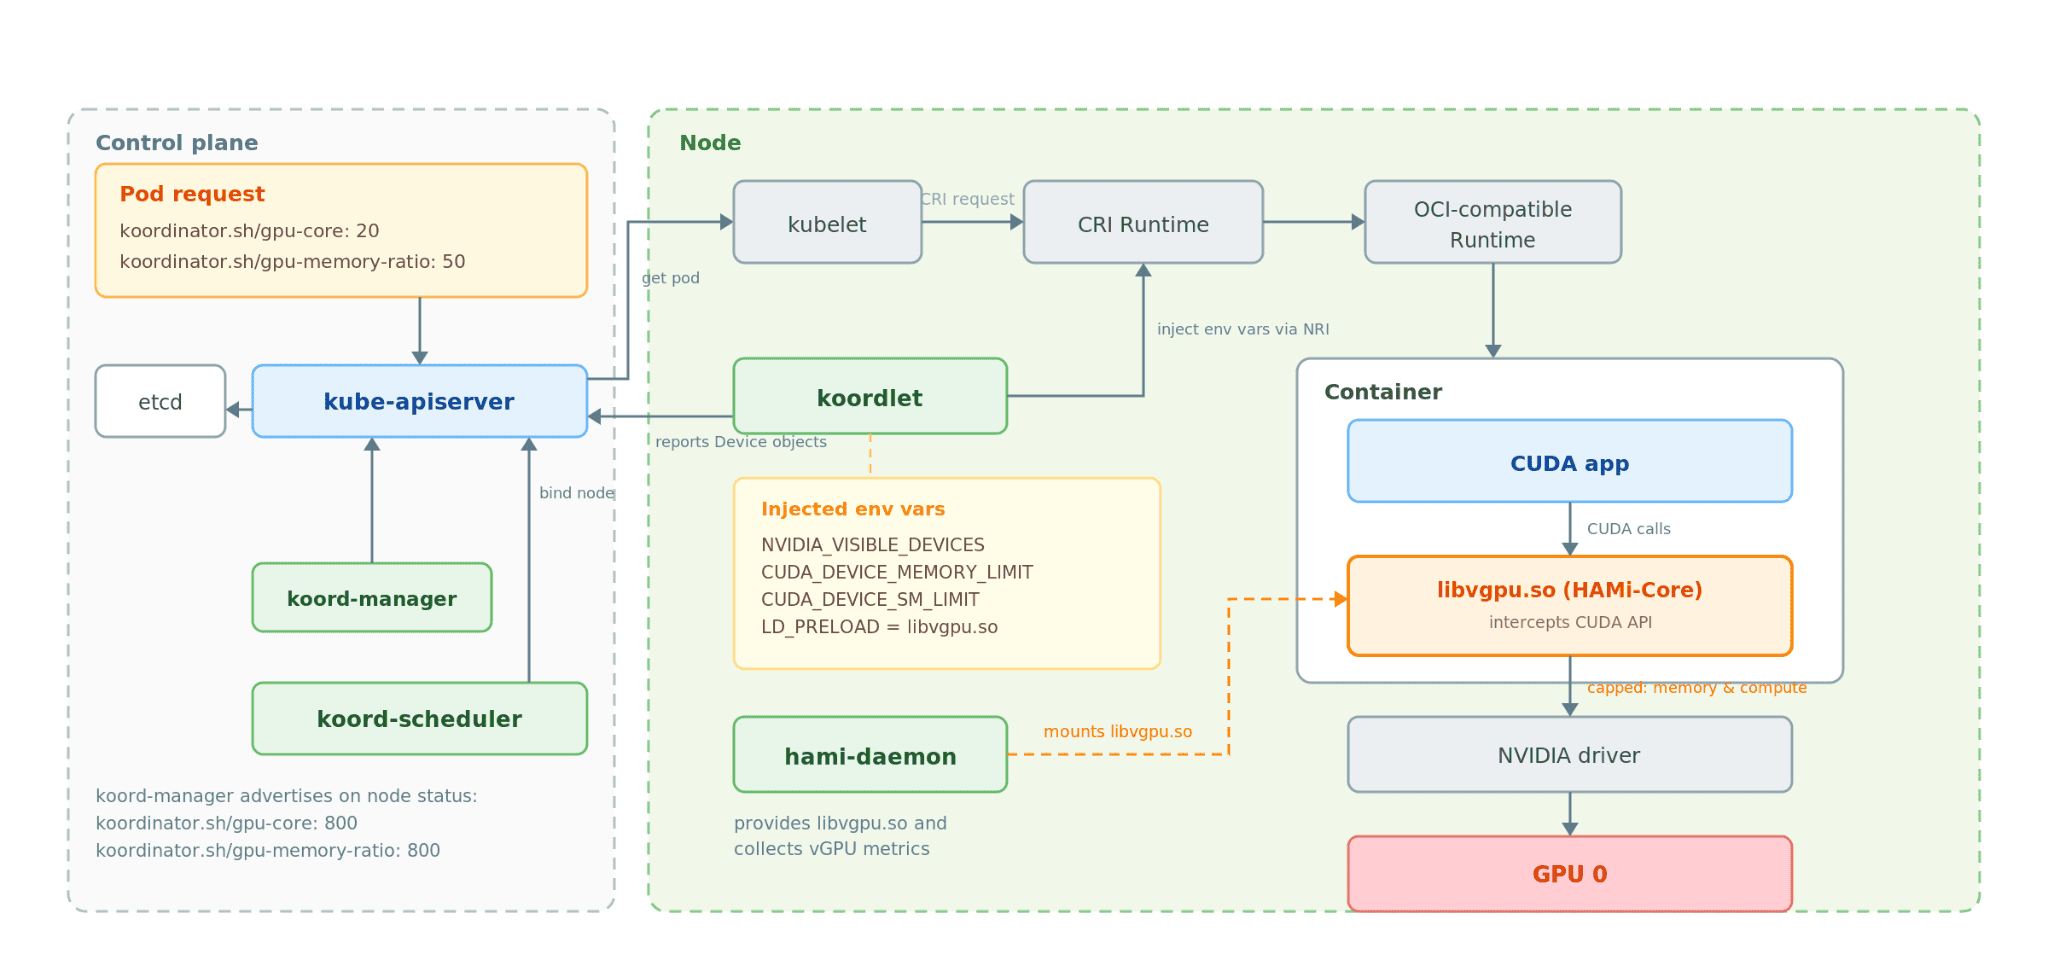
Device Share 放置 GPU 切片;HAMi-Core 拦截 CUDA API 调用并执行运行时限制。
实施效果
Gang Scheduling:分布式作业同时启动或整体释放
工作负载控制器为 Head 和 Worker Pod 设置相同的 gang 名称与 min-available 数量。Koord-scheduler 识别这些注解,为各 Pod 选择节点,并在 Permit 阶段暂缓绑定。达到 min-available 所要求的有效放置数量后,调度器才放行整组绑定。
如果超时前未达到阈值,则回滚全部已假定分配的 Pod。一个分布式作业要么获得足够资源后启动,要么释放临时预留,避免部分 Pod 占着 GPU、其他成员却一直等待。
量化结果
| 指标 | 结果 |
|---|---|
| ElasticQuota 对象 | 每个集群 100 多个 |
| 调度吞吐 | 每天 30 万至 80 万个 Pod |
| GPU 分配率 | 超过 95% |
| GPU 利用率 | 整体超过 55%;共享推理约 60% |
| Codespaces 所需 GPU 整卡 | 减少约 60% |
测量方法。 GPU 分配率是已调度 GPU 卡数除以可调度 GPU 卡数,不包含故障设备。GPU 利用率采用节点遥测上报的平均 SM 利用率,分别统计全体集群与共享推理节点。Codespaces 的节省量比较 Device Share 引入前后的整卡需求。
后续计划
算力需求随业务增长,调度吞吐与精度越来越成为整条流水线 SLA 的约束。团队接下来关注四个方向:遵守分布式作业原子性的 ElasticQuota 回收;通过工作负载级队列平抑 Pending 峰值;通过调度器分片突破串行调度上限;以及面向突发 AI 需求的多集群、混合云调度。团队会结合这些生产场景评估 Koordinator 社区相关能力,并将结果反馈给社区。
原文:How Zhuoyu Technology Pushed GPU Allocation Above 95% on Kubernetes with Koordinator ↗
发布方:Cloud Native Computing Foundation(CNCF) · 2026-09-29
本页为 CNCF 案例的中文翻译,保留原文技术信息与数据口径;并非 CNCF 官方中文版本。架构图沿用原文,图内英文保留。项目阶段及产品信息以文章发布时为准。
原文依 Linux Foundation 内容条款使用,适用 CC BY 3.0;本页进行了中文翻译和版式调整,品牌标识归各权利人所有。