
赛力斯如何通过 Kubernetes 与 HAMi 支撑日均百亿 Token 推理
从约 3 亿增长至 100 亿以上
HAMi 与平台动态扩缩容协同,原为 15%–25%
SeresCloud 整体业务增长
本文目录
关于赛力斯与 SeresCloud
赛力斯是一家以新能源汽车为核心业务的科技型汽车企业。随着 AI 应用在企业内部不断落地,赛力斯自建了 SeresCloud,为业务系统与智能体应用提供统一的模型服务,并以 Kubernetes 管理底层 GPU 资源。
2026 年,平台在线模型数量从约 10 个增至 42 个以上,日 Token 处理量从约 3 亿增长至 100 亿以上。业务快速增长,也让小模型推理场景下的 GPU 利用效率成为重点。
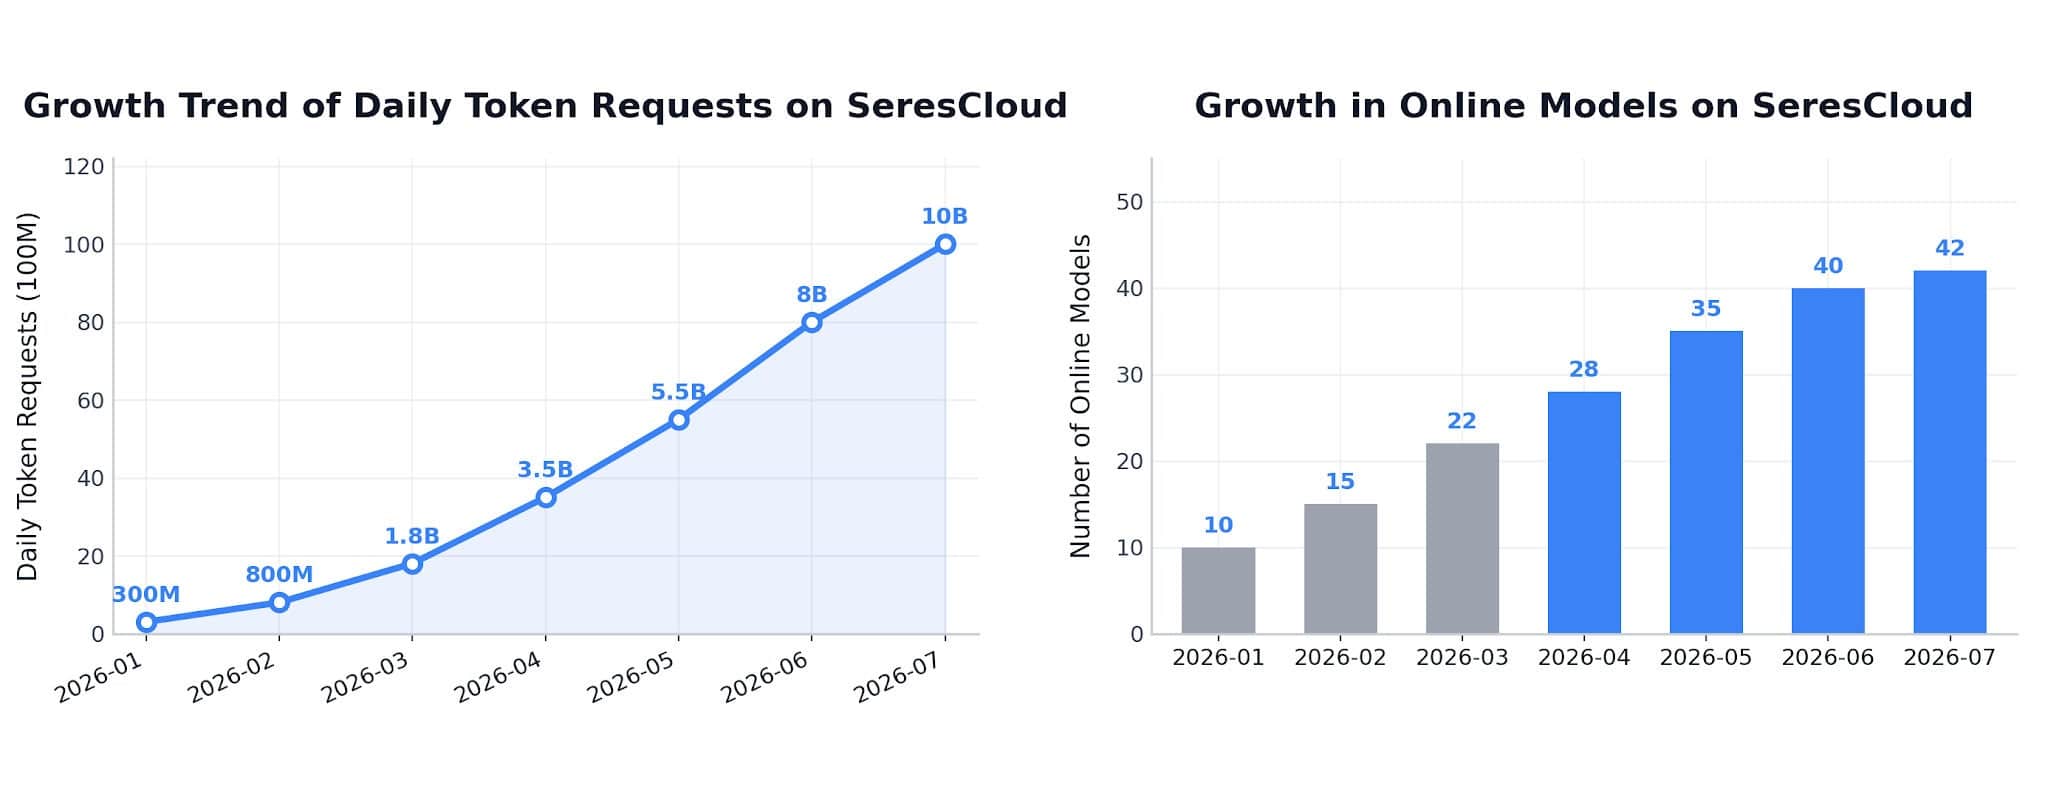
SeresCloud 的模型数量与日 Token 处理量增长
整卡分配难以匹配小模型需求
原有环境通过 GPU-Operator 管理设备,并在支持的 A100、H100 上使用 MIG。随着模型类型和 GPU 型号增加,整卡分配的粒度难以适应 Embedding、Rerank、语音和 OCR 等小模型。单次推理往往仅需 1–4 GB 显存,流量又存在明显的昼夜波动,独占模式下这些场景的 GPU 利用率通常只有 15%–25%。
Time-slicing 能让多个任务共享设备,但缺少明确的显存与算力边界,容易带来资源争抢、OOM 和延迟抖动。赛力斯需要在提高资源利用率的同时,让多租户推理服务保持可控。
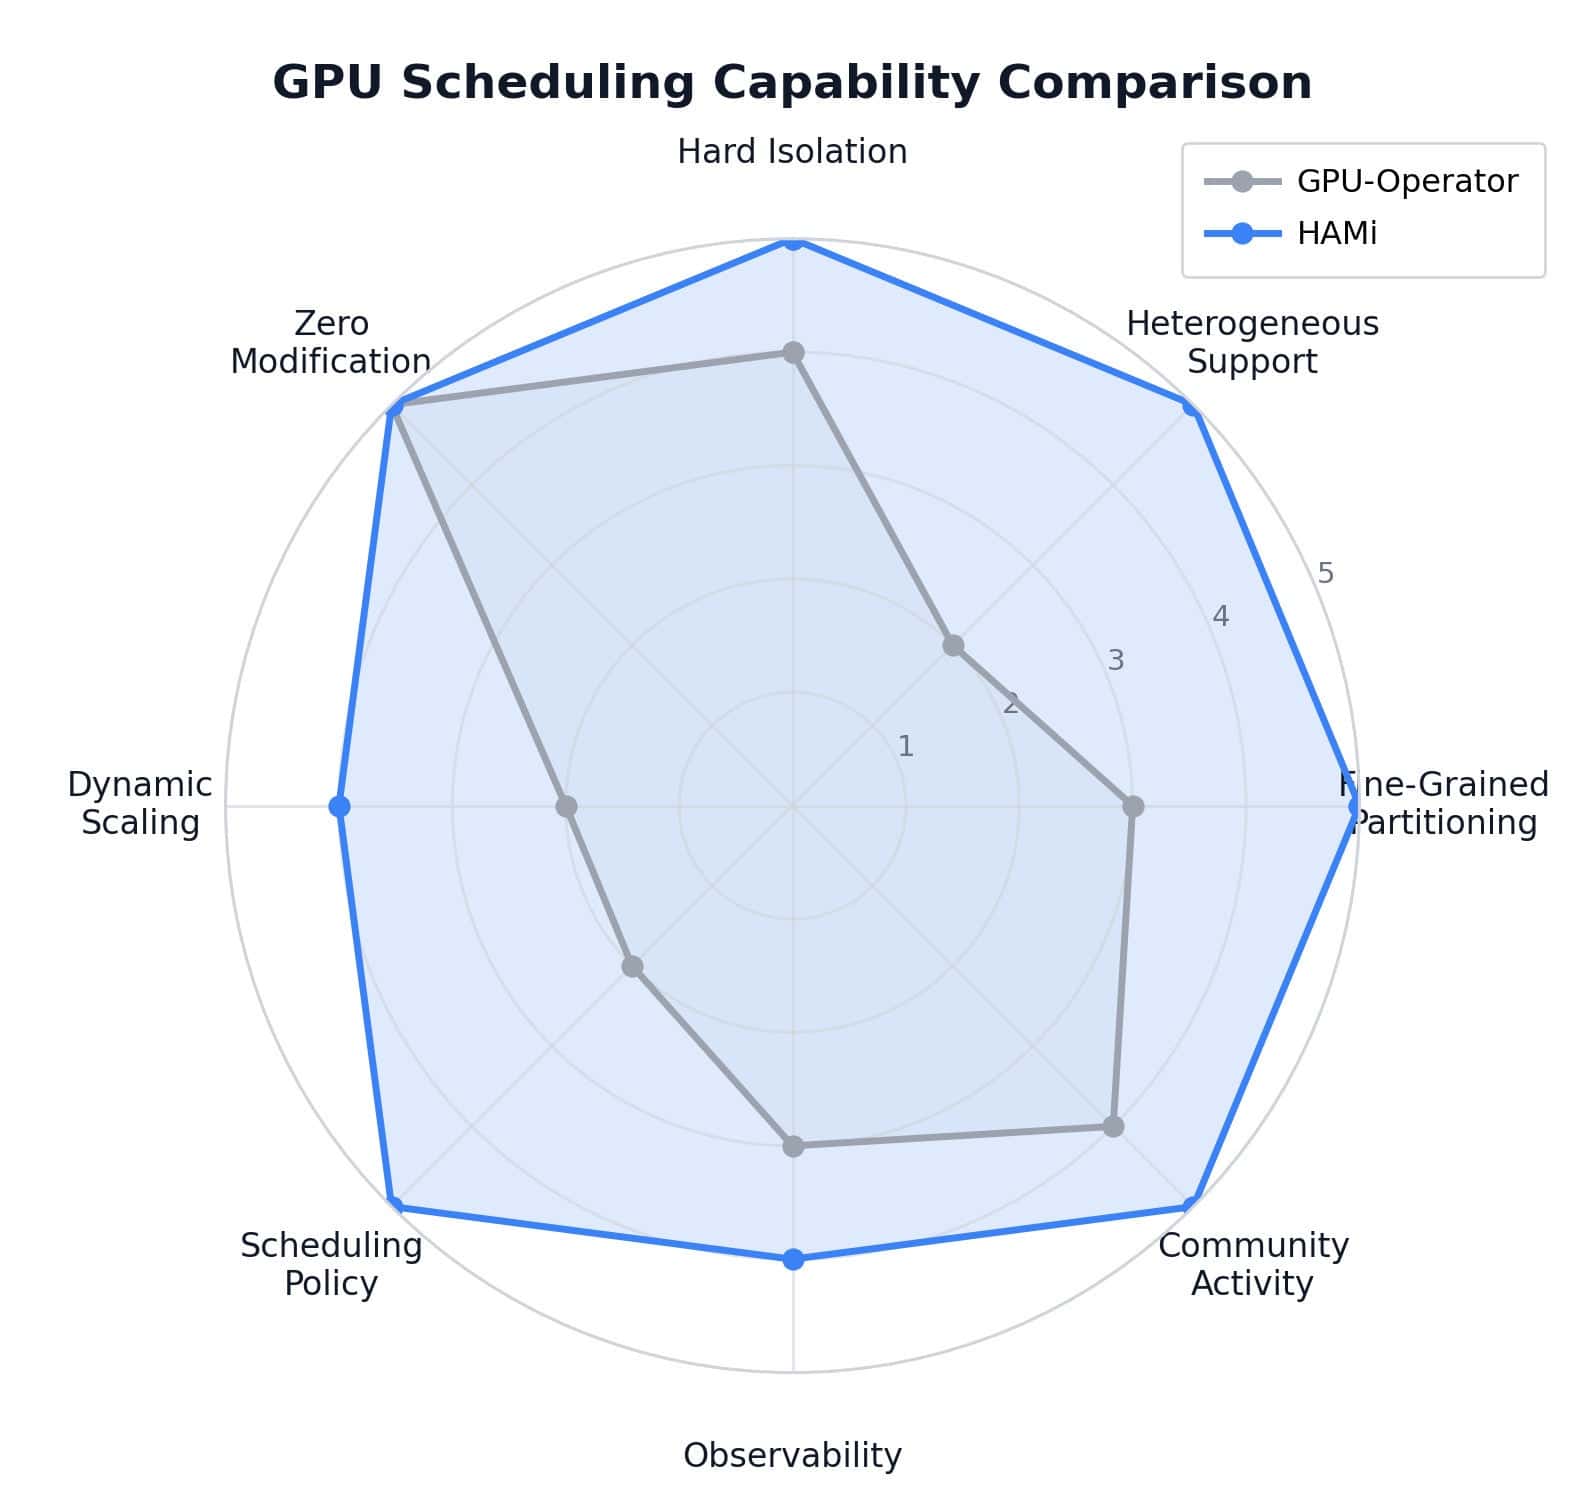
不同 GPU 资源分配方式的对比
HAMi 与平台动态扩缩容协同
SeresCloud 已具备模型注册、推理网关、自动扩缩容和监控能力。模型注册统一管理镜像、配置与版本;推理网关负责路由、负载均衡、限流与熔断;扩缩容则结合 QPS、GPU 利用率和队列深度调整服务副本。
引入 HAMi 后,平台负责决定何时扩缩容、需要多少副本,HAMi 则负责将副本放置到合适的 GPU,并限制每个任务的显存和算力使用。两层通过统一的监控信号协作,将服务弹性与细粒度资源分配连接起来。
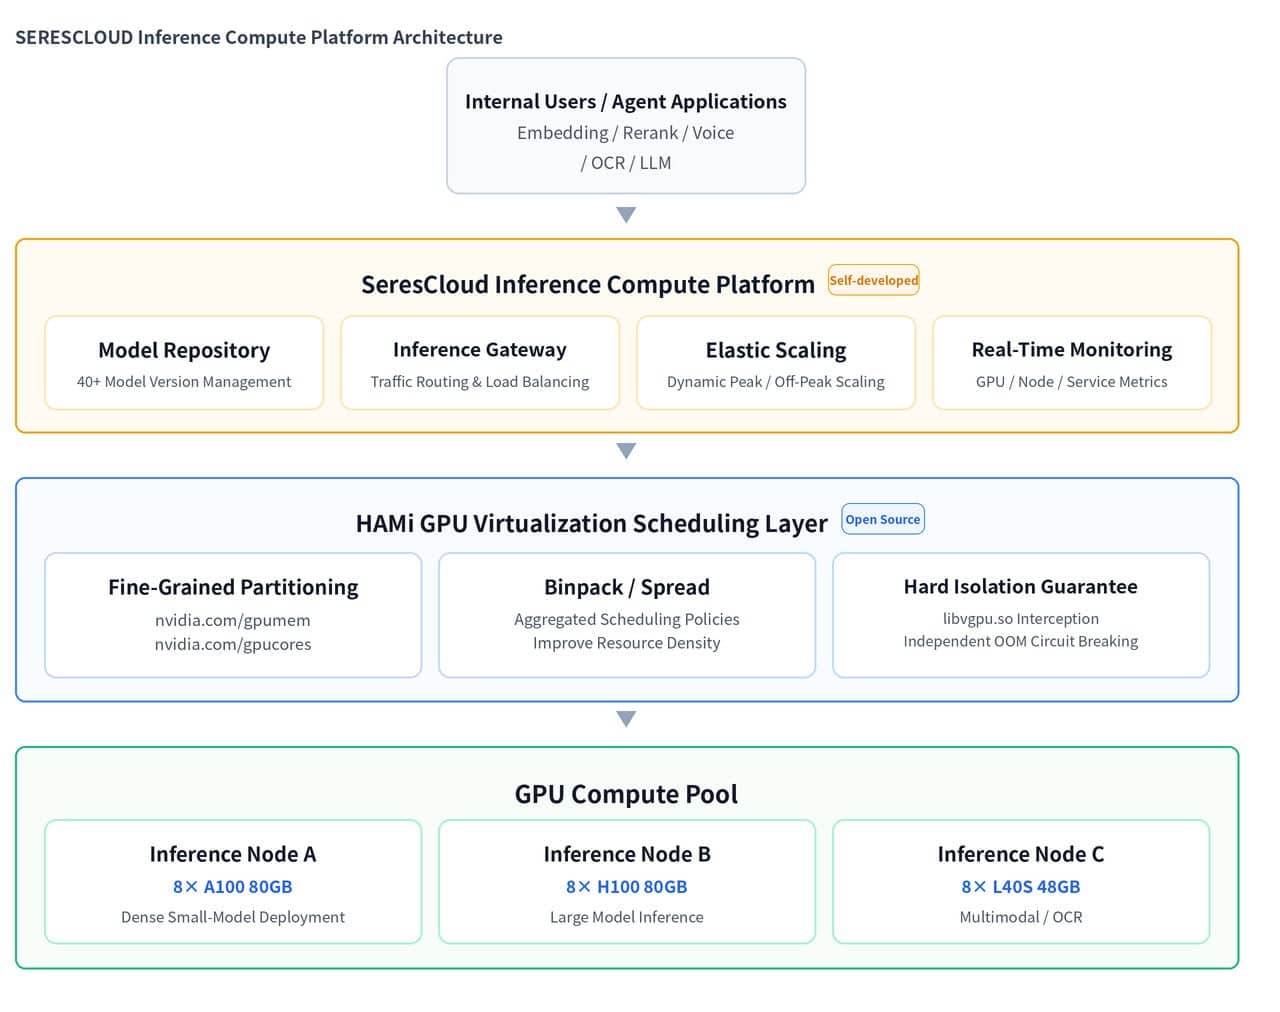
SeresCloud 推理平台与 HAMi 的协同架构
让多个推理任务共享一张卡
通过 HAMi,任务可以在 Kubernetes Pod 中声明所需的 vGPU 数量、显存和算力比例。下面的示例申请 1 个 vGPU、3,000 MiB 显存和 30% 算力,帮助小模型按需使用资源,而不必独占整张卡。
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 3000
    nvidia.com/gpucores: 30
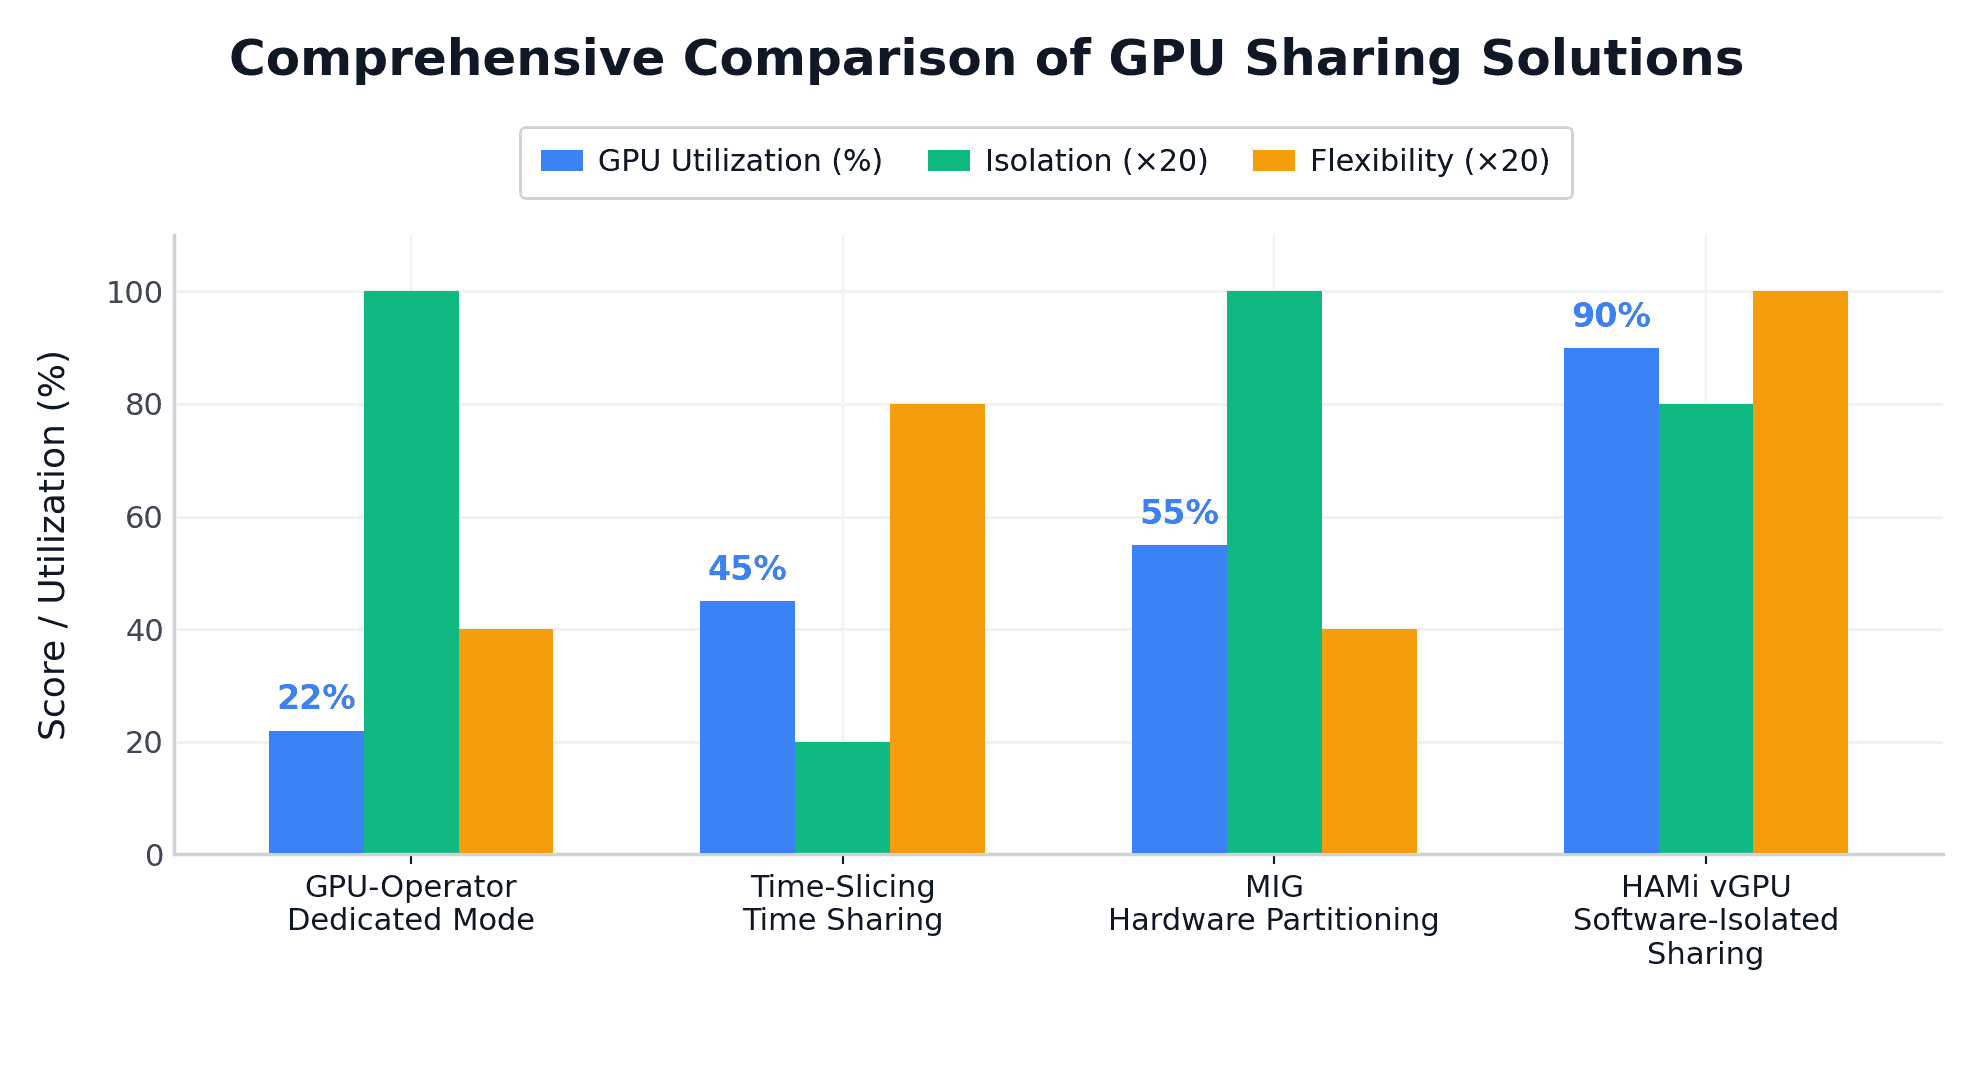
从整卡独占到具有资源边界的 GPU 共享
生产环境中的调度与配置
赛力斯在生产环境中使用 Binpack 与 Spread 策略,并根据业务负载选择资源放置方式。经过实际压测,每张物理卡最多划分为 10 个 vGPU 任务,不开启显存和算力超卖。任务数量增加并不意味着物理资源增加,调度时仍需检查设备的剩余资源。
devicePlugin:
  deviceSplitCount: 10
  deviceMemoryScaling: 1
  deviceCoreScaling: 1
  migStrategy: none
  disablecorelimit: "false"

scheduler:
  defaultMem: 5000
  defaultCores: 0
小模型推理 GPU 利用率提升至约 90%
HAMi 与 SeresCloud 动态扩缩容共同作用,使小模型推理场景的 GPU 利用率从 15%–25% 提升至约 90%。与此同时,整个平台的日 Token 处理量增长超过 3,000%,达到 100 亿以上,在线模型超过 42 个。平台业务增长与资源效率提升相互配合,为更多 AI 应用提供支撑。
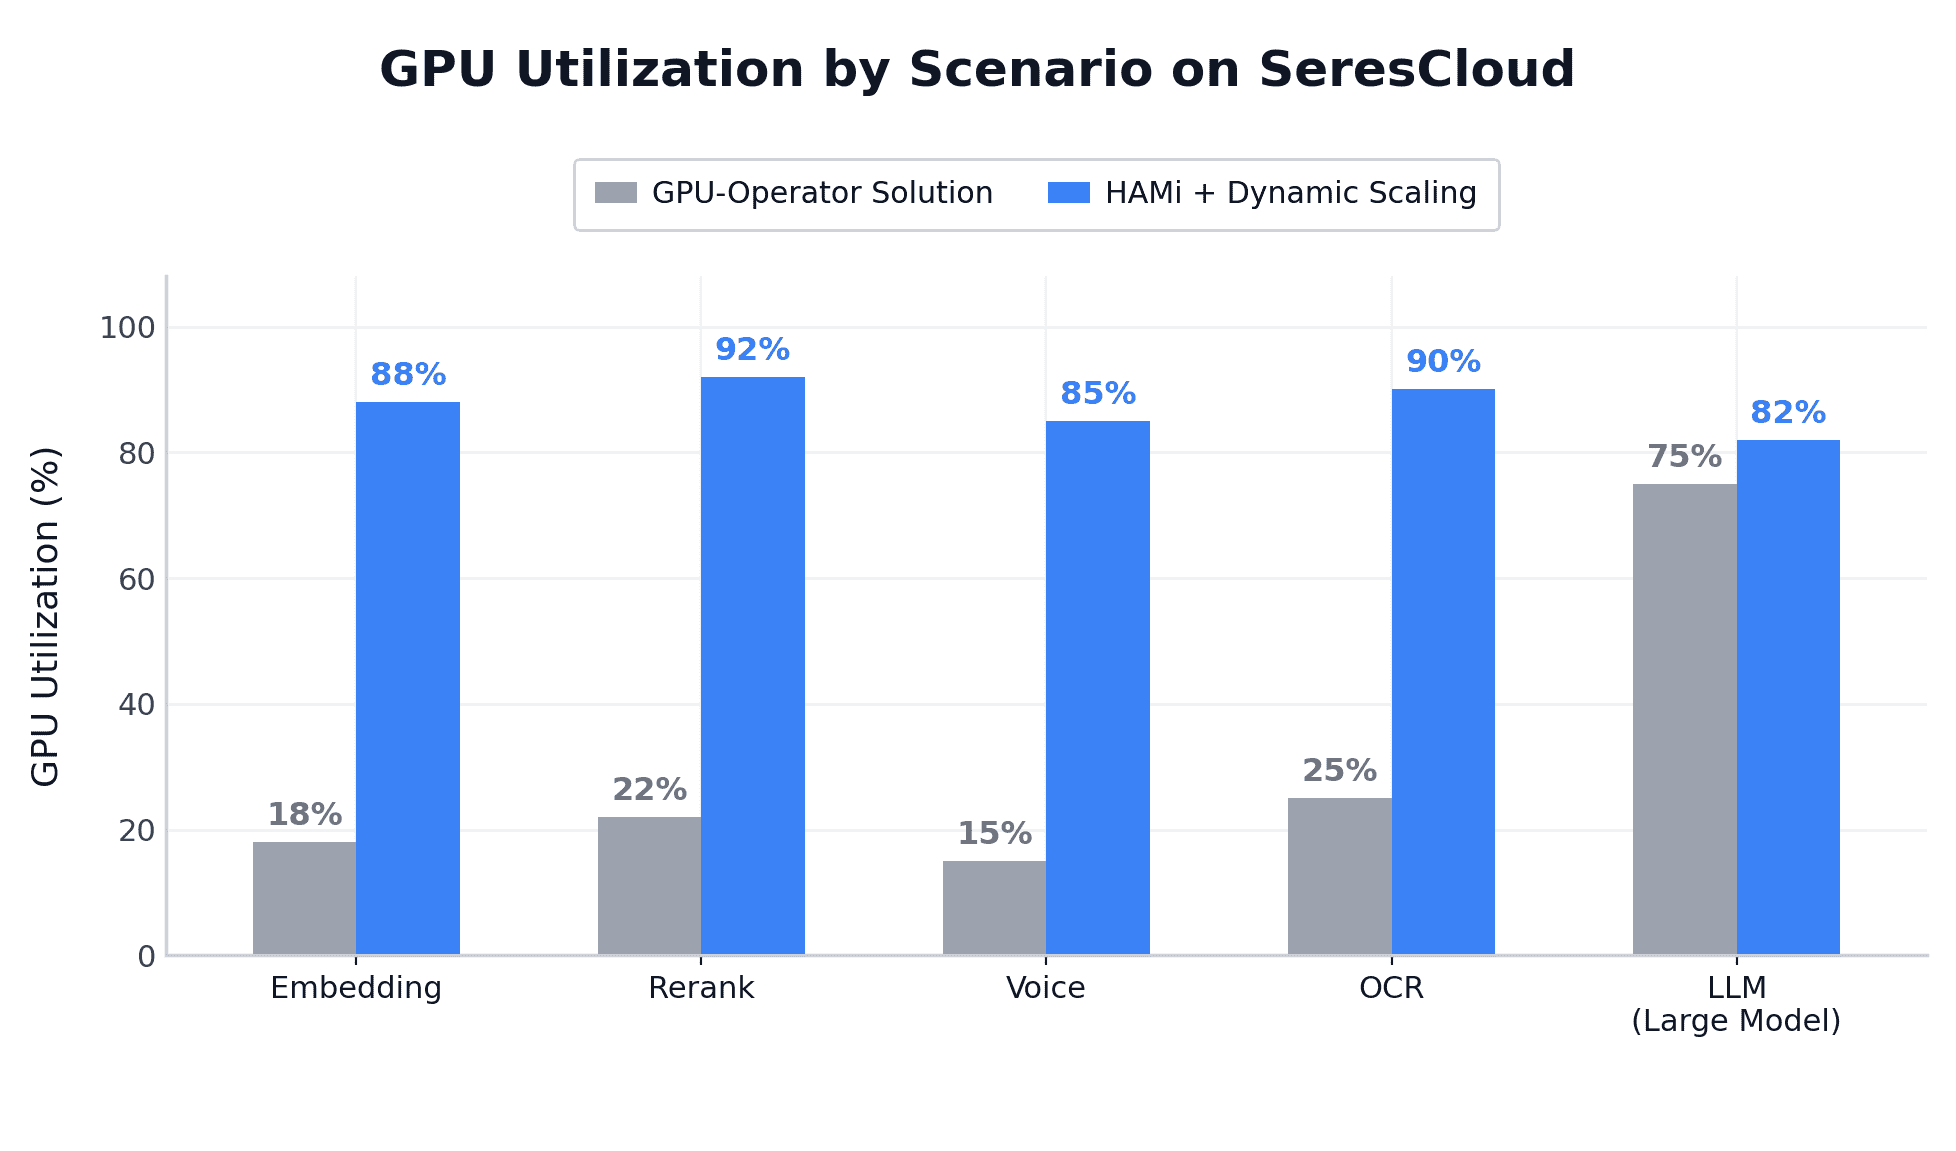
小模型推理场景的 GPU 利用率变化
从生产实践中沉淀工程经验
落地过程中,团队为特权调试 Pod 设置 Webhook 跳过规则,并结合 NodeInsufficientDevice、CardTypeMismatch、CardInsufficientMemory 等原因定位调度失败。通过 Prometheus 和 Grafana 观察 HAMi 与平台指标,让故障排查、资源放置和自动扩缩容使用一致的信号。
设备切分数量需要结合真实模型、并发和服务质量压测确定,而不是越多越好。平台扩缩容与 HAMi 调度各司其职,并共享监控数据,是这套方案持续稳定运行的关键。
下一步:拓展异构资源与调度能力
赛力斯计划进一步将昇腾、海光 DCU 等设备纳入资源池,评估 HAMi-DRA,并探索面向大模型的优先级抢占与拓扑感知调度。同时,团队将继续向开源社区反馈生产环境中的经验。
原文:How SeresCloud Scaled AI Inference to 10 Billion Daily Tokens with Kubernetes and HAMi ↗
发布方:Cloud Native Computing Foundation(CNCF) · 2026-11-02
本页为 CNCF 案例的中文翻译,保留原文技术信息与数据口径;并非 CNCF 官方中文版本。架构图沿用原文,图内英文保留。项目阶段及产品信息以文章发布时为准。
原文依 Linux Foundation 内容条款使用,适用 CC BY 3.0;本页进行了中文翻译和版式调整,品牌标识归各权利人所有。