密瓜案例|科大讯飞如何让研发与线上业务共享算力?
科大讯飞作为一家以智能语音和人工智能为核心的科技企业,业务覆盖教育、医疗、智慧城市等领域。支撑这些业务的 AI 平台,既要承载面向用户的推理服务,也要运行数据处理、模型训练和研发实验等多种任务。
不同任务对算力的需求并不相同:线上服务需要稳定的资源保障,研发团队则希望尽快获得 GPU,启动实验、验证模型。当这些业务共用同一批算力时,**如何保障关键业务稳定运行,同时让暂时空闲的 GPU 得到更充分的利用,**成为平台建设需要解决的问题。
为此,科大讯飞在保留 Airflow、Spark 等既有工作流的基础上,结合 Kubernetes、Volcano 与 HAMi-Core,构建兼顾资源保障与弹性共享的 GPU 资源管理体系。
在这套由科大讯飞自主建设的体系中,密瓜智能(Dynamia)核心团队发起并持续维护的 HAMi,提供了 GPU 显存与算力细粒度控制能力,让存量 GPU 能够按任务需求分配,成为平台开展多业务共享的基础之一。
多业务共用 GPU,难在哪里
对科大讯飞而言,让不同业务共享 GPU,不只是提高资源使用的灵活性,还需要解决三个现实问题。
- 资源需求不同。 线上推理服务需要稳定的算力保障,研发实验则希望灵活使用空闲资源。固定划分 GPU 容易造成部分资源闲置,完全开放共享又可能影响关键业务的稳定运行。
- 现有流程需要保留。 Airflow、Spark 等工具已承载大量业务流程,如果为了引入 GPU 共享而重新搭建任务入口、迁移编排逻辑,将增加平台改造成本与业务风险。
- 共享后的管理更加复杂。 资源如何借用与回收、任务之间是否相互干扰、异常发生后如何追溯,都需要明确的管理规则和运行记录。
因此,科大讯飞选择在延续既有业务体系的基础上,通过任务调度与 GPU 细粒度资源控制,让底层算力具备更灵活的分配能力,同时兼顾关键业务保障与研发任务的弹性需求。
流程继续用,GPU 按需分
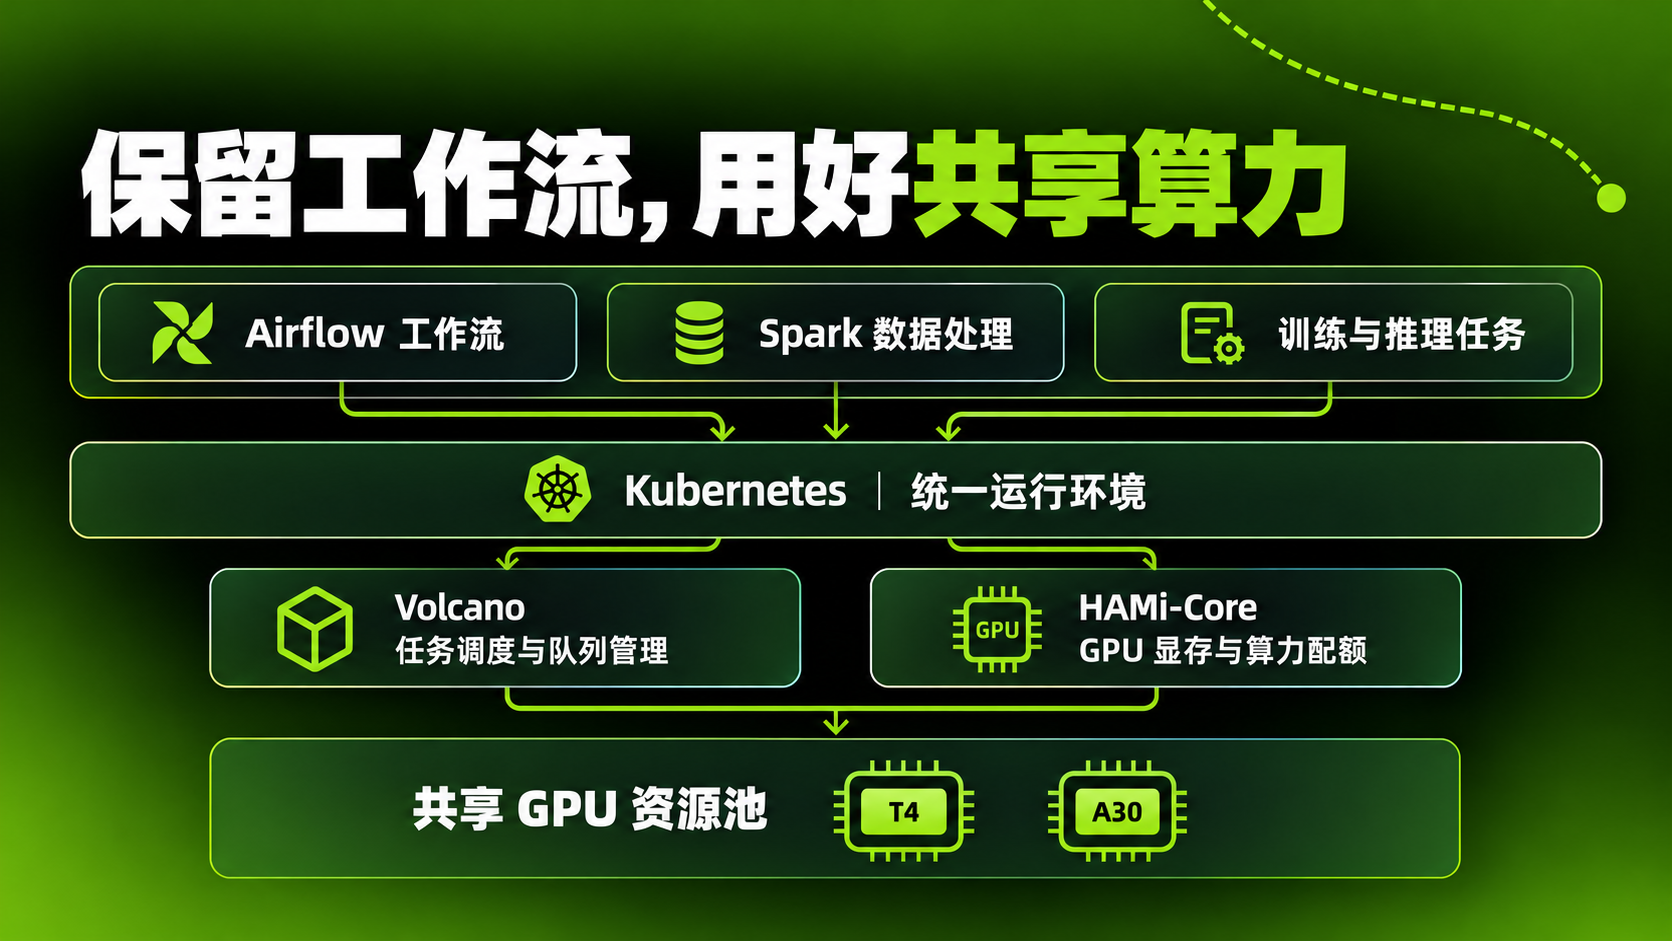
在业务侧,科大讯飞保留原有工作流的任务编排方式,将底层任务接入统一的 Kubernetes 运行环境。研发人员还可以从工作流中的指定节点启动验证,使用部分数据检查模型或代码修改,无需每次重新运行完整流水线。
在资源侧,平台采用分层协同的架构:Kubernetes 管理基础运行环境,Volcano 负责队列与任务调度,HAMi-Core 则控制任务在 GPU 内可使用的显存和算力。
其中,Volcano 决定任务如何获得资源,HAMi-Core 则进一步控制任务在共享 GPU 中的资源使用额度。两者协同,使 GPU 资源分配不再局限于整卡占用,而是能够根据不同任务的需求进行细粒度配额管理。
通过这种协同方式,GPU 资源管理不再局限于整卡分配,而是能够在符合业务运行要求的前提下,根据不同任务的需求设置更细粒度的资源配额。
在实际建设中,科大讯飞将 T4、A30 等存量 GPU 纳入研究场景,借助 HAMi-Core 的细粒度控制能力,让不同任务能够更灵活地使用既有设备。
通过这种方式,科大讯飞既保留了原有业务流程,也将 GPU 共享能力融入现有调度体系,在减少业务改造的同时,为存量算力的灵活使用提供了技术支撑。
关键业务有保障,研发用卡有弹性
GPU 能够共享之后,企业还需要解决一个关键问题:如何在灵活利用空闲资源的同时,保障重要业务稳定运行?
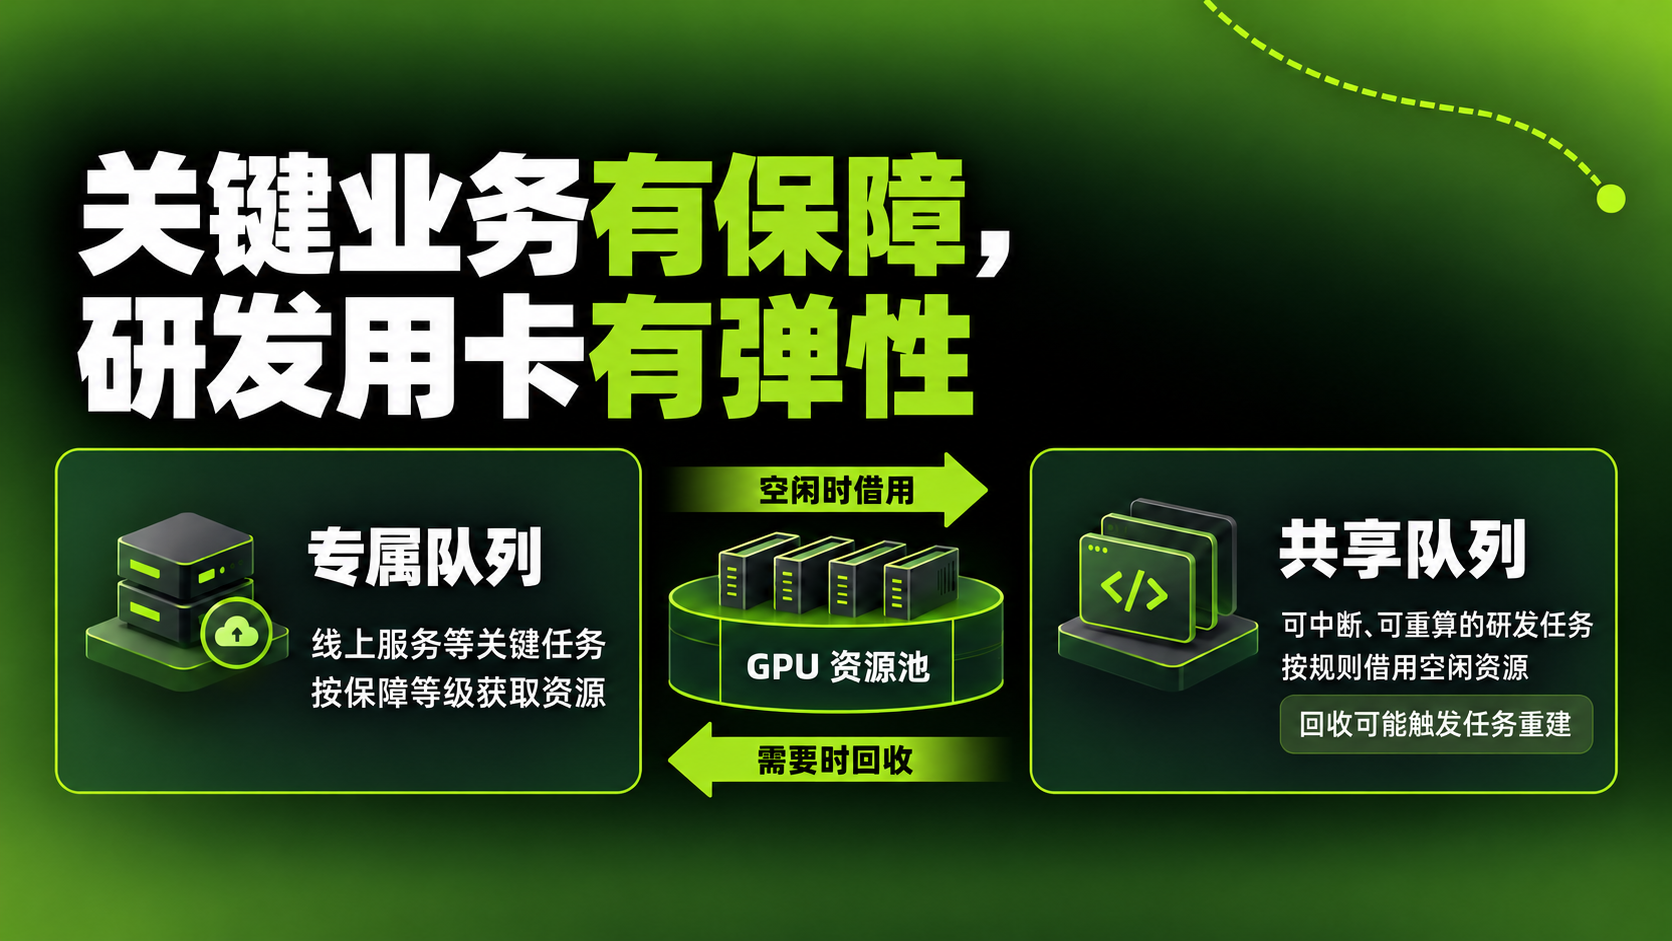
线上推理服务需要持续、稳定的资源供给,而部分研发实验能够接受任务中断或重新执行。针对这些差异,科大讯飞通过专属队列与共享队列,为不同业务设置最小资源保障、最大资源额度及使用权重。
关键业务按照既定规则获得资源保障,可中断、可重算的研发任务则可以借用暂时空闲的容量。当资源需要回收时,平台依据队列规则进行调整,让资源共享建立在明确的业务优先级之上,在保障关键任务的同时,提高存量算力的使用灵活性。
不过,**弹性共享也有相应的使用边界。**资源回收可能触发任务驱逐和重建,因此需要根据任务是否能够中断、是否允许重算,制定不同的资源规则。同时,HAMi-Core 的用户态资源限制并不等同于硬件级故障隔离,共享同一张 GPU 时,仍需评估任务之间的资源干扰与异常影响。
为了让共享规则持续有效,科大讯飞还完善了 GPU 资源的可观测与追溯能力。
平台整合 DCGM、DCMI 等监控采集接口,补充 GPU 设备与 Pod 的映射关系,并记录任务创建、退出等关键生命周期事件。这些运行信息能够帮助平台团队了解资源使用情况,定位异常发生的环节,分析任务抢占与资源回收的影响,为故障排查、配额调整和成本分摊提供依据。
通过队列管理、细粒度资源控制与运行监测的配合,科大讯飞将 GPU 共享从单纯的资源分配,进一步延伸到面向不同业务需求的资源治理。
共享能力,融入企业现有体系
科大讯飞的实践提供了一种值得参考的思路:对于已经拥有成熟业务工作流和算力基础设施的企业,建设 GPU 共享能力不一定意味着推倒重建,而是可以通过分层架构,将任务调度、细粒度资源控制与现有管理体系逐步衔接。
在这一过程中,原有业务工作流得以保留,T4、A30 等存量 GPU 能够以更细粒度的方式服务研究任务,关键业务与弹性任务也能够按照各自的保障要求使用资源。与此同时,完善的运行记录为后续排障、资源配额调整和管理策略优化提供了依据。
这也体现了 HAMi 在企业实际应用中的价值:细粒度 GPU 共享能力能够与已有的调度器、业务流程及资源管理规则协同,满足多样化的业务需求。 在科大讯飞的实践中,HAMi-Core 与 Volcano 分工配合,使 GPU 卡内资源控制能够融入平台的任务调度体系。
未来,密瓜智能将持续围绕 HAMi 的 GPU 共享与资源治理能力开展建设,保持开放、中立,与硬件、调度及应用生态协作,帮助更多企业结合自身业务需求和现有技术体系,探索更加灵活、可管理的算力使用方式。