HAMi Meetup 上海站深度解读(五):科大讯飞如何用 Volcano + HAMi-core 管好多业务 GPU 共享?
研究任务希望尽快拿到 GPU,线上业务需要稳定的资源保障,大数据处理和模型训练又各有一套编排工具。企业 AI 平台要让这些任务共享算力,就必须同时回答三件事:谁可以使用哪些资源,空闲资源何时能被借用,发生干扰后怎样定位和恢复。HAMi-core 的细粒度资源控制,需要与集群调度、业务流程和运行记录一起发挥作用。
本文是 HAMi Meetup 上海站 系列深度解读的第五篇。科大讯飞资深架构师 董江在本场活动分享的《基于 Volcano + HAMi-core 打造 K8s 异构 AI 加速算力底座》,给出了一套真实的组合实践。团队将 Volcano 的队列与编排能力和 HAMi-core 的 GPU 资源控制结合,让不同业务保留自己的执行方式,也让共享资源拥有清楚的使用规则。沿着这套实践,可以看清 HAMi 如何进入企业已有的平台体系。
核心亮点
- 科大讯飞将 Volcano 的队列与任务编排同 HAMi-core 的卡内资源控制结合。
- 线上服务与研究任务按保障等级分配资源,已有业务工作流可以继续保留。
- 存量 GPU 共享要与监控和故障处理一起设计,用户态资源限制不等于硬件级故障隔离。
演讲嘉宾: 董江|科大讯飞资深架构师
Volcano 管分配规则,HAMi-core 管卡内资源
科大讯飞的 AI 基础设施需要支撑教育、医疗、智慧城市等业务,工作负载覆盖数据处理、模型训练、推理和研究开发。不同任务对资源的要求并不相同。可重算、可延后的研究任务,与必须保持稳定的线上服务,不能采用同一套分配规则。
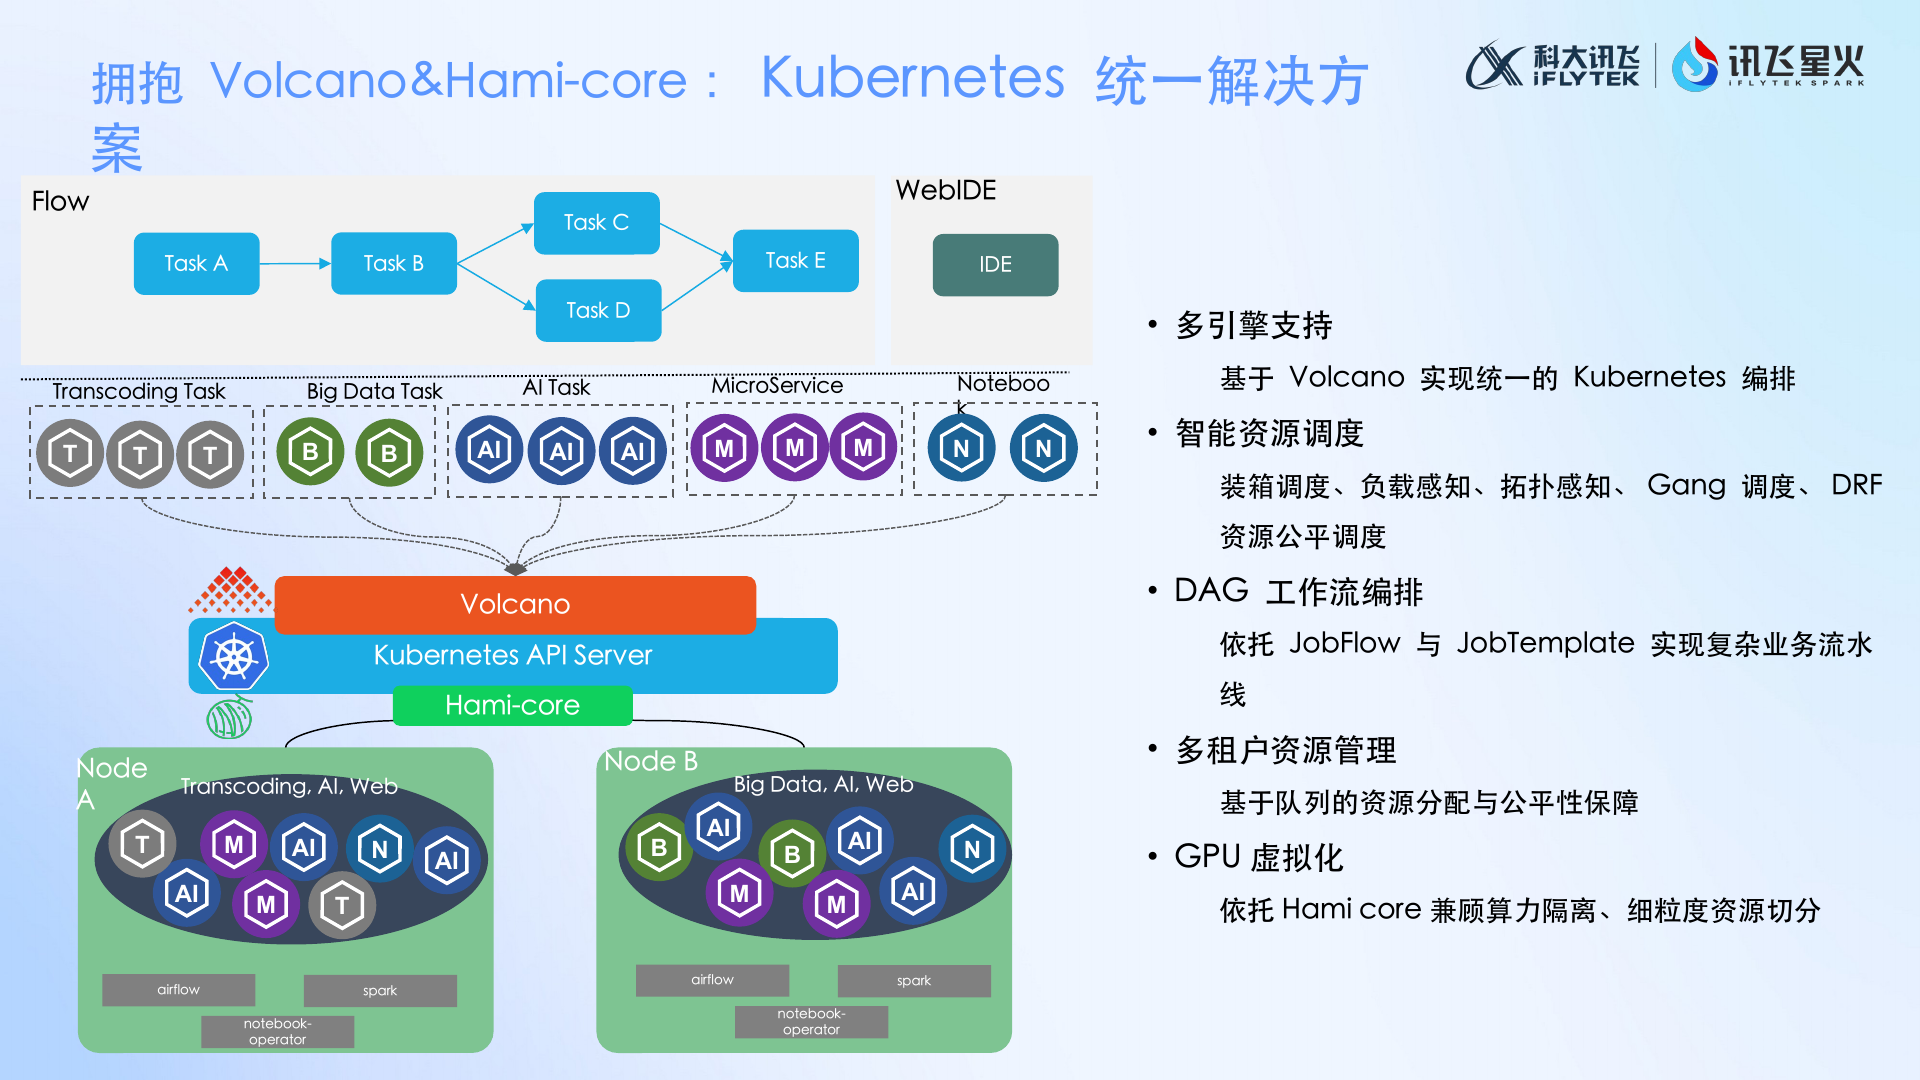
这套实践以 Kubernetes 管理节点与基础运行环境,由 Volcano 承担多类型任务的调度与编排,结合 HAMi-core 实现 GPU 显存和算力的细粒度配额控制。Volcano 组织任务如何获得资源,HAMi-core 控制共享 GPU 中的资源使用。分工明确之后,卡内共享才能接入平台的任务调度与租户管理规则。
在组织管理层面,平台通过专属队列与共享队列映射不同业务需求,设置最小资源保障、最大资源额度及权重。空闲资源可以被其他队列借用,需要时再依据规则回收,让资源保障与弹性共享同时存在。
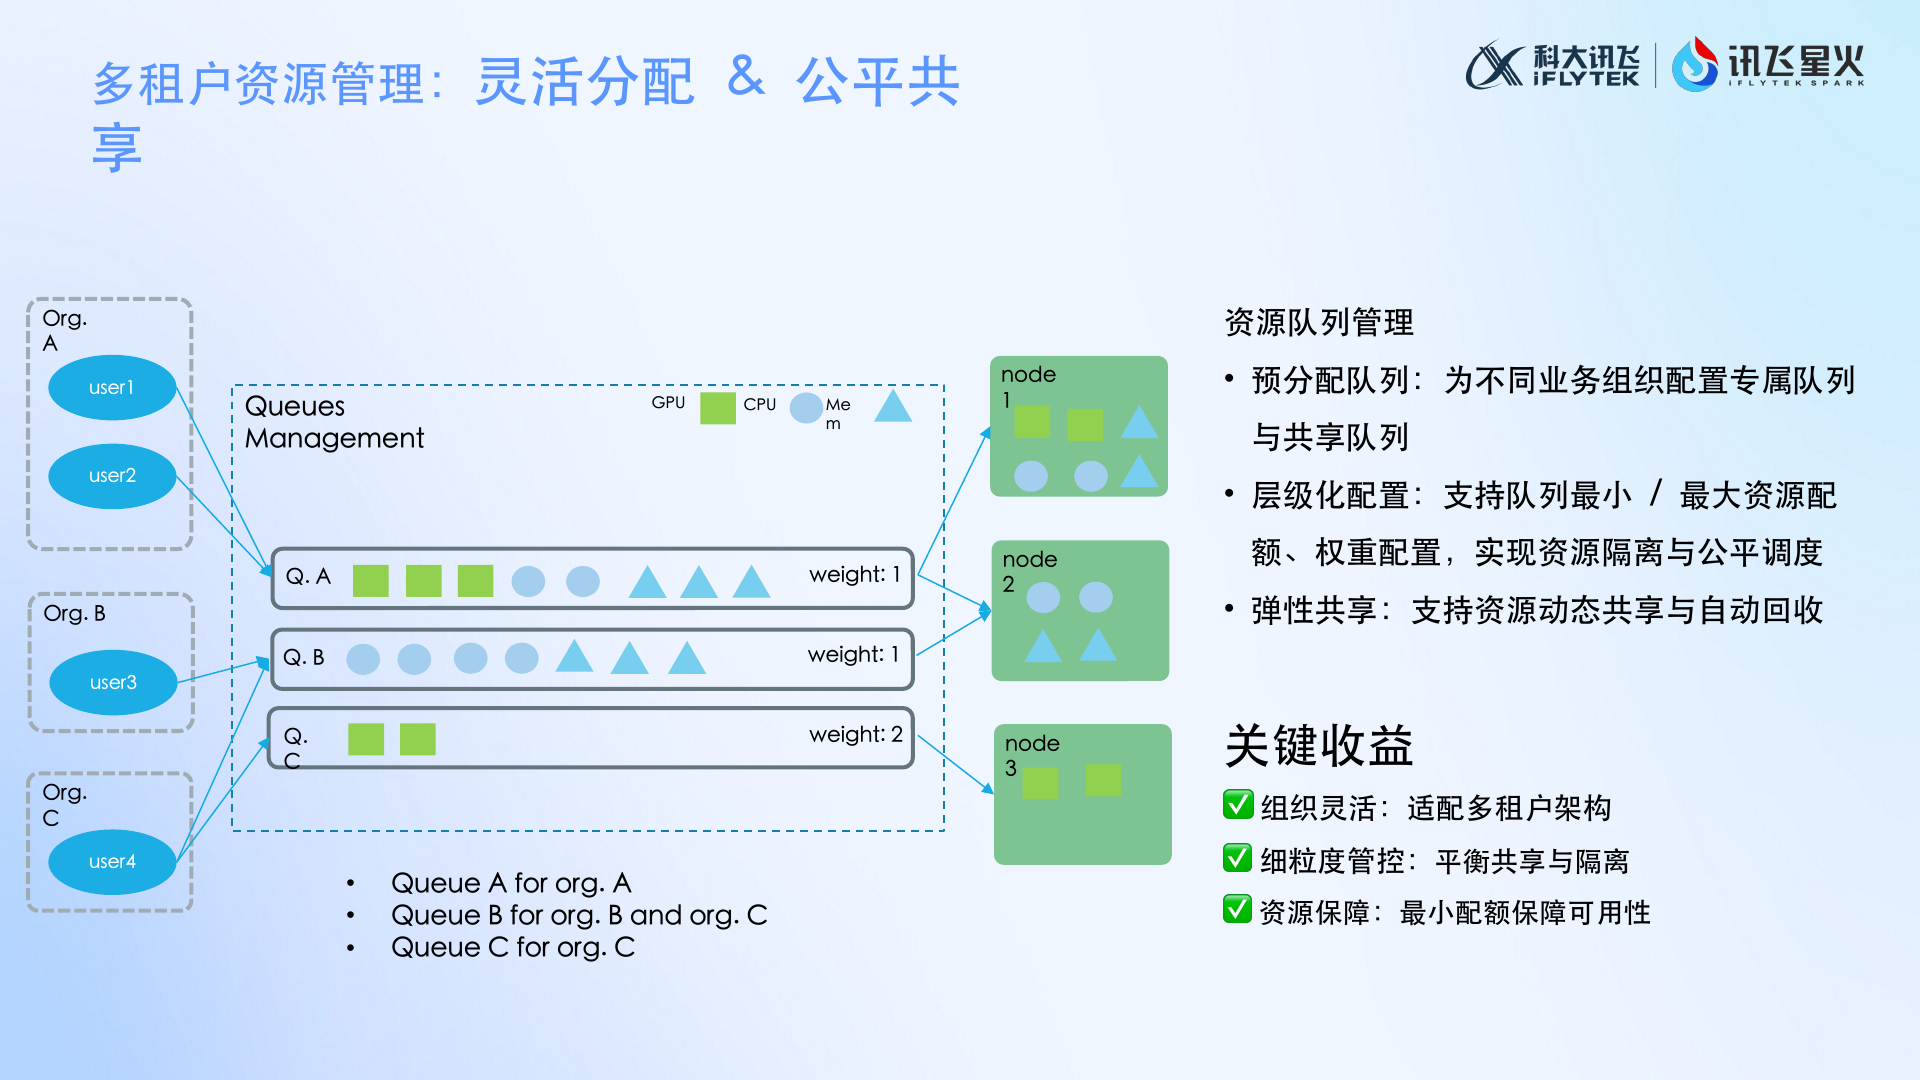
但借用资源也附带代价。资源回收可能触发任务驱逐和重建,因此任务是否能够重算、是否允许中断,必须先进入队列设计。共享规则只有与业务优先级对应起来,才不会把提高利用率的压力转嫁给关键业务。
保留业务入口,统一底层任务执行
企业已有的 Airflow、Spark 等工具,往往承载了长期积累的业务流程。要求所有团队迁移到一个全新的编排入口,会增加改造成本。
董江介绍的路径,是把任务中的原子操作抽象为 JobTemplate,将任务依赖关系组织为 JobFlow,并通过工作流模板复用常见流程。镜像、数据集等执行参数发生变化时,再通过补丁调整具体实例。
原有工具仍可保留自己的编排逻辑,通过相应的 Kubernetes 算子调用底层任务,任务以 Pod 形态运行时,再由 Volcano 与 HAMi-core 配合完成资源分配和控制。这样,企业可以保留上层已经使用的工作流,将底层算力纳入统一管理,减少为了引入 GPU 共享而重做业务入口的负担。
上下游数据则通过存储卷等方式衔接,减少重复复制。这里仍需要处理并发读写、数据一致性和存储性能,不能仅凭接入共享存储就省略这些约束。对于研发调试,也可以从工作流中的某个节点启动实例,使用部分数据验证修改,避免每次都重跑完整流水线。
HAMi-core 的选型价值,要连同使用边界一起看
在调度层,Gang 成组调度用于协调分布式作业的资源需求;Binpack 装箱调度减少资源碎片;真实负载感知则关注申请量与实际使用量之间的差距,为任务放置提供依据。
这一组合解决的是不同层次的问题。集群有剩余资源,不代表资源分布足以启动一个大型作业;任务声明的资源需求,也不总能准确反映运行时负载。
董江介绍,团队把 T4、A30 等存量资源组织起来用于研究场景,选择 HAMi-core 的重要考虑,是让异构设备上的任务获得更细粒度的显存与算力控制。他同时明确区分了资源限制与强隔离:HAMi-core 通过用户态机制控制资源使用,共享同一张卡时,仍需要评估业务之间的干扰和异常影响,不能将其等同于硬件级故障隔离。
研究环境中的超分尝试也有明确前提。他介绍,相关实验资源与生产资源通过标记区分,研究任务需要接受可能发生的中断或重算。这种做法不能直接复制到要求持续稳定运行的线上业务,更不能据此默认显存可以无约束超卖。
让资源行为可追溯,调度规则才有改进依据
多租户共享之后,平台还需要回答,资源由谁使用、任务何时出现异常、回收与重建发生在哪个阶段。
团队在 GPU 可观测建设中整合 DCGM、DCMI 等采集接口,并补充设备与 Pod 的映射关系、创建和退出事件。在关键生命周期节点主动采集信息,可以减少仅靠定时监控造成的上下文缺失,为排障和成本分摊提供依据。
任务历史也会反过来支持策略调整。某项任务是否频繁受到抢占、显存申请是否合适、应该进入专属队列还是共享队列,都需要结合实际运行记录判断。
科大讯飞的实践表明,GPU 共享需要完整的运行规则。HAMi-core 负责细粒度资源控制,Volcano 将这种能力接入队列和任务编排,可观测信息再帮助团队修正配额与放置策略。企业验收共享效果时,也应检查关键任务的保障、资源回收的影响和异常追溯能力。
密瓜智能围绕 HAMi 企业落地所重视的,正是共享能力与生产管理之间的衔接。面对已有调度器和业务流水线的团队,平台建设应先明确负载分级、资源配额和故障边界,再设计集成与验证路径。科大讯飞自主建设的这套实践,为企业评估 HAMi 如何融入现有体系提供了具体参照。
视频回放及 PPT 下载
- B 站回放: 主题演讲 | 基于 Volcano + HAMi-core 打造 K8s 异构 AI 加速算力底座 —— 董江
- 下载 PPT: volcano-hami-core-k8s-ai-base-dongjiang.pdf