HAMi Meetup 上海站深度解读(六):UCloud 如何把 HAMi 共享能力接入可用的开发环境?
GPU 已经到位,算法团队却还在等待环境。驱动、镜像、网络和存储逐项配置,换一个集群又要重新适配。即使底层具备了 GPU 共享能力,平台仍需把资源规格、调度配置和开发工具接起来,让用户获得可以直接开始工作的环境。
本文是 HAMi Meetup 上海站 系列深度解读的第六篇。UCloud 高级研发工程师 彭鹏在本场活动分享的《智算平台的工程挑战与实践》,把 HAMi 放进了这条环境交付链路。团队在私有化智算场景采用 HAMi vGPU,同时通过资源抽象、多集群接入、工具注入和镜像加速降低使用门槛。对企业平台团队,这套实践的参考价值在于,如何将底层的资源能力组织成用户可用、运维可管的服务。
核心亮点
- UCloud 在私有化智算场景采用 HAMi vGPU,满足大小模型混布等共享需求。
- 统一实例规格、多集群接入、工具注入与镜像加速,共同缩短开发环境交付链路。
- HAMi 用户态共享、公有云内核级 vGPU 与 QEMU 透传对应不同部署条件,不能混为一种方案。
演讲嘉宾: 彭鹏|UCloud 高级研发工程师
让整卡与 vGPU 进入统一的实例规格
UCloud 建设智算平台的需求来自三个方向:内部算法团队需要快速获得开发环境,自建推理集群需要统一管理,部分购买自有 GPU 的客户则希望获得轻量的管理方案。
用户提交的需求通常很清楚,镜像、CPU 与内存、GPU 型号和数量,以及整卡或 vGPU 分配方式。但这些字段不能直接变成 Kubernetes 中可执行的配置,不同硬件还涉及资源键、分配注解、节点约束和运行时参数。
团队用 Instance Spec 定义稳定的实例规格,将整卡或 vGPU 分配方式纳入统一表达,再由适配层转换为底层配置。资源声明、厂商注解、调度约束和运行参数集中处理,避免每一种工作负载都重复编写硬件适配逻辑。HAMi 提供的共享资源,也由此进入平台统一的环境创建流程。
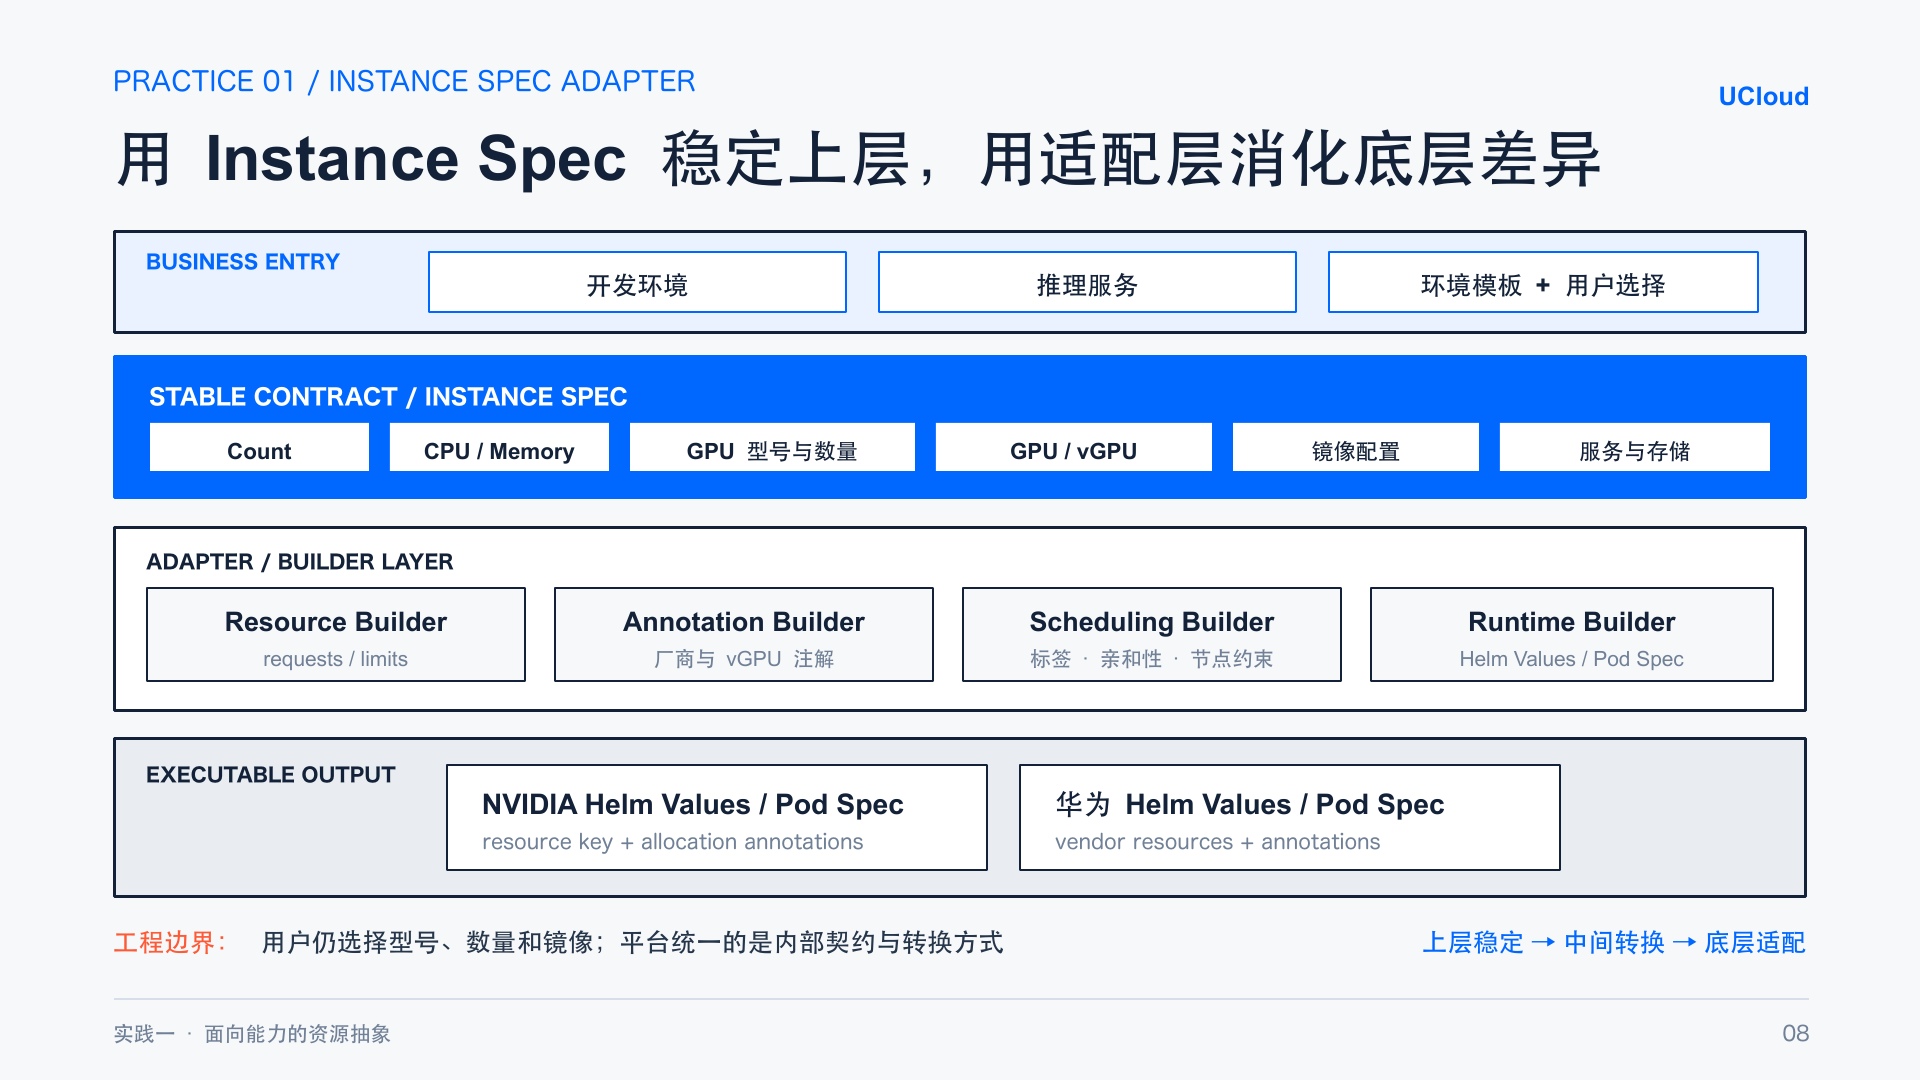
用户仍然需要选择合适的型号、数量和镜像。平台统一的是规格表达与转换方式,而不是假定所有 GPU 可以无差别替换。新增设备时,适配工作也可以围绕这一层提前开展和验证。
多集群管理,按实际业务边界做取舍
集群分布在不同地域,存储、网络和镜像仓库的条件也不同。管理多个集群,需要持续处理接入权限、容量与健康状态、任务生命周期,以及日志和监控汇总。
团队调研过 Karmada 等完整的多集群编排方案,最终选择通过 kubeconfig 接入各集群的 Kubernetes API。原因是当前场景相对收敛,一个任务创建时选定一个目标集群,运行后不需要跨集群分发、迁移或容灾。
在这一前提下,轻量接入减少了额外控制面和资源模型带来的维护负担。日志、指标等能力仍需单独适配,凭据也需要按敏感信息管理,并落实权限控制。
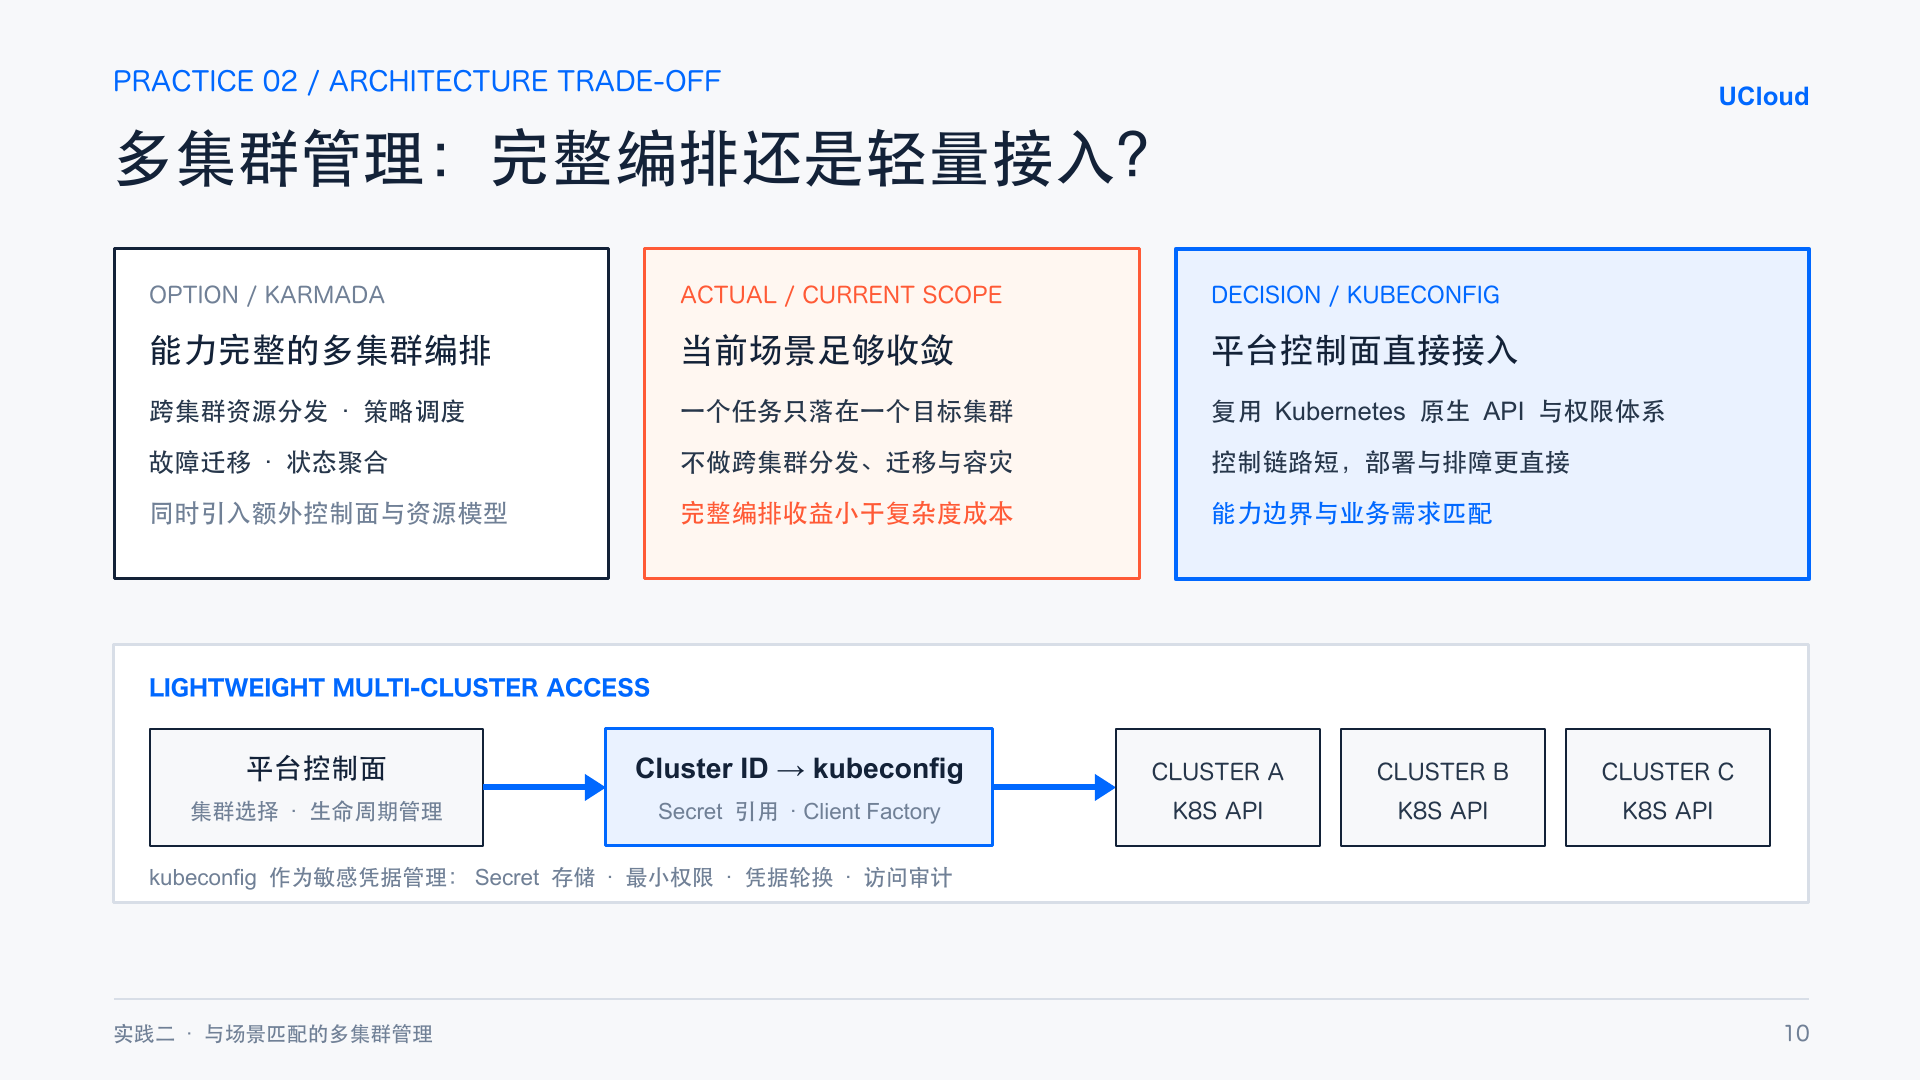
这一选择有清楚的适用范围。当业务确实需要跨集群迁移和容灾时,就需要重新评估编排方案及数据条件,不能把轻量接入当成完整多集群能力的替代品。
工具解耦与按需加载,减少环境等待
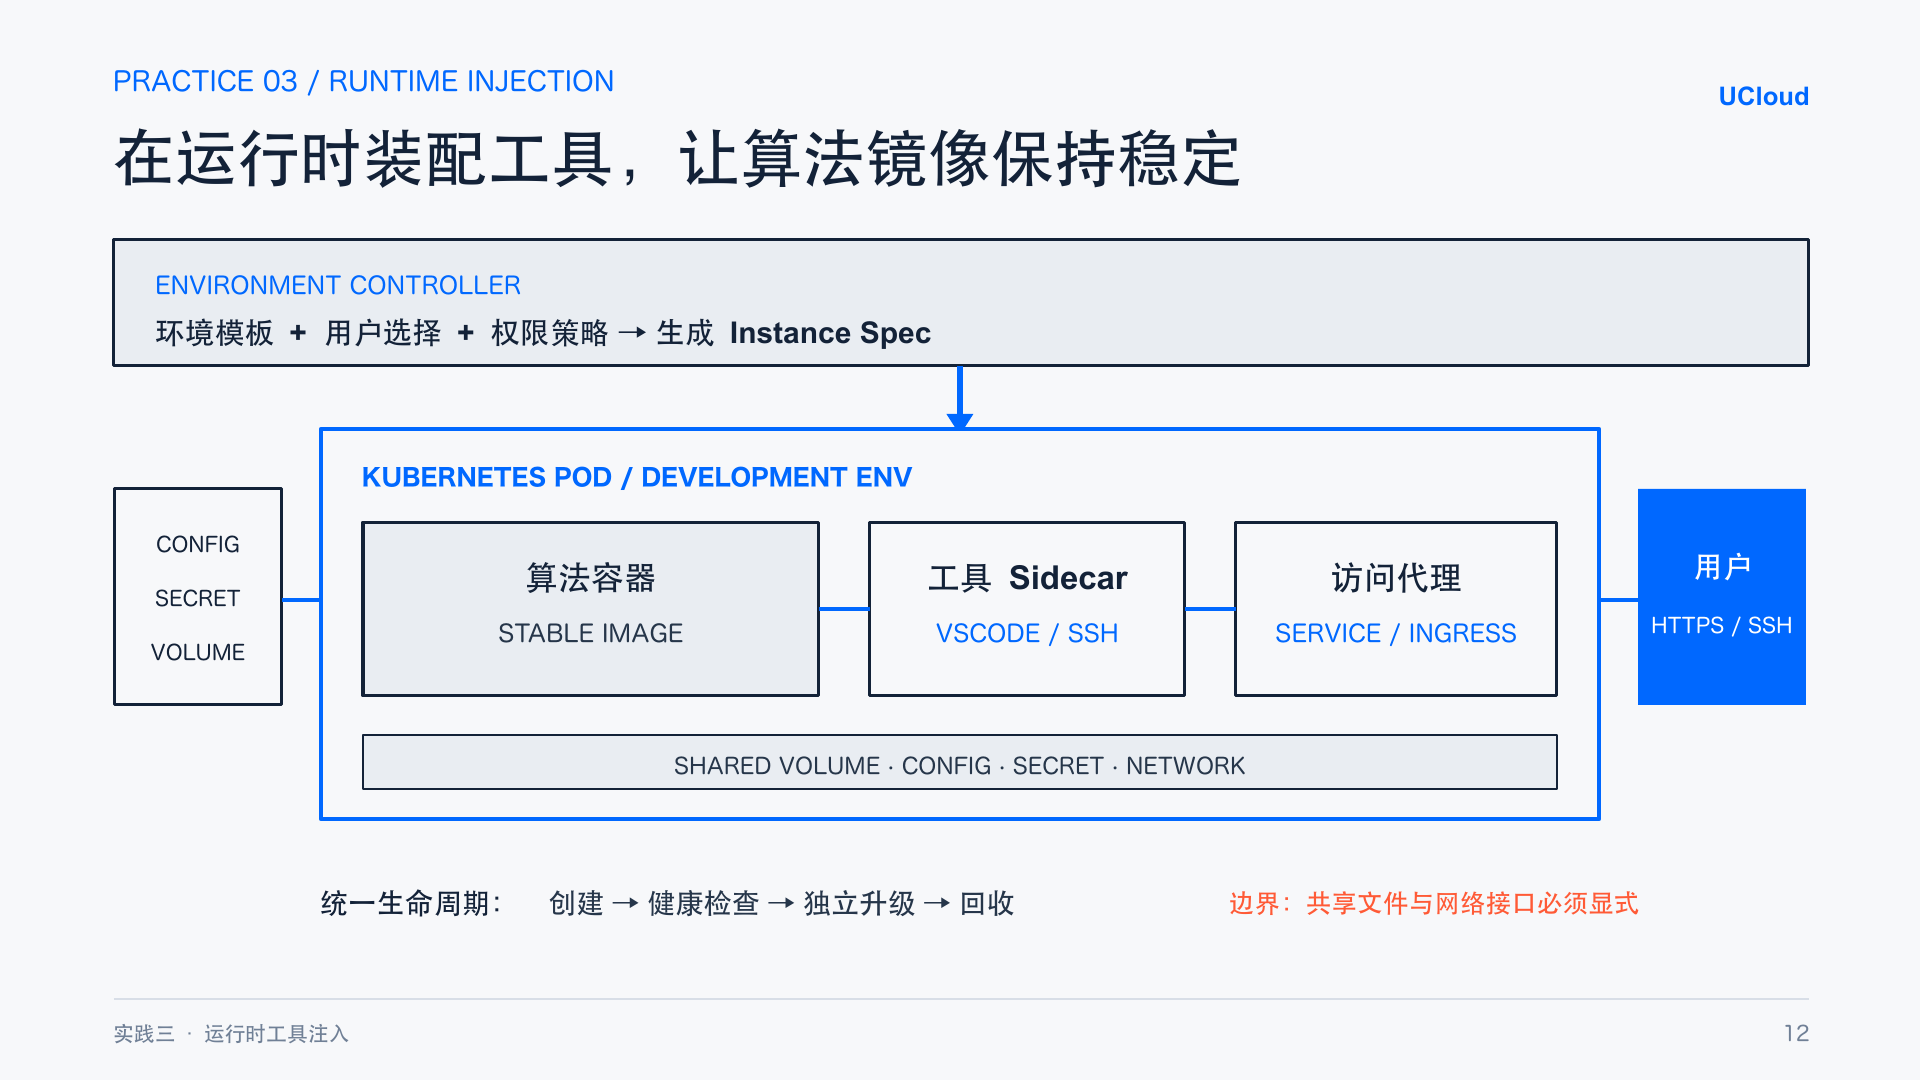
算法框架和项目依赖需要稳定,SSH、VSCode 等开发工具却可能持续更新。把它们全部打进同一个镜像,会让一次工具升级牵动镜像重建和环境验证。
团队转向在环境创建时装配工具,以 Sidecar 等方式注入开发能力,并结合规则补充配置。算法容器与平台工具可以分别维护,但共享文件、网络接口和配置边界仍需明确。
镜像本身的体积也会拖慢启动。传统流程需要完整下载并解压各层,之后才能组装文件系统。分享中的加速方案会扫描原始镜像的压缩层,生成独立文件索引。运行时先获取元数据与索引、挂载远程层,文件真正被访问时,再读取所需片段并写入本地缓存。
下载并没有消失,只是部分读取被放到了容器启动之后。如果应用一开始就需要读取大文件,等待仍然存在;没有有效索引或不适合懒加载的层,也需要回退到常规拉取。
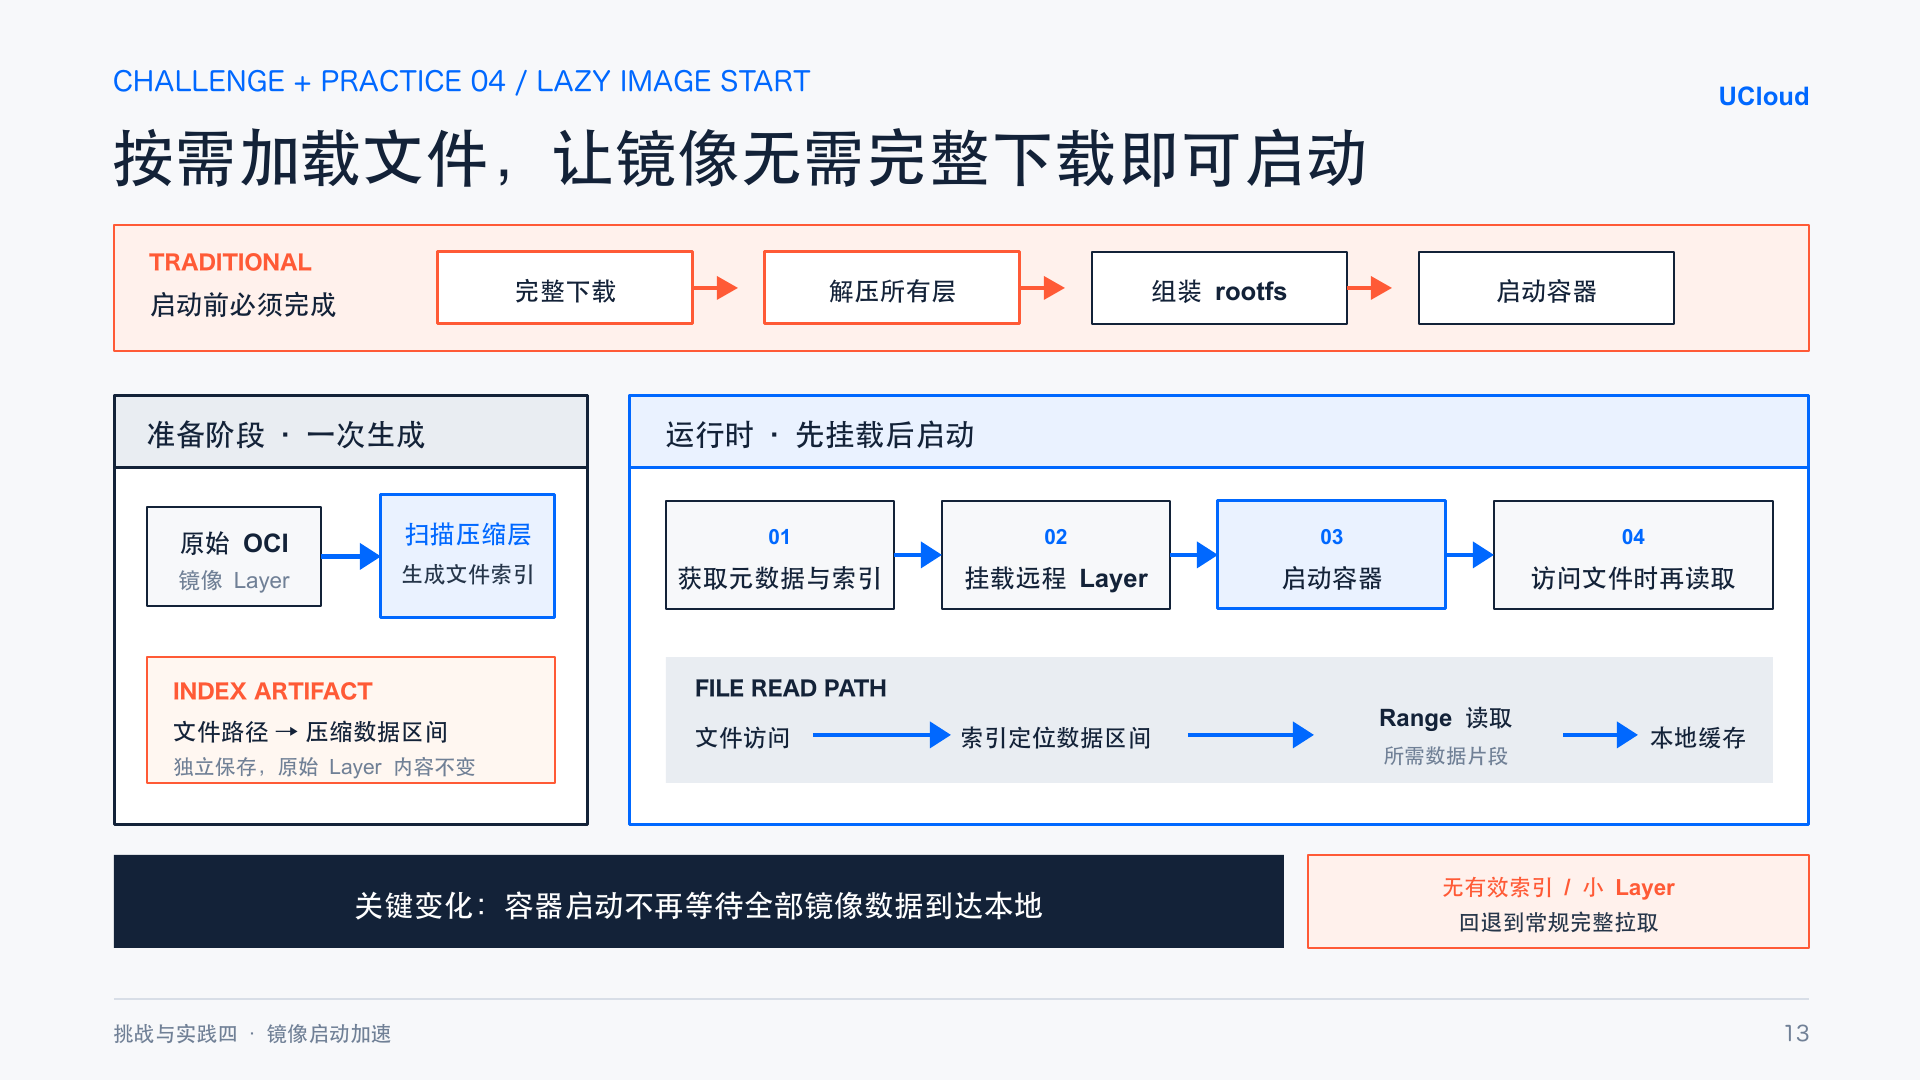
所以,评估环境是否变快,应一直观察到应用真正可用,不能只看容器是否已经启动。
私有化场景选择 HAMi,公有云另有隔离路径
彭鹏介绍,团队早期尝试过 MIG,在其设备与业务条件下遇到了切分规格不够灵活、部分硬件难以适配等问题,之后选择 HAMi 用于私有化智算场景。他还分享了在大小模型混布场景中使用 HAMi 改善 GPU 利用情况的实践。具体到部署方式,私有化智算采用 HAMi vGPU,在 Kubernetes 中实现 GPU 共享与显存、算力配额;公有云消费卡场景采用内核级 vGPU,将逻辑设备通过 VFIO 映射给 QEMU;公有云企业卡场景则涉及将整机中的不同 GPU 透传给不同虚拟机。
这里的选型逻辑很清楚:HAMi 承担私有化场景中的用户态资源共享与配额控制,适配 Kubernetes 下的资源使用方式;内核级 vGPU 和 QEMU 散卡透传,则是 UCloud 针对另外两类部署环境介绍的工程方案。三条路径面对不同的硬件与租户隔离条件,需要分别设计和验证。
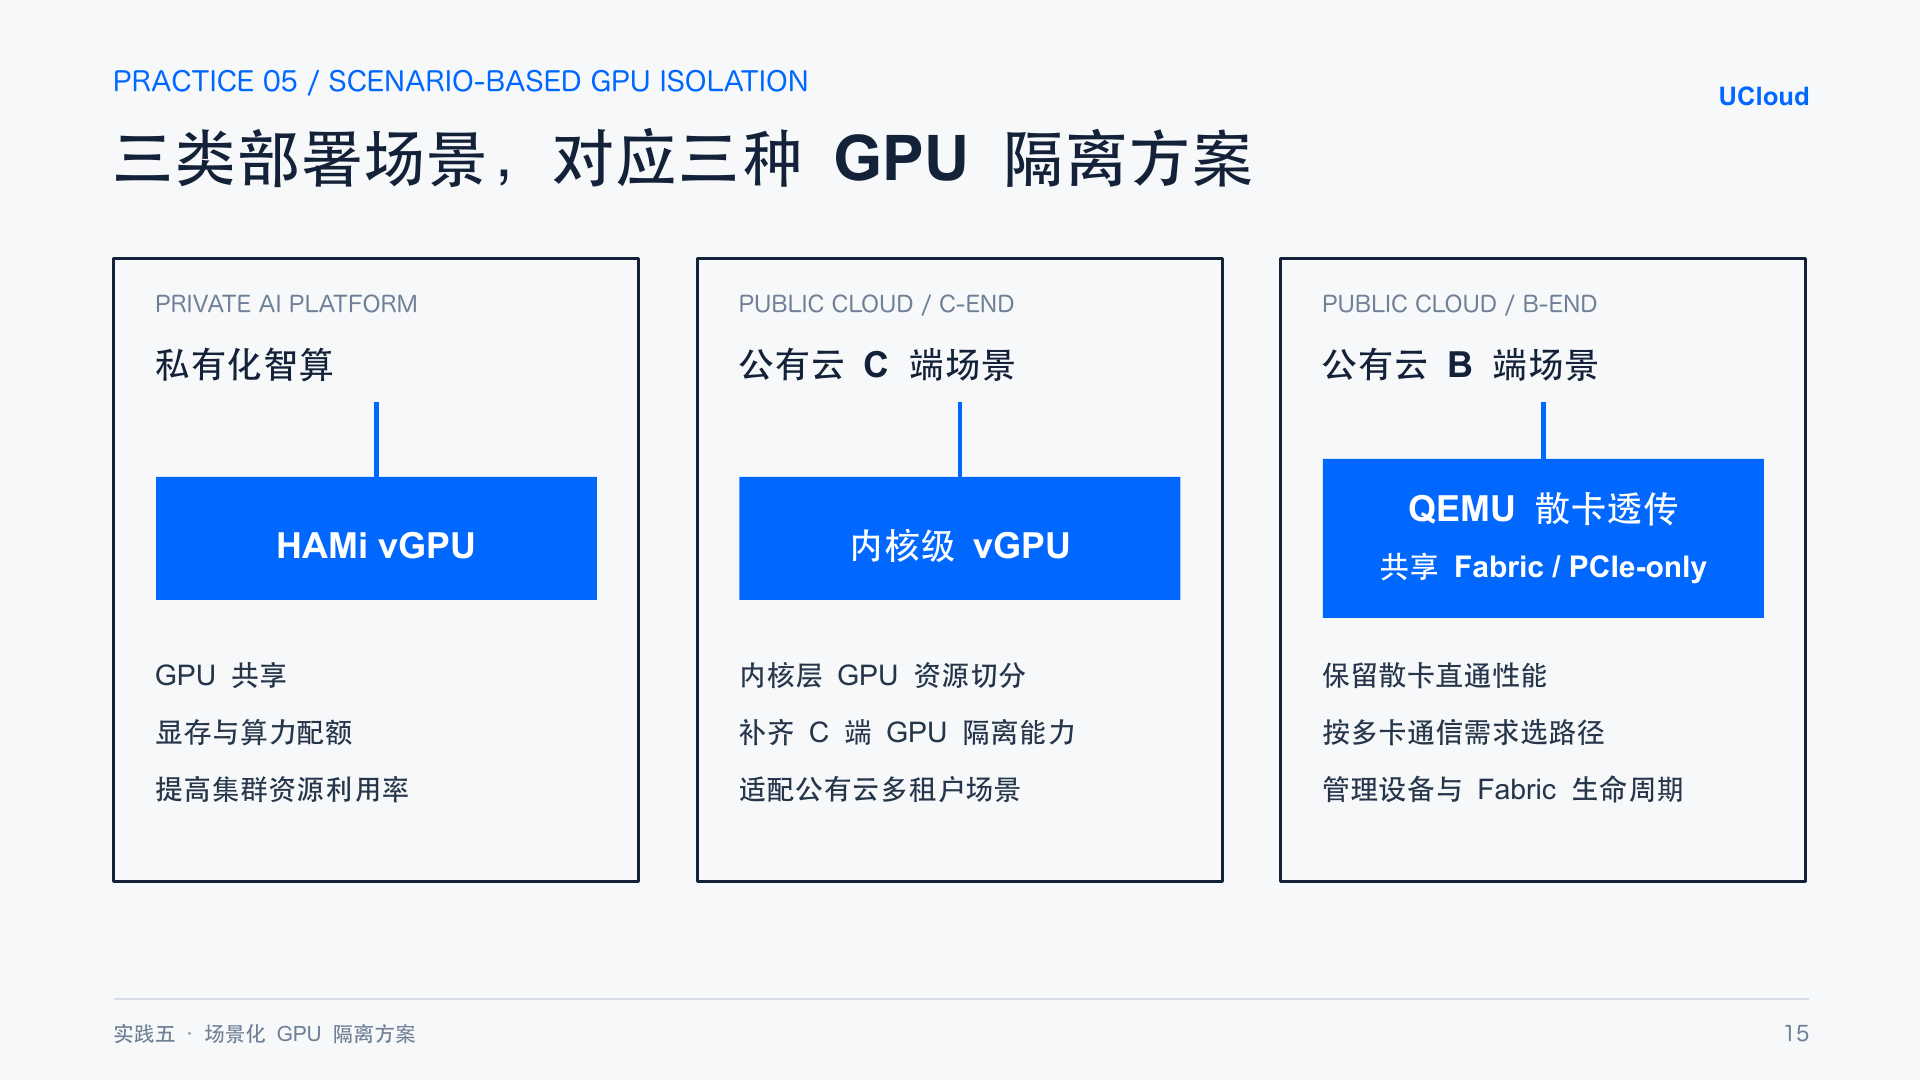
企业卡散卡透传还要考虑多卡通信。保留 NVLink 的路径,需要由可信的 Fabric 服务管理共享 NVSwitch,并与虚拟机生命周期协同;另一条路径禁用 NVLink,将 GPU 作为独立 PCIe 设备透传,工程实现更简单,但失去了对应的高速互联能力。
选择哪条路径,取决于硬件条件、部署形态、隔离要求和通信需求。能分配到 GPU,只是交付链路中的一个环节。
彭鹏也将模型权重加载、推理资源协同、空闲 CPU 复用和异构算力选择列为后续探索方向,把平台的关注点继续延伸到模型运行和资源运营。
对正在评估 HAMi 的企业,UCloud 的实践提供了清楚的检查顺序:共享规格能否进入环境创建流程,镜像与工具能否顺畅交付,运行中的配额和生命周期能否持续管理。密瓜智能重视的企业落地价值,也体现在这条完整链路中:让 HAMi 的资源共享能力与平台集成、兼容验证和运行管理协同,减少开发者从获得 GPU 到开始工作的等待。