HAMi Meetup 上海站深度解读(三):推理控制与 GPU 资源管理如何分工?llm-d 与 HAMi 的协同方向
同一个模型部署了多个副本,请求平均分过去,响应却未必更快。多轮对话能否复用缓存、实例是否已经排满队列,都会影响用户等待答案的时间。对企业 AI 平台来说,请求如何路由与 GPU 资源如何分配,是需要衔接、又不能相互替代的两层工作。
本文是 HAMi Meetup 上海站 系列深度解读的第三篇。红帽大中华区 CTO 张家驹在本场活动的分享《llm-d:打造跨负载、跨模态、跨硬件、跨平台的分布式推理平面》,提供了理解这层分工的具体架构。他介绍了 llm-d 如何协调路由、缓存与不同推理阶段,也在问答中谈到了与 HAMi 的协同方向。本文从企业平台建设的角度,梳理哪些问题由推理控制平面解决,哪些还需要资源管理能力配合。
核心亮点
- llm-d 综合缓存位置与实例负载选择端点,避免只追求缓存命中而忽略排队。
- PD 分离与缓存卸载需要连同网络、存储和搬运开销一起评估。
- HAMi 与红帽在分享中讨论了资源层协作,P/D 阶段算力划分仍需结合具体部署验证。
演讲嘉宾: 张家驹|红帽大中华区 CTO
请求数量相同,处理成本可能完全不同
传统无状态服务常用轮询方式分配请求,但大模型请求之间存在明显差异。输入长度不同,处理开销不同;多轮对话反复携带历史上下文,还会产生大量可复用的前缀。
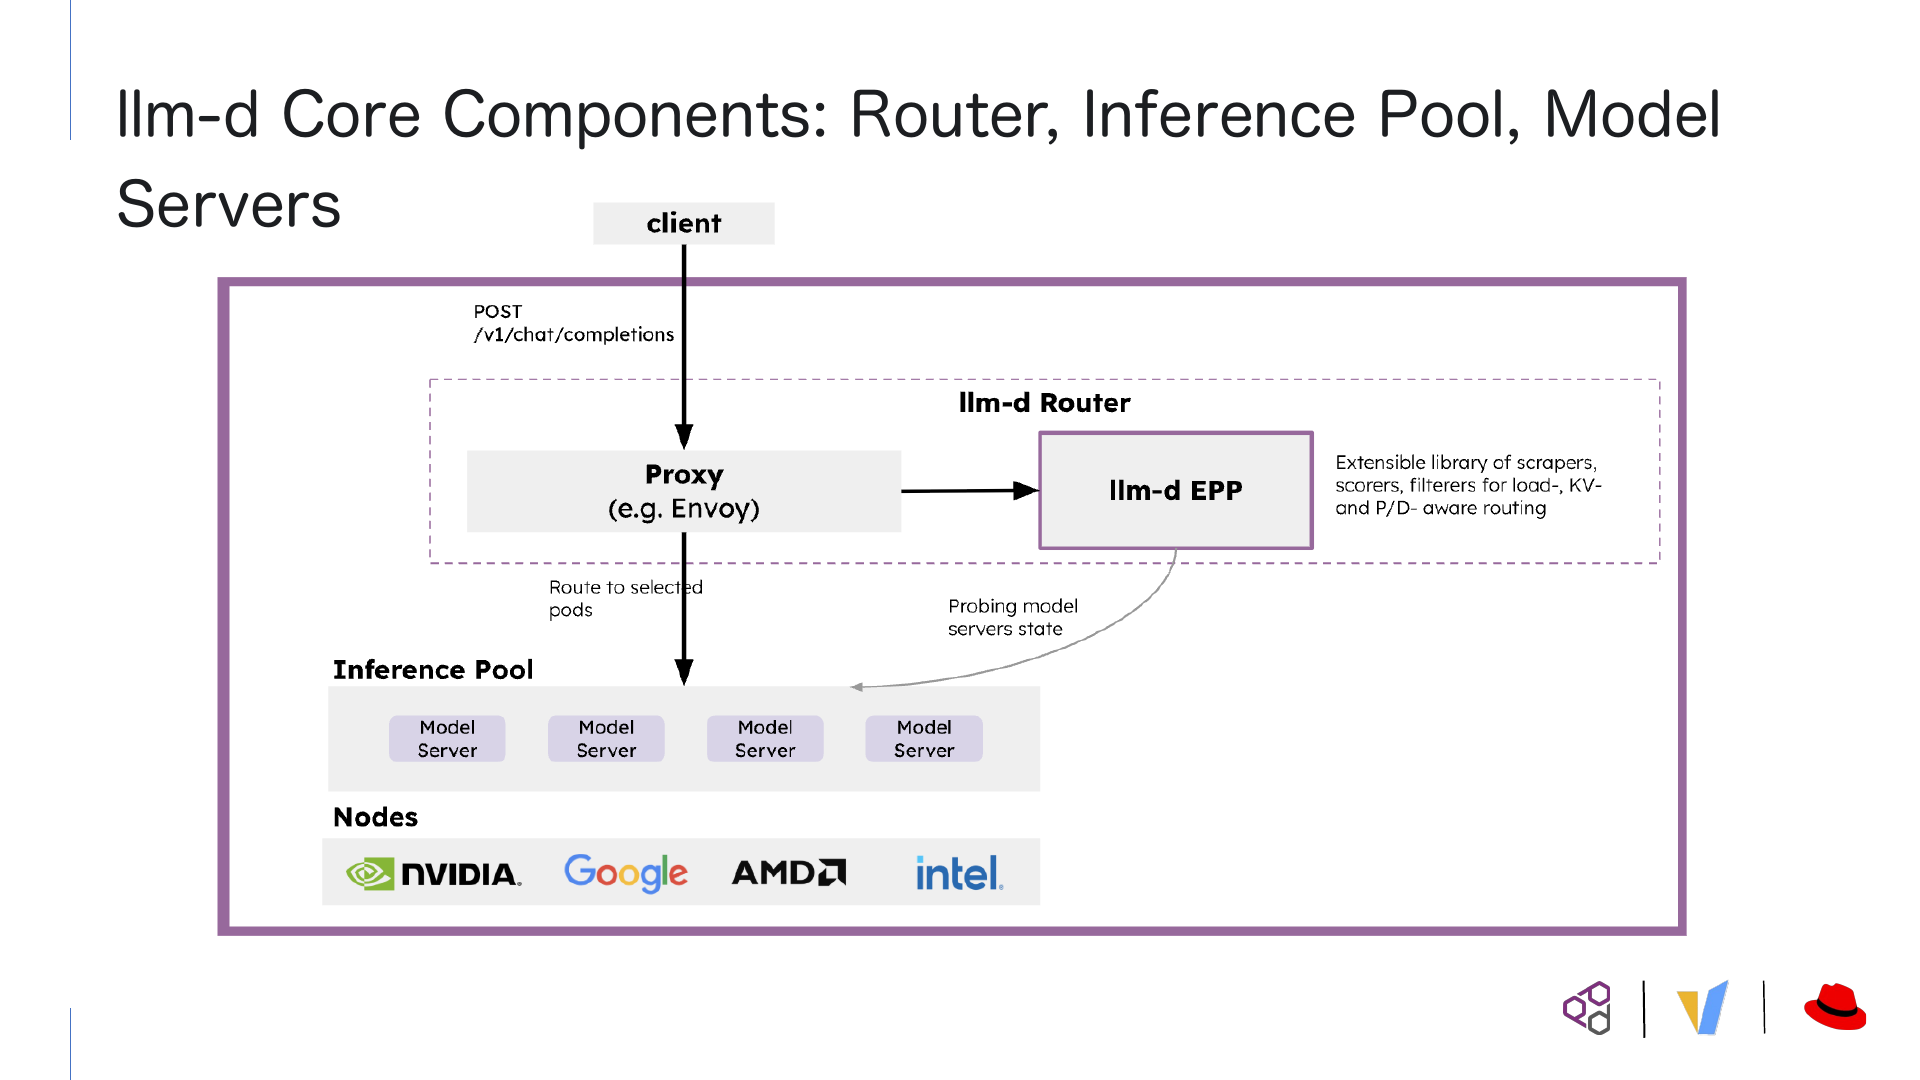
llm-d 把这些差异纳入选点过程。请求经过 Proxy,由 EPP(Endpoint Picker)结合推理实例上报的指标作出选择,再进入对应的模型服务。InferencePool 将一组可承接请求的端点组织成调度范围,底层推理引擎负责实际计算。
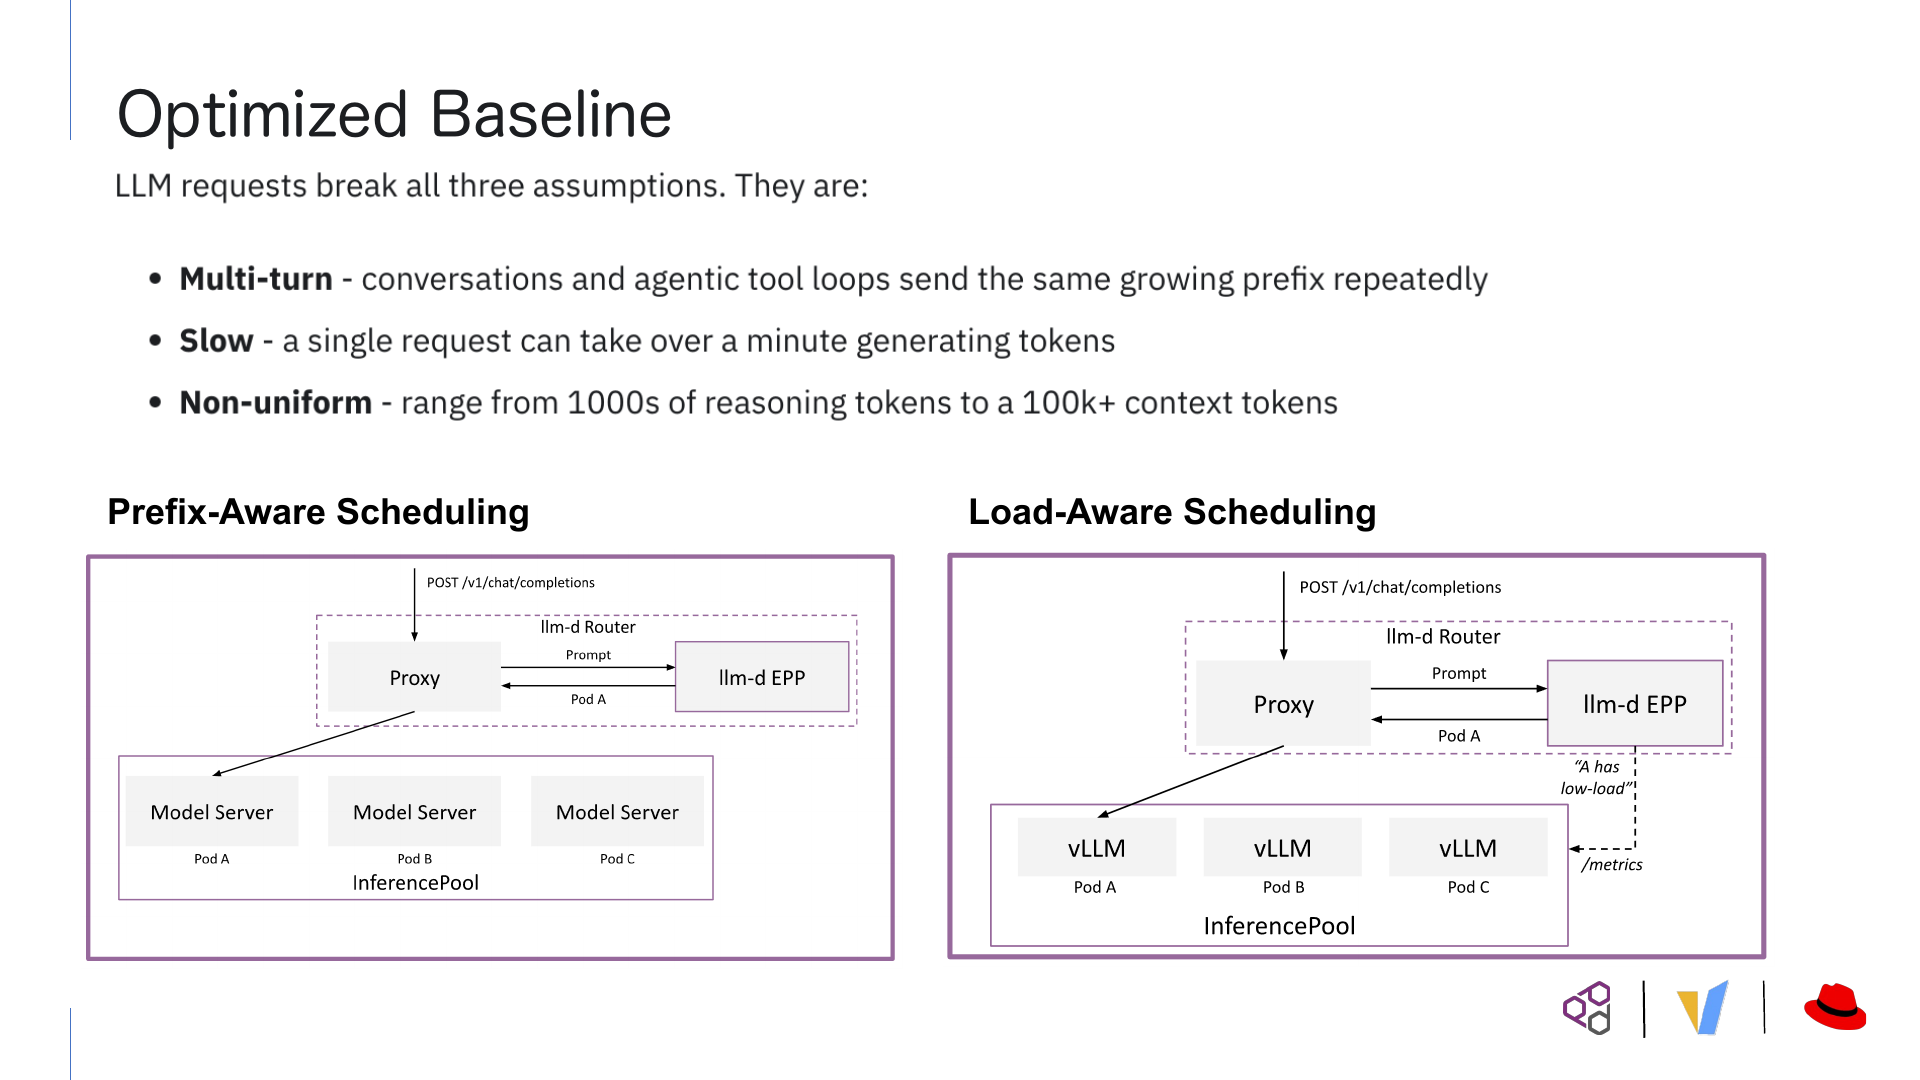
其中,前缀感知路由会考虑已有 KV Cache 的位置,把合适的请求送到能够复用缓存的实例,减少重复的预填充计算。但缓存命中并非唯一目标。如果不断把请求送向同一个实例,排队可能抵消省下的计算时间。
因此,选点需要综合缓存亲和、实时负载和实例饱和程度。张家驹还介绍了基于历史请求采样进行延迟预测的思路。企业评估这类策略时,需要同时观察缓存复用与响应延迟,不能只把命中率做高就视为完成优化。
PD 分离之后,还要解决缓存往哪里走
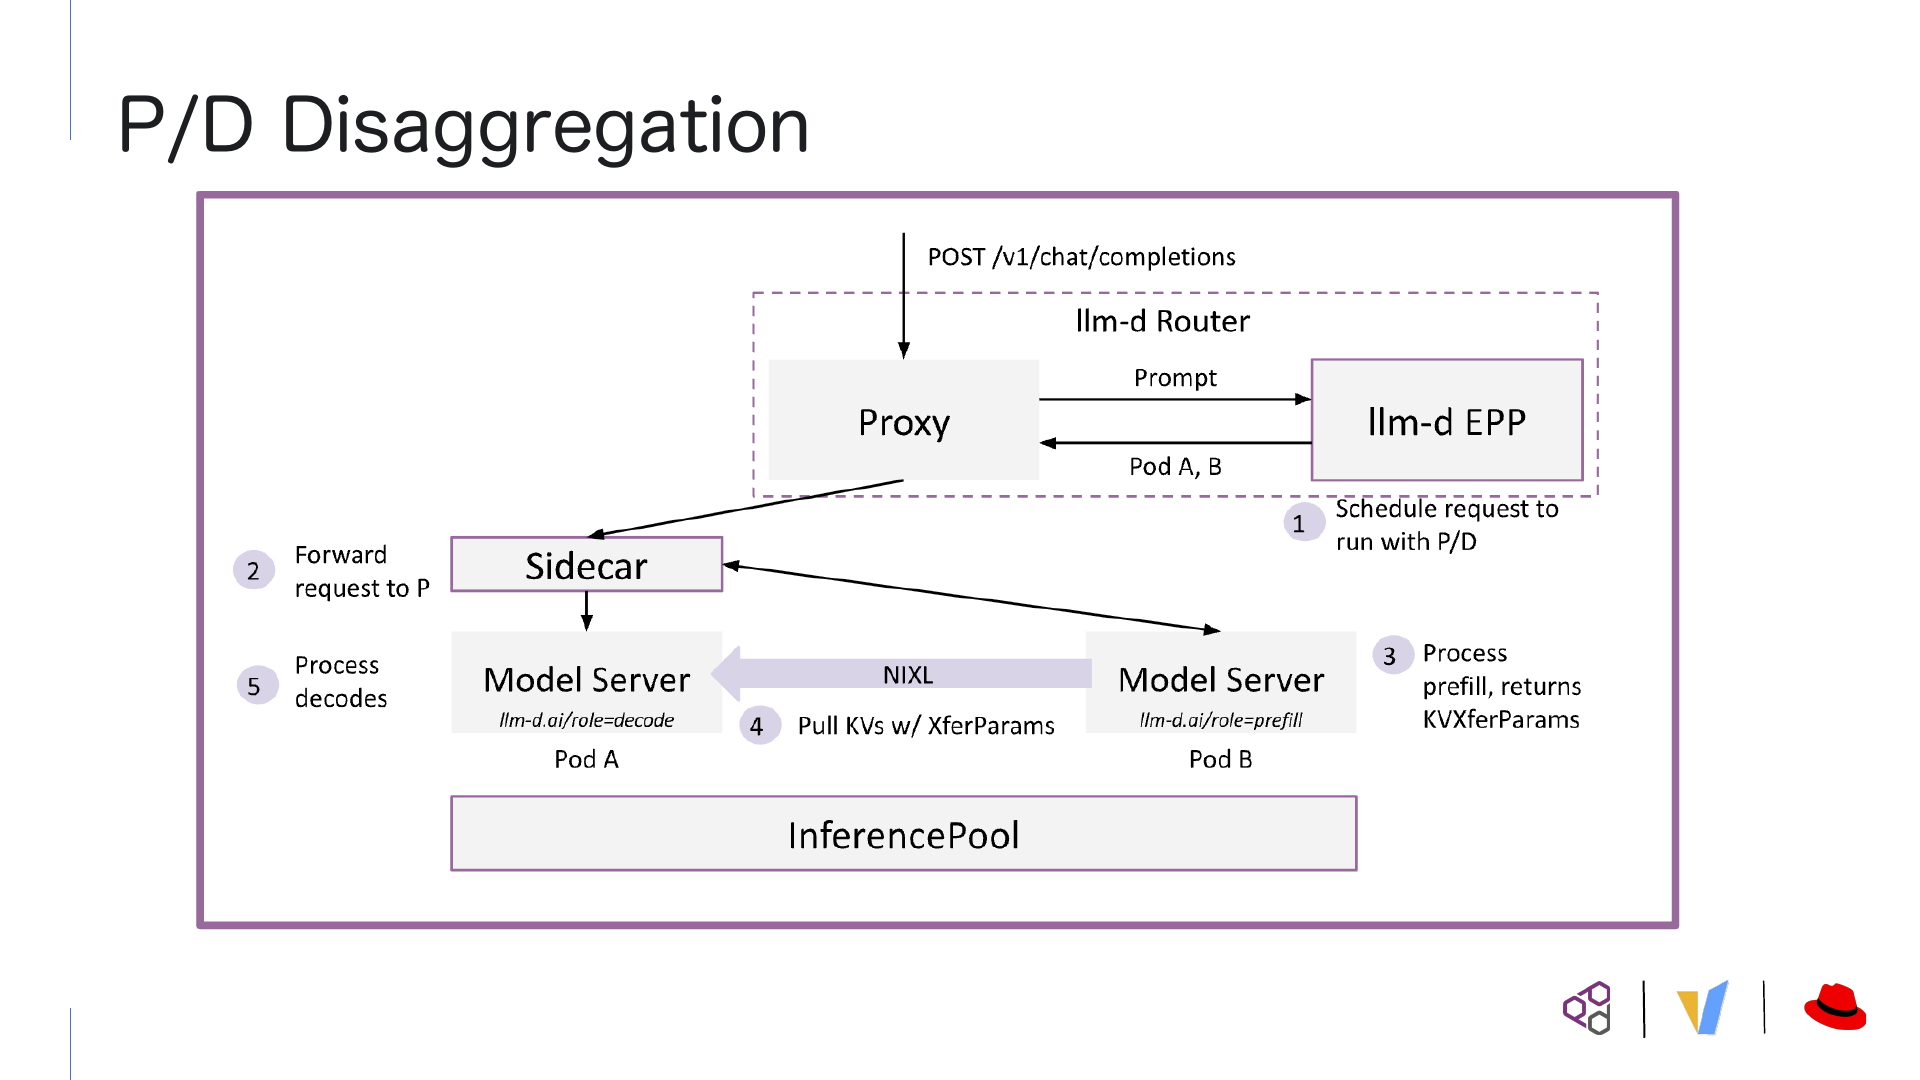
一次大模型推理包含 Prefill 和 Decode 两个阶段。Prefill 处理输入,更偏计算密集;Decode 逐步生成内容,更依赖显存带宽等条件。将两个阶段分开放置,可以为各自配置更合适的资源。
分开后,新的协同问题也随之出现。哪些实例承担 Prefill,哪些承担 Decode?前一阶段生成的 KV Cache 如何传给后一阶段?这些角色、端点和传输路径,需要与底层推理引擎及缓存组件共同组织起来。
缓存管理也不能只盯着 GPU 显存。显存有限,缓存被驱逐后,后续请求可能需要重新计算。分享介绍了将 KV Cache 卸载到内存或进一步放到存储中的路径,以及与 LMCache、Mooncake 等组件协作的方向。
这里没有脱离硬件条件的统一最优解。读取本地存储、从其他节点传输缓存、直接重算前缀,成本会随网络与存储条件变化。缓存保存得更多,并不自动等于推理更快;还要把搬运开销算进请求的完整处理过程。
控制平面管协同,推理引擎管执行
对企业平台,控制平面与推理引擎的边界需要先划清。张家驹介绍的 llm-d 架构,将路由、端点选择、缓存协调与弹性等工作放在控制平面,实际模型执行继续由 vLLM 等推理引擎承担。采用 llm-d,解决的是集群层面的推理协同问题,并不取代模型执行栈。
这种分工,也让企业能够按问题组合能力。多租户场景需要区分优先级,在线交互与批处理对延迟的要求不同;多模型服务需要判断请求适合交给哪个模型;跨节点的 MoE 推理还需要感知专家并行的分组关系。它们都是集群层面的协同问题,不能仅靠提升单个实例的执行速度解决。
负载差异还体现在 Agent 多轮交互、多模态和批处理任务上。张家驹在演讲中将它们列为不同的服务场景,其中批处理可通过较低优先级的异步处理,与在线请求共用集群。跨硬件支持则依赖推理引擎、设备适配与相应部署路径,统一控制平面不代表不同加速器可以跳过兼容验证。演讲对这些场景的展开深度不同,具体可用范围仍需按版本和环境确认。
弹性扩缩容也需要理解推理服务的状态。新副本获得设备后,还要完成模型加载等准备工作。分享介绍了 Workload Autoscaling 与 vLLM Sleep/Wake Up 相关方向,希望缩短恢复服务的等待。平台评估扩容效果时,应检查新增实例何时能实际承接请求,而非只记录 Pod 是否已创建。
推理也出现在强化学习的 rollout 阶段,需要生成大量样本。训练团队可能沿用 Slurm、Ray 或裸机环境,不能为了引入路由能力就要求整套平台迁入 Kubernetes。张家驹介绍的 EndpointDiscovery 机制,通过文件记录并更新服务端点,让非 Kubernetes 环境也有机会接入缓存感知与负载感知路由。这里扩展的是推理协同能力的使用范围,并非由 llm-d 替代训练框架。
这些方向对应不同的版本和部署条件。企业采用时,应依据具体场景验证功能组合与成熟度,不能把一份路线图理解为所有能力都已适用于现有集群。
把请求送对地方之后,还要让资源配置匹配负载
当企业同时评估 llm-d 与 HAMi 时,一个具体问题是:请求调度与 GPU 切分如何配合,PD 分离能否使用虚拟 GPU?这也是张家驹在分享问答中直接回应的问题。
张家驹在回答中明确提到,HAMi 与红帽正在推进协作,计划将 HAMi 的部分能力引入 llm-d 场景;他以 Prefill、Decode 阶段的 GPU 算力划分为例,讨论了进一步协同的方向。从平台分工看,llm-d 负责推理请求与角色之间的协调,HAMi 则提供资源共享与异构设备管理能力。企业需要分别判断请求应送给哪个实例,以及该实例应该获得什么设备、多少资源。
这里讨论的是分享时的协作方向,并非已经完成的通用部署方案。具体硬件、模型和资源切分配置仍需验证,不能据此推导为任意虚拟 GPU 都能承载 PD 分离。海外最佳实践使用的硬件也可能与国内集群不同,参数需要在实际环境重新测试。
密瓜智能关注的企业落地问题,是让资源配置与推理服务要求共同进入验证过程。评估 llm-d 与 HAMi 的协同,应使用同一组业务负载,分别检查资源分配、请求排队、缓存复用和通信开销,再看整体响应是否满足目标。这样才能区分资源不足与请求调度不当,明确下一步该优化哪一层。
视频回放及 PPT 下载
- B 站回放: 主题演讲 | llm-d:打造跨负载、跨模态、跨硬件、跨平台的分布式推理平面 —— 张家驹
- 下载 PPT: llm-d-distributed-inference-plane-zhangjiaju.pdf