HAMi Meetup 上海站深度解读(四):GPU 性能如何变成推理服务能力?从天数智芯实践看平台分工
GPU 的计算性能不错,用户却仍在等待首个 Token,或在生成过程中感到卡顿。企业部署大模型时,这类问题不一定出在芯片本身。资源放在哪里、请求如何路由、缓存如何传输、新副本何时真正可用,都可能影响最终体验。
本文是 HAMi Meetup 上海站 系列深度解读的第四篇。天数智芯 Infra 研发总监 叶成林在本场活动分享的《天数智芯 GPU 上的高性能推理部署实践》,展示了执行优化、拓扑调度与推理编排之间的分工,也介绍了小模型场景使用 HAMi 共享 GPU 的路径。对企业平台,借鉴这套实践的重点,是按负载选择资源形态,再用端到端指标检查各层能力是否真正配合起来。
核心亮点
- 验收推理服务要看首 Token、生成间隔和尾部请求表现,不能只看单卡性能。
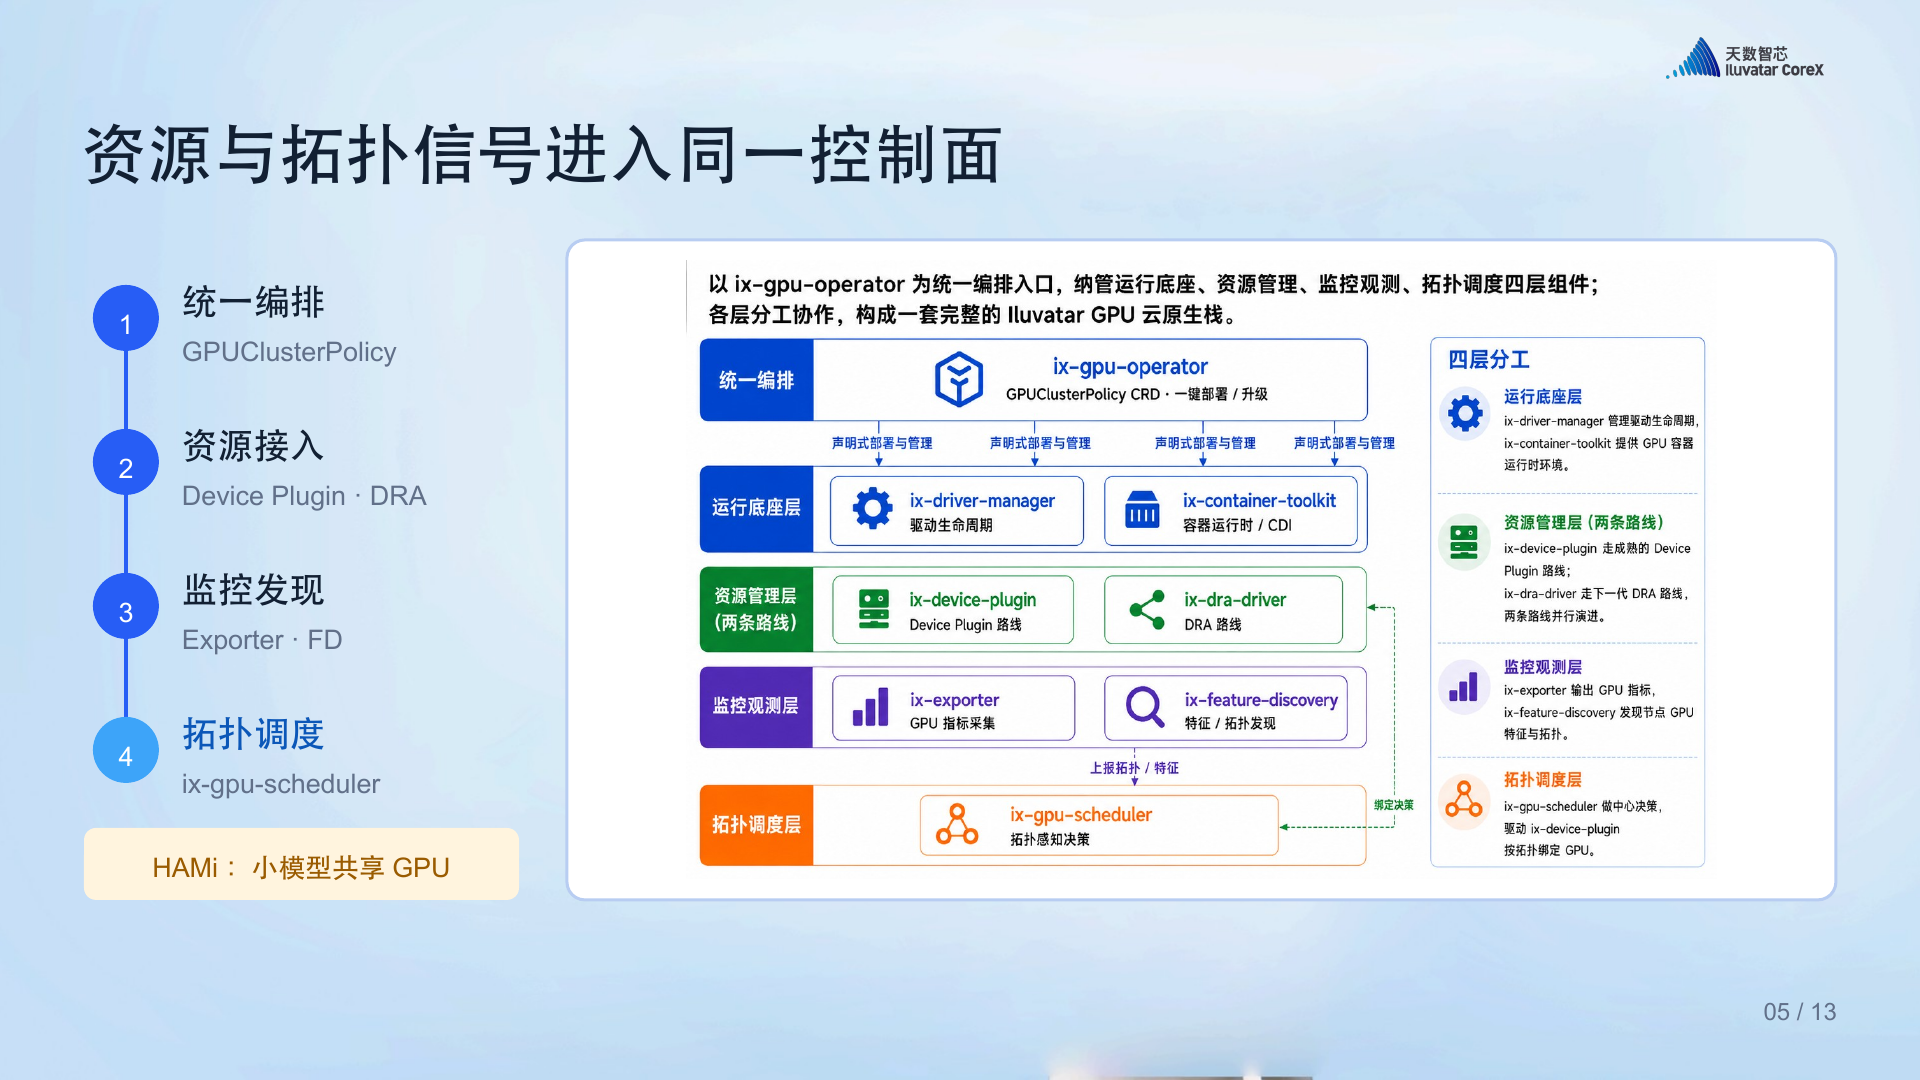
- 资源放置、请求路由和执行通信各有分工;HAMi 用于其中按需采用的小模型 GPU 共享分支。
- PD 分离要用收益覆盖缓存搬运等新增成本,新副本就绪则以可提供合格服务为准。
演讲嘉宾: 叶成林|天数智芯 Infra 研发总监
兼容接口是入口,端到端 SLO 才是验收标准
叶成林介绍的技术路线,是在上层兼容 OpenAI API、vLLM 等主流生态,在底层通过天数智芯自研的 IxFormer、IXInfer、ixDNN、ixBLAS 及 IXCCL 等执行与通信组件优化性能。
上层兼容帮助应用沿用熟悉的接入方式,底层优化则针对实际 GPU 的计算与通信特点。两部分需要共同落到用户可以感知的指标上。
分享重点关注首 Token 延迟 TTFT、逐 Token 生成间隔 TPOT,尤其是它们的 P99 表现,以及集群吞吐和有效 Token 产出。平均速度之外,尾部请求是否仍能满足要求,同样是服务验收的一部分。
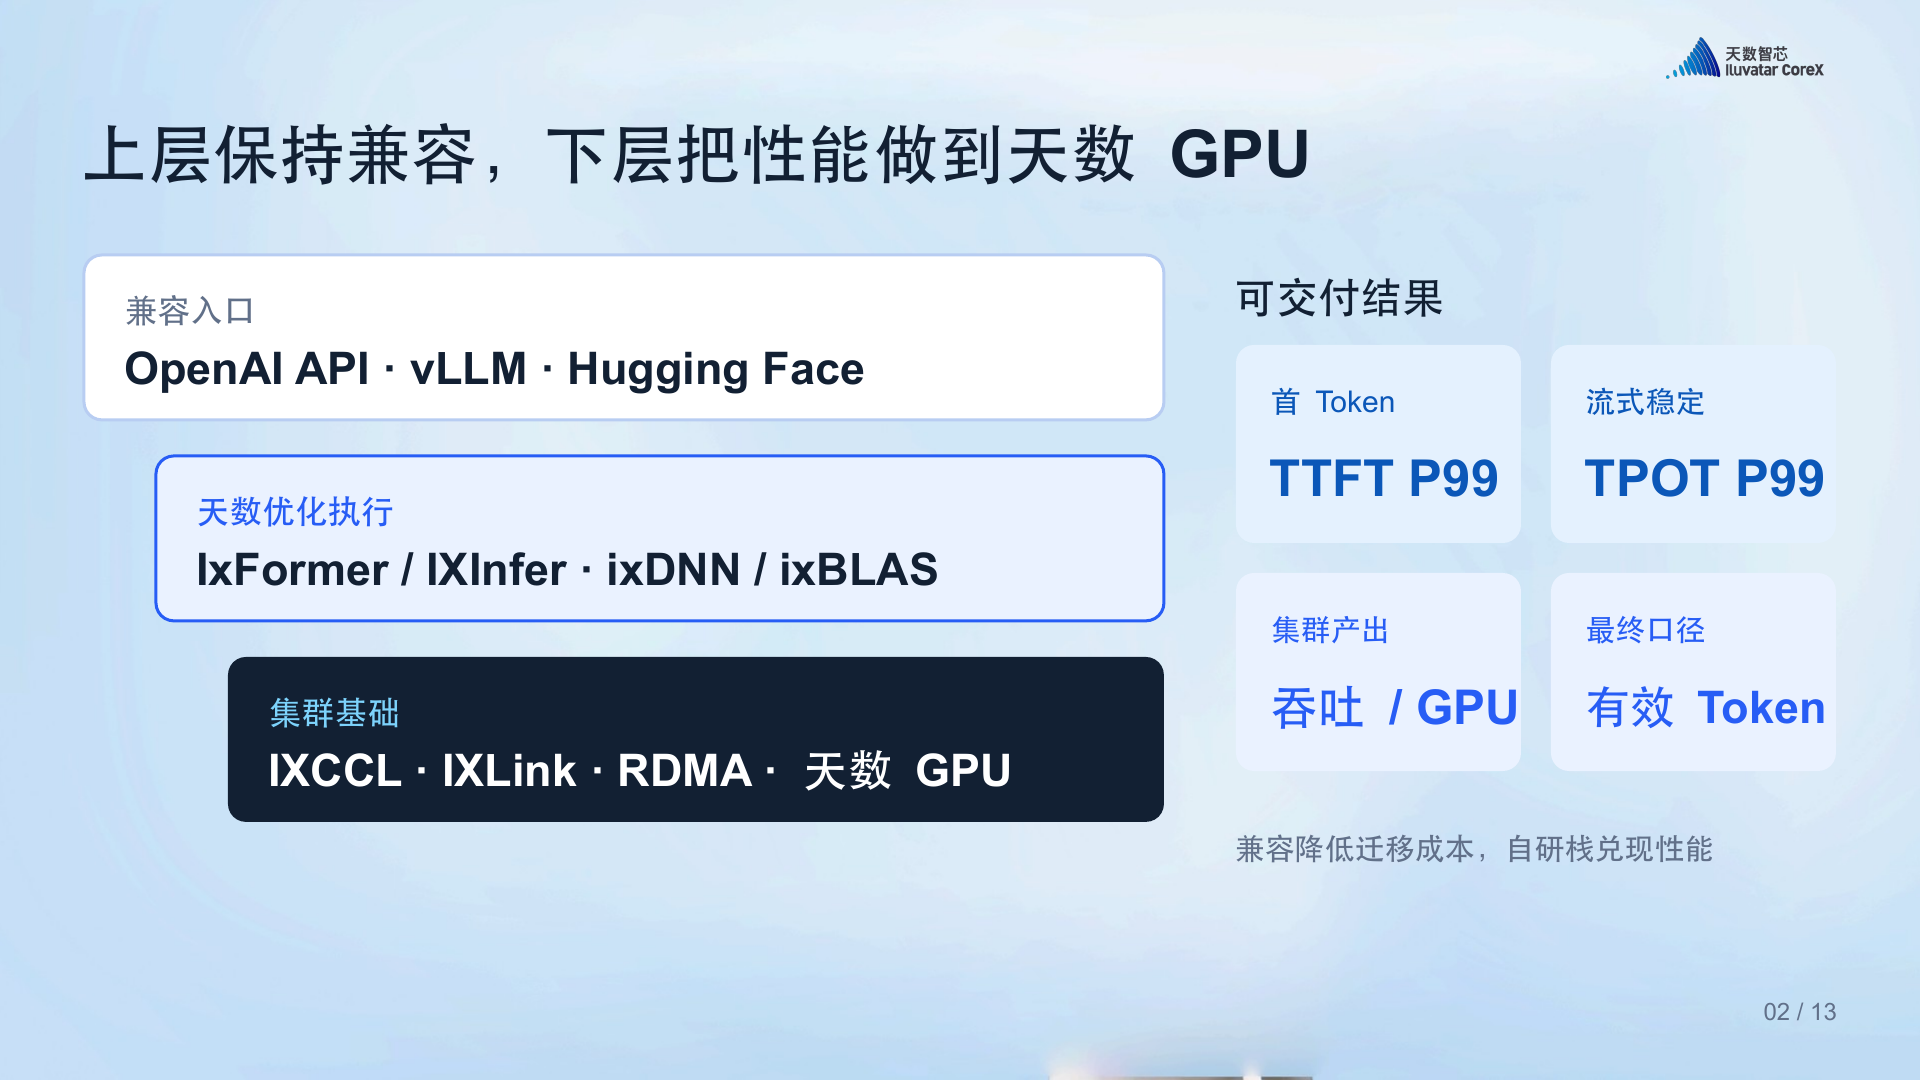
因此,评估国产 GPU 推理方案,需要沿着应用请求一路看到最终输出。单个算子跑得快、模型能够启动,分别证明了局部能力;用户需要的是整条服务链路都能守住 SLO,也就是服务等级目标。
资源放置、请求路由与小模型共享,各自解决什么问题
集群里有空闲 GPU,并不代表它们适合任意组合。Prefill 与 Decode 分开放置后,GPU 与网卡的连接关系、PCIe 和 NUMA 拓扑、跨节点通信路径,都会影响缓存搬运和整体延迟。
分享中的控制面把资源信息、监控指标与拓扑发现结果组织起来,由 ix-gpu-scheduler 进行拓扑感知的放置决策,并结合 Volcano 使用。目标是为推理实例选择合适的 GPU 与 RDMA 资源,减少不必要的跨设备、跨节点传输。
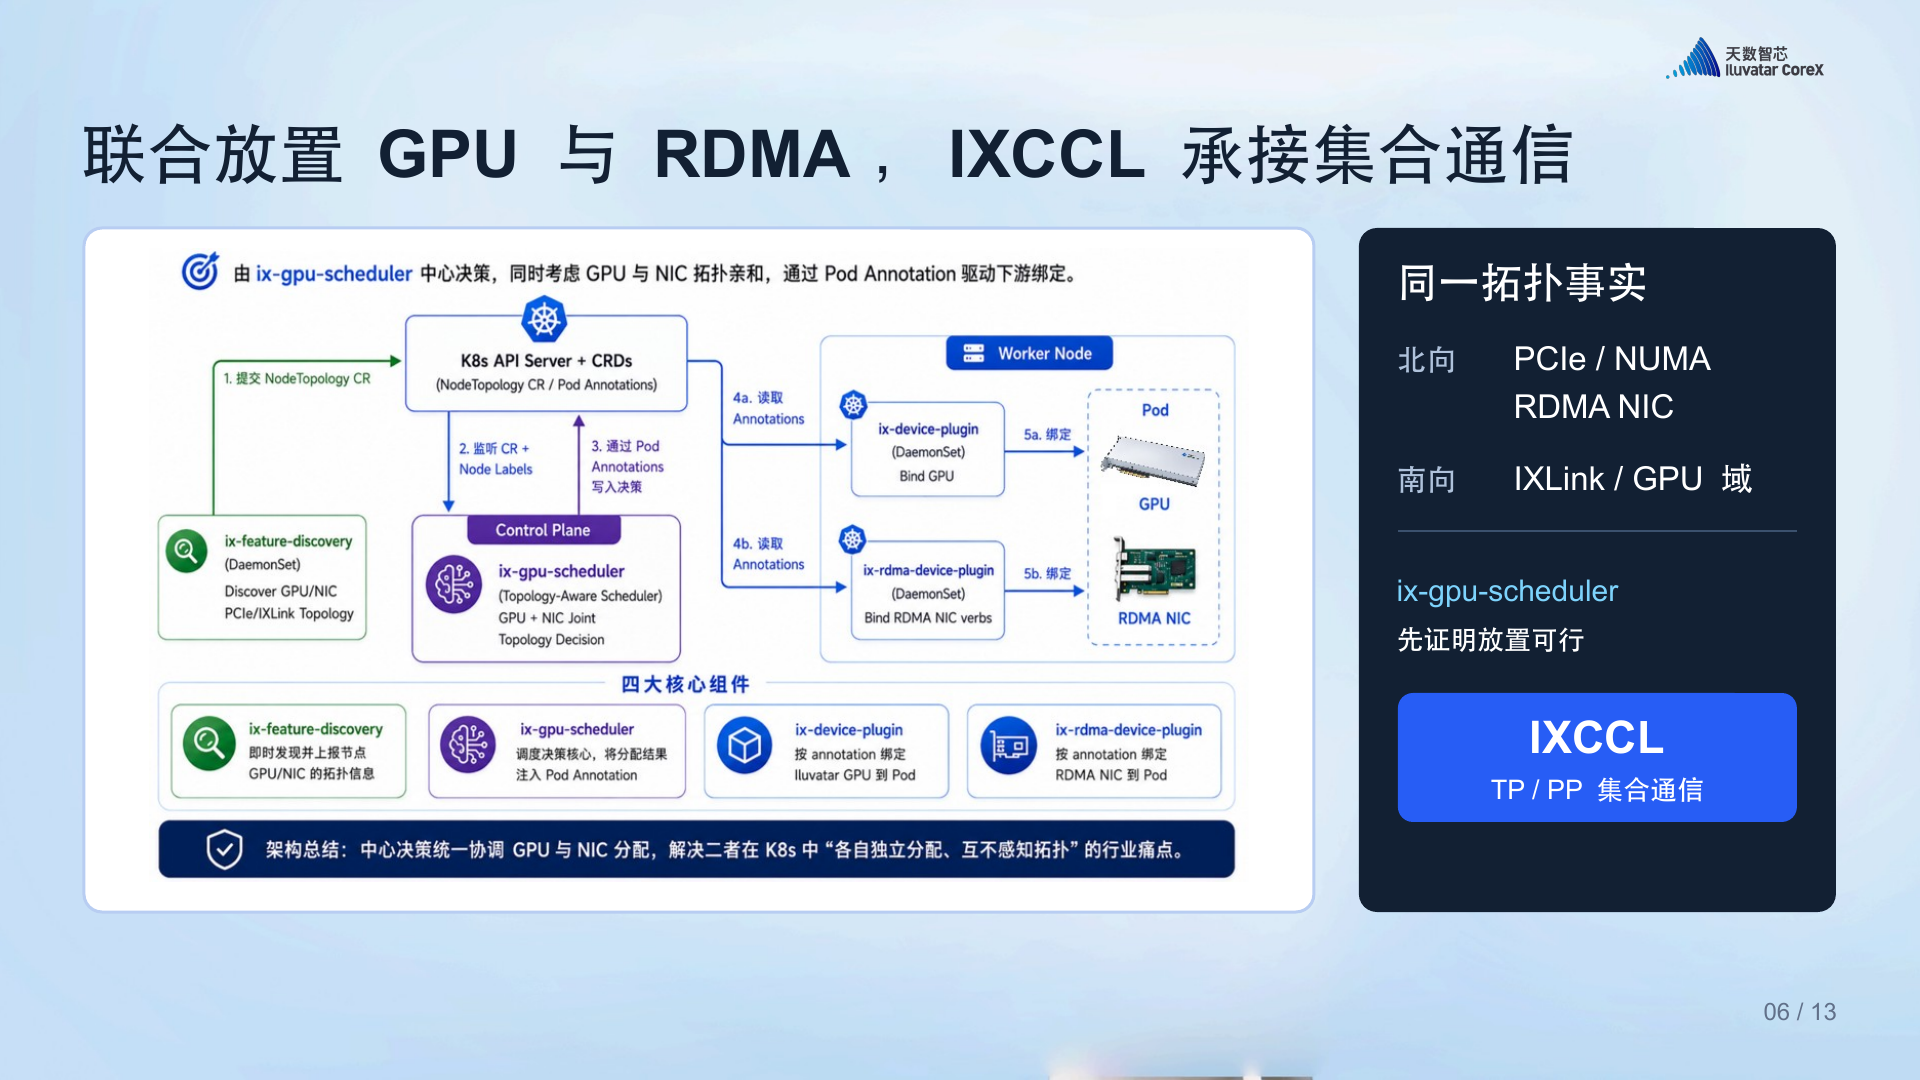
请求进入服务后,再由 llm-d 的 Proxy 与 EPP 综合 KV Cache 亲和性和实时负载选择端点;模型计算及池内并行通信则交给天数执行栈与 IXCCL。
这两层调度不能混在一起理解。资源放置解决实例部署在哪组设备上,请求路由解决当前请求交给哪个实例。即使路由策略合理,如果底层拓扑不合适,通信成本仍会影响结果。
HAMi 在这套实践中有清楚的位置。叶成林介绍,团队在小模型需要共享 GPU 时使用 HAMi,对应架构也将它列为按需分支。HAMi 处理小模型的资源共享需求,llm-d 负责请求选点与推理阶段协同,天数智芯自研执行栈和 IXCCL 则负责计算与通信。企业按负载组合这些能力时,需要分别验证共享配置、推理编排与底层执行的效果。
PD 分离是否值得,要把新增成本一起算进去
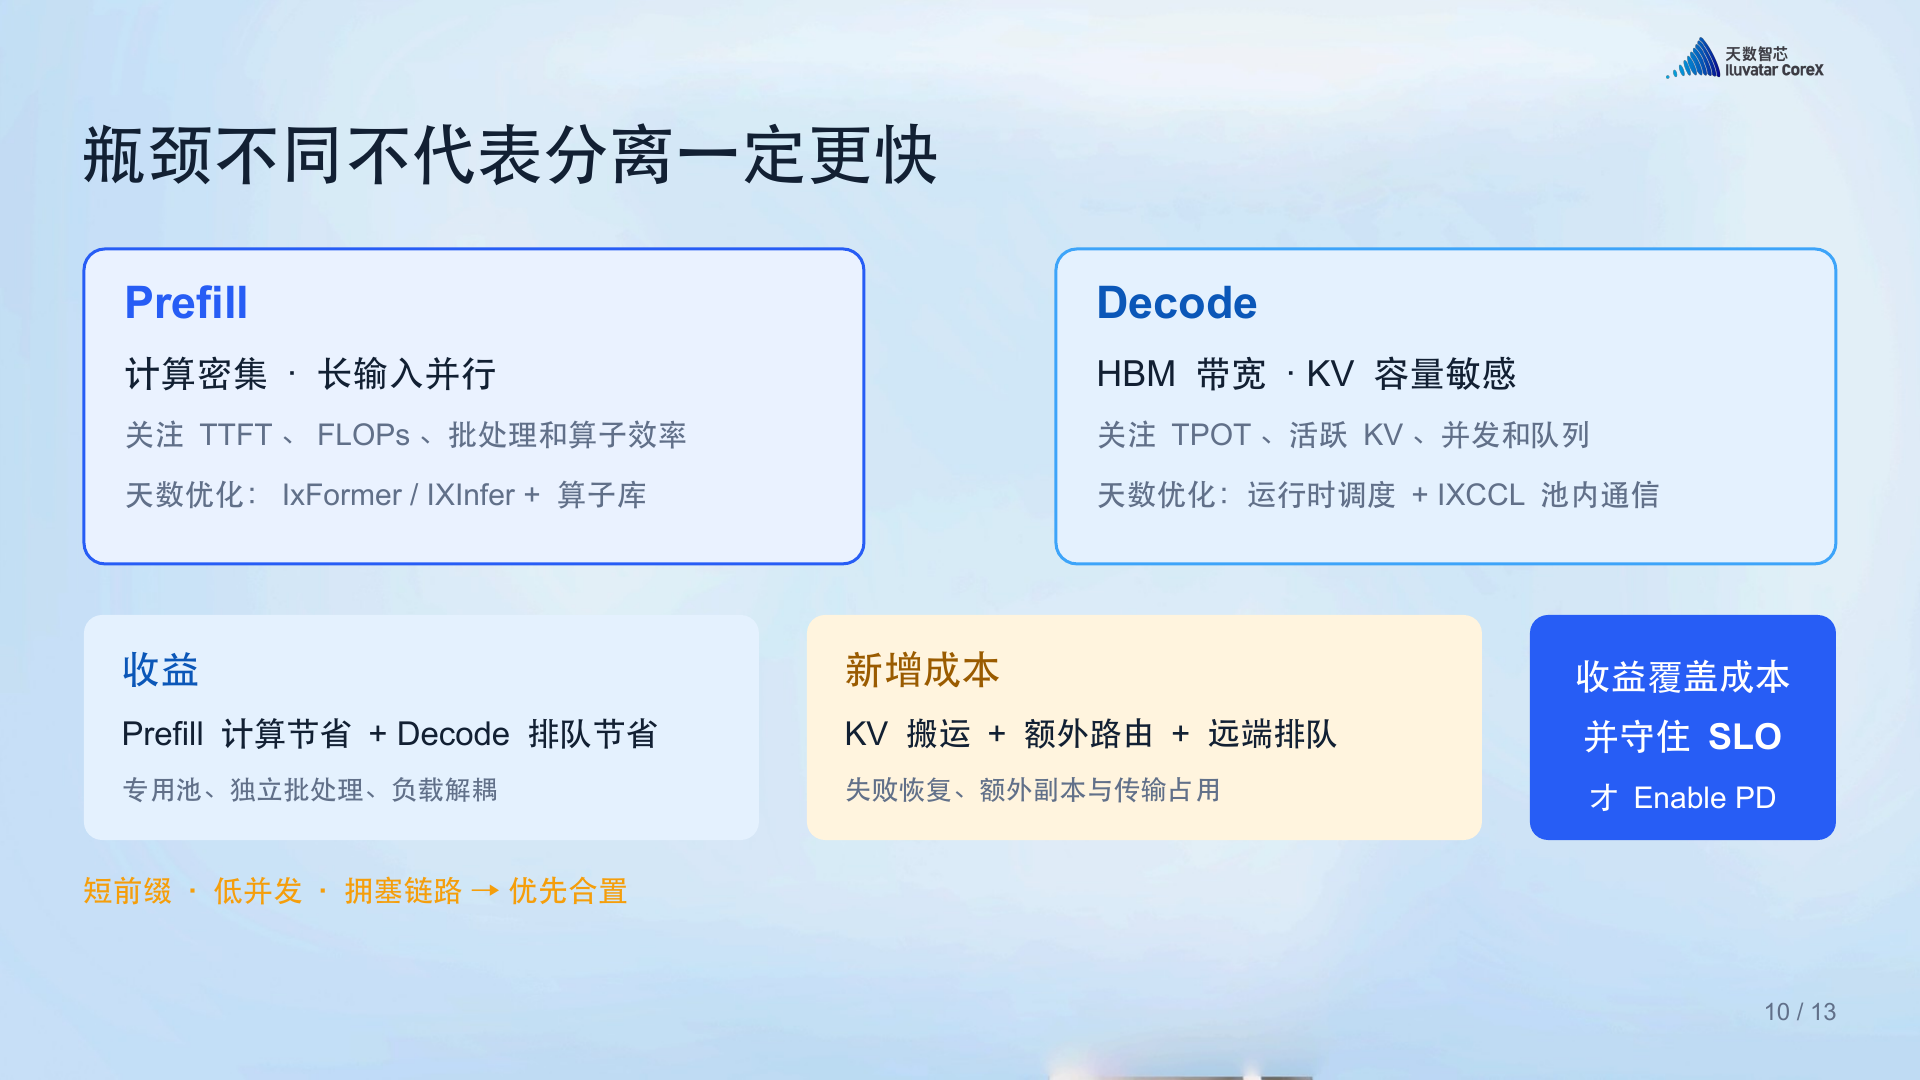
Prefill 更偏计算密集,Decode 对显存带宽、KV 容量和并发队列更敏感。分成专用资源池后,两阶段可以分别安排批处理与资源配置,减少相互干扰。
但叶成林强调,瓶颈不同,不代表分离一定更快。PD 分离还会增加 KV Cache 搬运、额外路由、远端排队和故障恢复等成本。只有收益覆盖新增开销,并且仍然满足 SLO,分离才有价值。
分享给出了明确边界:短前缀、低并发或链路拥塞的场景,应优先考虑合置。对于适合分离的负载,P、D 实例的配比也没有通用答案。现场问答中,叶成林介绍,团队会在上线前通过压测寻找配比,实际部署再结合拓扑条件调整;线上扩容策略仍在探索。
缓存亲和也需要类似的取舍。一个实例缓存命中率高,不代表所有请求都该继续送过去。队列过深时,需要结合队列与缓存命中的权重重新选点。这是分享中提出的调优思路,并非已经完成大规模验证的统一参数方案。
扩容完成,要以首个合格 Token 为准
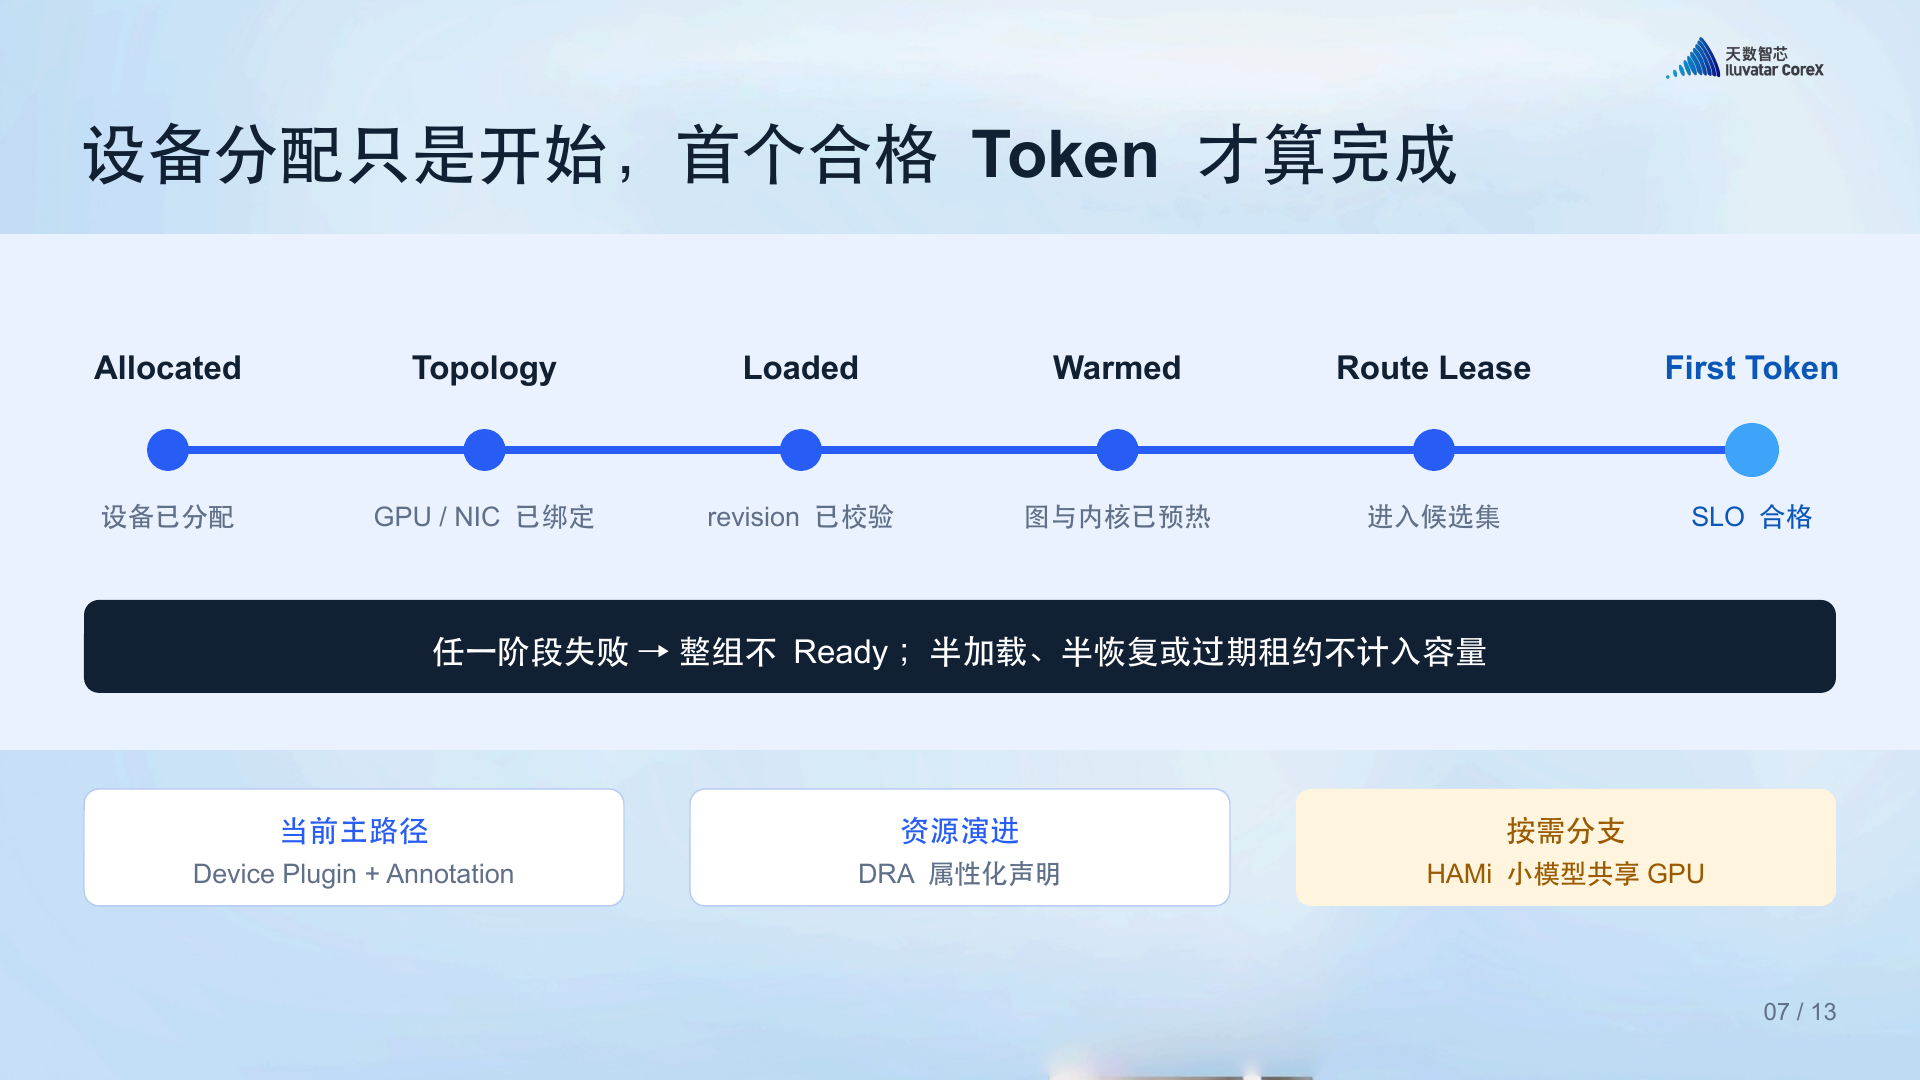
设备分配成功之后,新副本还要经历模型加载、内核与图预热、路由就绪等步骤。容器已经运行,并不等于业务容量已经增加。
分享将这条链路从设备分配、拓扑绑定,一直延伸到首个满足 SLO 的 Token。半加载或半恢复的实例不应计入可用容量,否则扩容看起来成功,实际请求仍可能等待或失败。
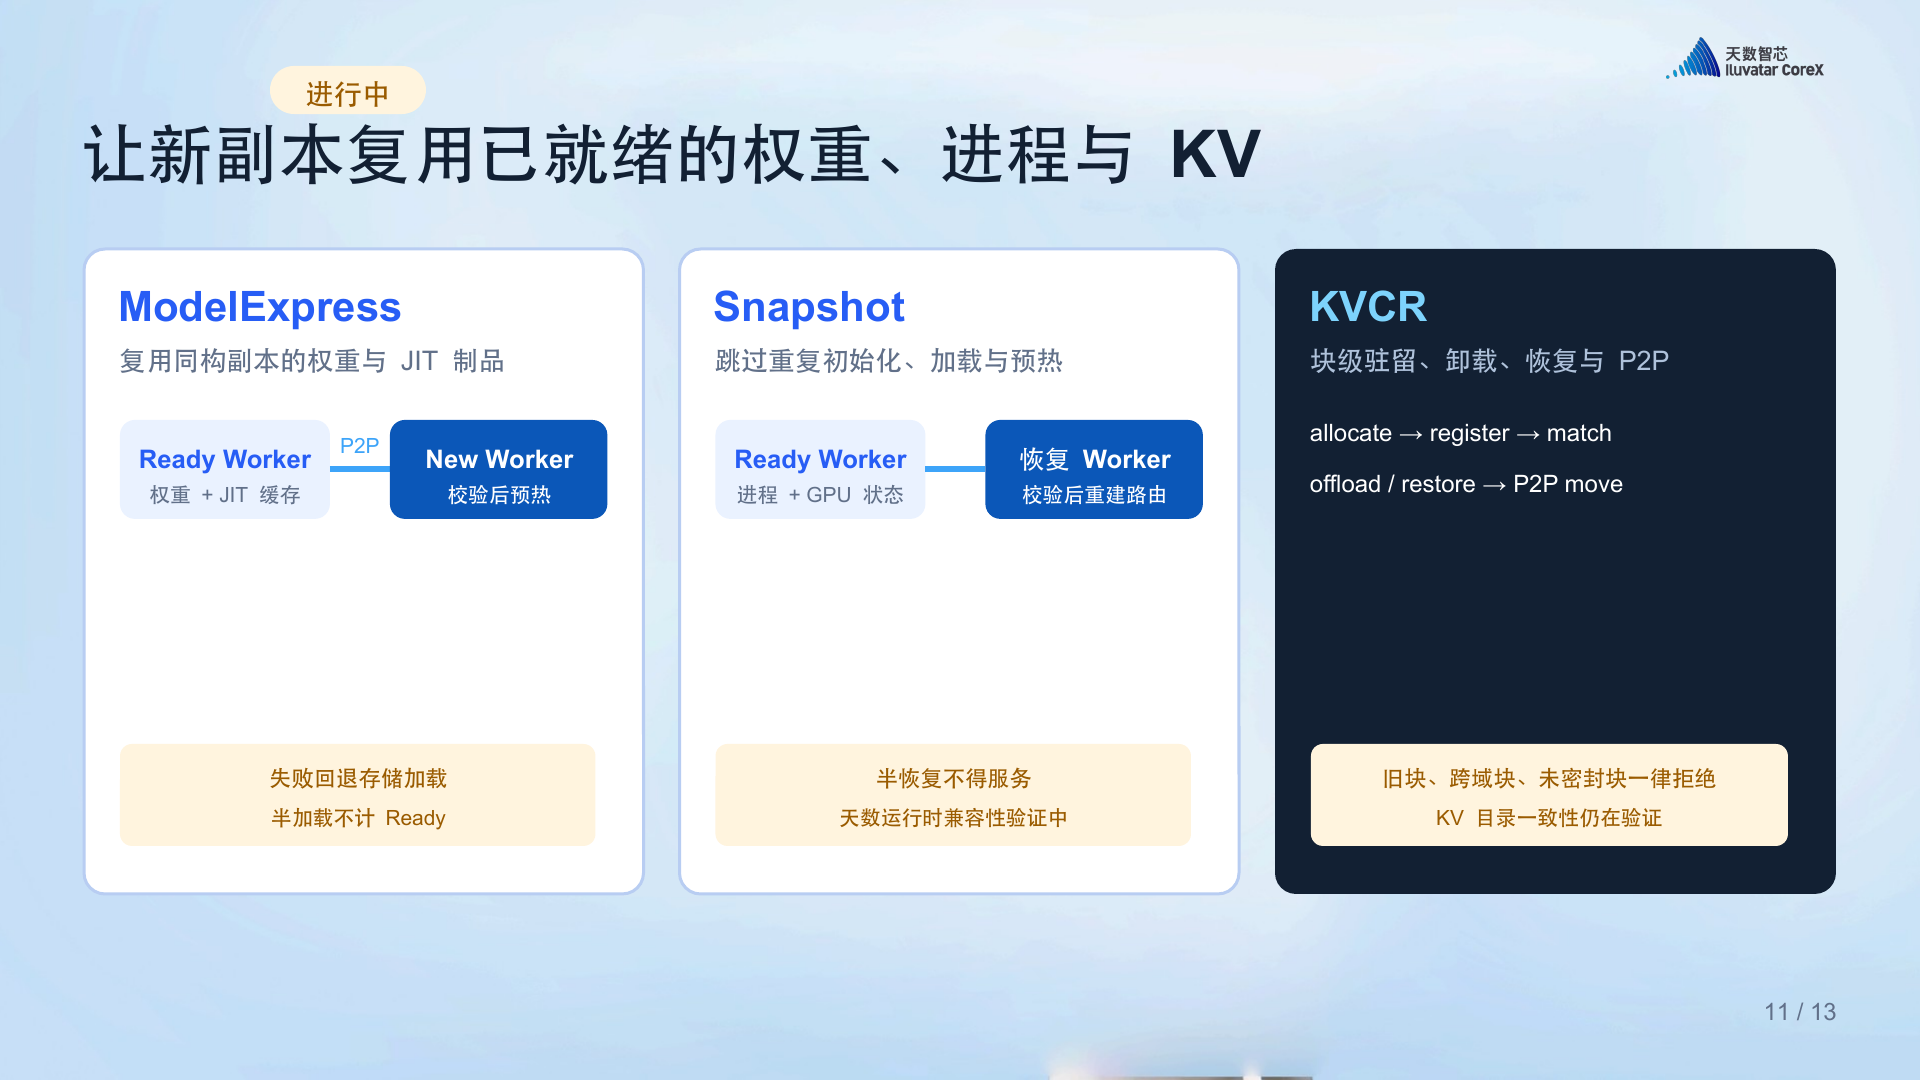
为缩短这段过程,叶成林介绍了分享时正在探索的 ModelExpress、Snapshot 与 KVCR 等方向,分别围绕权重复用、进程与 GPU 状态恢复、KV Cache 生命周期管理展开。这些工作在演讲中被列为尝试或验证内容,不应视为已经交付的性能结果。
对企业平台,落地时需要把两类判断分开:大模型是否适合 PD 分离,要检查计算、缓存传输与排队的收益成本;小模型是否适合共享 GPU,要检查共享后的资源争用与服务表现。密瓜智能围绕 HAMi 的企业应用,关注的是把适合共享的负载纳入这套验证:使用真实输入、并发和硬件条件压测,同时观察首 Token、持续生成与副本就绪时间,让资源效率的改善经得起业务体验检验。