电科云基于 HAMi 构建便携式知识库的国产 GPU 共享资源底座
电科云需要把智能知识库带到项目现场,在一套采用国产 GPU 的便携设备中同时承载文本生成、Embedding、Rerank、知识加工和研发调试任务。团队引入 Kubernetes 与 HAMi,将有限的国产 GPU 从长期绑定于单一服务的设备,转变为可由生产模型和 Kubernetes 开发环境按需申请、共享与调度的资源。
在这套资源底座上,文本生成、向量嵌入和重排模型形成完整知识库链路;单张国产 GPU 也可以通过 HAMi 的虚拟化能力供多个 Kubernetes 开发 Pod/容器共享。
案例信息
| 项目 | 内容 |
|---|---|
| 使用方 | 电科云技术团队 |
| 业务场景 | 可携带到项目现场、能够独立运行的智能知识库设备 |
| 部署环境 | Kubernetes 与本地国产 GPU |
| 使用项目 | Kubernetes、HAMi |
| 核心挑战 | 多模型协同、生产与研发共享 |
实践范围
| 知识库生产链路 | Kubernetes 开发环境 |
|---|---|
| 文本生成、Embedding、Rerank | 多个开发 Pod/容器可共享单张国产 GPU |
这套实践包含两条 GPU 使用路径:知识库生产模型优先使用本地稳定资源,Kubernetes 开发 Pod/容器通过 HAMi 共享本地国产 GPU。
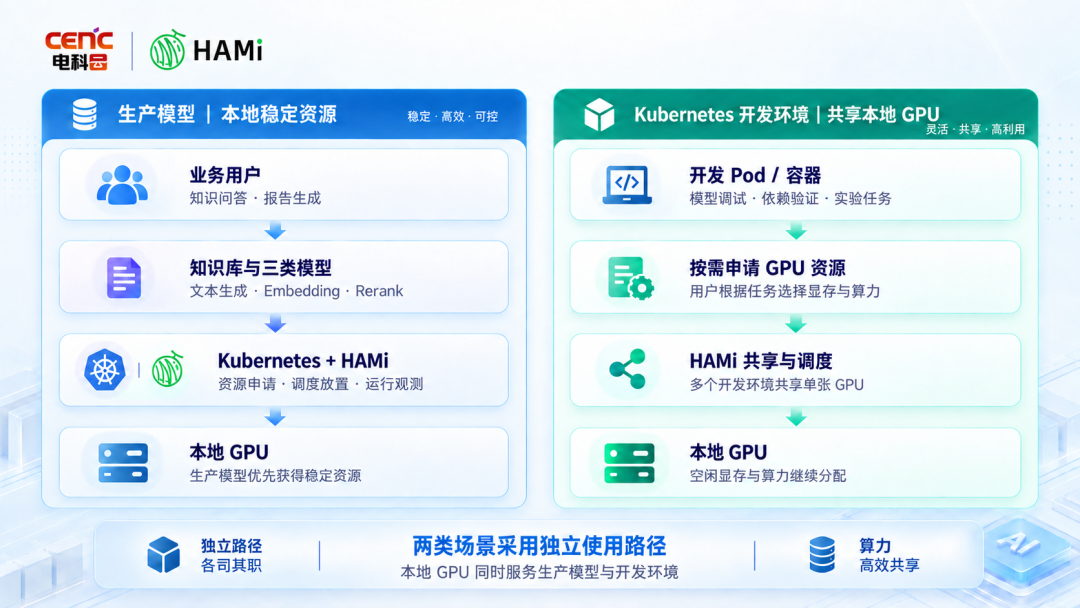
图 1:生产模型和 Kubernetes 开发环境分别通过 HAMi 使用本地国产 GPU。
一套便携设备需要同时服务生产与研发
知识库的在线问答依赖文本生成、向量检索和重排,数据进入系统后还要经过解析、切分、向量化、知识抽取和索引构建。研发人员还需要在 Kubernetes 开发 Pod/容器中调试模型、验证依赖和运行实验任务。这些工作负载对 GPU 的使用方式并不相同:
- 文本生成模型需要长期在线,显存基线较高,对响应时延敏感;
- Embedding 在批量导入资料时形成阶段性高峰,更关注吞吐;
- Rerank 位于在线检索路径,单次计算短,但调用频繁;
- 知识加工和索引重建属于批处理任务,需要与在线服务隔离;
- 开发 Pod/容器具有阶段性和交互式特征,适合在明确资源边界下共享 GPU。
如果继续让每个服务或开发环境长期绑定整张卡,有限设备会很快被逻辑占满;如果只追求尽可能细的切分,又可能放大显存不足、排队抖动和故障影响。团队需要让每类工作负载描述自身需求,再由平台根据设备状态和服务等级完成资源放置。
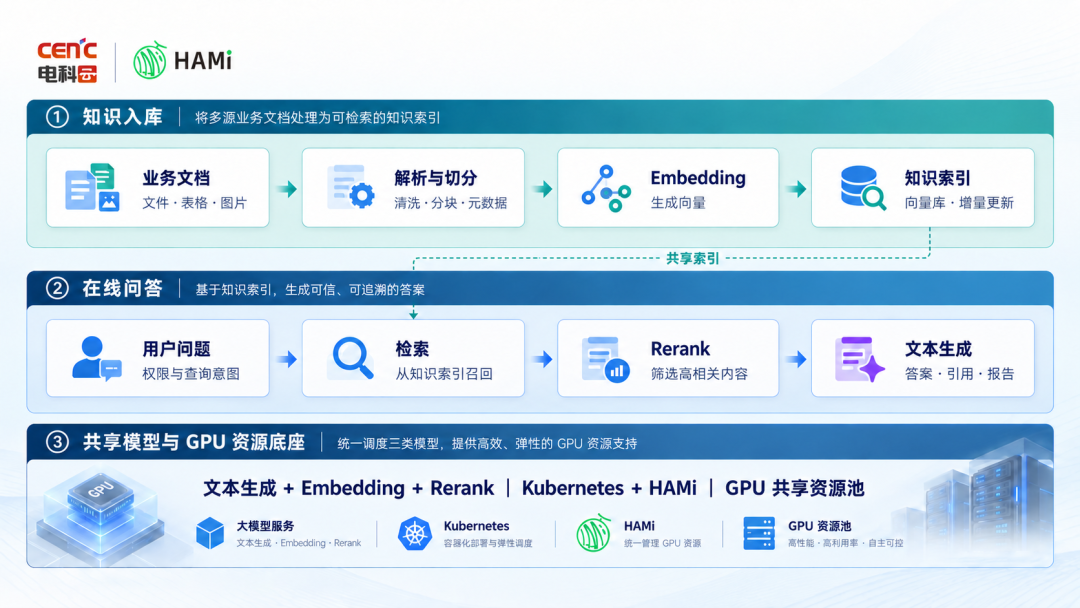
图 2:业务文档经过解析、Embedding 和索引构建进入知识库;在线问题经过检索、Rerank 和文本生成得到答案、引用或报告。
为什么选择 HAMi
电科云希望保留 Kubernetes 的应用交付方式,同时让平台进一步理解国产 GPU 设备是否能够满足工作负载申请,并让适合共享的开发环境复用同一张物理 GPU。HAMi 提供的 Kubernetes 原生资源声明、设备感知放置、设备共享与运行观测,与这三项需求相对应。
HAMi 的价值不只是把一张物理卡表示成多份资源,更重要的是建立一套共同的资源契约:
- 模型服务和开发 Pod/容器描述所需设备资源,不再依赖长期人工绑卡;
- 调度过程不仅判断节点上是否存在 GPU,还结合可用设备状态完成选择;
- 在实际设备后端支持的范围内,多个开发 Pod/容器能够共享单张国产 GPU,并获得各自的资源边界;
- Pod、容器、设备和调度结果能够重新关联,为容量观测和资源配置修正提供依据。
从资源画像到共享国产 GPU
团队按照工作负载特征建立资源画像,关注模型加载、峰值占用、并发、时延和长时间运行表现,再将验证后的需求转化为 Kubernetes 资源申请。生产模型与开发环境采用不同策略:
- 在线链路保持稳定边界。 文本生成、在线向量检索和 Rerank 优先获得稳定资源。
- 阶段性任务允许排队和错峰。 文档向量化、知识抽取和索引重建在在线负载较低时运行。
- 开发环境共享单张国产 GPU。 多个 Kubernetes 开发 Pod/容器通过 HAMi 的虚拟化能力复用国产 GPU,不再要求每个开发环境长期独占一张设备。
- 配置由真实负载修正。 切分粒度来自基线验证和运行观测,而不是预设跨模型通用的固定比例。
这套资源治理方式实现了四项产品能力:
- 文本生成、Embedding 和 Rerank 被纳入同一套 Kubernetes GPU 资源治理流程;
- 知识入库、检索、问答和报告生成形成完整运行链路;
- 在线服务、批处理任务和研发调试采用不同的资源规则;
- 单张国产 GPU 可以同时服务多个 Kubernetes 开发 Pod/容器。
量化结果:单设备开发环境承载能力从 2 个提升至 30 个
团队在同一套配备 8 张国产 GPU 的便携设备上,对引入 HAMi 前后的资源承载能力进行了同口径对比:
| 对比项 | 未使用 HAMi | 使用 HAMi 后 |
|---|---|---|
| 文本生成模型 | 独占 4 张国产 GPU | 继续独占 4 张国产 GPU |
| Embedding 与 Rerank | 各独占 1 张国产 GPU | 各申请 8GB GPU 显存配额 |
| 可供开发环境使用的容量 | 剩余 2 张 GPU,只能承载 2 个开发 Pod | 实际验证可同时承载 30 个开发 Pod |
| 开发环境承载能力 | 基线 | 提升至原来的 15 倍 |
开发 Pod 的显存额度由用户根据任务需要自行申请,平台不设置统一的固定值。在当前模型配额和开发负载下,团队完成了 30 个开发 Pod 同时运行的验证。
Embedding 模型的单卡资源对比
Embedding 模型在单张 64GB 国产 GPU 上实际需要约 8GB 显存。整卡独占时,模型虽然只使用约 12.5% 的显存,但其余资源无法被其他工作负载申请;引入 HAMi 后,团队按照模型需求分配 8GB 显存和 20% 算力,将剩余资源重新纳入调度。团队使用相同的模型镜像、请求集和并发配置,对整卡独占与 HAMi 切分两种模式进行了对比。
| 指标 | 未使用 HAMi | 使用 HAMi 后 |
|---|---|---|
| Embedding 显存分配 | 独占整张 64GB GPU | 按需分配 8GB |
| 模型实际显存需求 | 约 8GB | 约 8GB |
| 可供其他任务复用的显存 | 0GB | 56GB,即整卡显存的 87.5% |
| Embedding 算力分配 | 独占整卡 | 分配 20%,其余 80% 可调度 |
| Token 处理速度(tokens/s) | 基线 | 与整卡独占相比变化在 5% 以内 |
| 模型加载时间 | 基线 | 与整卡独占基本一致,未观察到明显变化 |
| P95 请求时延 | 基线 | 与整卡独占基本一致,未观察到明显变化 |
这组同卡、同模型对比表明,HAMi 将 Embedding 从整卡独占调整为按需分配,在 Token 处理速度变化控制在 5% 以内、模型加载时间和 P95 请求时延基本稳定的情况下释放了显存和算力,使同一张国产 GPU 能够继续承载开发环境或其他适合共享的任务。
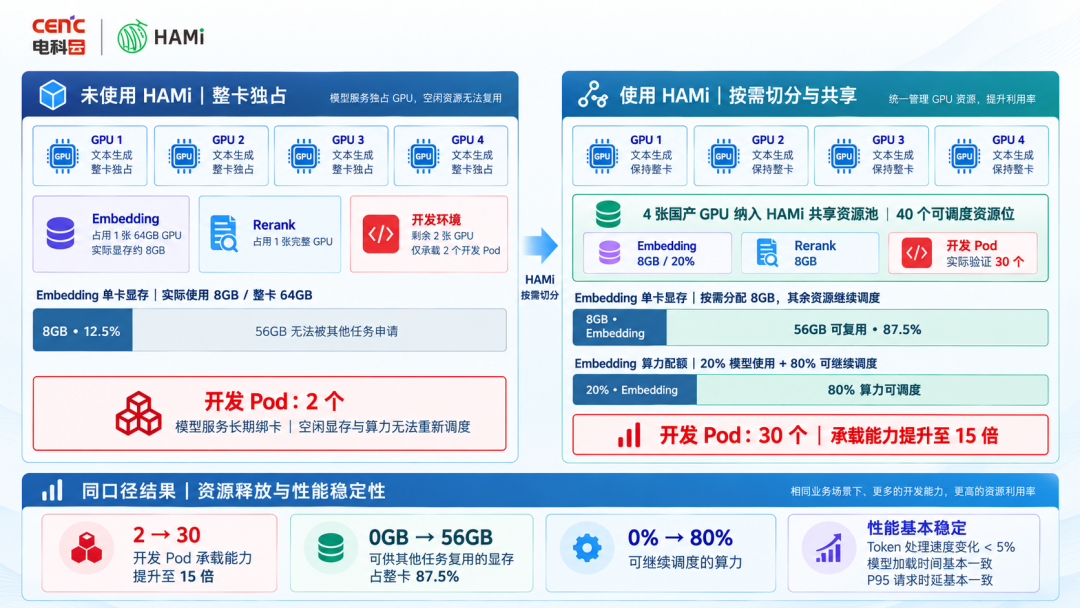
图 3:引入 HAMi 后,Embedding 从整卡独占调整为按需分配,单卡释放 56GB 显存和 80% 算力供其他任务调度;整台设备的开发 Pod 承载能力由 2 个提升至 30 个。
从这次实践中得到的经验
首先,国产 GPU 共享应从工作负载画像开始,而不是先决定统一切分比例。生产模型、批处理任务和开发环境对时延、显存、吞吐和隔离的要求不同,资源策略也应不同。
其次,研发环境是共享 GPU 的重要使用方。将开发环境运行在 Kubernetes Pod/容器中,可以复用与生产服务一致的资源声明和调度方式,同时避免每个开发环境长期独占设备。
下一阶段,电科云将继续完善生产和研发工作负载的容量及健康状态视图,补充不同模型、网络和调用模式下的可复现实验数据。
关于电科云技术团队
本案例中的电科云技术团队负责便携式智能知识库的产品研发与工程落地,围绕项目现场的本地运行、知识加工、模型服务和研发环境建立产品能力。
欢迎通过 HAMi 社区交流共享 GPU 和便携式 AI 的实践问题。