


Wie Zhuoyu Technology mit Koordinator die GPU-Zuweisungsquote auf Kubernetes auf über 95 % steigerte
Zugewiesene / zuweisbare GPUs, ohne fehlerhafte Geräte
Gemeinsame Steuerung mit Koordinator und HAMi
Entwicklungsumgebungen für Algorithmen und Data Engineering
Auf dieser Seite
Bei der Verwendung von Standardplaner, Multi-Tenant Flash-Einreichungen, GPU/CPU-Ressourcenfragmente und die Unfähigkeit, alle Pod gleichzeitig zu starten verteilt Operationen begrenzen Ressourcenzuweisung und -auslastung. Das Team führte Elastic Quta, Reservation, Device Share und Gang Scheduling Extension Schemer ein, die Device Share mit Hami kombinieren, um die Gesamtzahl der Karten um etwa 60 Prozent zu reduzieren.
Über Zhuoyu Technologie
Zhuoyu Technology bietet autopiloten Systemen und selbststudiumden Kernkomponenten. Um die Daten-geschlossene Schleife herum bauen Unternehmen Pilotwolken, die die Datenproduktion, Modellbildung, Modellbewertung und Modellbeurteilung in kontinuierliche iterative „Datenflyer“ verlinken, um mehr als ein Dutzend Algorithmen, Daten und Plattformteams zu teilen. Koordinator ist seit zwei Jahren als zentrale Scheduling-Engine der Plattform tätig.
Herausforderungen
Es gibt vier Hauptprobleme im Produktionsumfeld:
- Multi-Tenant Wettbewerb ist unfair. Die Kommission ist der Auffassung, daß die Kommission eine Reihe von Vorschlägen für die Durchführung der Maßnahmen zur Bekämpfung des Terrorismus und zur Bekämpfung der illegalen Drogenkonsumenten anwendet.
- GPU-Ressourcen sind leer. Pure CPU Pod verwendet die CPU und den Speicher auf GPU-Knoten, wodurch teure GPUs nicht scheduliert werden; gleichzeitig lassen GPU-Betriebe oft fast die Hälfte der CPU und des Speichers leer.
- Die GPU-Auslastung ist gering. Die Codespaces, die routinemäßig von Algorithmen und Dateningenieuren verwendet werden, und kleine Modelle verwenden weniger als 15 Prozent der gesamten Karte, wenn sie es alleine besetzen. Während des Debuggings ist GPU für die meisten Zeit leer und Anfragen für eine einzige Anfrage sind viel kleiner als die gesamte Karte.
- Verteilte Todesschlösser. Distributive Operationen erfordern, dass mehrere Pods bereit sind; einzeln führt dies zu einigen Pods, die Ressourcen halten, während andere mit der gleichen Operation bleiben im Pending-Status.
Warum Kubernetes und Koordinator
Die originalen Kubernetes bieten Hard-SourceQuota, Pod-by-Pod Bindung und gesamte Kartenzuweisung, aber nicht bieten intertenante Gewichtskreditquoten, einen Mechanismus, um CPU/RAM für GPUs zu halten, Partikelgrößenverteilung oder alle oder keine der verteilten Jobs. Koordinator erweitert diese vier Fähigkeiten durch Schedule ohne Änderung von Cluster API; und Hamei-Core Grenzen beim Teilen von GPS-Betrieben, wenn sie von Compute Resources and GPU betrieben werden.
Seit 2023 wurden mehr als 10 PRs in Koordinator integriert, einschließlich der Verfügbarkeit von HAMi-Core bei der Scheduler Perception Node (#2577) und der Bereitstellung von VGPU-Verteilungs- und Auslastungsindikatoren (#2578).
Loesungen
ElasticQuota: Equitable Kreditierung von Ressourcen mit Gewichten
Die zweistöckige Baumstruktur trennt die Quotengruppe von der Blattgeschäftsquote. Quota-Gruppen sind durch GPU-Typ oder Niveau der operativen Kritik geteilt, und die verschiedenen Gruppen leihen keine Ressourcen zwischen sich selbst durch Markierung eines Knotens. In derselben Gruppe kann die Blattquote über Mins Reservekapazität geliehen werden; wenn Wettbewerb stattfindet, entscheidet Max über seinen Anteil.
Automatische Etikettierung der Aufgabe 's plötzliche Notwendigkeit, nur freie GPU in dieser Gruppe zu verwenden, und nicht andere Ausbildungsgruppen geschützte GPUs. Jede GPU-Geschäftsquote ist auf .gpu und .cpuDies ermöglicht den Fluss der freien Ressourcen zwischen Betrieben innerhalb von kontrollierten Pools, während geschützte Pools ihre Präsenz beibehalten.
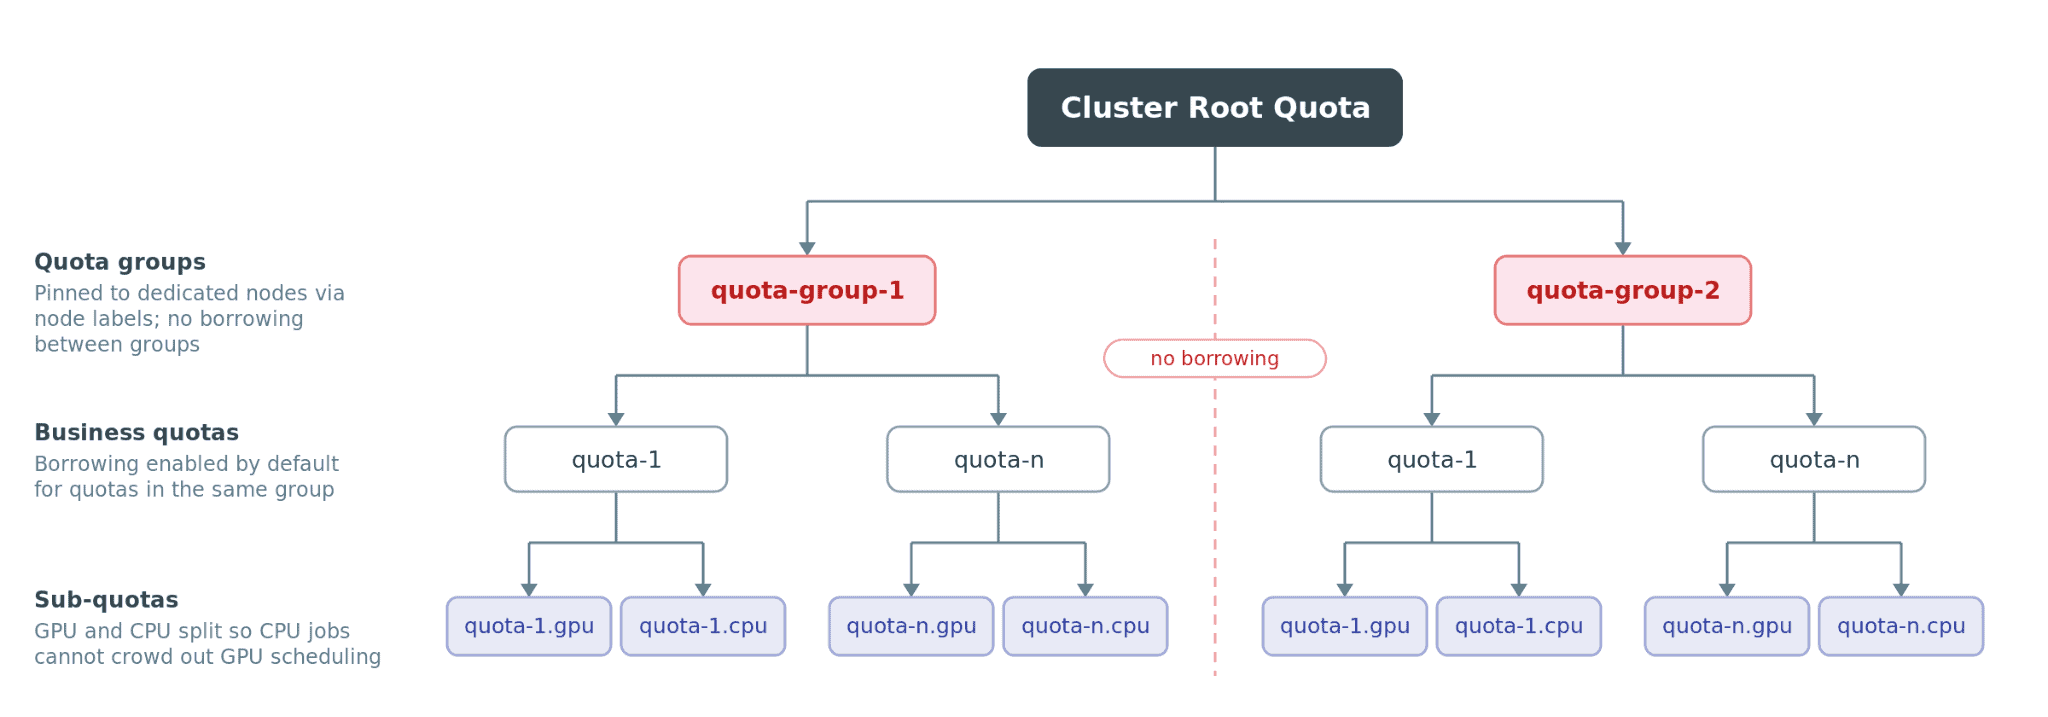
Quota Gruppensolationspool; verlässt Quote wird verwendet, um Ressourcen innerhalb der Gruppe zu leihen und GPU- und CPU-Anforderungen getrennt zu verwalten.
Reservierung: Sicherheit zur Erhöhung der Ressourcennutzungsintensität von GPU-Knoten
Auf dem 8 GPU / 224 CPU-Knoten hat RESERVATION CPU und Speicher für GPU Pod reserviert, so dass die CPU-Last überschüssige Kapazität nutzen kann, ohne das Schieduling der nachfolgenden GPU-Aufgaben zu verhindern. Dies entspricht einem virtuellen CPU-Pool, etwa 112 Kerne, 500gi, angepasst an das Ressourcenmuster des GPU-Betriebs, und erfordert keinen zusätzlichen Kauf von reinen CPU-Maschinen.
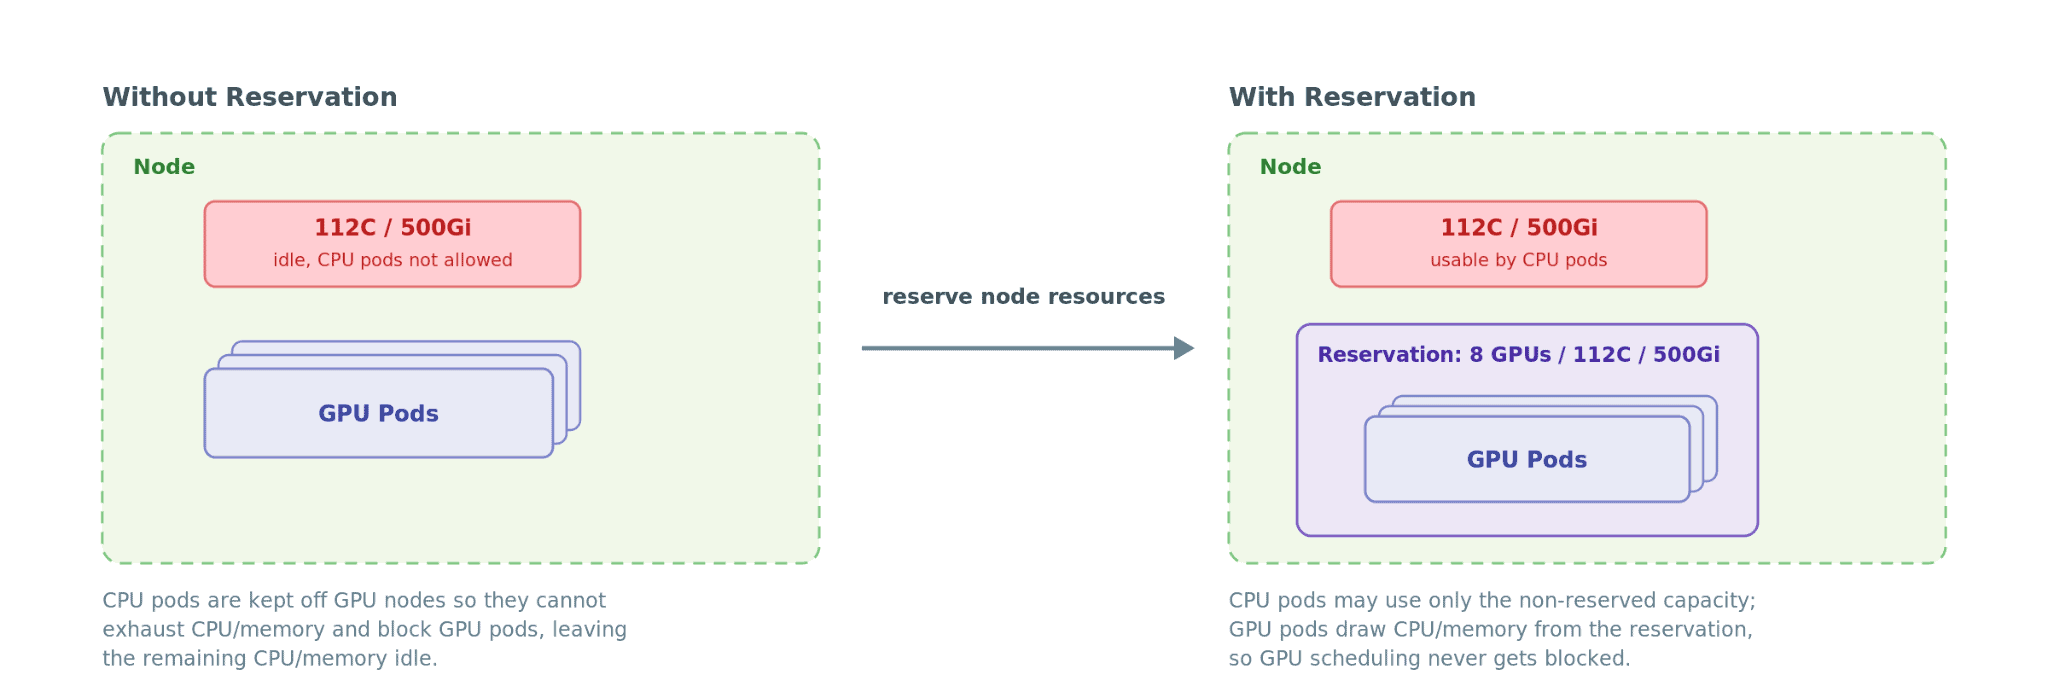
Die Reservation schützt die CPU/RAM-Ressourcen für GPU Pod und die verbleibende Kapazität wird für die CPU-Workload verwendet.
Device Share + Hami: GPU-Splits und Verein
feine Partikelgröße GPU geteilt nach vier Schritten: Pod Anfrage gpu-core und gpu-memory-ratio; koord-scheduler Device Share Plugin gebunden an eine Scheibe; Koordlet injiziert die Geräteumgebung variabel durch NRI in CRI Runtime statt direkt in Container; Hami-Core (gemounted by hami-daemon) libvgpu.soDies ist im Kontext der folgenden zu sehen:
Co-Pilot-Missionen können somit innerhalb ihrer jeweiligen Zuteilungsgrenzen aufrechterhalten werden, so dass Codespaces und kleine Modelle GPUs teilen können, ohne die ganze Karte besitzen zu müssen.
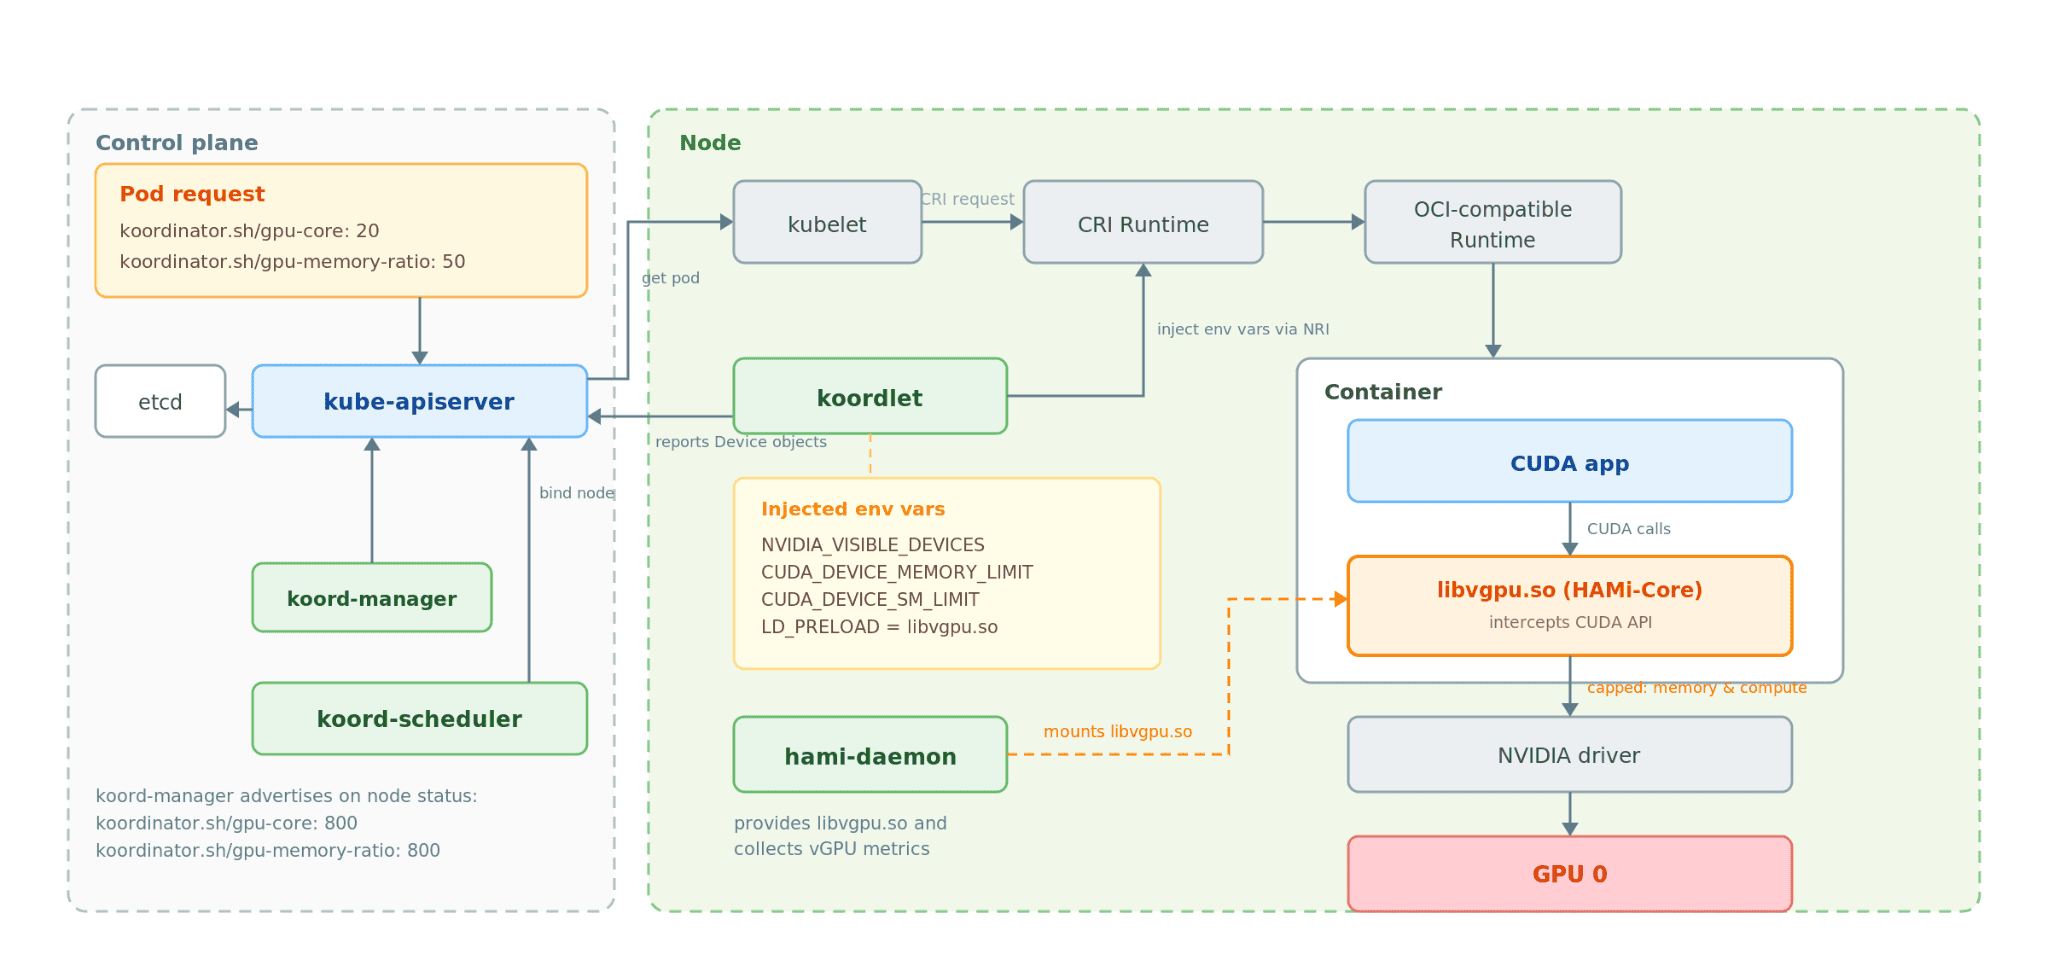
Device Share platziert GPU-Slices; Hami-Core stoppt CUDA API Anrufe und läuft Zeitlimits.
Wirksamkeit der Durchführung
Gang Scheduling: Distributive Operationen starten oder veröffentlichen als Ganzes
Der Task-Laderegler setzt den gleichen Gangnamen für Head und Worker Pod wie die min-available Nummer. Koord-scheduler identifiziert diese Noten, wählt Knoten für jedes Pod aus und hängt Bindung an der Permit-Stufe ab. min-available Nach der erforderlichen Anzahl gültiger Platzierungen veröffentlichte Scheduler die gesamte Gruppe.
Wenn die Schwelle nicht erreicht ist, bevor die Zeit abgelaufen ist, rollen Sie alle vermuteten Verteilungen zurück. Eine verteilte Operation beginnt entweder mit ausreichenden Ressourcen oder gibt eine vorübergehende Reservierung, um einige Pod halten die GPU zu vermeiden, während andere Mitglieder warten.
Quantifizierte Ergebnisse
| Metrik | Ergebnis |
|---|---|
| ElastischeQuota-Objekt | Mehr als 100 pro Cluster |
| Scheduling. | Zwischen 300.000 und 800.000 Pods pro Tag |
| GPU-Zuweisungsquote | Über 95% |
| GPU-Auslastung | Mehr als 55 Prozent insgesamt; geteilter Zugang ca. 60 Prozent |
| Codes erforderlich GPU ganze Karten | Reduzierung von ca. 60 Prozent |
Messmethoden. Die GPU-Zuweisungsrate wird durch die Anzahl der Planuling-GPU-Karten geteilt und umfasst nicht Funktionsgeräte. Der GPU-Auslastungsfaktor verwendet den in Knotentelemetrie gemeldeten mittleren SM-Nutzungsfaktor, Zählung aller Cluster und geteilter Referenzpunkte getrennt.
Folgeplan
Das Team konzentriert sich dann auf vier Richtungen: die Einhaltung verteilter atomarer Quota-Recycling; die Abflachung der Pending-Spitzen durch eine Last-Level-Linie; die String Scheduling Decke durch eine Scheduler-Fraktion zu brechen; und Multiclustering und Mischen von Wolken, um den plötzlichen AI-Anforderungen gerecht zu werden.
Original:How Zhuoyu Technology Pushed GPU Allocation Above 95% on Kubernetes with Koordinator ↗
Herausgeber: Cloud Native Computing Foundation (CNCF) · 2026-09-29
Diese lokalisierte Fassung übernimmt die technischen Informationen und den Messumfang des Originalartikels. Sie ist keine offizielle CNCF-Übersetzung. Architekturdiagramme behalten ihren Originaltext. Projektstatus und Produktangaben beziehen sich auf das ursprüngliche Veröffentlichungsdatum.
Das Original wird unter den Inhaltsbedingungen der Linux Foundation und CC BY 3.0 verwendet. Diese Fassung wurde übersetzt und neu gestaltet. Alle Marken gehören ihren jeweiligen Inhabern.