

Wie SeresCloud mit Kubernetes und HAMi die KI-Inferenz auf 10 Milliarden Token pro Tag skalierte
Von rund 300 Millionen auf über 10 Milliarden
HAMi und automatische Plattformskalierung; zuvor 15–25 %
Wachstum der gesamten SeresCloud-Plattform
Auf dieser Seite
Über Seres und SeresCloud
Seres ist ein technologieorientierter Automobilhersteller mit Schwerpunkt auf Fahrzeugen mit alternativen Antrieben. Mit dem wachsenden Einsatz von KI entwickelte das Unternehmen SeresCloud: eine interne Plattform für einheitliche Modelldienste für Geschäftsanwendungen und KI-Agenten. Kubernetes verwaltet die zugrunde liegenden GPU-Ressourcen.
Im Jahr 2026 stieg die Zahl der bereitgestellten Modelle von etwa 10 auf über 42. Das tägliche Token-Volumen wuchs von rund 300 Millionen auf über 10 Milliarden. Dieses Wachstum der Gesamtplattform rückte die GPU-Effizienz insbesondere bei der Inferenz kleiner Modelle in den Mittelpunkt.
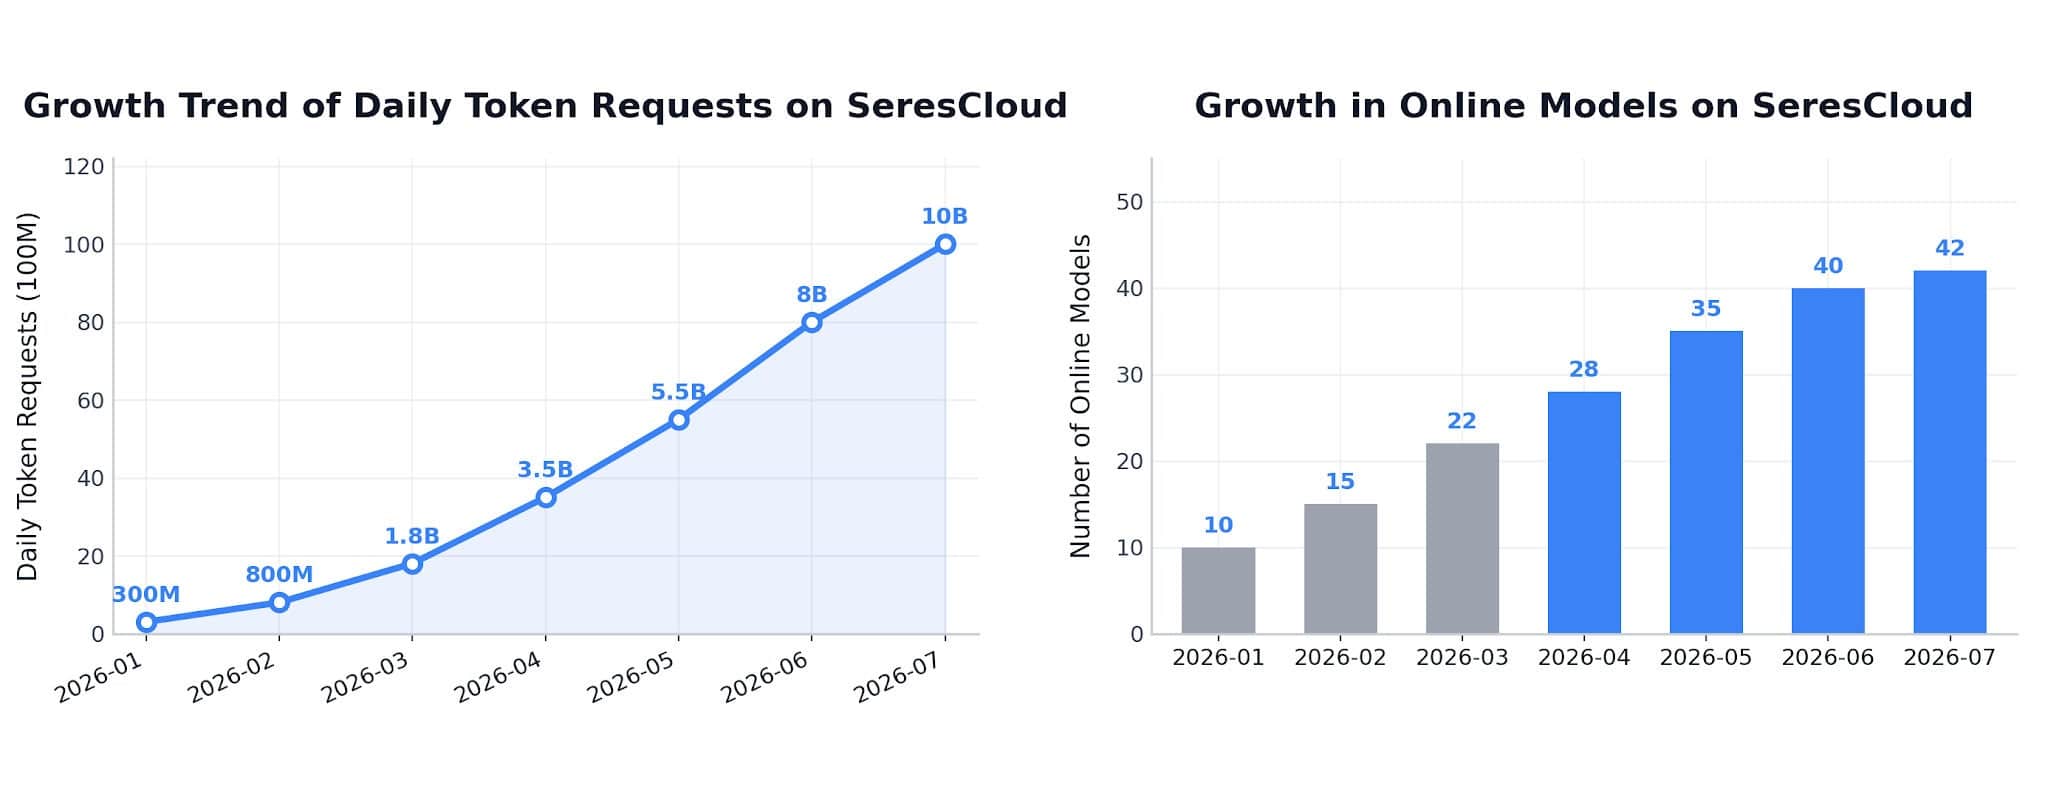
Wachstum der Modellzahl und des täglichen Token-Volumens auf SeresCloud
Warum die Zuweisung ganzer GPUs nicht ausreichte
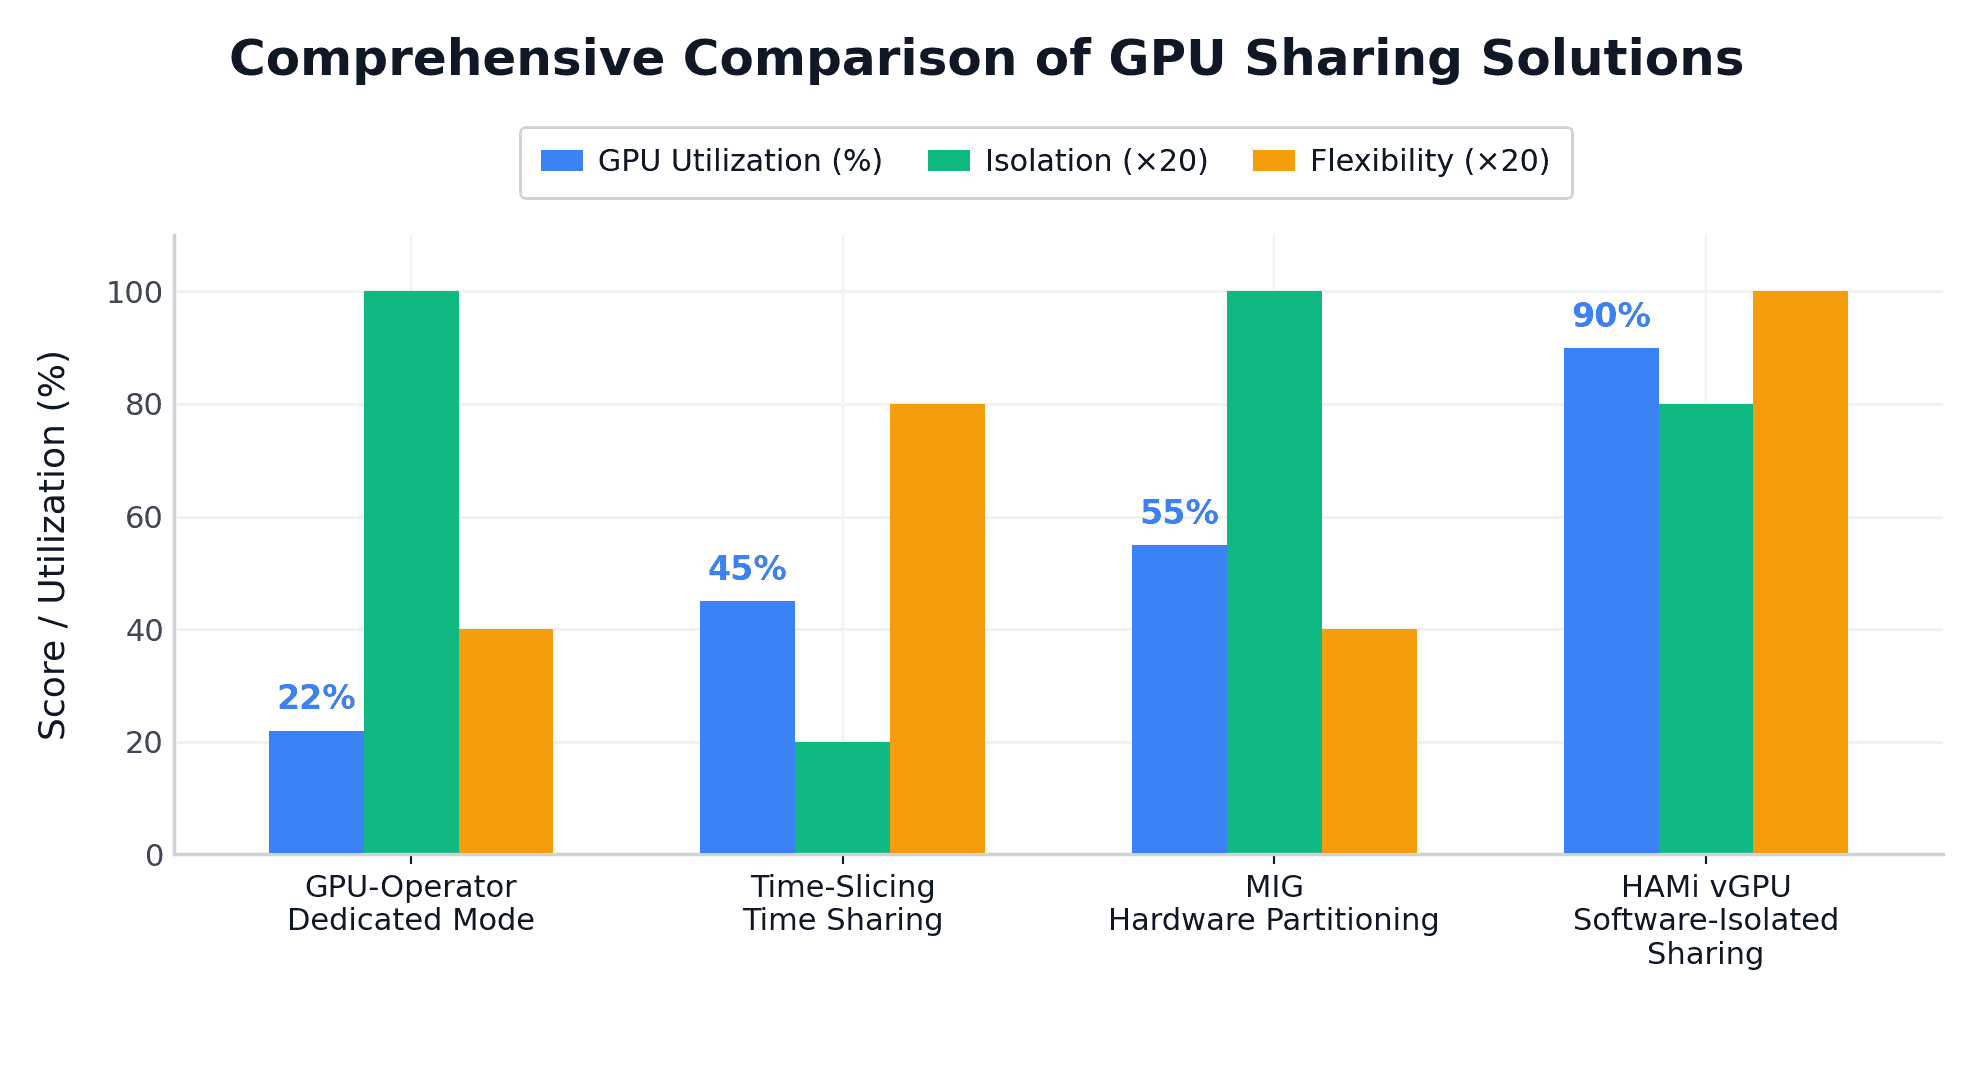
Die bestehende Umgebung nutzte GPU-Operator zur Geräteverwaltung sowie MIG auf unterstützten A100- und H100-GPUs. Mit zunehmender Vielfalt an Hardware und Modellen war die Zuweisung ganzer GPUs für Embedding, Reranking, Sprachverarbeitung und OCR zu grob. Einzelne Inferenz-Workloads benötigten häufig nur 1–4 GB GPU-Speicher; zugleich schwankte die Nachfrage stark zwischen Tag und Nacht. Bei exklusiver Zuweisung lag die GPU-Auslastung in diesen Szenarien meist nur bei 15–25 %.
Time-Slicing ermöglichte zwar die gemeinsame Nutzung, doch ohne klare Grenzen für Speicher und Rechenleistung entstanden Ressourcenkonflikte, Speicherengpässe und Latenzschwankungen. Seres benötigte eine höhere Auslastung mit besser kontrollierbaren Ressourcengrenzen für mandantenfähige Inferenzdienste.
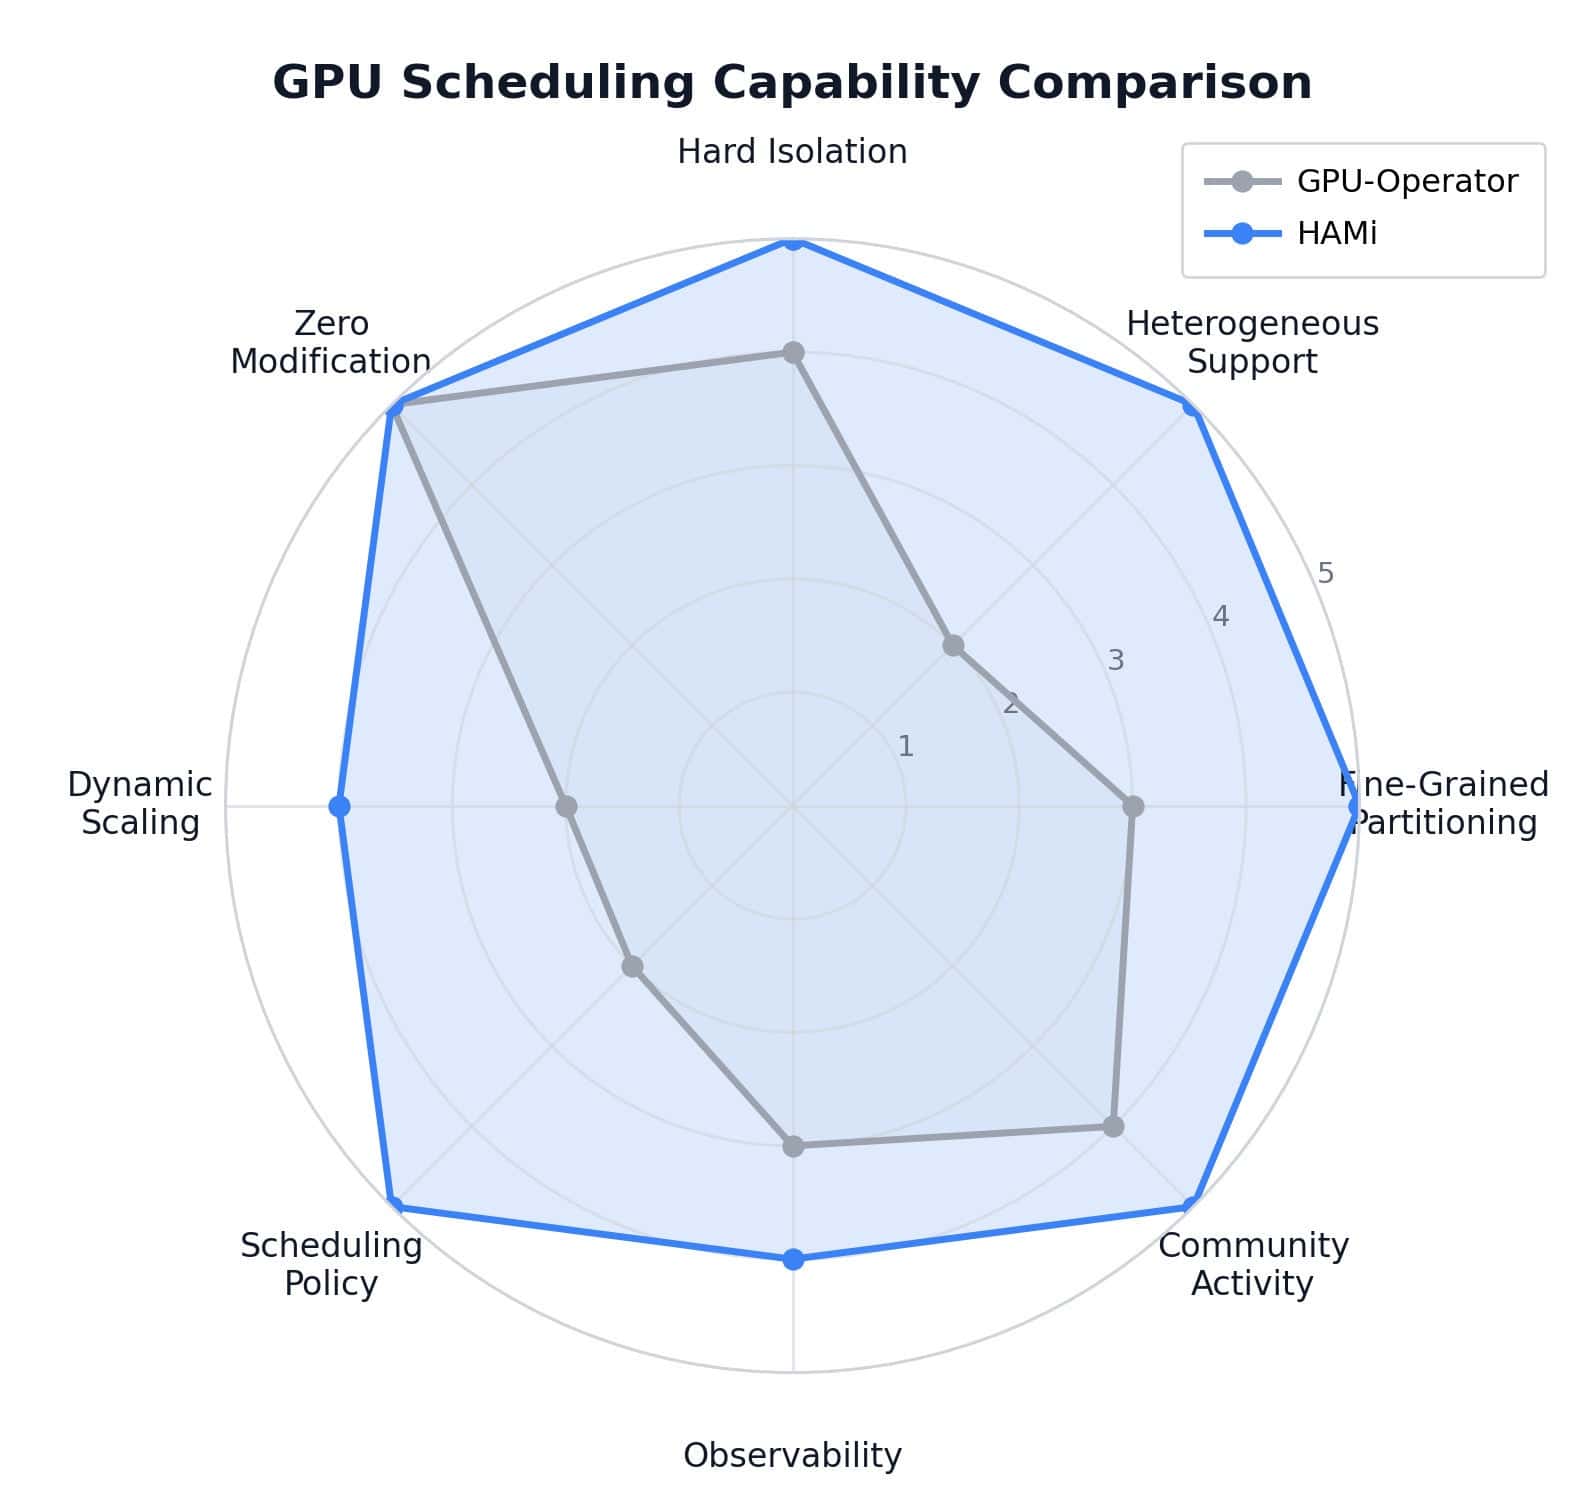
Vergleich verschiedener Ansätze zur GPU-Ressourcenzuweisung
HAMi und die automatische Skalierung der Plattform
SeresCloud verfügte bereits über eine Modellregistrierung, ein Inferenz-Gateway, automatische Skalierung und Monitoring. Die Registrierung verwaltete Images, Konfigurationen und Versionen. Das Gateway übernahm Routing, Lastverteilung, Ratenbegrenzung und Circuit Breaking. Die automatische Skalierung passte Replikate anhand von QPS, GPU-Auslastung und Warteschlangentiefe an.
Mit HAMi entscheidet die Plattform, wann skaliert wird und wie viele Replikate benötigt werden. HAMi platziert diese Replikate auf geeigneten GPUs und begrenzt GPU-Speicher und Rechenleistung pro Aufgabe. Gemeinsame Monitoring-Signale verbinden die Elastizität der Dienste mit einer feingranularen Ressourcenzuweisung.
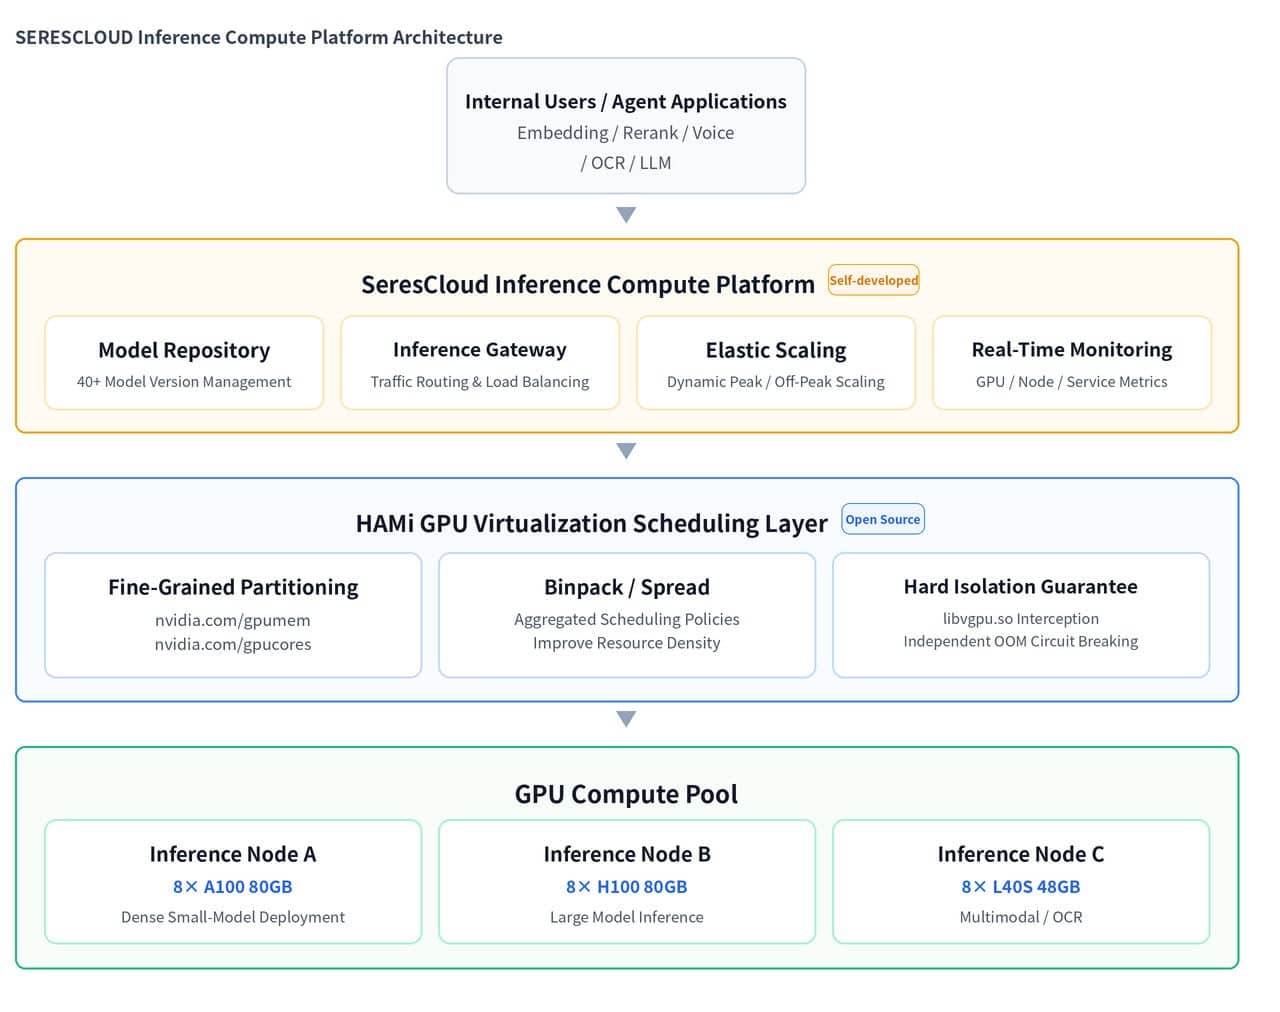
Zusammenspiel der SeresCloud-Inferenzplattform mit HAMi
Eine GPU für mehrere Inferenz-Workloads
Mit HAMi kann ein Kubernetes-Pod die Anzahl der vGPUs, den GPU-Speicher und einen Anteil der Rechenleistung anfordern. Das folgende Beispiel fordert eine vGPU, 3.000 MiB GPU-Speicher und 30 % Rechenleistung an. So kann ein kleines Modell bedarfsgerecht Ressourcen nutzen, ohne eine ganze GPU zu reservieren.
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 3000
    nvidia.com/gpucores: 30
Von exklusiven GPUs zur gemeinsamen Nutzung mit Ressourcengrenzen
Scheduling und Konfiguration im Produktivbetrieb
Seres setzt im Produktivbetrieb sowohl Binpack als auch Spread ein und wählt die Platzierung nach den Anforderungen der Workloads. Lasttests führten zu einem Limit von 10 vGPU-Aufgaben pro physischer GPU, ohne Überbuchung von Speicher oder Rechenleistung. Zusätzliche Aufgabenplätze schaffen keine zusätzlichen physischen Ressourcen: Beim Scheduling werden weiterhin die verfügbaren Geräteressourcen geprüft.
devicePlugin:
  deviceSplitCount: 10
  deviceMemoryScaling: 1
  deviceCoreScaling: 1
  migStrategy: none
  disablecorelimit: "false"

scheduler:
  defaultMem: 5000
  defaultCores: 0
GPU-Auslastung bei kleinen Inferenzmodellen steigt auf rund 90 %
Gemeinsam steigerten HAMi und die automatische Skalierung von SeresCloud die GPU-Auslastung bei der Inferenz kleiner Modelle von 15–25 % auf rund 90 %. Auf der Gesamtplattform wuchs das tägliche Token-Volumen um über 3.000 % auf mehr als 10 Milliarden; über 42 Modelle waren im Einsatz. Eine effizientere Ressourcennutzung unterstützte die Plattform beim Ausbau ihrer KI-Anwendungen.
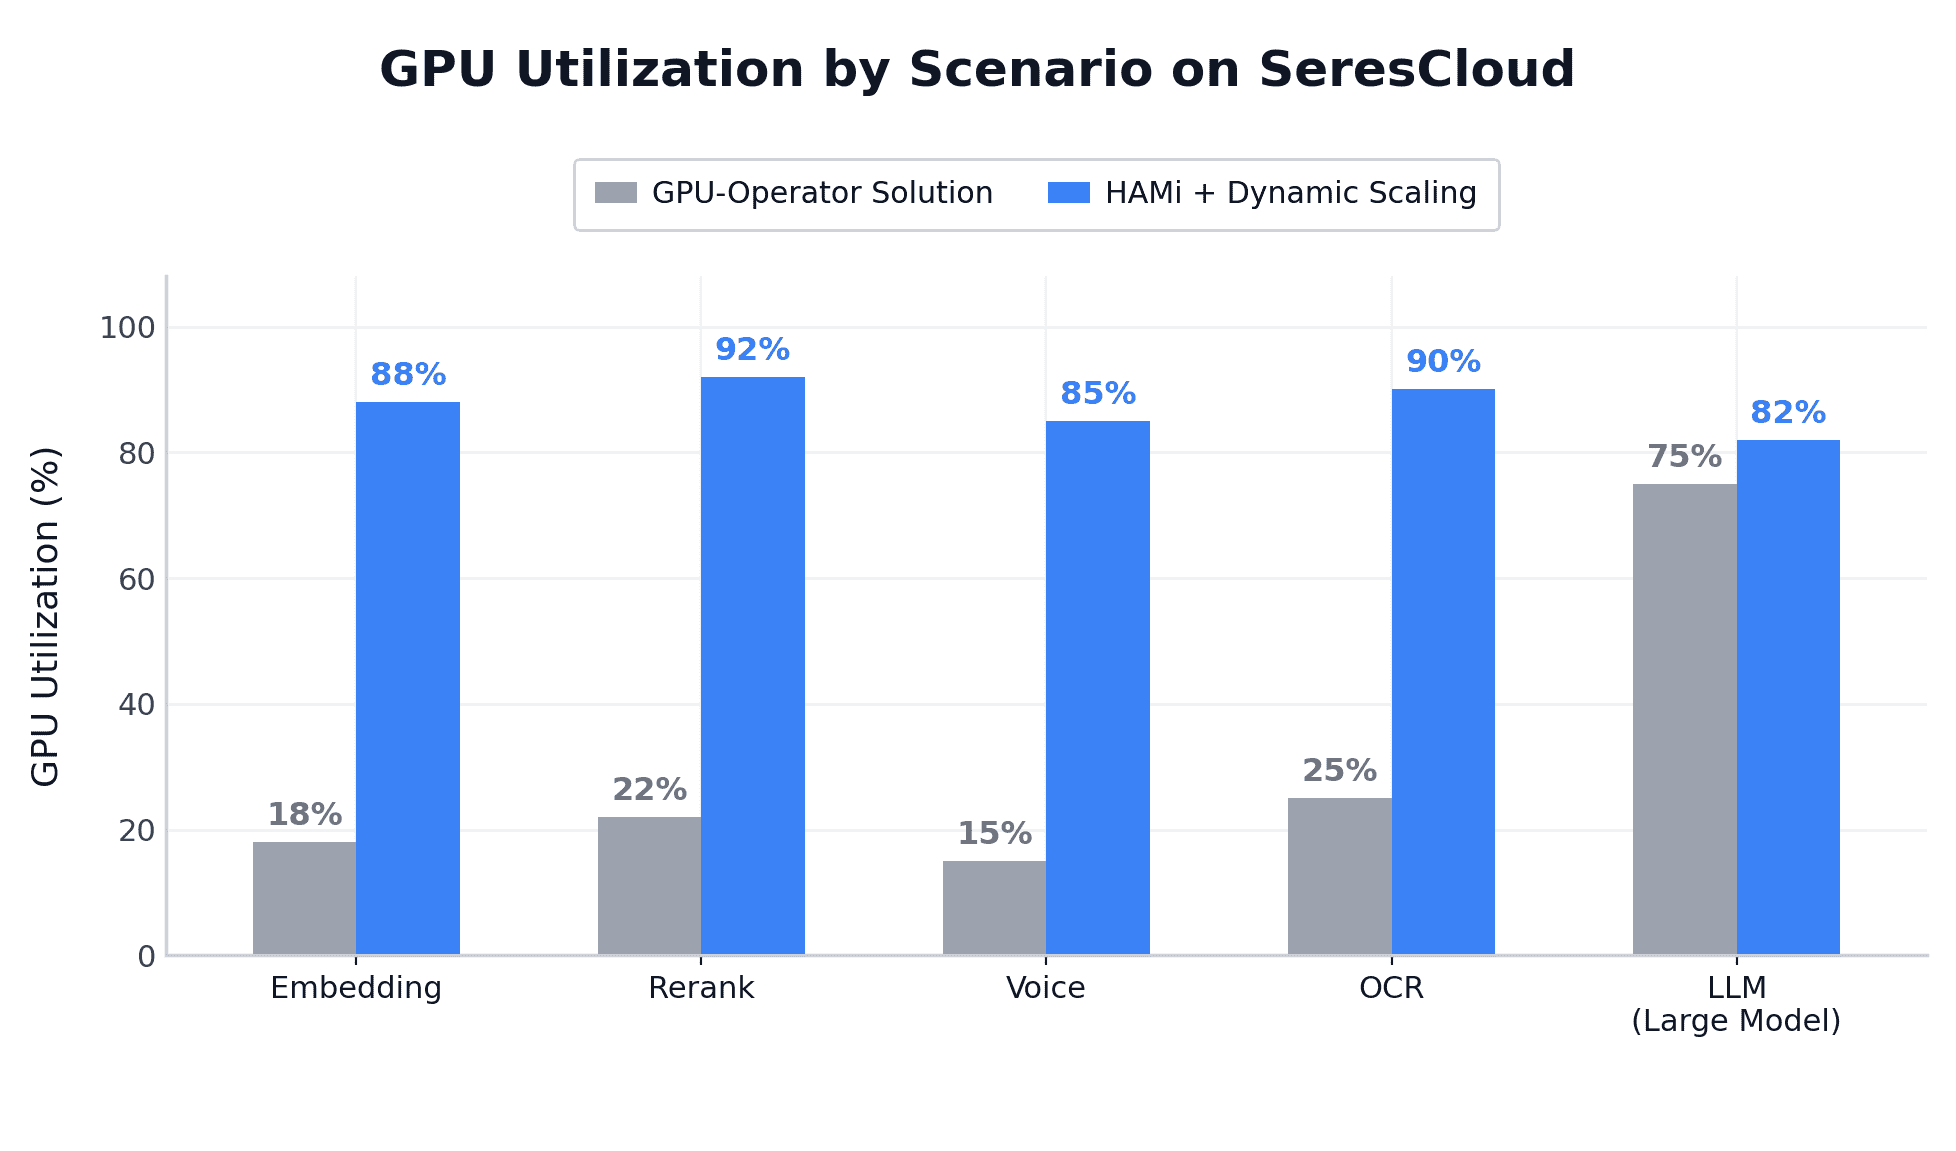
GPU-Auslastung bei der Inferenz kleiner Modelle
Erkenntnisse aus dem Produktivbetrieb
Bei der Einführung konfigurierte das Team Webhook-Ausnahmen für privilegierte Debugging-Pods und analysierte Scheduling-Fehler anhand von Gründen wie NodeInsufficientDevice, CardTypeMismatch und CardInsufficientMemory. Prometheus und Grafana führten die Metriken von HAMi und der Plattform zusammen, damit Fehleranalyse, Platzierung und automatische Skalierung auf einheitlichen Signalen basieren konnten.
Die Zahl der Gerätesegmente muss anhand realer Modelle, Nebenläufigkeit und Dienstqualität getestet werden; mehr Segmente sind nicht automatisch besser. Klare Zuständigkeiten zwischen der automatischen Skalierung der Plattform und dem HAMi-Scheduling sowie gemeinsames Monitoring sind entscheidend für einen stabilen Betrieb.
Nächste Schritte: mehr Hardware und Scheduling-Funktionen
Seres plant, Ascend- und Hygon-DCU-Geräte in seine Ressourcenpools aufzunehmen, HAMi-DRA zu evaluieren und prioritätsbasierte Verdrängung sowie topologiebewusstes Scheduling für größere Modelle zu untersuchen. Das Team möchte zudem seine Erfahrungen aus dem Produktivbetrieb weiter in die Open-Source-Community einbringen.
Original:How SeresCloud Scaled AI Inference to 10 Billion Daily Tokens with Kubernetes and HAMi ↗
Herausgeber: Cloud Native Computing Foundation (CNCF) · 2026-11-02
Diese lokalisierte Fassung übernimmt die technischen Informationen und den Messumfang des Originalartikels. Sie ist keine offizielle CNCF-Übersetzung. Architekturdiagramme behalten ihren Originaltext. Projektstatus und Produktangaben beziehen sich auf das ursprüngliche Veröffentlichungsdatum.
Das Original wird unter den Inhaltsbedingungen der Linux Foundation und CC BY 3.0 verwendet. Diese Fassung wurde übersetzt und neu gestaltet. Alle Marken gehören ihren jeweiligen Inhabern.