

Ein heterogener Ressourcenpool, zwei Workloads: China Merchants Bank vereint Training und Inferenz auf Kubernetes
Plattformweiter Durchschnitt: 35 % → über 60 %
Eingabe und Ausgabe, bei vergleichbaren Modellen und Servicebedingungen
Standardmäßig teilen fünf LoRA-Mandanten ein Basismodell
Auf dieser Seite
Die China Merchants Bank ist einer der führenden chinesischen Geschäftsbanken, die kontinuierlich in claud-native Technologie, künstliche Intelligenz und digitale Infrastruktur investiert. Da KI sich auf weitere Finanzszenen ausdehnt, muss die Plattform große Modellausbildung, Feinabstimmung, Onlinezugang und andere KI-Lasts an fast 10.000 heterogenen Beschleunigern unterstützen.
In dieser Größenordnung wird die Erhöhung der Beschleunigungsmesser nicht die Effizienzprobleme der Plattform lösen.
Die China Merchants Bank schafft ein einheitliches Kontrollflugzeug auf Kubernetes, während sie zwei schmückende Pfade festhält. Beide Lasten laufen im Kubernetes Deproyment Pod mit Ray als verteilte Laufzeit: Twinkle ist verantwortlich für mehrstufiges Training, vLLM oder SSLang bietet Online-Zugang.
In der Ladersteuerungsschicht verwaltet Kuue Trainingsschlangen, Quoten und Zugang; Prometheus und KEDA skalieren Inferenzdienste basierend auf Echtzeit-Anforderungssignalen; Hami Scheduling und Allocate gemeinsamen Beschleunigerressourcen; Fluid beschleunigt Zugriff auf Datensätze, Modellgewichte und Kontrollpunkte.
Der mittlere Beschleuniger der Plattform stieg von 35 % auf mehr als 60 %. Bei vergleichbaren Modell- und Servicebedingungen wurden die Referenzkosten pro Million Token (Gesamteinsatz und Ausgang) um mehr als 60 % reduziert. In der Standardkonfiguration teilten 5 LoRA Mieter ein Beispiel eines Basismodells, das fünfmal die Trainingsdichte erhöhte und das Basismodell von 5 auf 1 reduziert wurde.
„Die eigentliche Herausforderung besteht darin, keine Beschleunigerkapazität zu haben, sondern Möglichkeiten zu finden, bestehende heterogene Ressourcen effizienter zu nutzen.
— PeiXiang Tan, China Mercants Bank AI Infrastructure Architect
| Waren | Inhalt |
|---|---|
| Industrie / Region | Finanzdienstleistungen / China |
| Plattformen | KI Ausbildung und Referenz |
| Größe | Fast 10.000 heterogene Beschleuniger. |
| Verwendete Projekte | Kubernetes、Kueue、KEDA、Prometheus、HAMi、Fluid、Twinkle |
| Durchschnittliche Beschleunigerauslastung | Tokenkosten pro Million | Multi-Tenant Trainingsdichte |
|---|---|---|
| 35% → 60%+ | Reduzierung von 60% oder mehr, Gesamteingabe und -ausgabe | 5 mal höher |
Herausforderungen
Das Problem ist nicht nur eine geringe Auslastung, sondern auch die Art und Weise, in der Ausbildung und Zugang die gleichen Ressourcen verbraucht, ist grundlegend unterschiedlich.
Schulungen erfordern stabile und vorhersehbare Ressourcen
Distributives Training ist in der Regel langlebig und basiert auf Insinuation, und nur alle Arbeiten können effektiv starten, wenn die Worker-und Beschleuniger-Karten bereit sind. In Abwesenheit eines sensorischen Quotenzugriffsmechanismus kann einige Pod früh genug aktiviert werden, um Kapazität zu sparen, während warten auf die restlichen Ressourcen. Gleichzeitig müssen Datensätze und Modellgewichte zwischen zentralisierten Speicher- und Rechenknoten übertragen werden; wenn Daten nicht bereit sind, zugeordnete Beschleuniger.
Der Einfluss muss dem Fluss folgen.
Online-Referenz ist das Gegenteil. Anfragen schwanken mit Geschäftsflüssen, und Reaktionsverzögerungen sind wichtiger als die Batch-Verarbeitung im Falle von Staus. Beschleunigungsanlagen werden auf Spitzenlast gesetzt, verlassen eine große Menge an Leerständen im Tal. Eindrücke können Abfall reduzieren, aber wenn Verkehr zurückkehrt, müssen neue Kopien Modellgewichte auf Serviceanfragen neu laden.
Die Feinabstimmung erfordert eine Sollation ohne Wiederholung des Ladegrundmodells.
LoRA aktualisiert nur einige wenige Parameter, aber die traditionelle “ein Mieter-Einsatz” wird immer noch das komplette Basismodell laden wie es läuft. 5 der gleichen Modelle werden fünf Basismodelle erstellen, obwohl kleinere Adapter unterschiedlich ist.
Daher erfordert die Aufteilung der Rechenpools unterschiedliche Laststrategien und eine separate Verarbeitung von physikalischen Beschleuniger-Sharing und Modellreuse.
Loesungen
Warum eine kombinierbare Cloud-native Technologie-Wage wählen
Die China Merchants Bank nutzt eine auf Kubernetes basierende Plattformstrategie, die mehrere CNCF-Projekte in einheitliche Trainings- und Inferenzfähigkeiten vereint. Schulung und Referenz ermöglichen die Auswahl von Motoren und Strategien, die sich am besten eignen, indem sie Kontrollböden, Ressourcenschichten, Datenpfade und Überwachungssysteme teilt.
Diese Entscheidung beruht auf drei Grundsätzen:
- Unabhängige Entwicklung: Trainingsrahmen, Referenzmotoren und Modelle sind unterschiedlich in Geschwindigkeiten und sollten nicht eng ausgerichtet werden.
- Hardwareflexibilität: Kubernetes und Hami bieten ein gemeinsames Management-Portal für den Austausch heterogener Beschleuniger, wodurch die Abhängigkeit von Single-Manufacturing Technologie Lockdowns reduziert wird.
- Offene Integration: Kuue, KEDA, Prometheus, Hami und Fluid sind über die Kubernetes primäre Schnittstelle verbunden, ohne dass ein Produkt benötigt wird, um den gesamten Modelllebenszyklus zu verwalten.
Die gemeinsame Basis besteht hauptsächlich aus CNCF-Hosting-Projekten. Kubernetes, KEDA und Prometheus sind Abschlussprojekte; Kueue wird von Kubernetes SIG Scheduling gehalten; Hami und Fluid sind Inkubatoren.
Umsetzung und Zusammenarbeit
In enger Zusammenarbeit mit den Rechenzentren der Bank und anderen internen Teams nutzte die China Mercants Bank diesen Rahmen, um 99 Prozent der Beschleunigerressourcen in das einheitliche Management und die Leistung zu integrieren.
Struktur: geteilte Infrastruktur, Entkopplungszeit
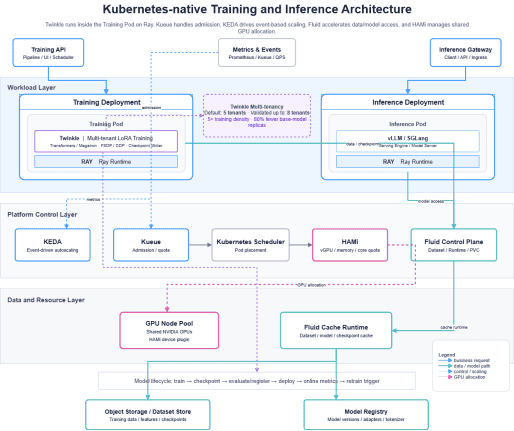
Kubernetes Native Unified Training and Reference Framework.
Die Architektur teilt Ressourcen auf der Infrastrukturebene und unterscheidet zwischen Ausbildung und Zugang zum Betriebszeitpunkt.
In der Lastschicht sendet Traying API Aufgaben an Pod, Twinkle, die von Training Development verwaltet wird, wo das Training auf Ray basiert. Inference Gateway verbindet Online-Anfragen an Pod, verwaltet von Access Development Management, mit vLLM oder SGLang, die Zugriff auf Ray bietet.
Die beiden Pfade hängen von der gleichen Anzahl von Fähigkeiten ab: Kueue und KEDA, für Schulungen Zugang und Inferenzelastizität; Kubernetes Scheduler und HAMi, um Pod zu platzieren, Beschleunigerkapazität zuzuordnen; Fluid, um Daten und Modellzugriff bereitzustellen, Prometheus zur Erfassung von Leistungsindikatoren. Der untere gemeinsame Beschleunigerknoten ist an die Objektspeicherung und Modellregistrierung angeschlossen.
| Abmessungen | Ausgebildeter Pfad | Inferenzpfad |
|---|---|---|
| Muster der Nachfrage | Lange Zeit, Batch und unempfindlich. | Sudden, verzögert empfindlich, Antrag getrieben |
| Zugang. | Training API | Inference Gateway |
| Primärkontrolle | Keueué Access und Quota Management | Prometheus Indikatoren und KEDA Autoscaling |
| Laufzeit | Twinkle on Ray | vLM oder SGLang auf Ray |
| Geteilter Bottom | Kubernetes Scheduler, Hami, Fluid, Beschleunigerknoten, Speicher- und Modellregistrierungszentrum | Die gleiche Linke |
| Schlüsselergebnisse | Höhere mehrstufige Trainingsdichte | Niedrigere Stückkosten |
Die Erhöhung der Auslastung von Beschleunigern kann nicht auf einzelne Komponenten, sondern auf die kombinierten Effekte des Zugriffs, der Terminierung, der Verteilung, des Datenzugriffs und des Zurücklaufens zurückgeführt werden.
Trainingspfad: Twinkle Multi-Tenant Training basierend auf Ray
Schulungsanfragen werden durch Zugriffskontrollen vor der Erstellung von Rechen- und Datenressourcen gestellt:
Training API → Kueue-Zulassung & Quoten → Kubernetes Scheduler → HAMi-Beschleunigerzuweisung → Fluid-Datensatz-/Checkpoint-Zugriff → Twinkle on Ray → Checkpoint- & Modellregistrierung.
Kuuee ermittelt zunächst, ob Operationen Cluster auf Basis von Warteschlangen und Quoten eingeben können, wodurch einige Pod nicht endgültig für den Rest der Ressourcen warten. Nach dem Zugriff wählt Kubernetes Scheduler Knoten und Hami verteilt die erforderliche Beschleunigerkapazität. Fluid verwendet den abstrakten und rechnerischen Seitencache von Kubernetes Rohdaten, um doppelten Zugang zu zentralisierten Speichern zu reduzieren und die Beschleuniger weniger warten zu lassen.
Twinkle arbeitet in Training Pod, basierend auf Ray-Training, um Transformers oder Megatron Backends zu unterstützen. Im Multi-Tenant LoRA-Szenario teilen Mieter Beispiele eines Modells mit einem unabhängigen Adapter, Trainingskonfiguration und Status. Standardmäßig teilen fünf Mieter ein Basismodell. Im Vergleich zur unabhängigen Bereitstellung wird das Basismodell von 5 bis 1 Kopien reduziert, wodurch die Nutzung der Beschleunigerressourcen um 80 Prozent reduziert wird.
Die Anzahl der mit einem Beispiel eines Basismodells unterstützten Mit-Teaching-Patienten ist fünffach gestiegen, die Plattform wurde als Co-opted validiert und die Produktionsumgebung wird standardmäßig von 5 Mietern genutzt.
Nach dem Training übergibt Twinkle die Kontrollpunkte an den nachgeschalteten Modellmanagementprozess. Fluid beschleunigt den Ablauf der Kontrollpunkte zwischen Speicher und Berechnung, und das Model Registration Centre registriert Modellversionen, Adapter und Tokenizer für Bewertung und Bereitstellung.
Inferenzpfad: KEDA, HAMi und Fluid synergetic service
Der Inferenzpfad beginnt mit einer Online-Anfrage:
Inference Gateway → vLLM oder SGLang on Ray → Prometheus-Service- & Nachfragekennzahlen → KEDA-Skalierungsentscheidung → Kubernetes Scheduler & HAMi-Zuweisung → Fluid-Modellcache-Zugriff.
Schlüsselindikatoren wie QPS, beantragte Warteschlangentiefe, Zugriffsverzögerung sind den Prometheus-Sammlungsdiensten ausgesetzt. KEDA fügt Kopien auf Basis dieser Briefentscheidungen hinzu und subtrahiert Kopien. Kubernetes Scheduling new Pod, Hami ordnet entsprechende Beschleunigerressourcen an und Fluid liefert das Cache Modellgewicht.
Jede Komponente beseitigt Kosten aus verschiedenen Quellen:
- KEDA passt die Anzahl der Kopien an, um die Leerlaufkapazität in niedrigen Talstunden zu reduzieren.
- HAMi ordnet die Beschleunigerkapazität für den entsprechenden Anteil des Feinkorns an, um kleine oder flüchtige Dienstleistungen mit ausschließlichem Eigentum an der gesamten Karte zu vermeiden.
- Fluid reduziert die Ladezeit für neue Kopien, indem Modellgewichte in der Nähe der Berechnung platziert werden.
- Prometheus liefert Echtzeit-Indikatoren, die Skalierungsentscheidungen ermöglichen, um die tatsächlichen Nachfrage- und Serviceziele zu reflektieren.
Die bedarfsgerechte Elastizität, Feinkornbeschleunigerverteilung und die schnellere Modellbelastung vermindern zusammen die Kosten der Inferenz.
Integrierter Modelllebenszyklus
Trotz unterschiedlicher betrieblicher Strategien sind Schulungen und Referenzen mit dem Lebenszyklus des gleichen Modells verknüpft:
Training → Checkpoint → Bewertung & Registrierung → Produktionsbereitstellung → Online-Monitoring → iterative Optimierung.
Schulungs- und Inspektionspunkte werden im Objekt- oder Datensatzspeicher gespeichert und Fluid bietet einen einheitlichen Zugriff und Cache. Twinkle Generation Models oder Adapter Checkpoints werden im Modellregistrierungszentrum ausgewertet und registriert; der Inference Service lädt ausgewählte Versionen durch Fluid. Prometheus sammelt Produktionsindikatoren kontinuierlich, um eine Basis für Volumenanpassungen und die nächste Runde von Modellüberlagerungen bereitzustellen.
Die Harmonisierung von Ausbildung und Inferenz ist nicht nur eine Kombination aus zwei Lasten im gleichen Kubernetes-Cluster, sondern gemeinsame Ressourcenverwaltung, Datenfluss, Modellversionen und Online-Feedback.
Wirksamkeit der Durchführung
| Metrik | Ergebnis |
|---|---|
| Durchschnittliche Beschleunigerauslastung | 35% → 60%+ |
| Kosten der Gegenleistung | Token sinkt um mehr als 60% pro Million, Gesamtleistung |
| Multi-Tenant Trainingsdichte | 5 mal zunehmen; 5 Reduzierung der Nutzung von Beschleunigerressourcen durch Mieter 80% |
| Kopie des Basismodells | Standard 5 LoRA Mieter, Kopie reduziert von 5 bis 1 |
| Komponieren Authentication | Gültig 8 Mieter; Produktionsstandard 5 |
Die wichtigsten Ergebnisse des Plattform-Teams.
Durchschnittliche Beschleunigernutzung: 35% 60% +
Mit den gleichen internen Messmethoden vor und nach dem Nachrüsten stieg die durchschnittliche Nutzungsrate von fast 10.000 heterogenen Karten von 35 % auf über 60 %. Kuue reduziert Trainingsoperationen, die vorzeitig sind und schädliche Ressourcen sind; Hami erhöht die Verteilung von Partikeln; Fluid verkürzt Daten und Modellgewichte warten.
Token-Inferenz pro Million: um 60% oder mehr
Unter vergleichbaren Modell- und Servicebedingungen werden die Kosten für die Verarbeitung einer Million Token durch Input und Output um mehr als 60 Prozent gesenkt. Die Stückkosten sind relevanter als die Gesamtausgaben, da sie die Effizienz im Wachstum des Geschäftsvolumens widerspiegeln.
Accelerator-Ressourcen: 80 Prozent Reduktion
Bei der Verwendung des DeepSeek Basismodells ermöglicht Twinkle standardmäßig fünf LoRA-Täter, ein Grundmodell zu teilen. Copies werden von 5 auf 1 reduziert, wodurch die Menge an Beschleunigerressourcen für diese Konfiguration um 80% verringert und die Trainingsdichte um 5 mal erhöht wird.
„Wir nutzen diesen Rahmen, um 99 % der Beschleunigerressourcen in ein integriertes Management zu integrieren, indem wir eng mit Rechenzentren und anderen internen Teams zusammenarbeiten. Der Effekt kann quantifiziert werden: Die durchschnittliche Beschleunigernutzung hat sich von 35 % auf über 60 % erhöht und die Kosten für die Inferenz pro Million Token wurden um mehr als 60 % reduziert.“
— MeiQing Zhang, Leiter des China Merchants Bank Architecture Management Team
Praxiserfahrung
Behalten Sie verschiedene Laufstrategien unter einheitlicher Kontrollebene
Schulungen und Zugang erfordern eine Harmonisierung des Ressourcenmanagements, sollten aber nicht dieselbe Strategie verwenden. Kueues Warteschlange und Quotenzugriff sind für Trainingslasten geeignet, und KEDAs Indikator-getriebene Skalierung ist für Online-Bezugszwecke geeignet.
Die Differenzelastizität beruht auf der schnellen Fertigstellung des Modells
Eine neue Kopie kann nur eine Anforderung erhalten, wenn Sie das Modellgewicht laden. So ist die Ladegeschwindigkeit des Modus Teil der Flexibilität des Modells und nicht nur dessen Speicheroptimierung. Fluid 's rechnerische Seitenkache verkürzt diese Zeit.
Gemeinsame Ressourcen-Sharing und Modell-Sharing zur Lösung verschiedener Probleme
Hami entscheidet, wie die physikalische Beschleunigerkapazität verteilt wird und Twinkle entscheidet, wie mehrere LoRA-Täter ein Basismodell wiederverwenden können.
Genaue Messung der Gewinne unter Verwendung einheitlicher Indikatoren
Die Verwendung von Beschleunigern, Einheiten Tokenkosten und Trainingsdichte misst unterschiedliche Probleme. Die Klärung des Umfangs und der Methodik jedes Indikators erleichtert die Validierung der Ergebnisse und bezieht sich auf andere Organisationen.
Bedeutung dieser Praxis
In dieser Architektur betreibt Kubernetes nicht nur KI-Container, sondern verbindet auch den betrieblichen Zugriff, die ereignisgesteuerte Elastizität, die Gasverteilung, die Datenbeschleunigung und die Beobachtungsfähigkeit.
Das CNCF-Projekt bietet eine neutrale, modulare Infrastrukturschnittstelle. Die China Mercants Bank kann den Trainingsrahmen oder Inferenzmotor verbessern, ohne die Ressourcen und Datenschichten zu ersetzen; sie kann auch den Beschleunigertyp hinzufügen oder ändern, ohne das gesamte Trainingspaket und den Inferenzprozess neu schreiben zu müssen.
Beschreibung der Messung: Das Ergebnis ist ein konsistenter interner Vergleich der Bank, mit vergleichbaren Modellen und Servicebedingungen wie oben beschrieben.
Folgeplan
Die nächste Phase wird sich auf vier Richtungen konzentrieren:
- Dynamische Multitensivseite: Durchbrechen der festen 5 Mieter-Standardkonfiguration basierend auf einer bewährten maximalen 8 Mieter, Einstellen von Twinkle auf Modellgröße, LoRA-Konfiguration, GPU-Memoory-Druck und Service-Ziele.
- Kapazitätsmanagement auf Basis von Stückkosten: Die Verteilung der Kapazität zwischen Training und Referenz wird durch die Kombination von Beschleunigerauslastung, Kueu-Training Queue-Status, Prometheus verzögert Signal und Token Kosten geführt.
- Server AI-Last auf Basis von KEDA: Erweitern Sie die ereignisgesteuerte Erweiterung auf Server-Betriebsart. Wenn Serviceziele erlauben, kann der Zugriff auf Null reduziert und wieder auf Echtzeitbedarf zurückgesetzt werden; Modellbereitschaft wird durch Fluid Cache reduziert.
- Broader Hardware und laufende Unterstützung: Erweiterung der HAMi-basierten heterogenen Beschleunigerunterstützung, verstärktes Training und Inferenz-Backends, Wartung von zwei Wegentkoppelungslinks und Beitrag der Produktionserfahrung vorgelagert.
Original:One Heterogeneous Compute Pool, Two Workload Types: How China Merchants Bank Unified Training and Inference on Kubernetes ↗
Herausgeber: Cloud Native Computing Foundation (CNCF) · 2026-09-07
Diese lokalisierte Fassung übernimmt die technischen Informationen und den Messumfang des Originalartikels. Sie ist keine offizielle CNCF-Übersetzung. Architekturdiagramme behalten ihren Originaltext. Projektstatus und Produktangaben beziehen sich auf das ursprüngliche Veröffentlichungsdatum.
Das Original wird unter den Inhaltsbedingungen der Linux Foundation und CC BY 3.0 verwendet. Diese Fassung wurde übersetzt und neu gestaltet. Alle Marken gehören ihren jeweiligen Inhabern.