单卡跑 8 个模型、月省 20 万:深信服如何用 K8s + Volcano + HAMi 榨干每一张 GPU
2000 人研发团队的 AI 平台,曾经一边疯狂买卡,一边看着大量 GPU 空转。深信服基于 Kubernetes + Volcano + HAMi 重建算力平台后:GPU 利用率提升 3 倍以上,单卡承载 8+ 个模型,外部模型调用成本每月省下 20 万元。这是怎么做到的?
01 深信服的 GPU 困境:卡越买越多,利用率越来越难看
深信服是中国领先的企业级云计算与网络安全厂商。随着 AI 应用快速增长,他们正在为内部研发团队和企业客户构建统一的 AI 算力平台,支撑 AI Coding、数字员工、智能客服、销售 Agent、企业知识助手等一批业务场景。
平台规模涨起来之后,三个问题开始暴露。
推理服务独占整卡,GPU 大面积空转。 传统模式下,推理服务独占整张 GPU。大量业务只用到部分显存和算力,却占着完整的卡——最典型的是小模型服务,显存占用只有 15%~20%,剩下 80% 以上全部闲置。资源碎片化越来越严重,甚至出现了 GPU 扩容速度跑赢业务增长的怪象:卡买得越多,浪费越大。
多租户环境下资源治理复杂。 平台同时服务多个业务方,对 GPU 的需求差异明显:有的业务需要显存长期驻留,有的流量呈现明显的峰谷特征。统一资源池怎么管、配额怎么分,成了绕不开的问题。
推理与批处理任务并存。 在线推理、批量推理、分布式训练、Agent 工作流同时运行在一个平台上,原生 Kubernetes 的 GPU 调度接不住这么复杂的工作负载组合。
02 先看成绩单
深信服最终基于 Kubernetes、Volcano 和 HAMi 构建了生产级共享 GPU 平台,把 Kubernetes 变成统一的 AI 资源控制平面。核心指标变化如下:
| 指标 | 改进前 | 改进后 |
|---|---|---|
| GPU 利用率 | 基线 | 提升超过 3 倍 |
| 单卡承载模型数 | 1 | 8+ |
| 外部模型调用成本 | 40 万元/月 | 20 万元/月 |
| 模型故障恢复时间 | 约 1 小时 | <10 分钟 |
| 3 倍峰值流量成功率 | 不稳定 | 95%+ |
| 支撑研发团队规模 | 有限 | 2000+ 人 |
下面拆解他们是怎么做到的。
03 为什么选择 HAMi
「HAMi 的 Kubernetes 原生集成意味着零迁移成本。透明的设备虚拟化让业务无需任何改造。」
—— 贾毫杰,深信服云 AI 总架构师
Kubernetes 为 AI 平台提供了统一控制平面,但原生 GPU 调度以整卡为单位分配资源,满足不了推理服务、多租户和异构 GPU 环境的需求。深信服的方案是让 Volcano 和 HAMi 各管一摊:Volcano 解决高级调度问题,HAMi 解决 GPU 资源虚拟化问题。
选择 HAMi 的核心理由有三个:
- GPU 共享能力——显存配额精确到 MiB、算力切分粒度低至 1%,多个 Pod 共享同一张 GPU 且相互隔离;
- 异构 GPU 支持——统一的资源抽象,跨多代 GPU 设备保持一致的调度体验;
- 活跃的开源生态——Kubernetes 领域最活跃的开源 vGPU 项目之一,与 Volcano 队列、vLLM 持续集成。
04 平台架构:一条请求通路 + 一个算力底座
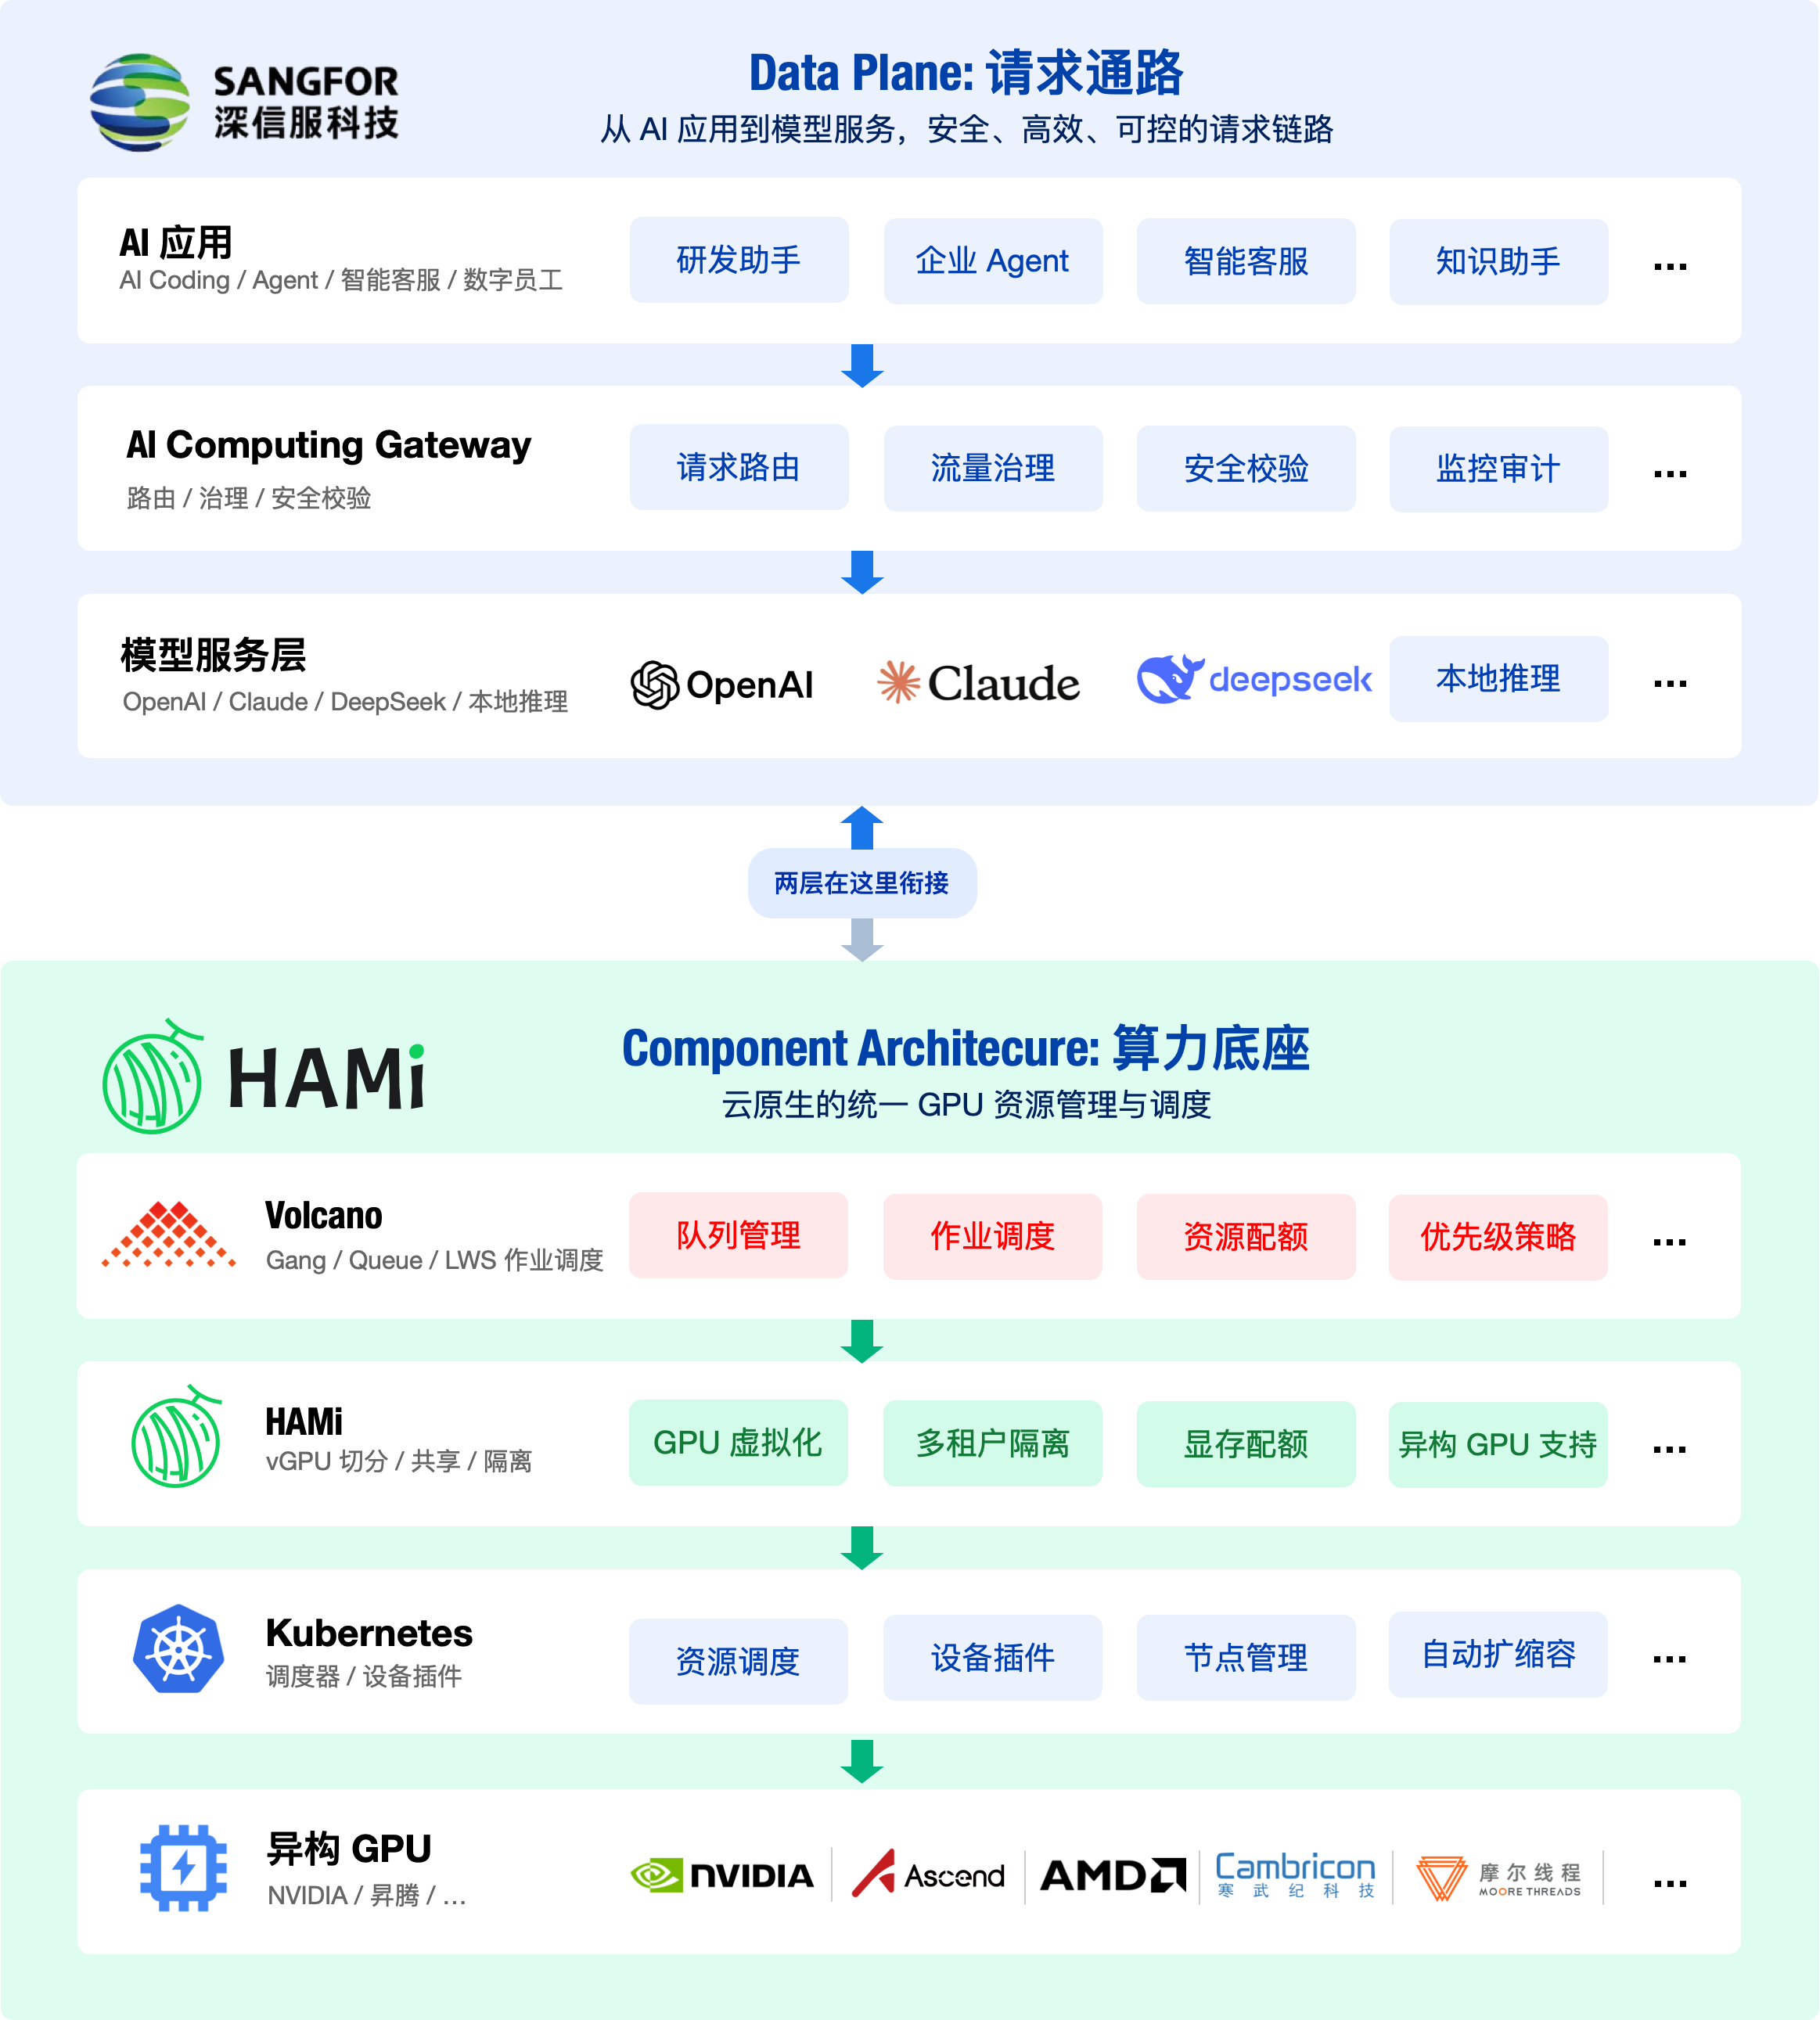
平台分为两层。Data Plane 是请求通路:AI 应用先经过 AI Computing Gateway 完成路由、治理与安全校验,再到达模型服务层。Component Architecture 是算力底座:Volcano 负责作业调度,HAMi 负责 GPU 虚拟化与共享隔离,Kubernetes 管理节点与设备插件,最终落到 NVIDIA、昇腾等异构 GPU 上执行。两层在模型服务与 Volcano 之间衔接,打通了从请求到算力的完整链路。
05 GPU 池化:从「一人一卡」到「大小模型混部」
这是整个改造中最直观的一步。改进前采用独占模式,一张卡只跑一个模型:
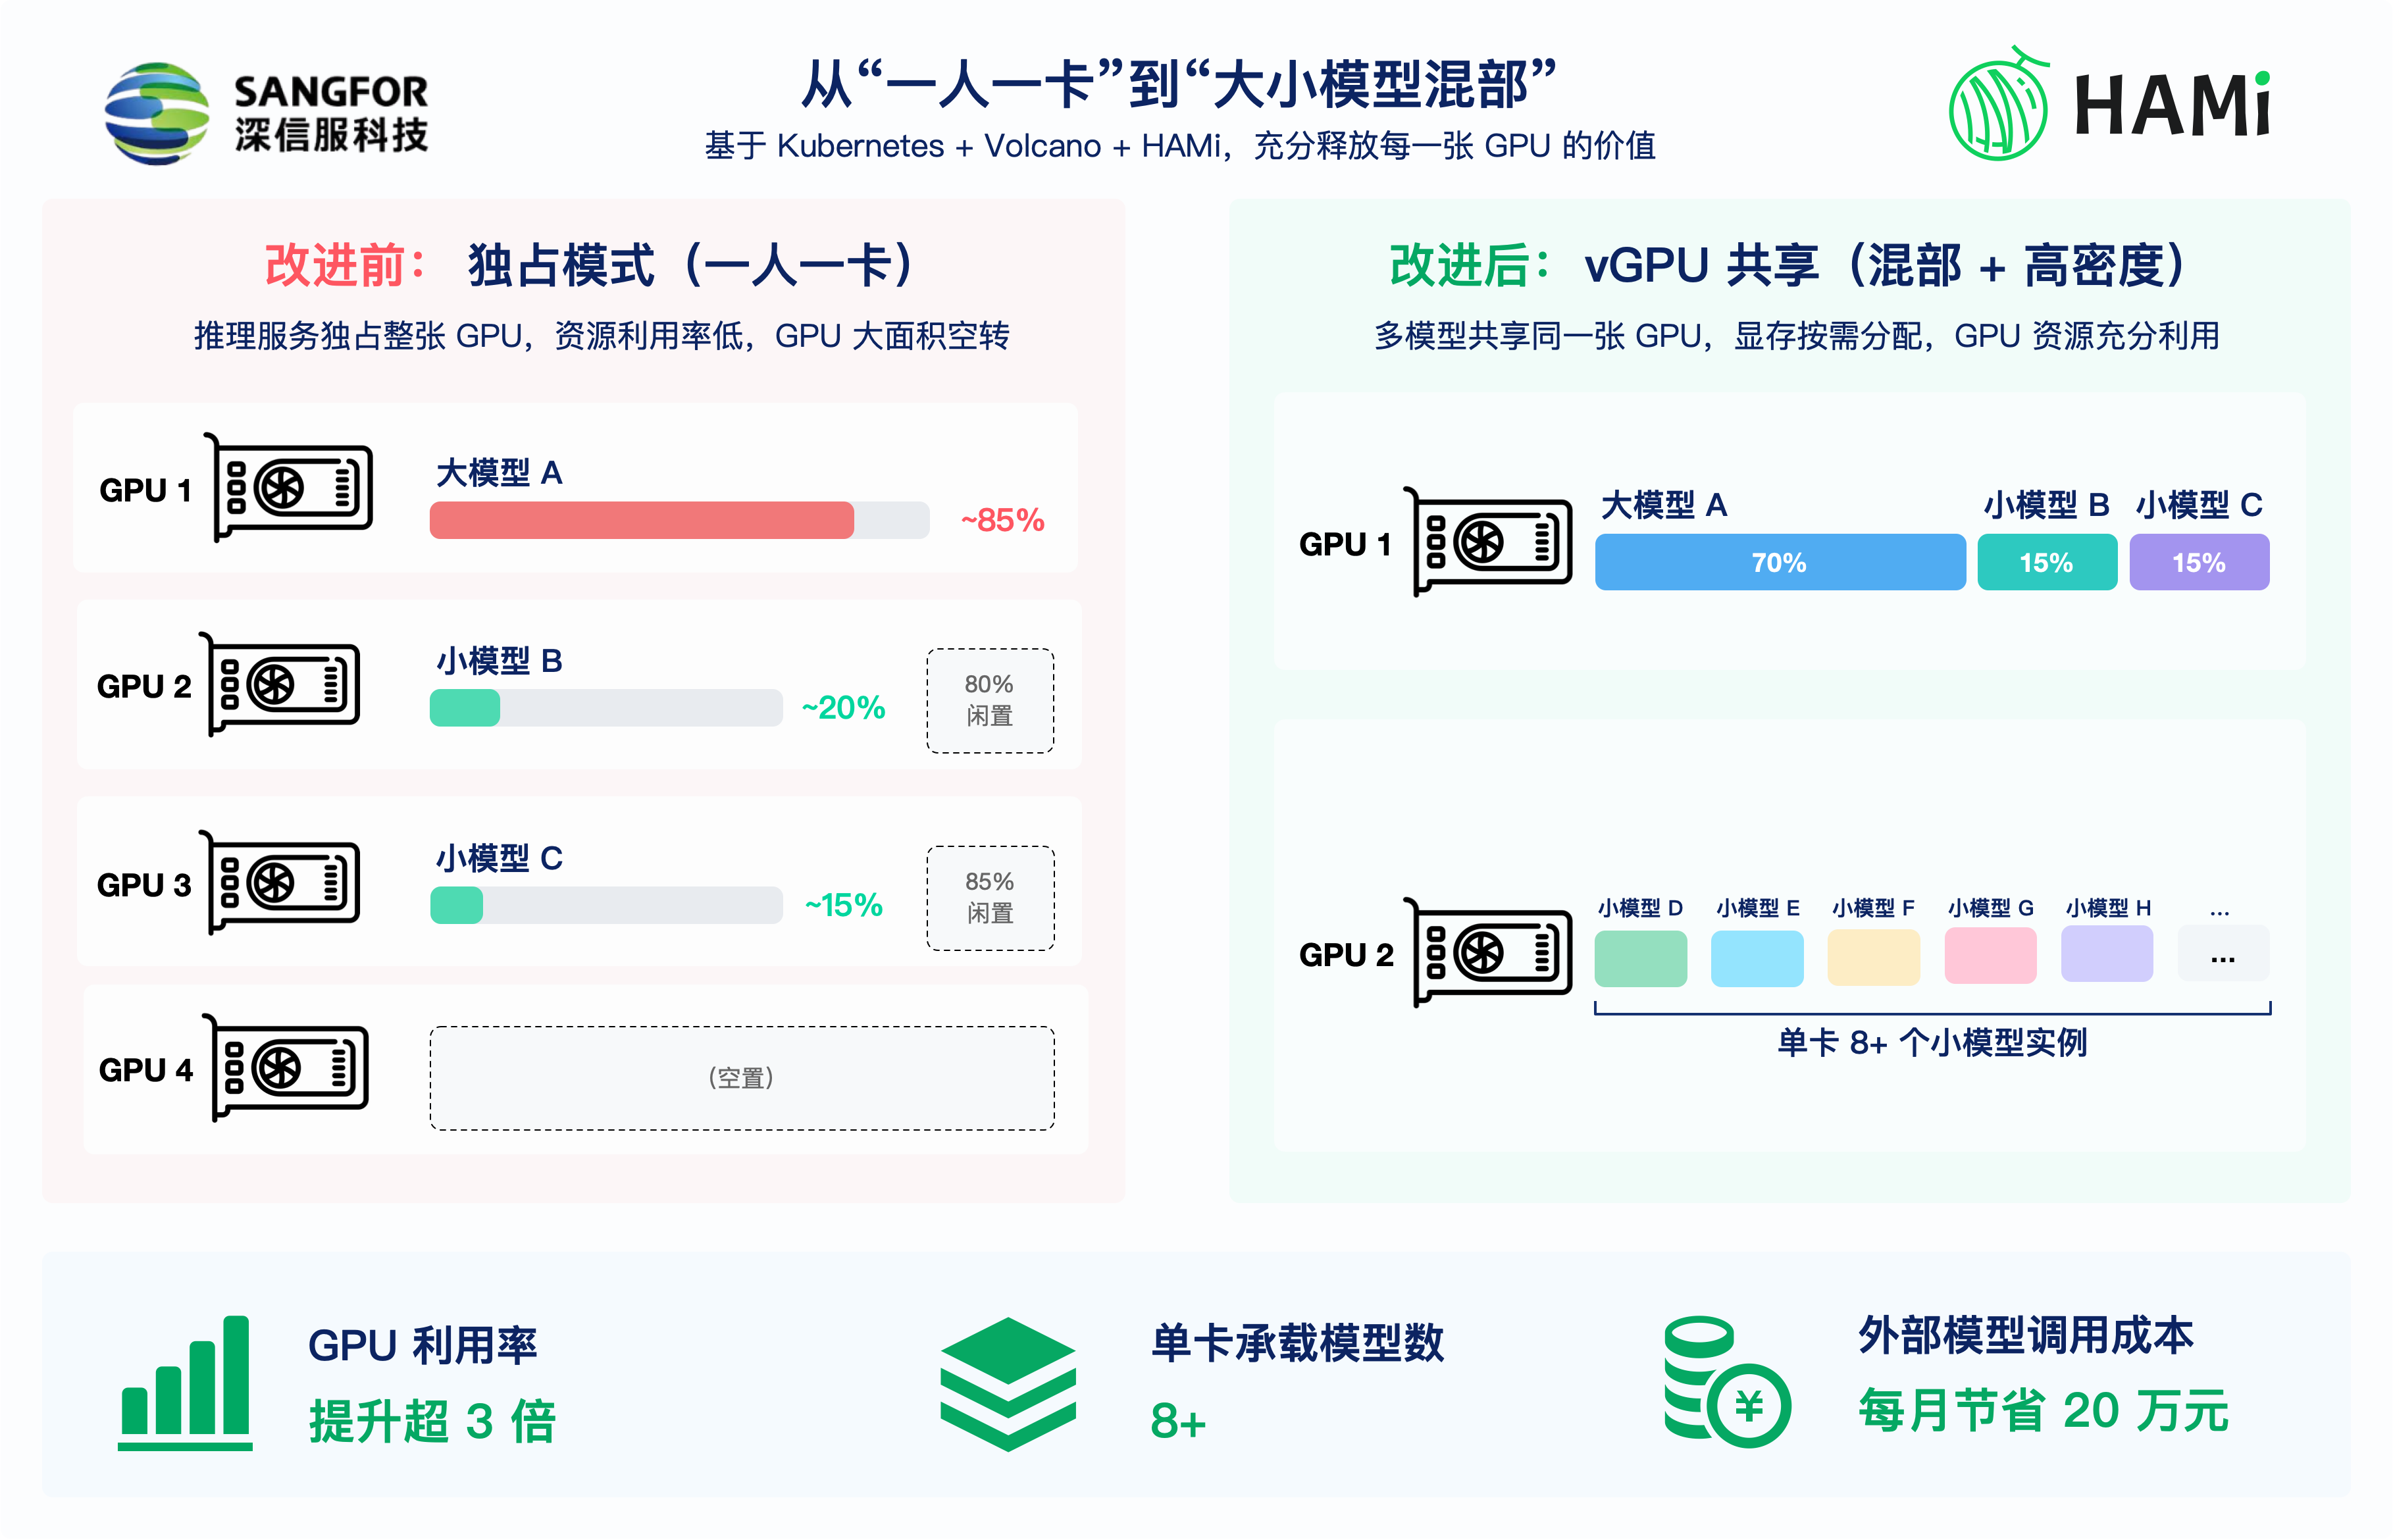
引入 vGPU 切分后,带来两个核心收益:
- 大小模型混部:同一张卡上,大模型占大头(比如 70%),剩余切片分给多个小模型,把原本闲置的算力吃满;
- 小模型部署密度:单卡可承载 8 倍以上的小模型实例,显著降低扩卡需求。
整体效果:GPU 利用率提升超过 3 倍,单卡模型密度提升超过 8 倍。
06 Volcano × HAMi:各管一摊的黄金搭档
只有 GPU 共享,还不足以满足生产需求——设备管理、配额治理、作业编排一个都不能少。Volcano 与 HAMi 结合,实现了设备资源和作业调度的统一管理:
- 设备状态维护——GPU 健康监控、故障自动隔离、资源自动回收;
- 资源声明治理——自动补齐资源字段、配额统一计算、非法请求提前拒绝;
- 调度事务隔离——资源试算与实际占用解耦,保证状态一致性;
- Gang 与 LWS 支持——Volcano 编排作业,HAMi 分配 GPU,整组联合调度。
一句话总结分工:Volcano 决定工作负载何时运行、运行在哪里;HAMi 决定 GPU 资源如何被共享和分配。 两者解耦之后,各自都能独立演进。
07 数字背后:平台发生了什么
更省卡。 通过 vGPU 切分,多个推理服务共享同一张 GPU,显存和算力按需分配,共享 GPU 池消除了资源碎片化——原本需要 3 张 GPU 的推理业务,现在 1~2 张就能承载。
更省钱。 结合智能路由——简单问题路由到低成本模型,复杂问题才走高价模型——外部模型调用费用从每月 40 万元降到 20 万元,再配合安全护栏机制,实现成本与效果的最优平衡。
更稳。 模型故障恢复时间从约 1 小时缩短到 10 分钟以内;3 倍流量压力测试下,成功率保持在 95% 以上;设备健康监控和自动故障隔离,确保故障 GPU 不再进入调度链路。
更大规模。 平台已支撑 AI Coding、企业 Agent、智能客服、数字员工等多个生产场景,覆盖 2000+ 研发人员的日常使用。
08 三条可复制的经验
先共享,再扩容。 多数推理工作负载吃不满一整张 GPU。在采购更多硬件之前,优先考虑 GPU 共享——ROI 更高、见效更快。
调度与资源虚拟化要解耦。 GPU 共享没有智能调度,会导致次优放置;调度没有 GPU 虚拟化,则无资源可调。HAMi 负责资源抽象,Volcano 负责调度策略,两层解耦后可以独立演进。
Kubernetes 正在成为 AI 资源控制平面。 AI 基础设施正沿着云原生的路径演进,而不是另起炉灶建一套新的资源管理系统。Kubernetes + Volcano + HAMi 的组合,让企业在不引入新管理范式的前提下,获得企业级 GPU 管理能力。
09 下一步:与社区一起往前走
深信服将继续与 HAMi 社区合作,推动 Kubernetes 成为 AI 工作负载的统一控制平面:
- 参与 HAMi 的 DRA 生态,推动 Kubernetes 原生 GPU 资源管理演进;
- 通过 HAMi 的统一抽象,扩展昇腾等异构 GPU 支持;
- 将生产级调度策略和运维最佳实践,回馈 Volcano 和 HAMi 社区。
10 关于 HAMi
HAMi 是 CNCF Incubating 项目、开源的云原生 GPU 虚拟化中间件,为 AI 工作负载提供异构加速器的共享、隔离与调度能力,已支持 NVIDIA、AMD、昇腾、寒武纪、海光、摩尔线程、天数智芯、燧原、昆仑芯、MetaX、AWS Neuron 等主流加速器。
- 官网:https://project-hami.io
- HAMi GitHub:https://github.com/Project-HAMi/HAMi (欢迎 Star ⭐)
- Volcano GitHub:https://github.com/volcano-sh/volcano
- 社区渠道:Discord(推荐)、Slack #hami-dev、社区双周会,详见官网社区页 https://project-hami.io/community
如果你也在被 GPU 利用率和多租户调度折磨,欢迎把这篇转发给同在做 AI 基础设施的同事,也欢迎在 GitHub Issues 和社区渠道分享你的场景与需求。
本案例由密瓜智能和深信服共同整理,并发布在 CNCF 案例研究《深信服基于 Kubernetes、Volcano 和 HAMi 构建企业级 AI 算力平台》。